Ce chapitre traite les équations différentielles spé linéaires, scalaires ou vectorielles, de la forme \(X^{\prime} = A(t) X + B(t)\). Le théorème de Cauchy linéaire y joue le rôle central : il garantit une solution unique, définie sur tout l’intervalle. Vous en déduirez la structure de l’ensemble des solutions, un espace affine de dimension finie, et le principe de superposition.
Au second semestre, ce chapitre s’appuie sur les fonctions vectorielles et sur les séries entières. Il développe ensuite les outils propres à l’ordre 2 : le wronskien, qui teste une base de solutions, la variation des constantes et la résolution d’une équation dont on connaît une solution. Enfin, il aborde la recherche de solutions développables en série entière et les raccordements d’équations non normalisées.
Ces méthodes reviennent sans cesse aux oraux et aux écrits des concours. De plus, elles préparent l’étude des systèmes différentiels à coefficients constants.
Pour vous entraîner ensuite, travaillez les exercices de maths spé sur équations différentielles linéaires.
I. Équations différentielles linéaires : cadre et problème de Cauchy
Dans tout le chapitre, \(I\) désigne un intervalle de \(\mathbb{R}\) d’intérieur non vide et \(E\) un espace vectoriel normé de dimension finie \(n\). Le corps de base est \(\mathbb{K} = \mathbb{R}\) ou \(\mathbb{C}\). Les coefficients sont toujours supposés continus sur \(I\). Cette hypothèse est essentielle : elle garantit l’existence et l’unicité des solutions.
1. Équation vectorielle et forme matricielle
Soient \(a : I \to \mathcal{L}(E)\) et \(b : I \to E\) continues. On appelle équation différentielle linéaire d’ordre 1 l’équation \[x^{\prime} = a(t) \cdot x + b(t). \qquad (E)\] Une solution de \((E)\) est une fonction \(x : I \to E\) dérivable telle que \(x^{\prime}(t) = a(t)(x(t)) + b(t)\) pour tout \(t \in I\). L’équation homogène associée est \(x^{\prime} = a(t) \cdot x\), notée \((H)\).
Choisissons une base de \(E\). Alors \(x(t)\) est représenté par une colonne \(X(t) \in \mathcal{M}_{n,1}(\mathbb{K})\), et \(a(t)\) par une matrice \(A(t) \in \mathcal{M}_n(\mathbb{K})\). L’équation s’écrit donc sous forme matricielle \(X^{\prime} = A(t) X + B(t)\). Autrement dit, on résout un système de \(n\) équations scalaires couplées. De plus, une solution est automatiquement de classe \(C^1\), car \(x^{\prime}\) est continue comme somme de fonctions continues.
Le système \(x^{\prime} = t x – y + 1\), \(y^{\prime} = x + t^2 y\) s’écrit \(X^{\prime} = A(t) X + B(t)\) avec \[A(t) = \begin{pmatrix} t & -1 \\ 1 & t^2 \end{pmatrix}, \qquad B(t) = \begin{pmatrix} 1 \\ 0 \end{pmatrix}.\] Les coefficients sont continus sur \(\mathbb{R}\) : c’est donc une équation linéaire sur \(I = \mathbb{R}\).
2. Problème de Cauchy et forme intégrale
Soient \(t_0 \in I\) et \(x_0 \in E\). Le problème de Cauchy associé à \((E)\) et à la condition initiale \((t_0, x_0)\) consiste à chercher les solutions \(x\) de \((E)\) sur \(I\) telles que \(x(t_0) = x_0\).
Une fonction \(x : I \to E\) continue est solution du problème de Cauchy si et seulement si \[\forall t \in I, \quad x(t) = x_0 + \int_{t_0}^{t} \big( a(s) \cdot x(s) + b(s) \big) \, \mathrm{d}s.\] C’est la forme intégrale du problème de Cauchy.
Si \(x\) est solution, alors \(x\) est \(C^1\). Le théorème fondamental de l’analyse donne \(x(t) – x(t_0) = \int_{t_0}^{t} x^{\prime}(s) \, \mathrm{d}s\), d’où l’égalité. Réciproquement, si \(x\) est continue et vérifie l’égalité, l’intégrande \(s \mapsto a(s) \cdot x(s) + b(s)\) est continue. Par conséquent, le membre de droite est dérivable, de dérivée \(a(t) \cdot x(t) + b(t)\). Enfin, l’égalité en \(t = t_0\) donne \(x(t_0) = x_0\).
La forme intégrale n’exige que la continuité de \(x\). C’est pourquoi elle sert dans les démonstrations d’existence et dans les majorations de solutions.
3. Équation scalaire d’ordre n
Une équation scalaire linéaire d’ordre \(n\) s’écrit \(x^{(n)} + a_{n-1}(t) x^{(n-1)} + \cdots + a_0(t) x = b(t)\), avec des fonctions \(a_k\) et \(b\) continues sur \(I\). Elle se ramène à un système d’ordre 1.
La fonction \(x\) est solution de l’équation scalaire d’ordre \(n\) si et seulement si le vecteur \(X = (x, x^{\prime}, \ldots, x^{(n-1)})\) est solution de \(X^{\prime} = A(t) X + B(t)\), où \[A(t) = \begin{pmatrix} 0 & 1 & & \\ & \ddots & \ddots & \\ & & 0 & 1 \\ -a_0(t) & -a_1(t) & \cdots & -a_{n-1}(t) \end{pmatrix}, \qquad B(t) = \begin{pmatrix} 0 \\ \vdots \\ 0 \\ b(t) \end{pmatrix}.\]
Les \(n – 1\) premières lignes traduisent simplement que chaque composante est la dérivée de la précédente. La dernière ligne est l’équation elle-même. Ainsi, une condition initiale pour l’ordre \(n\) porte sur les \(n\) valeurs \(x(t_0), x^{\prime}(t_0), \ldots, x^{(n-1)}(t_0)\).
L’équation \(x^{\prime\prime} + t x^{\prime} – e^{t} x = \cos t\) équivaut au système \[\begin{pmatrix} x \\ y \end{pmatrix}^{\prime} = \begin{pmatrix} 0 & 1 \\ e^{t} & -t \end{pmatrix} \begin{pmatrix} x \\ y \end{pmatrix} + \begin{pmatrix} 0 \\ \cos t \end{pmatrix}, \qquad y = x^{\prime}.\]
II. Théorème de Cauchy linéaire et structure des solutions
1. Le théorème de Cauchy linéaire
Théorème de Cauchy linéaire. Soient \(a : I \to \mathcal{L}(E)\) et \(b : I \to E\) continues. Pour tout \((t_0, x_0) \in I \times E\), le problème de Cauchy \(x^{\prime} = a(t) \cdot x + b(t)\), \(x(t_0) = x_0\) admet une unique solution définie sur \(I\) tout entier.
La démonstration n’est pas exigible. Retenez cependant son idée. On définit la suite \(x_0(t) = x_0\) et \(x_{k+1}(t) = x_0 + \int_{t_0}^{t} (a(s) \cdot x_k(s) + b(s)) \, \mathrm{d}s\). Sur un segment \(J\) inclus dans \(I\), on majore alors \(\|x_{k+1} – x_k\|\) par \(C \frac{(M |t – t_0|)^{k}}{k!}\). La série télescopique converge donc normalement, et sa limite vérifie la forme intégrale.
Pour l’équation scalaire d’ordre \(n\) à coefficients continus sur \(I\), il existe, pour tout \(t_0 \in I\) et tout \((y_0, \ldots, y_{n-1}) \in \mathbb{K}^n\), une unique solution sur \(I\) telle que \(x^{(k)}(t_0) = y_k\) pour \(0 \leq\, k \leq\, n – 1\).
Le théorème exige une équation résolue en la dérivée d’ordre maximal, c’est-à-dire de coefficient dominant égal à \(1\). Pour une équation comme \(t x^{\prime} – 2 x = 0\), il ne s’applique que sur \(]0, +\infty[\) ou \(]-\infty, 0[\). La partie VI traite ce cas.
Une conséquence immédiate est souvent utilisée. Une solution de \((H)\) qui s’annule en un point est nulle partout, car la fonction nulle résout le même problème de Cauchy. Par conséquent, deux solutions distinctes de \((E)\) ne se croisent jamais.
2. Structure de l’ensemble des solutions
Notons \(S_H\) l’ensemble des solutions de \((H)\) sur \(I\), et \(S_E\) celui de \((E)\).
- \(S_H\) est un sous-espace vectoriel de \(C^1(I, E)\), et pour tout \(t_0 \in I\), l’application \(\varphi_{t_0} : x \mapsto x(t_0)\) est un isomorphisme de \(S_H\) sur \(E\). Ainsi, \(\dim S_H = n\).
- Si \(x_p\) est une solution de \((E)\), alors \(S_E = x_p + S_H\) : c’est un sous-espace affine de direction \(S_H\).
D’abord, \(S_H\) contient \(0\) et est stable par combinaison linéaire, car \(a(t)\) est linéaire. Ensuite, \(\varphi_{t_0}\) est linéaire. Elle est injective : si \(x(t_0) = 0\), l’unicité donne \(x = 0\). Elle est surjective : pour tout \(x_0 \in E\), l’existence fournit \(x \in S_H\) avec \(x(t_0) = x_0\). Enfin, \(x\) résout \((E)\) si et seulement si \(x – x_p\) résout \((H)\), par linéarité.
Principe de superposition. Si \(x_1\) est solution de \(x^{\prime} = a(t) \cdot x + b_1(t)\) et \(x_2\) solution de \(x^{\prime} = a(t) \cdot x + b_2(t)\), alors, pour tous scalaires \(\lambda, \mu\), la fonction \(\lambda x_1 + \mu x_2\) est solution de \(x^{\prime} = a(t) \cdot x + \lambda b_1(t) + \mu b_2(t)\).
Pour l’équation scalaire d’ordre \(n\), l’ensemble des solutions homogènes est donc de dimension \(n\). En effet, \(x \mapsto (x(t_0), \ldots, x^{(n-1)}(t_0))\) est un isomorphisme sur \(\mathbb{K}^n\). En particulier, pour l’ordre 2, il suffit de trouver deux solutions indépendantes pour connaître toutes les solutions homogènes.
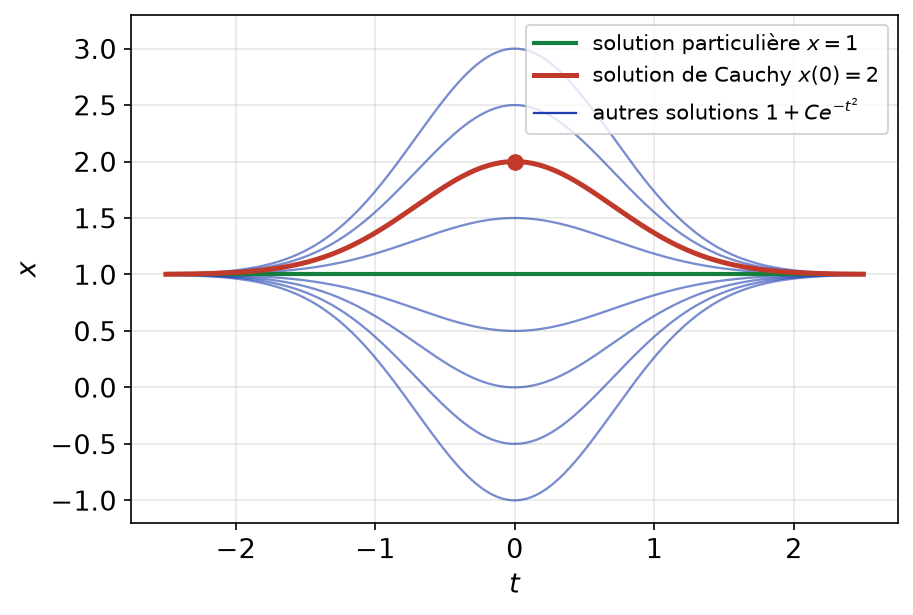
Considérons \(x^{\prime} + 2 t x = 2 t\) sur \(\mathbb{R}\). La fonction constante \(1\) est une solution évidente. De plus, les solutions homogènes sont les \(C e^{-t^2}\). Par conséquent, \(S_E = \{ t \mapsto 1 + C e^{-t^2}, \ C \in \mathbb{R} \}\). La solution telle que \(x(0) = 2\) correspond à \(C = 1\).
Comme le montre la figure ci-dessous, les courbes intégrales remplissent le plan sans se croiser. Chaque point \((t_0, x_0)\) est traversé par exactement une solution, ce qui illustre le théorème de Cauchy linéaire.
III. Wronskien et bases de l’espace des solutions
1. Définition et caractérisation des bases
Soient \(x_1, \ldots, x_n\) des solutions de \((H)\) et \(\mathcal{B}\) une base de \(E\). Leur wronskien est la fonction \(W(t) = \det_{\mathcal{B}} (x_1(t), \ldots, x_n(t))\). Pour l’équation scalaire d’ordre 2 \(x^{\prime\prime} + a(t) x^{\prime} + b(t) x = 0\), le wronskien de deux solutions \(x_1, x_2\) est \[W(t) = \begin{vmatrix} x_1(t) & x_2(t) \\ x_1^{\prime}(t) & x_2^{\prime}(t) \end{vmatrix} = x_1(t) x_2^{\prime}(t) – x_2(t) x_1^{\prime}(t).\]
Soient \(x_1, \ldots, x_n\) des solutions de \((H)\) sur \(I\). Les assertions suivantes sont équivalentes :
- \((x_1, \ldots, x_n)\) est une base de \(S_H\) ;
- il existe \(t_0 \in I\) tel que \(W(t_0) \neq 0\) ;
- pour tout \(t \in I\), \(W(t) \neq 0\).
Fixons \(t \in I\). L’isomorphisme \(\varphi_t : x \mapsto x(t)\) transforme la famille \((x_1, \ldots, x_n)\) en \((x_1(t), \ldots, x_n(t))\). Or un isomorphisme conserve le caractère libre. Donc \((x_1, \ldots, x_n)\) est libre si et seulement si \(W(t) \neq 0\). Comme \(\dim S_H = n\), libre équivaut à base. Cette équivalence vaut pour chaque \(t\), d’où le résultat.
Ce théorème fournit un test très pratique : on calcule \(W\) en un seul point bien choisi, souvent là où les conditions initiales sont simples.
2. Formule de Liouville à l’ordre 2
Si \(x_1, x_2\) sont solutions de \(x^{\prime\prime} + a(t) x^{\prime} + b(t) x = 0\) sur \(I\), alors \(W^{\prime} = -a(t) W\). Par conséquent, pour \(t_0 \in I\), \[W(t) = W(t_0) \exp( -\int_{t_0}^{t} a(s) \, \mathrm{d}s ).\]
On dérive : \(W^{\prime} = x_1^{\prime} x_2^{\prime} + x_1 x_2^{\prime\prime} – x_2^{\prime} x_1^{\prime} – x_2 x_1^{\prime\prime} = x_1 x_2^{\prime\prime} – x_2 x_1^{\prime\prime}\). Ensuite, on remplace \(x_i^{\prime\prime} = -a x_i^{\prime} – b x_i\). Les termes en \(b\) se compensent, et il reste \(W^{\prime} = -a (x_1 x_2^{\prime} – x_2 x_1^{\prime}) = -a W\). On résout enfin cette équation d’ordre 1.
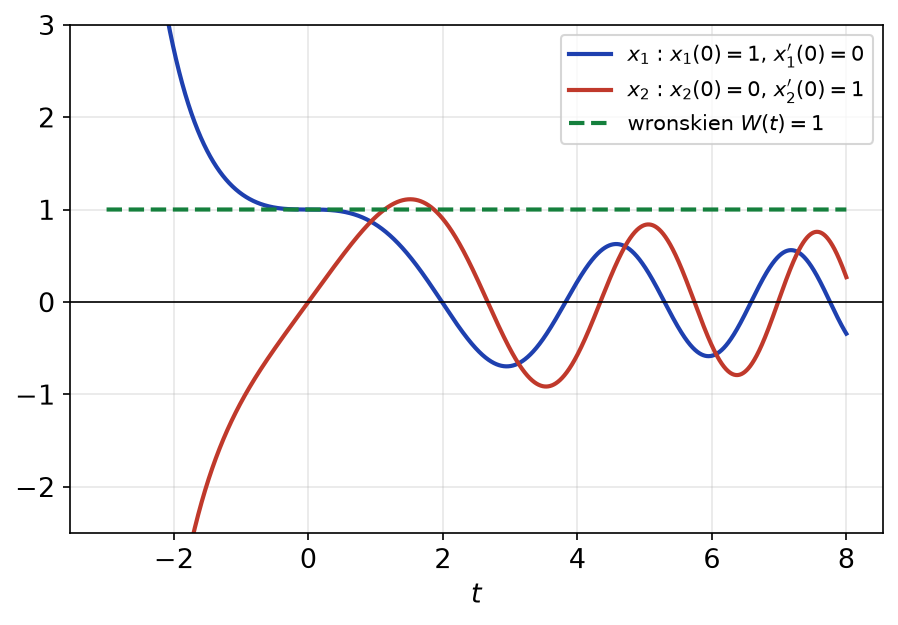
Pour \(x^{\prime\prime} + t x = 0\), il n’y a pas de terme en \(x^{\prime}\), donc \(a = 0\) et \(W\) est constant. Soient \(x_1\) et \(x_2\) les solutions telles que \(x_1(0) = 1\), \(x_1^{\prime}(0) = 0\), \(x_2(0) = 0\), \(x_2^{\prime}(0) = 1\). Alors \(W(0) = 1\), donc \(W = 1\) sur \(\mathbb{R}\), et \((x_1, x_2)\) est une base.
Ces solutions ne s’expriment pas avec les fonctions usuelles. Pourtant, la figure ci-dessous, obtenue par un calcul numérique, confirme que leur wronskien reste égal à \(1\). Remarquez aussi que les zéros de \(x_1\) et de \(x_2\) alternent.
3. Résoudre une équation d’ordre 2 connaissant une solution
Soit \(x_1\) une solution de \(x^{\prime\prime} + a(t) x^{\prime} + b(t) x = 0\) qui ne s’annule pas sur \(J \subset I\). Deux méthodes équivalentes donnent une seconde solution.
- Changement de fonction inconnue. On pose \(x = x_1 z\). Les termes en \(z\) disparaissent, et \(w = z^{\prime}\) vérifie l’équation d’ordre 1 \(x_1 w^{\prime} + (2 x_1^{\prime} + a x_1) w = 0\).
- Par le wronskien. On calcule \(W\) par la formule de Liouville. Puis on utilise \(( \dfrac{x_2}{x_1} )^{\prime} = \dfrac{W}{x_1^2}\) et on intègre.
Sur \(]0, +\infty[\), l’équation \(t^2 x^{\prime\prime} – 2 t x^{\prime} + 2 x = 0\) admet la solution \(x_1 = t\). Sous forme résolue, \(a(t) = -2/t\). Donc \(W^{\prime} = \frac{2}{t} W\), et l’on peut prendre \(W = t^2\). Ensuite, \((x_2 / t)^{\prime} = t^2 / t^2 = 1\), d’où \(x_2 = t^2\). Les solutions sur \(]0, +\infty[\) sont donc les \(\lambda t + \mu t^2\).
IV. Méthode de variation des constantes à l’ordre 2
On connaît une base \((x_1, x_2)\) des solutions de \(x^{\prime\prime} + a(t) x^{\prime} + b(t) x = 0\). On cherche alors une solution de l’équation complète \(x^{\prime\prime} + a(t) x^{\prime} + b(t) x = g(t)\), avec \(g\) continue sur \(I\).
Soient \(\lambda, \mu\) de classe \(C^1\) sur \(I\) telles que \[\begin{cases} \lambda^{\prime} x_1 + \mu^{\prime} x_2 = 0 \\ \lambda^{\prime} x_1^{\prime} + \mu^{\prime} x_2^{\prime} = g. \end{cases}\] Alors \(x = \lambda x_1 + \mu x_2\) est solution de l’équation complète. De plus, ce système a pour unique solution \(\lambda^{\prime} = -\dfrac{x_2 g}{W}\) et \(\mu^{\prime} = \dfrac{x_1 g}{W}\).
La première équation donne \(x^{\prime} = \lambda x_1^{\prime} + \mu x_2^{\prime}\). En dérivant, puis avec la seconde, \(x^{\prime\prime} = \lambda x_1^{\prime\prime} + \mu x_2^{\prime\prime} + g\). Ainsi, \(x^{\prime\prime} + a x^{\prime} + b x = \lambda (x_1^{\prime\prime} + a x_1^{\prime} + b x_1) + \mu (x_2^{\prime\prime} + a x_2^{\prime} + b x_2) + g = g\). Enfin, le déterminant du système vaut \(W(t) \neq 0\), et les formules de Cramer donnent \(\lambda^{\prime}\) et \(\mu^{\prime}\).
Cette méthode n’est rien d’autre que la variation des constantes pour le système \(X^{\prime} = A(t) X + B(t)\) associé. En effet, on cherche \(X = \lambda X_1 + \mu X_2\), où \(X_i = (x_i, x_i^{\prime})\).
Pour appliquer la variation des constantes :
- normaliser l’équation pour que le coefficient de \(x^{\prime\prime}\) vaille \(1\), afin d’identifier \(g\) ;
- écrire le système en \(\lambda^{\prime}, \mu^{\prime}\), puis le résoudre ;
- intégrer, en gardant une seule primitive (les constantes redonnent les solutions homogènes) ;
- ajouter la solution homogène générale et exploiter les conditions initiales.
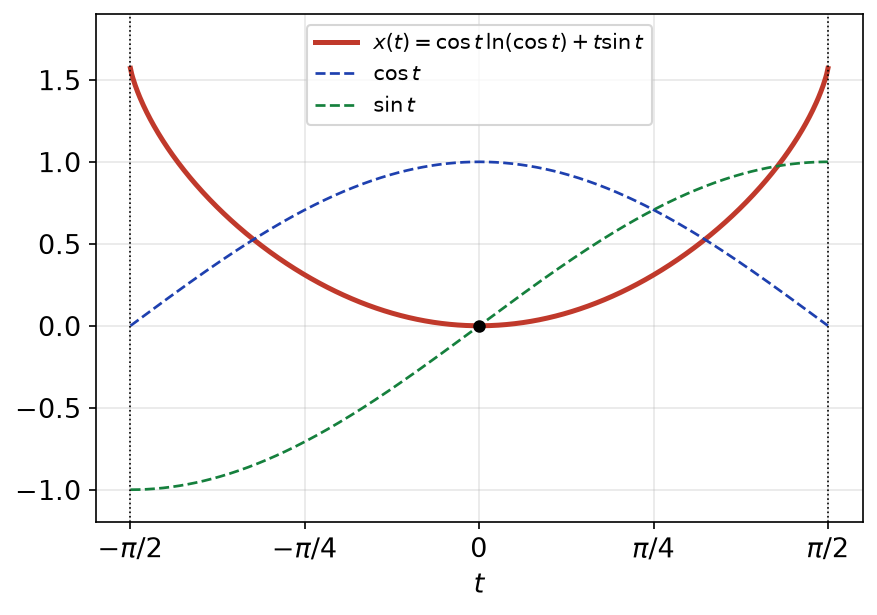
Résolvons \(x^{\prime\prime} + x = \dfrac{1}{\cos t}\) sur \(I = ]-\pi/2, \pi/2[\). La base \((\cos, \sin)\) a pour wronskien \(1\). Le système donne \(\lambda^{\prime} = -\tan t\) et \(\mu^{\prime} = 1\). Ainsi, \(\lambda = \ln(\cos t)\) et \(\mu = t\) conviennent. Finalement, les solutions sont \[x(t) = \cos t \, \ln(\cos t) + t \sin t + \alpha \cos t + \beta \sin t, \qquad (\alpha, \beta) \in \mathbb{R}^2.\] La solution telle que \(x(0) = x^{\prime}(0) = 0\) correspond à \(\alpha = \beta = 0\).
La figure ci-dessous montre cette solution. Elle reste bornée, alors que le second membre \(1 / \cos t\) tend vers \(+\infty\) aux bords de \(I\).
V. Recherche de solutions développables en série entière
Lorsque les coefficients sont des polynômes, on cherche souvent des solutions sous la forme \(x(t) = \sum a_k t^k\). Cette méthode fournit des solutions qu’aucune formule usuelle ne donne. De plus, elle permet de repérer des solutions polynomiales ou connues.
Pour chercher les solutions développables en série entière :
- supposer que \(x(t) = \sum a_k t^k\) a un rayon \(R > 0\), et dériver terme à terme sur \(]-R, R[\) ;
- reporter dans l’équation et réindexer chaque somme pour faire apparaître \(t^k\) ;
- par unicité du développement en série entière, annuler chaque coefficient : on obtient une relation de récurrence ;
- calculer les \(a_k\), puis le rayon, par exemple avec la règle de d’Alembert ;
- réciproquement, vérifier que la série obtenue, de rayon non nul, est bien solution sur \(]-R, R[\).
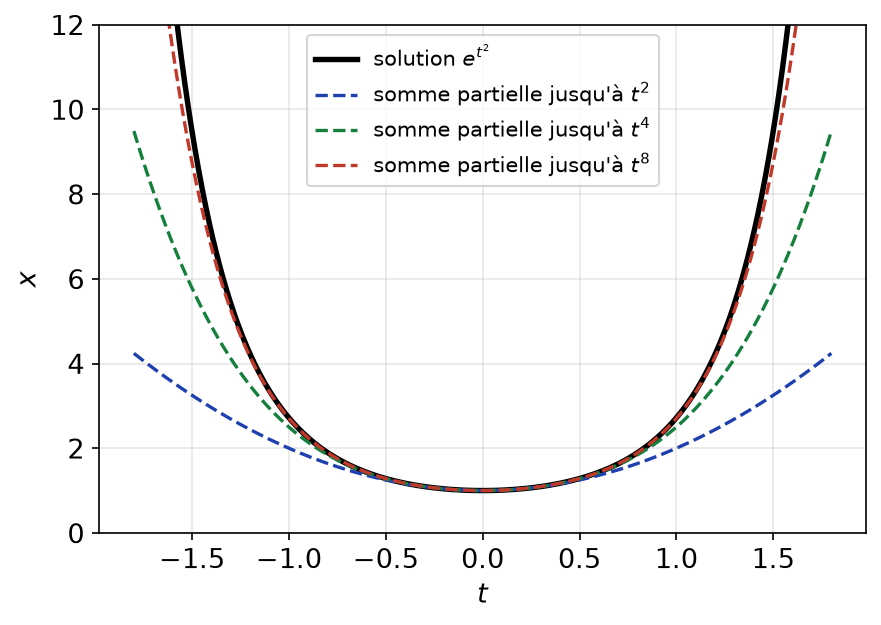
Considérons \(x^{\prime\prime} – 2 t x^{\prime} – 2 x = 0\) avec \(x(0) = 1\) et \(x^{\prime}(0) = 0\). En reportant, le coefficient de \(t^k\) donne \((k+2)(k+1) a_{k+2} – 2 k a_k – 2 a_k = 0\). Autrement dit, \(a_{k+2} = \dfrac{2 a_k}{k+2}\). Comme \(a_1 = 0\), tous les coefficients impairs sont nuls. De plus, \(a_{2p} = \dfrac{a_{2p-2}}{p}\), donc \(a_{2p} = \dfrac{1}{p!}\). Ainsi, \(x(t) = \sum \dfrac{t^{2p}}{p!} = e^{t^2}\), de rayon infini.
Comme le montre la figure ci-dessous, les sommes partielles approchent la solution de mieux en mieux lorsque l’on ajoute des termes. L’approximation reste cependant locale : loin de \(0\), il faut beaucoup de termes.
La récurrence peut porter sur des indices espacés de 2 ou de 3. Il faut alors traiter séparément chaque classe d’indices. Par ailleurs, une solution de rayon \(R\) fini peut se prolonger au-delà de \(]-R, R[\) : le rayon ne mesure pas l’intervalle de définition.
VI. Équations non normalisées et raccordements
1. Le problème
Considérons une équation \(\alpha(t) x^{\prime} + \beta(t) x = \gamma(t)\), ou \(\alpha(t) x^{\prime\prime} + \beta(t) x^{\prime} + \gamma(t) x = \delta(t)\), où le coefficient \(\alpha\) s’annule en certains points. Sur chaque intervalle où \(\alpha\) ne s’annule pas, on peut diviser par \(\alpha\). Le théorème de Cauchy linéaire s’applique alors. En revanche, aux points où \(\alpha\) s’annule, rien n’est garanti : l’espace des solutions sur \(I\) peut avoir une dimension quelconque.
Une solution sur \(I\) d’une équation non normalisée d’ordre \(p\) est une fonction \(p\) fois dérivable sur \(I\) qui vérifie l’équation en tout point de \(I\), y compris aux points où \(\alpha\) s’annule.
2. La méthode de raccordement
Supposons que \(\alpha\) ne s’annule qu’en \(t_0\), intérieur à \(I\).
- Résoudre sur chacun des intervalles \(I_- = I \cap ]-\infty, t_0[\) et \(I_+ = I \cap ]t_0, +\infty[\).
- Une solution sur \(I\) est, par restriction, solution sur \(I_-\) et sur \(I_+\). Elle est donc de la forme \(x_-\) à gauche et \(x_+\) à droite, avec des constantes a priori différentes.
- Écrire les conditions de recollement : existence d’une limite finie commune en \(t_0\) (continuité), puis dérivabilité en \(t_0\), et à l’ordre 2 dérivabilité de \(x^{\prime}\).
- Vérifier l’équation au point \(t_0\) lui-même.
- Conclure en donnant l’ensemble des solutions sur \(I\) et sa dimension.
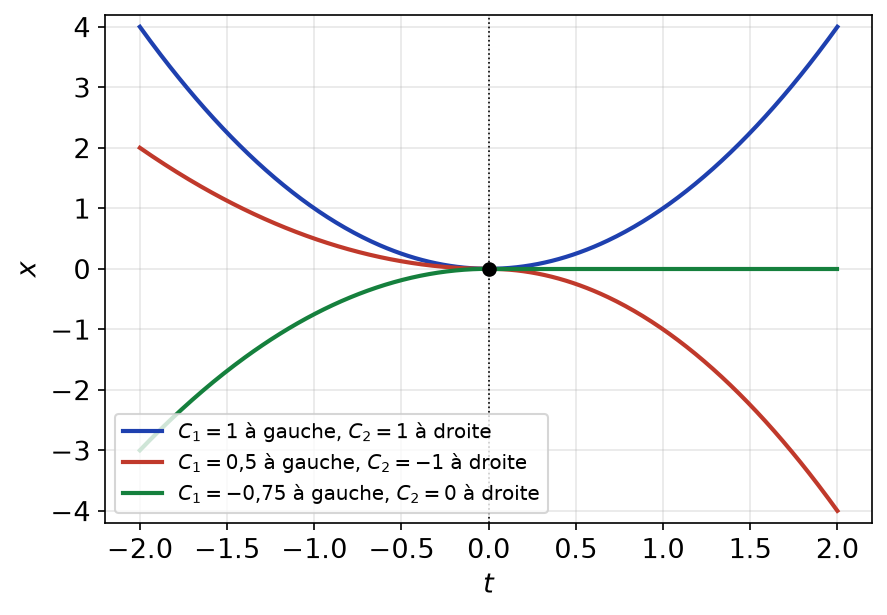
Résolvons \(t x^{\prime} – 2 x = 0\) sur \(\mathbb{R}\). Sur \(]0, +\infty[\), l’équation résolue \(x^{\prime} = \frac{2}{t} x\) donne \(x = C_2 t^2\). De même, sur \(]-\infty, 0[\), \(x = C_1 t^2\). Soit alors \(x\) égale à \(C_1 t^2\) pour \(t < 0\), \(C_2 t^2\) pour \(t > 0\), et \(x(0) = 0\). Elle est continue en \(0\). De plus, \(\frac{x(t) – x(0)}{t}\) vaut \(C_1 t\) ou \(C_2 t\), qui tend vers \(0\). Donc \(x\) est dérivable en \(0\), avec \(x^{\prime}(0) = 0\). Enfin, l’équation en \(t = 0\) s’écrit \(0 – 0 = 0\). Par conséquent, les solutions sur \(\mathbb{R}\) forment un espace de dimension 2, et non 1.
La figure ci-dessous montre trois de ces solutions : chacune recolle deux demi-paraboles indépendantes. Toutes passent par l’origine, donc le problème de Cauchy en \(t_0 = 0\) a une infinité de solutions si \(x_0 = 0\), et aucune sinon.
Le recollement peut aussi imposer des conditions très fortes. Par exemple, pour \(t x^{\prime} + x = 0\), les solutions sur \(]0, +\infty[\) sont les \(C / t\). Elles n’ont de limite finie en \(0\) que si \(C = 0\). Ainsi, la seule solution sur \(\mathbb{R}\) est la fonction nulle.
Ce qu’il faut retenir
- Une équation \(x^{\prime} = a(t) \cdot x + b(t)\) à coefficients continus s’écrit \(X^{\prime} = A(t) X + B(t)\) dans une base, et une équation scalaire d’ordre \(n\) se ramène à un système via \(X = (x, \ldots, x^{(n-1)})\).
- Le problème de Cauchy équivaut à sa forme intégrale, qui ne demande que la continuité.
- Le théorème de Cauchy linéaire donne existence et unicité sur \(I\) tout entier, sans restriction d’intervalle.
- Les solutions homogènes forment un espace de dimension \(n\), et les solutions de l’équation complète un espace affine : solution particulière plus solution homogène.
- Le principe de superposition permet de découper le second membre en morceaux simples.
- Des solutions forment une base si et seulement si leur wronskien est non nul en un point, et à l’ordre 2, \(W^{\prime} = -a W\).
- Connaissant une solution \(x_1\), on trouve la seconde en posant \(x = x_1 z\) ou avec \((x_2 / x_1)^{\prime} = W / x_1^2\).
- La variation des constantes à l’ordre 2 donne \(\lambda^{\prime} = -x_2 g / W\) et \(\mu^{\prime} = x_1 g / W\), après normalisation.
- Pour chercher une solution développable en série entière, on obtient une récurrence sur les coefficients, puis on calcule le rayon et on vérifie.
- Pour une équation non normalisée, on résout sur chaque intervalle puis on raccorde : la dimension de l’espace des solutions sur \(I\) peut alors changer.
Questions fréquentes sur équations différentielles linéaires
Pourquoi l'espace des solutions d'une équation linéaire homogène d'ordre n est-il de dimension n ?
Le théorème de Cauchy linéaire montre que l’application \(x \mapsto (x(t_0), x^{\prime}(t_0), \ldots, x^{(n-1)}(t_0))\) est bijective. Elle est de plus linéaire. C’est donc un isomorphisme entre l’espace des solutions et \(\mathbb{K}^n\).
Comment vérifier rapidement que deux solutions forment une base ?
On calcule leur wronskien \(W = x_1 x_2^{\prime} – x_2 x_1^{\prime}\) en un seul point bien choisi. S’il est non nul en ce point, il ne s’annule nulle part et la famille est une base. S’il est nul en un point, les solutions sont proportionnelles.
Quand faut-il faire un raccordement ?
Dès que le coefficient de la dérivée d’ordre maximal s’annule sur l’intervalle d’étude. On résout alors sur chaque sous-intervalle, avec des constantes indépendantes, puis on impose la continuité et la dérivabilité aux points singuliers. La dimension de l’espace obtenu peut différer de l’ordre de l’équation.
La variation des constantes marche-t-elle sans normaliser l'équation ?
Non. Les formules \(\lambda^{\prime} = -x_2 g / W\) et \(\mu^{\prime} = x_1 g / W\) supposent que le coefficient de \(x^{\prime\prime}\) vaut 1. Il faut donc diviser le second membre par ce coefficient avant de les appliquer.
Pour aller plus loin en maths spé
- Les énoncés : exercices de maths spé sur équations différentielles linéaires
- À maîtriser avant : Fonctions vectorielles d'une variable réelle, Séries entières
- Chapitre précédent : Endomorphismes autoadjoints et théorème spectral
- Chapitre suivant : Exponentielle de matrice et systèmes différentiels
- Le même thème en L1 : équations différentielles, cours de maths en L1
- Le même thème en maths sup : équations différentielles linéaires, cours de maths sup
- Tester vos connaissances : QCM de maths spé par chapitre
- Le sommaire : tous les chapitres de maths spé et les chapitres de maths sup