Ce cours de diagonalisation spé exploite les éléments propres et le polynôme caractéristique vus au chapitre précédent. Vous y apprendrez à reconnaître une matrice diagonalisable, à construire la matrice de passage et à justifier proprement qu’une matrice ne l’est pas. Ces savoir-faire reviennent dans presque toutes les épreuves écrites.
Ensuite, le chapitre traite la trigonalisation, possible dès que le polynôme caractéristique est scindé, donc toujours sur les complexes. Il en déduit les formules de la trace et du déterminant en fonction des valeurs propres. Enfin, il caractérise les matrices nilpotentes par leur spectre.
Ces outils servent aussitôt : calcul des puissances d’une matrice, suites récurrentes linéaires, systèmes différentiels au second semestre. Le chapitre suivant les complète par les polynômes annulateurs et le théorème de Cayley-Hamilton.
Pour vous entraîner ensuite, travaillez les exercices de maths spé sur diagonalisation et trigonalisation.
I. Endomorphismes et matrices diagonalisables
Dans tout le chapitre, \(\mathbb{K}\) désigne \(\mathbb{R}\) ou \(\mathbb{C}\), \(E\) est un \(\mathbb{K}\)-espace vectoriel de dimension finie \(n \geq\, 1\) et \(u\) est un endomorphisme de \(E\). Le chapitre précédent a introduit les valeurs propres, les sous-espaces propres \(E_\lambda(u) = \ker(u – \lambda \,\mathrm{id}_E)\) et le polynôme caractéristique \(\chi_u\). Nous les utilisons maintenant pour simplifier la matrice de \(u\).
L’idée est simple. Une matrice diagonale se manipule sans effort : ses puissances, son déterminant et son rang se lisent directement. On cherche donc une base dans laquelle \(u\) agit par de simples dilatations.
L’endomorphisme \(u\) est diagonalisable s’il existe une base de \(E\) dans laquelle sa matrice est diagonale. Autrement dit, il existe une base de \(E\) formée de vecteurs propres de \(u\).
Une matrice \(A \in \mathcal{M}_n(\mathbb{K})\) est diagonalisable si elle est semblable à une matrice diagonale : il existe \(P \in GL_n(\mathbb{K})\) et \(D\) diagonale telles que \(A = P D P^{-1}\).
Les deux notions se correspondent. En effet, \(A\) est diagonalisable si et seulement si l’endomorphisme de \(\mathbb{K}^n\) canoniquement associé l’est. Dans ce cas, les colonnes de \(P\) forment une base de vecteurs propres, et les coefficients diagonaux de \(D\) sont les valeurs propres associées, dans le même ordre.
La diagonalisabilité d’une matrice réelle dépend du corps choisi. Une matrice de \(\mathcal{M}_n(\mathbb{R})\) peut être diagonalisable dans \(\mathcal{M}_n(\mathbb{C})\) sans l’être dans \(\mathcal{M}_n(\mathbb{R})\). Il faut donc toujours préciser le corps de travail.
1. Caractérisation par les sous-espaces propres
On sait que les sous-espaces propres associés à des valeurs propres distinctes sont en somme directe. Le théorème suivant en tire la caractérisation fondamentale.
Les assertions suivantes sont équivalentes :
- \(u\) est diagonalisable ;
- \(E = \displaystyle\bigoplus_{\lambda \in \operatorname{Sp}(u)} E_\lambda(u)\) ;
- \(\displaystyle\sum_{\lambda \in \operatorname{Sp}(u)} \dim E_\lambda(u) = n\).
Notons \(F\) la somme des sous-espaces propres. Cette somme est directe, donc \(\dim F = \sum \dim E_\lambda(u)\). Ainsi, les deux dernières assertions sont équivalentes, car \(F = E\) équivaut à \(\dim F = n\).
Si \(u\) est diagonalisable, une base de vecteurs propres est contenue dans \(F\). Par conséquent \(F = E\). Réciproquement, si \(F = E\), on concatène des bases des \(E_\lambda(u)\). On obtient une base de \(E\) formée de vecteurs propres, d’où la diagonalisabilité.
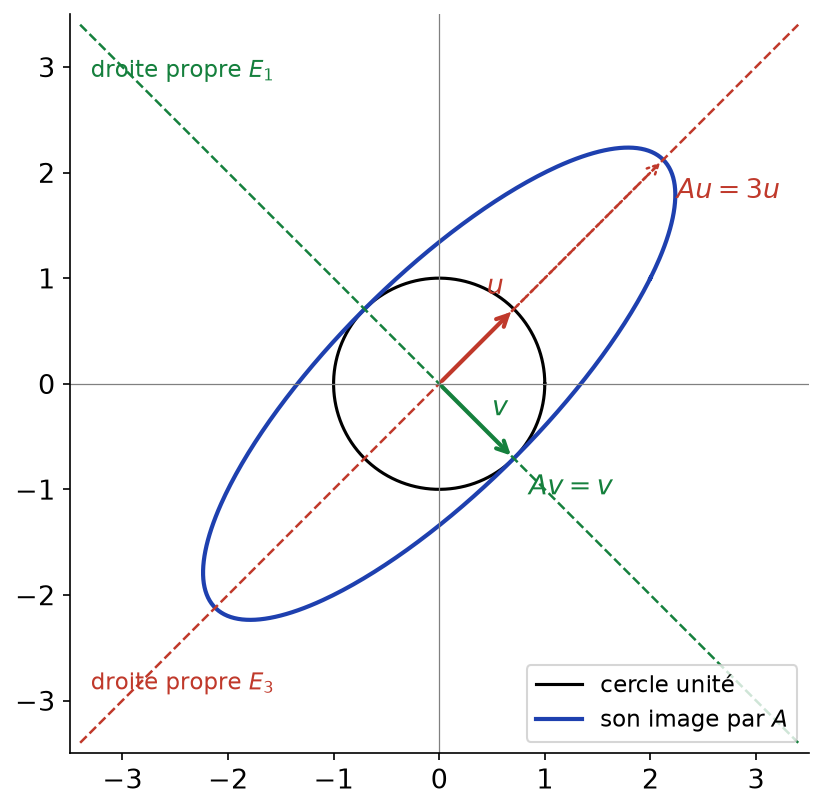
Soit \(A = \begin{pmatrix} 2 1 \\ 1 2 \end{pmatrix}\). On a \(\chi_A = X^2 – 4X + 3 = (X – 1)(X – 3)\). De plus, \(u = (1, 1)\) vérifie \(Au = 3u\) et \(v = (1, -1)\) vérifie \(Av = v\). Les deux droites propres sont supplémentaires, donc \(A\) est diagonalisable :
\[A = P \begin{pmatrix} 3 0 \\ 0 1 \end{pmatrix} P^{-1}, \qquad P = \begin{pmatrix} 1 1 \\ 1 -1 \end{pmatrix}.\]
La figure ci-dessous montre ce que signifie géométriquement la diagonalisation. L’image du cercle unité par \(A\) est une ellipse dont les axes portent les deux droites propres : \(A\) dilate d’un facteur 3 le long de \(E_3\) et laisse fixe la direction \(E_1\).
II. Critères de diagonalisation
1. Le cas de n valeurs propres distinctes
Si \(u\) possède \(n\) valeurs propres distinctes, alors \(u\) est diagonalisable, et chacun de ses sous-espaces propres est une droite.
Chaque sous-espace propre est de dimension au moins 1. La somme des \(n\) dimensions vaut donc au moins \(n\). Or cette somme est directe, donc elle vaut au plus \(n\). Ainsi, elle vaut exactement \(n\) et chaque dimension vaut 1. On conclut par le théorème précédent.
La condition est suffisante mais pas nécessaire. Par exemple, \(I_n\) est diagonale, donc diagonalisable, alors qu’elle n’a qu’une seule valeur propre.
2. Le critère avec le polynôme caractéristique
Rappelons que la multiplicité \(m_\lambda\) d’une valeur propre \(\lambda\) est son ordre de multiplicité comme racine de \(\chi_u\). On a toujours \(1 \leq\, \dim E_\lambda(u) \leq\, m_\lambda\).
L’endomorphisme \(u\) est diagonalisable si et seulement si les deux conditions suivantes sont réunies :
- \(\chi_u\) est scindé sur \(\mathbb{K}\) ;
- pour toute valeur propre \(\lambda\), \(\dim E_\lambda(u) = m_\lambda\).
Supposons \(u\) diagonalisable, de matrice \(D\) diagonale dans une base adaptée. La valeur propre \(\lambda\) apparaît \(d_\lambda = \dim E_\lambda(u)\) fois sur la diagonale. Par conséquent \(\chi_u = \prod_\lambda (X – \lambda)^{d_\lambda}\) : ce polynôme est scindé et \(m_\lambda = d_\lambda\).
Réciproquement, si \(\chi_u\) est scindé, la somme des multiplicités vaut \(\deg \chi_u = n\). Avec l’égalité des dimensions, on obtient \(\sum \dim E_\lambda(u) = n\). Le théorème de la partie I permet alors de conclure.
Pour une valeur propre simple, l’égalité \(\dim E_\lambda(u) = 1 = m_\lambda\) est automatique. En pratique, on ne vérifie donc la dimension que pour les valeurs propres multiples.
Pour diagonaliser une matrice \(A \in \mathcal{M}_n(\mathbb{K})\) :
- calculer \(\chi_A = \det(X I_n – A)\), en factorisant au fur et à mesure grâce aux opérations sur les lignes et les colonnes ;
- vérifier que \(\chi_A\) est scindé sur \(\mathbb{K}\) et lister les valeurs propres avec leurs multiplicités ;
- pour chaque valeur propre, résoudre \((A – \lambda I_n) X = 0\) et donner une base de \(E_\lambda\) ;
- comparer \(\dim E_\lambda\) et \(m_\lambda\) ; si l’égalité vaut partout, ranger les vecteurs trouvés en colonnes dans \(P\) ;
- écrire \(D\) avec les valeurs propres dans l’ordre des colonnes de \(P\), puis contrôler une colonne en calculant \(A P\).
Soit \(A = \begin{pmatrix} 0 1 1 \\ 1 0 1 \\ 1 1 0 \end{pmatrix}\). La somme de chaque ligne vaut 2, donc \((1, 1, 1)\) est propre pour la valeur 2. Ensuite, \(A + I_3\) a toutes ses colonnes égales, donc son rang vaut 1. Ainsi, \(-1\) est valeur propre et \(\dim E_{-1} = 2\). Comme la trace vaut \(0 = 2 + (-1) + (-1)\), on obtient \(\chi_A = (X – 2)(X + 1)^2\). Les dimensions sont égales aux multiplicités, donc \(A\) est diagonalisable :
\[P = \begin{pmatrix} 1 1 0 \\ 1 -1 1 \\ 1 0 -1 \end{pmatrix}, \qquad D = \begin{pmatrix} 2 0 0 \\ 0 -1 0 \\ 0 0 -1 \end{pmatrix}.\]
3. Justifier qu’une matrice n’est pas diagonalisable
Le critère fournit deux obstructions. D’abord, le polynôme caractéristique peut ne pas être scindé. Ensuite, un sous-espace propre peut être trop petit. Un argument très rapide sert aussi souvent : si \(A\) est diagonalisable et n’a qu’une valeur propre \(\lambda\), alors \(A = P(\lambda I_n)P^{-1} = \lambda I_n\).
Pour montrer que \(A\) n’est pas diagonalisable, on utilise l’un des arguments suivants :
- \(\chi_A\) n’est pas scindé sur \(\mathbb{K}\) (par exemple, il a des racines non réelles alors que \(\mathbb{K} = \mathbb{R}\)) ;
- une valeur propre \(\lambda\) vérifie \(\dim E_\lambda < m_\lambda\), ce qu’on obtient par le théorème du rang : \(\dim E_\lambda = n – \operatorname{rg}(A – \lambda I_n)\) ;
- \(A\) a une seule valeur propre \(\lambda\) mais \(A \neq \lambda I_n\).
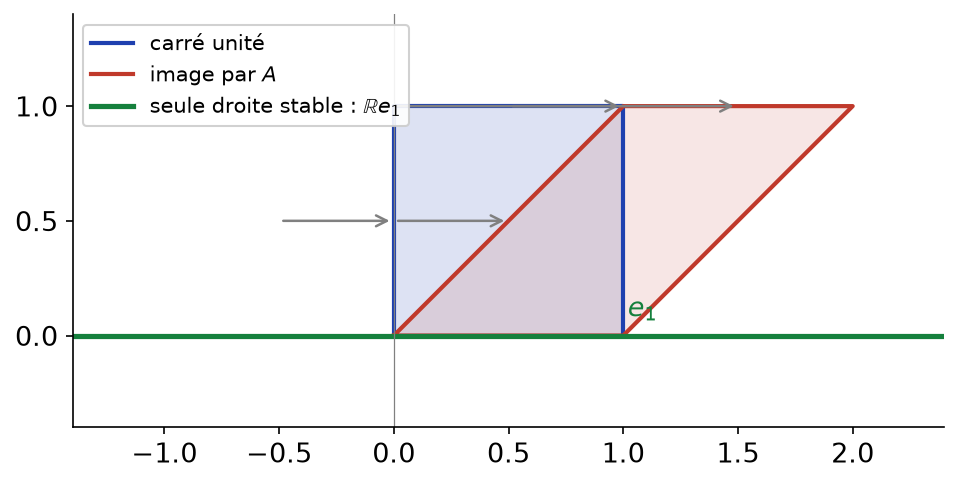
La matrice de cisaillement \(A = \begin{pmatrix} 1 1 \\ 0 1 \end{pmatrix}\) a pour seule valeur propre 1, et \(A \neq I_2\). Par conséquent, elle n’est pas diagonalisable. De fait, \(E_1 = \ker(A – I_2) = \mathbb{K} e_1\) n’est qu’une droite.
La figure suivante illustre ce phénomène : le carré unité est transformé en parallélogramme, et seul l’axe horizontal est conservé. Il manque donc une deuxième direction propre pour former une base.
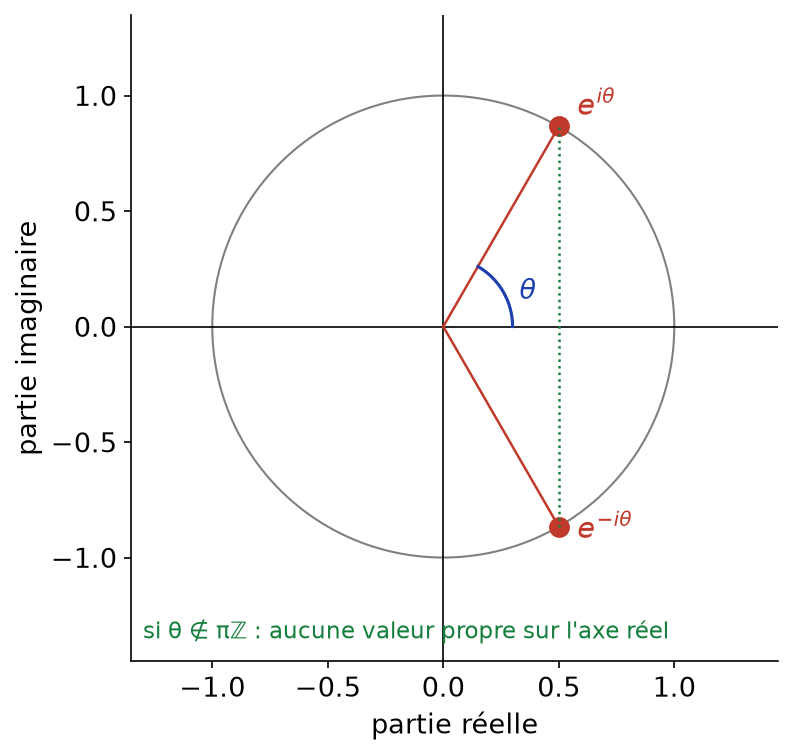
La matrice de rotation \(R_\theta = \begin{pmatrix} \cos\theta -\sin\theta \\ \sin\theta \cos\theta \end{pmatrix}\) a pour polynôme caractéristique \(X^2 – 2\cos\theta \, X + 1\), dont les racines sont \(e^{i\theta}\) et \(e^{-i\theta}\). Si \(\theta \notin \pi\mathbb{Z}\), ces racines ne sont pas réelles : \(R_\theta\) n’est pas diagonalisable dans \(\mathcal{M}_2(\mathbb{R})\). En revanche, elles sont distinctes, donc \(R_\theta\) est diagonalisable dans \(\mathcal{M}_2(\mathbb{C})\).
Comme le montre la figure ci-dessous, les deux valeurs propres complexes sont conjuguées et situées sur le cercle unité, hors de l’axe réel.
III. Puissances et récurrences linéaires
1. Puissances d’une matrice diagonalisable
Si \(A = P D P^{-1}\), alors les facteurs intermédiaires se simplifient. On obtient, par une récurrence immédiate, \(A^k = P D^k P^{-1}\) pour tout entier \(k \geq\, 0\). De plus, \(D^k\) s’obtient en élevant chaque coefficient diagonal à la puissance \(k\).
Si \(A = P \,\mathrm{diag}(\lambda_1, \ldots, \lambda_n)\, P^{-1}\), alors pour tout \(k \in \mathbb{N}\) :
\[A^k = P \,\mathrm{diag}(\lambda_1^k, \ldots, \lambda_n^k)\, P^{-1}.\]
Si de plus \(A\) est inversible, la formule reste vraie pour \(k \in \mathbb{Z}\).
Pour étudier une suite vectorielle définie par \(X_0\) et \(X_{k+1} = A X_k\) :
- écrire \(X_k = A^k X_0\) ;
- diagonaliser \(A\) et décomposer \(X_0 = \sum_i c_i V_i\) sur la base de vecteurs propres \((V_i)\) ;
- en déduire \(X_k = \sum_i c_i \lambda_i^k V_i\), ce qui évite de calculer \(P^{-1}\) ;
- lire le comportement asymptotique sur la valeur propre de plus grand module.
2. Un exemple de modèle d’évolution
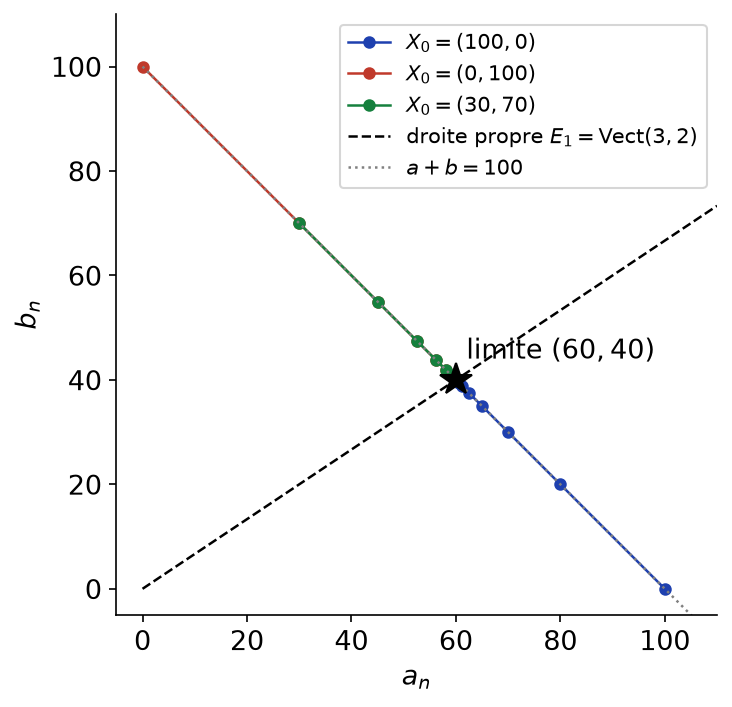
Deux populations évoluent selon \(a_{k+1} = 0{,}8\, a_k + 0{,}3\, b_k\) et \(b_{k+1} = 0{,}2\, a_k + 0{,}7\, b_k\). Autrement dit, \(X_{k+1} = M X_k\) avec \(M = \begin{pmatrix} 0{,}8 0{,}3 \\ 0{,}2 0{,}7 \end{pmatrix}\). La trace vaut \(1{,}5\) et le déterminant \(0{,}5\), donc \(\chi_M = (X – 1)(X – 0{,}5)\). Les vecteurs propres sont \((3, 2)\) pour 1 et \((1, -1)\) pour \(0{,}5\). Pour \(X_0 = (100, 0)\), on trouve \(X_0 = 20\,(3, 2) + 40\,(1, -1)\), donc :
\[X_k = 20 \begin{pmatrix} 3 \\ 2 \end{pmatrix} + \frac{40}{2^k} \begin{pmatrix} 1 \\ -1 \end{pmatrix} \xrightarrow[k \to +\infty]{ \begin{pmatrix} 60 \\ 40 \end{pmatrix}.\]
La figure ci-dessous représente plusieurs trajectoires dans le plan. Toutes restent sur la droite \(a + b = 100\), car le total est conservé, et convergent vers le point de la droite propre \(E_1\).
3. Récurrences linéaires scalaires
Une suite définie par \(u_{k+2} = \alpha\, u_{k+1} + \beta\, u_k\) se ramène au cas vectoriel. On pose \(X_k = (u_k, u_{k+1})\), et alors \(X_{k+1} = C X_k\) avec \(C = \begin{pmatrix} 0 1 \\ \beta \alpha \end{pmatrix}\). Le polynôme caractéristique de \(C\) vaut \(X^2 – \alpha X – \beta\) : on retrouve l’équation caractéristique de la récurrence. Si ses racines \(r_1 \neq r_2\) sont dans \(\mathbb{K}\), la diagonalisation donne \(u_k = c_1 r_1^k + c_2 r_2^k\).
IV. La trigonalisation
Toutes les matrices ne sont pas diagonalisables. On se contente alors d’une forme triangulaire, qui conserve l’essentiel des informations spectrales.
L’endomorphisme \(u\) est trigonalisable s’il existe une base de \(E\) dans laquelle sa matrice est triangulaire supérieure. Une matrice \(A\) est trigonalisable si elle est semblable à une matrice triangulaire supérieure \(T\).
Si \((e_1, \ldots, e_n)\) est une base de trigonalisation, alors chaque sous-espace \(\mathrm{Vect}(e_1, \ldots, e_k)\) est stable par \(u\). En particulier, \(e_1\) est un vecteur propre. Par ailleurs, les coefficients diagonaux de \(T\) sont exactement les valeurs propres, répétées selon leur multiplicité, puisque \(\chi_u = \prod_{i}(X – t_{ii})\).
L’endomorphisme \(u\) est trigonalisable si et seulement si son polynôme caractéristique \(\chi_u\) est scindé sur \(\mathbb{K}\).
Si la matrice de \(u\) est triangulaire, on vient de voir que \(\chi_u = \prod_i (X – t_{ii})\) est scindé.
Pour la réciproque, on raisonne par récurrence sur \(n\), le cas \(n = 1\) étant clair. Supposons \(\chi_A\) scindé, avec \(A \in \mathcal{M}_n(\mathbb{K})\) et \(n \geq\, 2\). Il possède une racine \(\lambda\), donc un vecteur propre \(e_1\). On complète \(e_1\) en une base de \(\mathbb{K}^n\). Ainsi, \(A\) est semblable à une matrice par blocs :
\[\begin{pmatrix} \lambda L \\ 0 A_1 \end{pmatrix}, \qquad A_1 \in \mathcal{M}_{n-1}(\mathbb{K}).\]
Le déterminant d’une matrice triangulaire par blocs donne \(\chi_A = (X – \lambda)\,\chi_{A_1}\). Par conséquent, \(\chi_{A_1}\) est scindé. Par hypothèse de récurrence, \(A_1 = Q T_1 Q^{-1}\) avec \(T_1\) triangulaire. Enfin, la matrice \(R = \begin{pmatrix} 1 0 \\ 0 Q \end{pmatrix}\) conjugue la matrice par blocs en \(\begin{pmatrix} \lambda L Q \\ 0 T_1 \end{pmatrix}\), qui est triangulaire.
Toute matrice de \(\mathcal{M}_n(\mathbb{C})\) est trigonalisable, car tout polynôme non constant est scindé sur \(\mathbb{C}\) (théorème de d’Alembert-Gauss). Une matrice réelle est donc toujours trigonalisable dans \(\mathcal{M}_n(\mathbb{C})\).
Pour trigonaliser une matrice \(A\) de taille 2 ou 3 non diagonalisable :
- taille 2, avec \(\chi_A = (X – \lambda)^2\) : on choisit un vecteur propre \(V_1\), puis un vecteur \(V_2\) non colinéaire. Alors \(A V_2 = \lambda V_2 + c\, V_1\), et on peut même choisir \(V_2\) tel que \((A – \lambda I_2) V_2 = V_1\), ce qui donne \(T = \begin{pmatrix} \lambda 1 \\ 0 \lambda \end{pmatrix}\) ;
- taille 3, avec \(\chi_A = (X – \lambda)^2 (X – \mu)\), \(\lambda \neq \mu\) et \(\dim E_\lambda = 1\) : on prend \(V_1 \in E_\lambda\) et \(V_3 \in E_\mu\) non nuls, puis on résout \((A – \lambda I_3) V_2 = V_1\). Dans la base \((V_1, V_2, V_3)\), on obtient \(T = \begin{pmatrix} \lambda 1 0 \\ 0 \lambda 0 \\ 0 0 \mu \end{pmatrix}\).
Soit \(A = \begin{pmatrix} 3 1 \\ -1 1 \end{pmatrix}\). On a \(\operatorname{tr} A = 4\) et \(\det A = 4\), donc \(\chi_A = (X – 2)^2\). Comme \(A \neq 2 I_2\), la matrice n’est pas diagonalisable. Le vecteur \(V_1 = (1, -1)\) est propre. Ensuite, \(V_2 = (1, 0)\) vérifie \(A V_2 = (3, -1) = 2 V_2 + V_1\). Ainsi :
\[A = P \begin{pmatrix} 2 1 \\ 0 2 \end{pmatrix} P^{-1}, \qquad P = \begin{pmatrix} 1 1 \\ -1 0 \end{pmatrix}.\]
De plus, \(T = 2 I_2 + N\) avec \(N^2 = 0\), et ces deux matrices commutent. La formule du binôme donne donc \(T^k = 2^k I_2 + k\, 2^{k-1} N\).
V. Trace, déterminant et valeurs propres
La trigonalisation fournit des formules très utiles. Elles relient deux invariants simples à calculer, la trace et le déterminant, au spectre complet.
Si \(\chi_A\) est scindé, de racines \(\lambda_1, \ldots, \lambda_n\) comptées avec multiplicité, alors :
\[\operatorname{tr} A = \sum_{i=1}^{n} \lambda_i, \qquad \det A = \prod_{i=1}^{n} \lambda_i.\]
C’est toujours le cas dans \(\mathbb{C}\) : pour \(A\) réelle, on utilise ses valeurs propres complexes.
La matrice \(A\) est semblable à une matrice triangulaire \(T\) de diagonale \((\lambda_1, \ldots, \lambda_n)\). Or deux matrices semblables ont même trace et même déterminant. Enfin, la trace de \(T\) est la somme de ses coefficients diagonaux, et son déterminant en est le produit.
Avec les mêmes notations, pour tout \(k \in \mathbb{N}\), les valeurs propres de \(A^k\) sont les \(\lambda_i^k\), avec multiplicité, et \(\operatorname{tr}(A^k) = \sum_{i=1}^{n} \lambda_i^k\).
En effet, \(A^k\) est semblable à \(T^k\), qui est triangulaire de diagonale \((\lambda_1^k, \ldots, \lambda_n^k)\).
Une matrice \(A \in \mathcal{M}_3(\mathbb{R})\) de trace 6 admet 1 et 2 pour valeurs propres, et \(\chi_A\) est scindé. La troisième valeur propre vaut \(6 – 1 – 2 = 3\). Ainsi, \(\det A = 1 \times 2 \times 3 = 6\) et \(A\) est diagonalisable, puisqu’elle a trois valeurs propres distinctes.
VI. Endomorphismes et matrices nilpotents
L’endomorphisme \(u\) est nilpotent s’il existe \(p \in \mathbb{N}^*\) tel que \(u^p = 0\). Le plus petit tel entier est l’indice de nilpotence de \(u\). La même définition vaut pour une matrice.
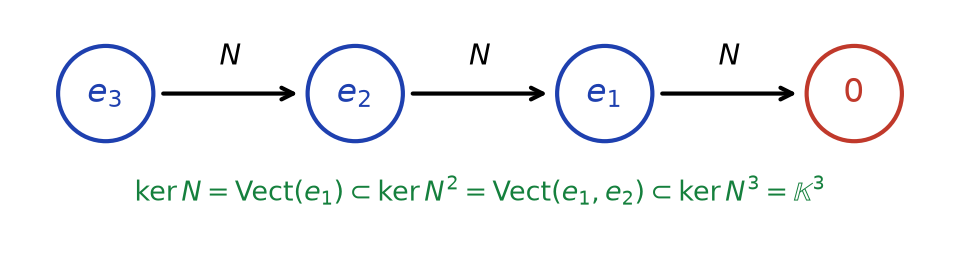
Soit \(N = \begin{pmatrix} 0 1 0 \\ 0 0 1 \\ 0 0 0 \end{pmatrix}\). On a \(N e_1 = 0\), \(N e_2 = e_1\) et \(N e_3 = e_2\). Donc \(N^2 \neq 0\) car \(N^2 e_3 = e_1\), tandis que \(N^3 = 0\). L’indice de nilpotence vaut 3.
La figure ci-dessous représente cette chaîne : chaque application de \(N\) fait descendre d’un cran, jusqu’au vecteur nul. On y lit aussi la croissance stricte des noyaux itérés.
Pour \(A \in \mathcal{M}_n(\mathbb{C})\), les assertions suivantes sont équivalentes :
- \(A\) est nilpotente ;
- \(\operatorname{Sp}(A) = \{0\}\) ;
- \(\chi_A = X^n\) ;
- \(A\) est semblable à une matrice triangulaire supérieure stricte.
Dans ce cas, \(A^n = 0\) : l’indice de nilpotence est au plus \(n\).
Si \(A^p = 0\) et \(A X = \lambda X\) avec \(X \neq 0\), alors \(0 = A^p X = \lambda^p X\), donc \(\lambda = 0\). Comme \(\chi_A\) est scindé sur \(\mathbb{C}\), on a bien \(\operatorname{Sp}(A) = \{0\}\), puis \(\chi_A = X^n\).
Si \(\chi_A = X^n\), le théorème de trigonalisation donne \(T\) triangulaire de diagonale nulle, c’est-à-dire strictement triangulaire. Enfin, si \(T\) est strictement triangulaire, on a \(T e_1 = 0\) et \(T e_j \in \mathrm{Vect}(e_1, \ldots, e_{j-1})\). Par récurrence sur \(k\), \(T^k e_j \in \mathrm{Vect}(e_1, \ldots, e_{j-k})\), cet espace étant nul pour \(j \leq\, k\). Par conséquent \(T^n = 0\), donc \(A^n = 0\).
Pour une matrice réelle, on applique ce théorème en la voyant dans \(\mathcal{M}_n(\mathbb{C})\). Ainsi, \(A \in \mathcal{M}_n(\mathbb{R})\) est nilpotente si et seulement si \(\chi_A = X^n\). En revanche, la condition \(\operatorname{Sp}_{\mathbb{R}}(A) = \{0\}\) ne suffit pas : la matrice \(\mathrm{diag}(0, R_{\pi/2})\) n’a que 0 comme valeur propre réelle et n’est pas nilpotente.
Soit \(N\) nilpotente. Alors \(\operatorname{tr} N = 0\) et \(\det N = 0\). De plus, si \(N\) est diagonalisable, alors \(N = 0\).
Toutes les valeurs propres complexes de \(N\) sont nulles, donc leur somme et leur produit aussi. Par ailleurs, si \(N = P D P^{-1}\), la diagonale de \(D\) ne contient que des valeurs propres, donc \(D = 0\) et \(N = 0\).
Le chapitre suivant introduit les polynômes annulateurs et le théorème de Cayley-Hamilton. Ils donneront des critères de diagonalisation plus algébriques, mais les méthodes de ce chapitre restent celles qu’on applique sur des matrices explicites.
Ce qu’il faut retenir
- \(u\) est diagonalisable si et seulement si \(E\) est la somme directe de ses sous-espaces propres, c’est-à-dire si \(\sum \dim E_\lambda = n\).
- \(n\) valeurs propres distinctes suffisent pour diagonaliser, mais ne sont pas nécessaires.
- Critère général : \(\chi_u\) scindé et \(\dim E_\lambda = m_\lambda\) pour toute valeur propre multiple.
- Une matrice diagonalisable à une seule valeur propre \(\lambda\) est égale à \(\lambda I_n\).
- \(A^k = P D^k P^{-1}\) : c’est l’outil des suites récurrentes linéaires vectorielles.
- Trigonalisable équivaut à \(\chi\) scindé ; toute matrice complexe est trigonalisable.
- Avec les valeurs propres complexes comptées avec multiplicité, \(\operatorname{tr} A = \sum \lambda_i\) et \(\det A = \prod \lambda_i\).
- \(A \in \mathcal{M}_n(\mathbb{C})\) est nilpotente si et seulement si son spectre est \(\{0\}\) ; son indice est alors au plus \(n\).
- Une matrice nilpotente et diagonalisable est nulle.
Questions fréquentes sur diagonalisation et trigonalisation
Comment montrer rapidement qu'une matrice n'est pas diagonalisable ?
Trois arguments suffisent presque toujours. Le polynôme caractéristique n’est pas scindé sur le corps de travail, ou bien un sous-espace propre a une dimension strictement inférieure à la multiplicité, que l’on calcule par le théorème du rang. Enfin, une matrice diagonalisable ayant une seule valeur propre \(\lambda\) est forcément égale à \(\lambda I_n\).
Faut-il toujours calculer l'inverse de la matrice de passage ?
Non. Pour vérifier une diagonalisation, il suffit de contrôler \(AP = PD\). Pour une suite \(X_{k+1} = AX_k\), on décompose \(X_0\) sur la base de vecteurs propres, ce qui évite aussi \(P^{-1}\). L’inverse n’est utile que pour écrire explicitement tous les coefficients de \(A^k\).
Quelle est la différence entre diagonalisable et trigonalisable ?
Une matrice est trigonalisable si et seulement si son polynôme caractéristique est scindé ; c’est toujours le cas sur \(\mathbb{C}\). Pour être diagonalisable, il faut en plus que chaque sous-espace propre ait pour dimension la multiplicité de la valeur propre. Ainsi, \(\begin{pmatrix} 1 & 1 \\ 0 & 1 \end{pmatrix}\) est trigonalisable mais pas diagonalisable.
Comment reconnaître une matrice nilpotente ?
Une matrice complexe est nilpotente si et seulement si 0 est sa seule valeur propre, c’est-à-dire si \(\chi_A = X^n\). Son indice de nilpotence est alors au plus \(n\), donc \(A^n = 0\). Une matrice nilpotente non nulle n’est jamais diagonalisable.
Pour aller plus loin en maths spé
- Les énoncés : exercices de maths spé sur diagonalisation et trigonalisation
- À maîtriser avant : Éléments propres et polynôme caractéristique
- Chapitre précédent : Éléments propres et polynôme caractéristique
- Chapitre suivant : Polynômes d'endomorphismes et Cayley-Hamilton
- Tester vos connaissances : QCM de maths spé par chapitre
- Le sommaire : tous les chapitres de maths spé et les chapitres de maths sup