Ce cours de systèmes différentiels spé introduit un outil central de la fin d’année : l’exponentielle de matrice. Vous verrez comment la définir par une série, comment la calculer pour une matrice diagonale, nilpotente ou semblable à une matrice simple, et pourquoi son spectre se déduit de celui de la matrice de départ.
La seconde partie applique cet outil aux systèmes différentiels linéaires homogènes à coefficients constants. La solution du problème de Cauchy s’écrit simplement avec \(\exp(tA)\). En pratique, on la calcule par diagonalisation ou par trigonalisation, surtout en dimension 2 ou 3.
Enfin, le chapitre étudie le comportement des solutions selon le signe des parties réelles des valeurs propres. Ce résultat de stabilité sert ensuite en calcul différentiel, en mécanique et dans de nombreux problèmes de concours.
Pour vous entraîner ensuite, travaillez les exercices de maths spé sur systèmes différentiels linéaires.
I. Exponentielle d’une matrice et d’un endomorphisme
Dans tout le chapitre, \(\mathbb{K}\) désigne \(\mathbb{R}\) ou \(\mathbb{C}\) et \(n\) est un entier non nul. On munit \(\mathcal{M}_{n}(\mathbb{K})\) d’une norme sous-multiplicative, c’est-à-dire vérifiant \(\|AB\| \leq\, \|A\| \, \|B\|\). Par exemple, toute norme subordonnée convient. En dimension finie, toutes les normes sont équivalentes : les notions de convergence et de continuité ne dépendent donc pas de ce choix.
1. Définition
L’idée est simple. Pour un réel \(a\), on sait que \(e^{a} = \sum a^{k}/k!\). On remplace alors \(a\) par une matrice, ce qui a un sens car on sait calculer les puissances d’une matrice.
Pour toute matrice \(A \in \mathcal{M}_{n}(\mathbb{K})\), la série \(\sum \dfrac{A^{k}}{k!}\) converge absolument. Sa somme est appelée exponentielle de \(A\) et se note \[\exp(A) = e^{A} = \sum_{k=0}^{+\infty} \dfrac{A^{k}}{k!}, \quad \text{avec } A^{0} = I_{n}.\]
Par sous-multiplicativité, on a \(\|A^{k}\| \leq\, \|A\|^{k}\) pour \(k \geq\, 1\). Ainsi \(\| \dfrac{A^{k}}{k!} \| \leq\, \dfrac{\|A\|^{k}}{k!}\), terme général de la série exponentielle réelle, qui converge. La série converge donc absolument. Or \(\mathcal{M}_{n}(\mathbb{K})\) est de dimension finie, donc complet : la série converge.
De la même façon, si \(E\) est un \(\mathbb{K}\)-espace vectoriel de dimension finie et \(u \in \mathcal{L}(E)\), on définit \(\exp(u) = \sum_{k \geq\, 0} u^{k}/k!\). Si \(A\) est la matrice de \(u\) dans une base \(\mathcal{B}\), alors \(\exp(A)\) est la matrice de \(\exp(u)\) dans \(\mathcal{B}\). En effet, l’application qui envoie un endomorphisme sur sa matrice est linéaire, continue et multiplicative.
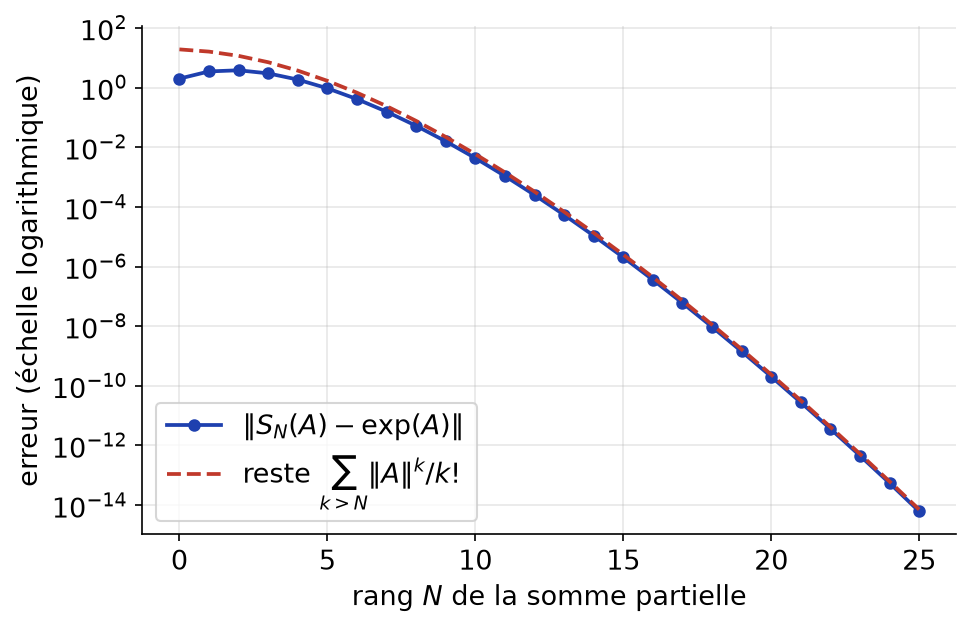
La convergence est très rapide. Par exemple, pour \(A = \begin{pmatrix} 0 -3 \\ 3 0 \end{pmatrix}\), la figure ci-dessous montre l’erreur commise en tronquant la série au rang \(N\). Elle est majorée par le reste \(\sum_{k > N} \|A\|^{k}/k!\), qui décroît plus vite que toute suite géométrique.
2. Premiers calculs
Matrice diagonale. Si \(D = \mathrm{diag}(\lambda_{1}, \ldots, \lambda_{n})\), alors \(D^{k} = \mathrm{diag}(\lambda_{1}^{k}, \ldots, \lambda_{n}^{k})\). En sommant coefficient par coefficient, on obtient \[\exp(D) = \mathrm{diag}(e^{\lambda_{1}}, \ldots, e^{\lambda_{n}}).\]
Matrice nilpotente. Si \(N^{p} = 0\), la série est en fait une somme finie : \(\exp(N) = \sum_{k=0}^{p-1} N^{k}/k!\). Par exemple, avec \(N = \begin{pmatrix} 0 1 \\ 0 0 \end{pmatrix}\), on a \(N^{2} = 0\), donc \(\exp(tN) = I_{2} + tN = \begin{pmatrix} 1 t \\ 0 1 \end{pmatrix}\).
Matrice de rotation. Soit \(J = \begin{pmatrix} 0 -1 \\ 1 0 \end{pmatrix}\). Comme \(J^{2} = -I_{2}\), les puissances paires valent \((-1)^{p} I_{2}\) et les impaires \((-1)^{p} J\). En séparant les deux sous-séries, on trouve \[\exp(\theta J) = \cos \theta \, I_{2} + \sin \theta \, J = \begin{pmatrix} \cos \theta -\sin \theta \\ \sin \theta \cos \theta \end{pmatrix}.\]
II. Propriétés de l’exponentielle matricielle
1. Matrices semblables et spectre
Soit \(P \in GL_{n}(\mathbb{K})\). Alors \(\exp(P A P^{-1}) = P \exp(A) P^{-1}\). De plus, \(\exp(A)\) commute avec \(A\) et appartient au sous-espace \(\mathbb{K}[A]\).
D’abord, \((PAP^{-1})^{k} = P A^{k} P^{-1}\) par récurrence. Ensuite, l’application \(M \mapsto P M P^{-1}\) est linéaire en dimension finie, donc continue. On peut ainsi passer à la limite dans les sommes partielles. De même, chaque somme partielle est un polynôme en \(A\) ; or \(\mathbb{K}[A]\) est un sous-espace de dimension finie, donc fermé. La limite \(\exp(A)\) y appartient, et elle commute avec \(A\).
Par conséquent, pour une matrice diagonalisable \(A = P D P^{-1}\), on obtient directement \(\exp(A) = P \exp(D) P^{-1}\). Le calcul se ramène donc à une diagonalisation.
Soit \(A \in \mathcal{M}_{n}(\mathbb{C})\) de valeurs propres \(\lambda_{1}, \ldots, \lambda_{n}\), comptées avec multiplicité. Alors les valeurs propres de \(\exp(A)\) sont \(e^{\lambda_{1}}, \ldots, e^{\lambda_{n}}\). En particulier, \[\det(\exp(A)) = e^{\mathrm{tr}(A)} \neq 0,\] donc \(\exp(A)\) est toujours inversible.
Sur \(\mathbb{C}\), la matrice \(A\) est trigonalisable : \(A = P T P^{-1}\) avec \(T\) triangulaire supérieure de diagonale \((\lambda_{1}, \ldots, \lambda_{n})\). Or \(T^{k}\) est triangulaire supérieure de diagonale \((\lambda_{1}^{k}, \ldots, \lambda_{n}^{k})\). En passant à la limite, \(\exp(T)\) est triangulaire supérieure de diagonale \((e^{\lambda_{1}}, \ldots, e^{\lambda_{n}})\). Enfin, \(\exp(A) = P \exp(T) P^{-1}\) a le même polynôme caractéristique que \(\exp(T)\). Le déterminant vaut donc \(\prod e^{\lambda_{i}} = e^{\sum \lambda_{i}} = e^{\mathrm{tr}(A)}\).
Une matrice réelle de déterminant négatif n’est jamais l’exponentielle d’une matrice réelle, puisque \(e^{\mathrm{tr}(A)} > 0\). De plus, l’exponentielle n’est pas injective : \(\exp(2\pi J) = I_{2} = \exp(0)\).
2. Continuité de l’exponentielle
L’application \(\exp : \mathcal{M}_{n}(\mathbb{K}) \to \mathcal{M}_{n}(\mathbb{K})\) est continue.
Chaque application \(A \mapsto A^{k}/k!\) est continue, car polynomiale en les coefficients. Fixons \(R > 0\). Sur la boule fermée \(\overline{B}(0, R)\), on a \(\|A^{k}/k!\| \leq\, R^{k}/k!\), terme d’une série convergente indépendant de \(A\). La série converge donc normalement sur cette boule, et sa somme y est continue. Comme tout point est intérieur à une telle boule, \(\exp\) est continue partout.
La continuité permet de passer à la limite dans des égalités. Par exemple, pour \(A\) fixée, on a \(( I_{n} + \frac{A}{p} )^{p} \to \exp(A)\) quand \(p \to +\infty\), ce qui prolonge la formule réelle \((1 + a/p)^{p} \to e^{a}\). De même, si une suite de matrices \(A_{p}\) converge vers \(A\), alors \(\exp(A_{p})\) converge vers \(\exp(A)\). On peut ainsi établir une propriété sur les matrices diagonalisables, qui sont denses dans \(\mathcal{M}_{n}(\mathbb{C})\), puis l’étendre à toutes les matrices lorsque les deux membres sont continus. C’est une autre façon de démontrer la formule \(\det(\exp A) = e^{\mathrm{tr}(A)}\).
III. Dérivation et exponentielle d’une somme
1. Dérivée de t ↦ exp(tA)
Soit \(A \in \mathcal{M}_{n}(\mathbb{K})\). L’application \(\varphi : t \mapsto \exp(tA)\) est de classe \(\mathcal{C}^{1}\) sur \(\mathbb{R}\), et \[\varphi^{\prime}(t) = A \exp(tA) = \exp(tA) A.\]
Posons \(u_{k}(t) = \dfrac{t^{k}}{k!} A^{k}\). Chaque \(u_{k}\) est de classe \(\mathcal{C}^{1}\), avec \(u_{k}^{\prime}(t) = \dfrac{t^{k-1}}{(k-1)!} A^{k}\) pour \(k \geq\, 1\). Sur un segment \([-a, a]\), on a \(\|u_{k}^{\prime}(t)\| \leq\, \|A\| \dfrac{(a \|A\|)^{k-1}}{(k-1)!}\). La série des dérivées converge donc normalement sur tout segment. De plus, \(\sum u_{k}\) converge simplement. D’après le théorème de dérivation terme à terme, \(\varphi\) est \(\mathcal{C}^{1}\) et \[\varphi^{\prime}(t) = \sum_{k=1}^{+\infty} \dfrac{t^{k-1}}{(k-1)!} A^{k} = A \sum_{j=0}^{+\infty} \dfrac{t^{j}}{j!} A^{j} = A \exp(tA).\] Enfin, \(A\) commute avec \(\exp(tA)\).
2. Exponentielle d’une somme de matrices qui commutent
Si \(A\) et \(B\) commutent, alors \(\exp(A + B) = \exp(A) \exp(B)\). En particulier, \(\exp(A)\) est inversible d’inverse \(\exp(-A)\), et \(\exp((s + t)A) = \exp(sA) \exp(tA)\).
Comme \(AB = BA\), la matrice \(B\) commute avec chaque somme partielle de \(\exp(tA)\), donc avec \(\exp(tA)\) par passage à la limite. Posons \(f(t) = \exp(-t(A+B)) \exp(tA) \exp(tB)\). Toutes ces matrices commutent entre elles. En dérivant le produit, on obtient \[f^{\prime}(t) = \exp(-t(A+B)) ( -(A + B) + A + B ) \exp(tA) \exp(tB) = 0.\] Ainsi \(f\) est constante sur l’intervalle \(\mathbb{R}\), égale à \(f(0) = I_{n}\). En prenant \(t = 1\) et \(B = 0\) d’abord, on voit que \(\exp(-A)\exp(A) = I_{n}\). Ensuite, pour \(t = 1\) dans le cas général, on conclut.
Sans l’hypothèse de commutation, la formule est fausse en général. Par exemple, avec \(A = \begin{pmatrix} 0 1 \\ 0 0 \end{pmatrix}\) et \(B = \begin{pmatrix} 0 0 \\ 1 0 \end{pmatrix}\), on trouve \(\exp(A)\exp(B) = \begin{pmatrix} 2 1 \\ 1 1 \end{pmatrix}\), alors que \(\exp(A + B)\) a pour coefficient diagonal \(\mathrm{ch}(1) \approx 1{,}54\).
Calculer l’exponentielle d’une matrice non diagonalisable. On écrit \(A = \lambda I_{n} + N\) avec \(N\) nilpotente, lorsque \(A\) n’a qu’une valeur propre \(\lambda\). Comme \(\lambda I_{n}\) commute avec \(N\), on a \[\exp(tA) = e^{\lambda t} \exp(tN) = e^{\lambda t} \sum_{k=0}^{n-1} \dfrac{t^{k}}{k!} N^{k}.\] Par Cayley-Hamilton, \(N = A – \lambda I_{n}\) vérifie bien \(N^{n} = 0\).
Soit \(A = \begin{pmatrix} 3 -1 \\ 1 1 \end{pmatrix}\). Son polynôme caractéristique vaut \(X^{2} – 4X + 4 = (X – 2)^{2}\). Posons \(N = A – 2I_{2} = \begin{pmatrix} 1 -1 \\ 1 -1 \end{pmatrix}\) ; on vérifie que \(N^{2} = 0\). Donc \[\exp(tA) = e^{2t} (I_{2} + tN) = e^{2t} \begin{pmatrix} 1 + t -t \\ t 1 – t \end{pmatrix}.\]
IV. Systèmes différentiels linéaires à coefficients constants
1. Le problème de Cauchy
On appelle système différentiel linéaire homogène à coefficients constants une équation \(X^{\prime} = AX\), où \(A \in \mathcal{M}_{n}(\mathbb{K})\) est fixée et l’inconnue \(X : I \to \mathbb{K}^{n}\) est dérivable. De manière intrinsèque, on étudie \(x^{\prime} = a(x)\), avec \(a \in \mathcal{L}(E)\) et \(x : I \to E\).
Résolution du problème de Cauchy. Soient \(t_{0} \in \mathbb{R}\) et \(X_{0} \in \mathbb{K}^{n}\). Le problème \(X^{\prime} = AX\), \(X(t_{0}) = X_{0}\) admet une unique solution sur \(\mathbb{R}\) : \[X(t) = \exp((t – t_{0}) A) X_{0}.\] De même, la solution de \(x^{\prime} = a(x)\), \(x(t_{0}) = x_{0}\) est \(x(t) = \exp((t – t_{0}) a)(x_{0})\).
Existence. D’après la partie III, \(X\) est dérivable et \(X^{\prime}(t) = A \exp((t – t_{0})A) X_{0} = A X(t)\). De plus, \(X(t_{0}) = I_{n} X_{0} = X_{0}\).
Unicité. Soit \(Y\) une solution sur un intervalle \(I\) contenant \(t_{0}\). Posons \(Z(t) = \exp(-(t – t_{0})A) Y(t)\). Alors \[Z^{\prime}(t) = -A \exp(-(t – t_{0})A) Y(t) + \exp(-(t – t_{0})A) A Y(t) = 0,\] car \(A\) commute avec son exponentielle. Donc \(Z\) est constante sur l’intervalle \(I\), égale à \(Z(t_{0}) = X_{0}\). Finalement, \(Y(t) = \exp((t – t_{0})A) X_{0}\).
L’ensemble \(\mathcal{S}\) des solutions de \(X^{\prime} = AX\) sur \(\mathbb{R}\) est un espace vectoriel de dimension \(n\). En effet, l’application \(X \mapsto X(t_{0})\) est un isomorphisme de \(\mathcal{S}\) sur \(\mathbb{K}^{n}\).
Résolvons \(x^{\prime} = -x\), \(y^{\prime} = x – y\) avec la condition \(X(1) = (1, 0)\). La matrice s’écrit \(A = -I_{2} + N\) avec \(N = \begin{pmatrix} 0 0 \\ 1 0 \end{pmatrix}\) et \(N^{2} = 0\). Ainsi, \(\exp(sA) = e^{-s}\begin{pmatrix} 1 0 \\ s 1 \end{pmatrix}\). D’après le théorème, avec \(s = t – 1\), on obtient \[X(t) = e^{1 – t}\begin{pmatrix} 1 \\ t – 1 \end{pmatrix}.\] On vérifie que \(y^{\prime}(t) = e^{1 – t} – (t – 1)e^{1 – t} = x(t) – y(t)\). Remarquez que l’instant initial \(t_{0} = 1\) apparaît seulement à travers le décalage \(t – t_{0}\).
La formule \(X(t) = \exp((t – t_{0})A)X_{0}\) montre aussi que la solution est définie sur \(\mathbb{R}\) tout entier : il n’y a jamais d’explosion en temps fini. C’est une différence majeure avec les équations non linéaires. De plus, la solution dépend linéairement et continûment de la condition initiale \(X_{0}\).
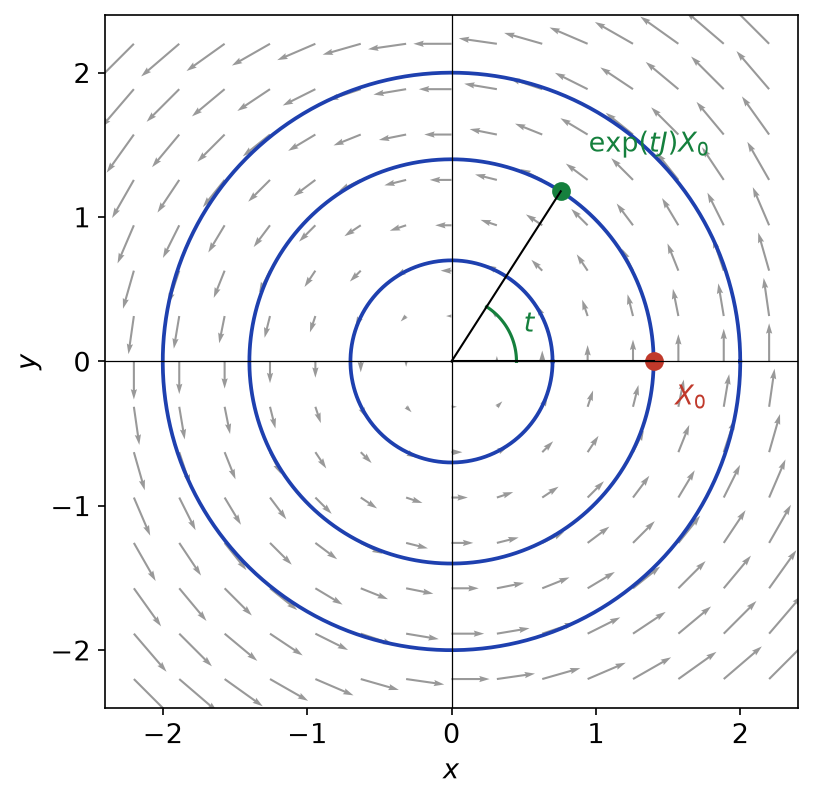
Considérons \(X^{\prime} = JX\) avec la matrice \(J\) de rotation. D’après la partie I, la solution telle que \(X(0) = X_{0}\) est \(X(t) = \exp(tJ) X_{0}\) : c’est le vecteur \(X_{0}\) tourné d’un angle \(t\). Les trajectoires sont donc des cercles centrés en l’origine, parcourus dans le sens direct, comme le montre la figure ci-dessous.
2. Lien avec les équations scalaires d’ordre n
Une équation \(y^{\prime\prime} + p y^{\prime} + q y = 0\) à coefficients constants se ramène à un système. En effet, on pose \(X = (y, y^{\prime})\). L’équation devient alors \(X^{\prime} = AX\) avec la matrice compagnon \(A = \begin{pmatrix} 0 1 \\ -q -p \end{pmatrix}\). Son polynôme caractéristique \(X^{2} + pX + q\) est exactement l’équation caractéristique vue en première année.
V. Résolution pratique des systèmes différentiels
1. Cas diagonalisable
Résoudre \(X^{\prime} = AX\) avec \(A\) diagonalisable.
- On cherche une base de vecteurs propres \((V_{1}, \ldots, V_{n})\), associés à \(\lambda_{1}, \ldots, \lambda_{n}\).
- Les fonctions \(t \mapsto e^{\lambda_{i} t} V_{i}\) sont solutions, car \(A e^{\lambda_{i} t} V_{i} = \lambda_{i} e^{\lambda_{i} t} V_{i}\).
- Elles forment une base de \(\mathcal{S}\) : la solution générale est \(X(t) = \sum c_{i} e^{\lambda_{i} t} V_{i}\).
- Enfin, on ajuste les constantes \(c_{i}\) en décomposant \(X_{0}\) dans la base \((V_{i})\).
Autrement dit, dans la base propre, le système se découple en \(n\) équations scalaires \(y_{i}^{\prime} = \lambda_{i} y_{i}\). On pose en effet \(X = PY\), et \(Y^{\prime} = DY\).
Soit le système \(x^{\prime} = x + 2y\), \(y^{\prime} = 2x + y\). La matrice \(\begin{pmatrix} 1 2 \\ 2 1 \end{pmatrix}\) a pour valeurs propres \(3\) et \(-1\), de vecteurs propres \((1, 1)\) et \((1, -1)\). Ainsi, la solution générale est \[\begin{pmatrix} x \\ y \end{pmatrix} = c_{1} e^{3t} \begin{pmatrix} 1 \\ 1 \end{pmatrix} + c_{2} e^{-t} \begin{pmatrix} 1 \\ -1 \end{pmatrix}.\]
2. Valeurs propres complexes d’une matrice réelle
Si \(A\) est réelle et diagonalisable sur \(\mathbb{C}\) seulement, on résout d’abord sur \(\mathbb{C}\). Ensuite, on revient aux solutions réelles. En effet, si \(Z\) est une solution complexe, alors \(\mathrm{Re}(Z)\) et \(\mathrm{Im}(Z)\) sont des solutions réelles, car \(A\) est réelle.
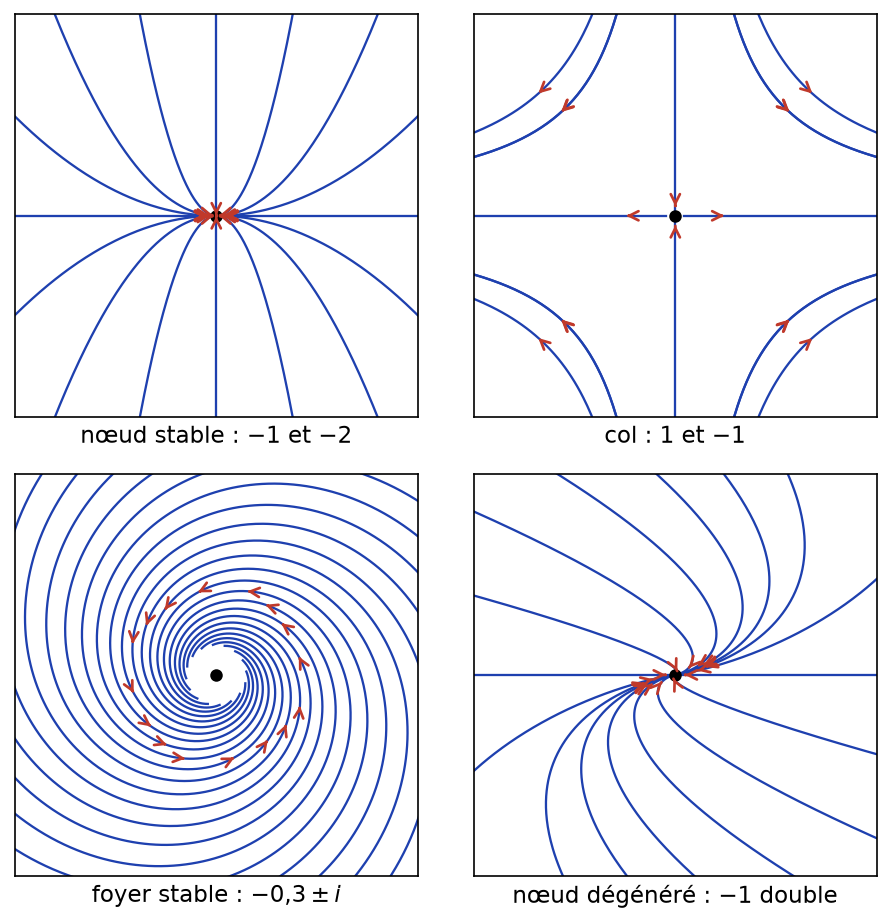
Pour \(A = \begin{pmatrix} -1 -1 \\ 1 -1 \end{pmatrix} = -I_{2} + J\), les valeurs propres sont \(-1 \pm i\). Comme \(-I_{2}\) et \(J\) commutent, \(\exp(tA) = e^{-t} \exp(tJ)\). Les trajectoires sont donc des spirales qui s’enroulent vers l’origine : c’est un foyer stable.
3. Cas trigonalisable et dimension au plus 3
Résoudre \(X^{\prime} = AX\) par trigonalisation. On écrit \(A = P T P^{-1}\) avec \(T\) triangulaire supérieure. On pose \(Y = P^{-1} X\), qui vérifie \(Y^{\prime} = TY\). On résout ce système triangulaire en cascade : d’abord la dernière équation \(y_{n}^{\prime} = t_{nn} y_{n}\), puis on remonte. Chaque étape est une équation scalaire \(y^{\prime} = \lambda y + f(t)\), résolue par variation de la constante. Finalement, on revient à \(X = PY\).
En dimension au plus 3, les situations sont peu nombreuses. Soit \(A\) est diagonalisable, soit elle a une valeur propre multiple. Dans ce dernier cas, on choisit une base adaptée : un vecteur propre \(V_{1}\), puis \(V_{2}\) tel que \((A – \lambda I_{n}) V_{2} = V_{1}\). On obtient alors des solutions de la forme \(e^{\lambda t}(V_{2} + t V_{1})\).
Reprenons \(A = \begin{pmatrix} 3 -1 \\ 1 1 \end{pmatrix}\) de la partie III. La solution de \(X^{\prime} = AX\) avec \(X(0) = (1, 2)\) est \[X(t) = \exp(tA) \begin{pmatrix} 1 \\ 2 \end{pmatrix} = e^{2t} \begin{pmatrix} 1 – t \\ 2 – t \end{pmatrix}.\] Le facteur \(t\) traduit la non-diagonalisabilité de \(A\).
Résolvons en cascade le système \(x^{\prime} = x + y\), \(y^{\prime} = y + z\), \(z^{\prime} = z\). D’abord, \(z(t) = ce^{t}\). Ensuite, \(y^{\prime} = y + ce^{t}\) : la variation de la constante \(y = \beta(t)e^{t}\) donne \(\beta^{\prime} = c\), donc \(y(t) = (b + ct)e^{t}\). Enfin, \(x^{\prime} = x + (b + ct)e^{t}\) donne de même \[x(t) = ( a + bt + \dfrac{c}{2}t^{2} )e^{t}.\] On retrouve ainsi les coefficients de \(\exp(tA) = e^{t}(I_{3} + tN + \frac{t^{2}}{2}N^{2})\), où \(N = A – I_{3}\).
En dimension 3, trois cas se présentent. Premièrement, si \(A\) a trois valeurs propres distinctes, elle est diagonalisable. Deuxièmement, si \(\chi_{A} = (X – \lambda)^{2}(X – \mu)\) avec \(\lambda \neq \mu\), la matrice est diagonalisable si et seulement si \(\dim E_{\lambda} = 2\) ; sinon, elle est semblable à \(\begin{pmatrix} \lambda 1 0 \\ 0 \lambda 0 \\ 0 0 \mu \end{pmatrix}\). Troisièmement, si \(\lambda\) est valeur propre triple, alors \(A = \lambda I_{3} + N\) avec \(N^{3} = 0\), et \(\exp(tA)\) s’obtient sans changement de base.
La figure ci-dessous regroupe les principaux portraits de phase en dimension 2. Chaque courbe est une trajectoire \(t \mapsto \exp(tA) X_{0}\), et les flèches indiquent le sens de parcours. Ainsi, le type de portrait se lit sur les valeurs propres.
VI. Comportement asymptotique des solutions
On s’intéresse enfin au comportement des solutions quand \(t \to +\infty\). Le résultat dépend du signe des parties réelles des valeurs propres, car \(|e^{\lambda t}| = e^{\mathrm{Re}(\lambda) t}\).
Soit \(A \in \mathcal{M}_{n}(\mathbb{C})\) et \(\mathcal{S}\) l’ensemble des solutions de \(X^{\prime} = AX\).
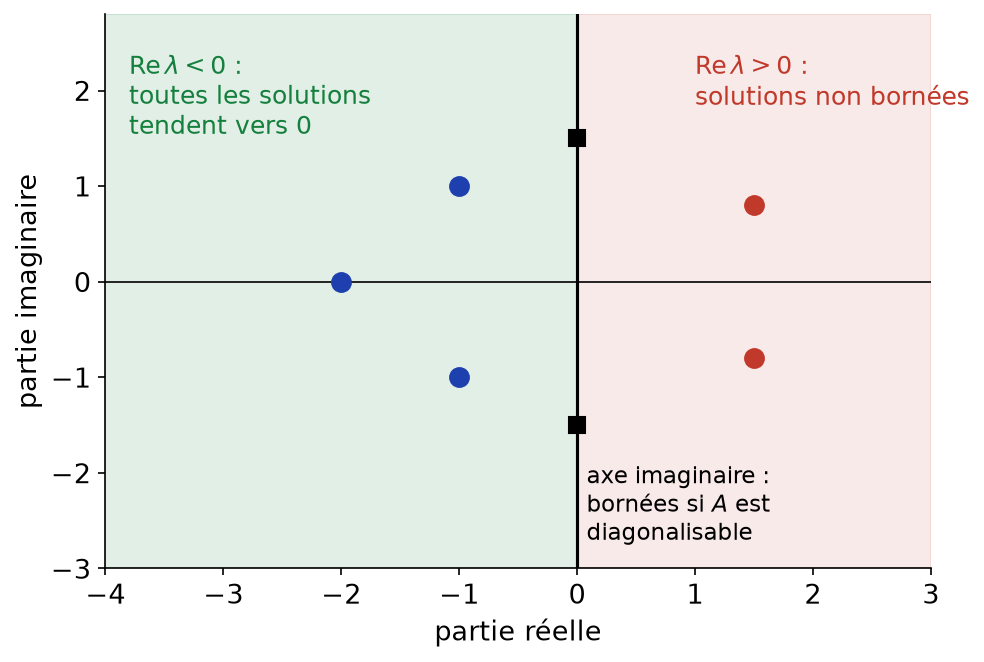
- Si toutes les valeurs propres de \(A\) ont une partie réelle strictement négative, toutes les solutions tendent vers \(0\) en \(+\infty\).
- Si une valeur propre a une partie réelle strictement positive, il existe des solutions non bornées sur \(\mathbb{R}_{+}\).
- Si \(A\) est diagonalisable et si toutes ses valeurs propres ont une partie réelle négative ou nulle, toutes les solutions sont bornées sur \(\mathbb{R}_{+}\).
Traitons le cas diagonalisable. La solution générale s’écrit \(X(t) = \sum c_{i} e^{\lambda_{i} t} V_{i}\), donc \[\|X(t)\| \leq\, \sum |c_{i}| \, e^{\mathrm{Re}(\lambda_{i}) t} \, \|V_{i}\|.\] Chaque terme tend vers \(0\) si \(\mathrm{Re}(\lambda_{i}) < 0\), et reste borné si \(\mathrm{Re}(\lambda_{i}) \leq\, 0\). D’autre part, si \(\mathrm{Re}(\lambda) > 0\) et \(AV = \lambda V\) avec \(V \neq 0\), la solution \(e^{\lambda t} V\) a pour norme \(e^{\mathrm{Re}(\lambda) t} \|V\| \to +\infty\).
Dans le cas général, on trigonalise. La résolution en cascade montre alors que chaque coordonnée est une somme de termes \(Q(t) e^{\lambda t}\), où \(Q\) est un polynôme et \(\lambda\) une valeur propre. Or \(|Q(t) e^{\lambda t}| = |Q(t)| e^{\mathrm{Re}(\lambda) t} \to 0\) si \(\mathrm{Re}(\lambda) < 0\), par croissances comparées.
L’hypothèse de diagonalisabilité est indispensable dans le troisième point. En effet, pour \(N = \begin{pmatrix} 0 1 \\ 0 0 \end{pmatrix}\), la seule valeur propre est \(0\), mais la solution \(\exp(tN)(0, 1) = (t, 1)\) n’est pas bornée.
La figure ci-dessous résume ce théorème dans le plan complexe. Les valeurs propres du demi-plan gauche (en bleu) donnent des solutions qui s’amortissent. À l’inverse, celles du demi-plan droit (en rouge) donnent des solutions qui explosent. Enfin, l’axe imaginaire est le cas critique.
Pour le système \(x^{\prime} = x + 2y\), \(y^{\prime} = 2x + y\), les valeurs propres sont \(3\) et \(-1\). Par conséquent, une solution tend vers \(0\) si et seulement si \(c_{1} = 0\), c’est-à-dire si \(X_{0}\) est colinéaire à \((1, -1)\). Toutes les autres solutions ont une norme qui tend vers \(+\infty\) : l’origine est un col.
Ce qu’il faut retenir
- \(\exp(A) = \sum A^{k}/k!\) converge absolument pour toute matrice, et \(\exp\) est continue sur \(\mathcal{M}_{n}(\mathbb{K})\).
- \(\exp(\mathrm{diag}(\lambda_{i})) = \mathrm{diag}(e^{\lambda_{i}})\), et \(\exp(PAP^{-1}) = P \exp(A) P^{-1}\).
- Pour \(N\) nilpotente, \(\exp(N)\) est une somme finie ; pour \(A = \lambda I_{n} + N\), \(\exp(tA) = e^{\lambda t} \exp(tN)\).
- Les valeurs propres de \(\exp(A)\) sont les \(e^{\lambda}\), et \(\det(\exp A) = e^{\mathrm{tr} A}\).
- Si \(AB = BA\), alors \(\exp(A + B) = \exp(A)\exp(B)\) ; sinon, c’est faux en général.
- \(t \mapsto \exp(tA)\) est \(\mathcal{C}^{1}\), de dérivée \(A \exp(tA)\).
- La solution de \(X^{\prime} = AX\), \(X(t_{0}) = X_{0}\) est \(X(t) = \exp((t – t_{0})A) X_{0}\), et l’espace des solutions est de dimension \(n\).
- On résout en diagonalisant (solutions \(e^{\lambda t} V\)) ou en trigonalisant (résolution en cascade).
- Si toutes les valeurs propres ont une partie réelle strictement négative, toutes les solutions tendent vers \(0\).
Questions fréquentes sur systèmes différentiels linéaires
Peut-on toujours écrire exp(A + B) = exp(A) exp(B) ?
Non, cette formule n’est garantie que si A et B commutent. Sans cette hypothèse, elle est fausse en général : pour les deux matrices nilpotentes élémentaires de taille 2, les deux membres diffèrent. On montre même que si l’égalité exp(tA) exp(tB) = exp(t(A + B)) vaut pour tout réel t, alors AB = BA.
Comment calculer exp(tA) quand A n'est pas diagonalisable ?
En dimension 2 ou 3, on écrit A = λI + N avec N nilpotente lorsque A n’a qu’une valeur propre, et exp(tA) = e^(λt) exp(tN) est une somme finie. Sinon, on trigonalise A = PTP⁻¹ et on calcule exp(tT) par blocs. On peut aussi résoudre directement le système triangulaire Y’ = TY en cascade.
Pourquoi la solution du problème de Cauchy est-elle unique ?
Si Y est solution de X’ = AX avec Y(t0) = X0, la fonction exp(-(t – t0)A) Y(t) a une dérivée nulle, car A commute avec son exponentielle. Elle est donc constante sur l’intervalle, égale à X0. On en déduit Y(t) = exp((t – t0)A) X0.
Quand toutes les solutions tendent-elles vers 0 ?
Toutes les solutions de X’ = AX tendent vers 0 en plus l’infini si et seulement si toutes les valeurs propres complexes de A ont une partie réelle strictement négative. En effet, chaque coordonnée est une somme de termes Q(t) e^(λt), dont le module vaut |Q(t)| e^(Re(λ) t).
Pour aller plus loin en maths spé
- Les énoncés : exercices de maths spé sur systèmes différentiels linéaires
- À maîtriser avant : Équations différentielles linéaires, Polynômes d'endomorphismes et Cayley-Hamilton, Compacité, connexité par arcs et dimension finie
- Chapitre précédent : Équations différentielles linéaires
- Chapitre suivant : Calcul différentiel dans les espaces normés
- Tester vos connaissances : QCM de maths spé par chapitre
- Le sommaire : tous les chapitres de maths spé et les chapitres de maths sup