Ce cours de calcul différentiel spé généralise la dérivation aux fonctions de plusieurs variables, définies sur un ouvert d’un espace vectoriel normé de dimension finie. Il part de la dérivée selon un vecteur et des dérivées partielles, puis montre pourquoi elles ne suffisent pas. Il définit ensuite la différentielle, application linéaire tangente, et la relie à la matrice jacobienne et au gradient.
La suite du chapitre donne les outils de calcul : différentielle d’une application multilinéaire, règle de la chaîne, changements de variables, différentielles du déterminant et de l’inverse. Elle étudie enfin les fonctions de classe C1, l’intégrale de la différentielle le long d’un arc et l’espace tangent à une ligne de niveau.
Ce chapitre se place au second semestre de MP. Il prépare directement le chapitre d’optimisation, avec la recherche de points critiques et d’extremums, et sert aussi en physique et en géométrie.
Pour vous entraîner ensuite, travaillez les exercices de maths spé sur calcul différentiel.
I. Dérivée selon un vecteur et dérivées partielles
Dans tout le chapitre, \(E\) et \(F\) sont deux espaces vectoriels normés réels de dimension finie. Toutes les normes y sont donc équivalentes, et les notions de limite, de continuité et de « petit o » ne dépendent pas de la norme choisie. On note \(U\) un ouvert de \(E\) et \(f : U \to F\) une application. Le but est simple : approcher \(f\) au voisinage d’un point par une application linéaire.
1. Dérivée selon un vecteur
La première idée consiste à se ramener à une variable réelle. On fixe un point \(a\) et une direction \(v\). Ensuite, on regarde comment varie \(f\) le long de la droite passant par \(a\) et dirigée par \(v\). Comme \(U\) est ouvert, \(a + tv\) reste dans \(U\) pour \(t\) assez petit.
Soit \(a \in U\) et \(v \in E\). On dit que \(f\) est dérivable en \(a\) selon le vecteur \(v\) si la fonction \(t \mapsto f(a + tv)\) est dérivable en \(0\). On note alors \[D_{v} f(a) = \lim_{t \to 0} \dfrac{f(a + tv) – f(a)}{t}.\]
Soit \(\mathcal{B} = (e_{1}, \ldots, e_{n})\) une base de \(E\). La \(j\)-ième dérivée partielle de \(f\) en \(a\) dans la base \(\mathcal{B}\) est, si elle existe, la dérivée selon le vecteur \(e_{j}\) : \[\partial_{j} f(a) = \dfrac{\partial f}{\partial x_{j}}(a) = D_{e_{j}} f(a).\] Autrement dit, on dérive par rapport à la \(j\)-ième coordonnée en gelant les autres.
Soit \(f(x, y) = x^{2} y\) sur \(\mathbb{R}^{2}\), \(a = (1, 2)\) et \(v = (h, k)\). On a \(f(1 + th, 2 + tk) = (1 + th)^{2} (2 + tk)\). En dérivant en \(t = 0\), on obtient \(D_{v} f(a) = 2h \times 2 + 1 \times k = 4h + k\). En particulier, \(\partial_{1} f(a) = 4\) et \(\partial_{2} f(a) = 1\).
2. Une notion insuffisante
L’existence de toutes les dérivées partielles, et même de toutes les dérivées selon un vecteur, ne garantit rien de solide. En effet, elle ne contrôle \(f\) que le long de droites. Or une fonction peut se comporter très mal le long d’autres courbes.
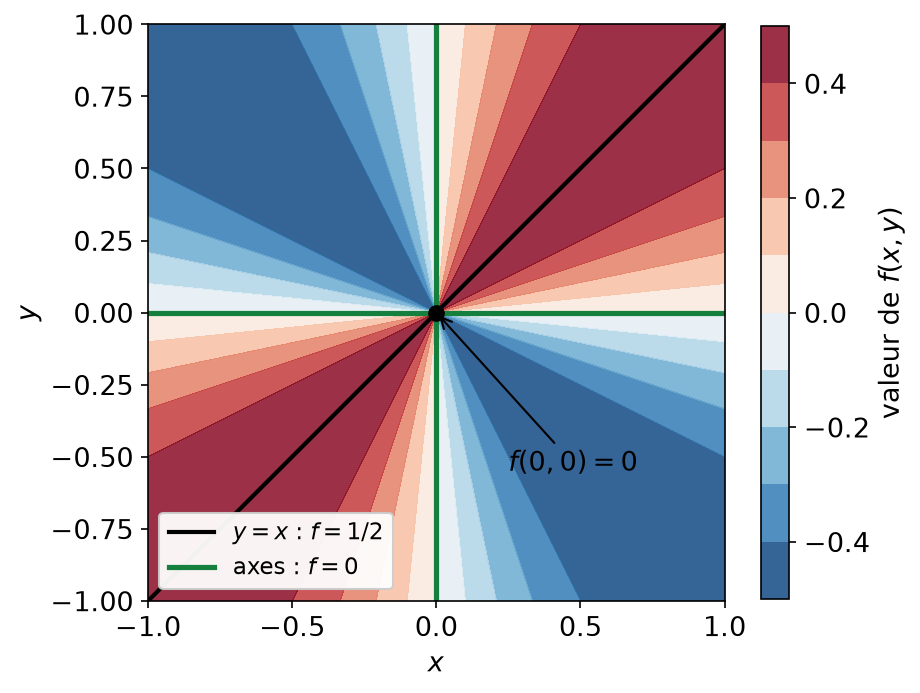
Soit \(f(x, y) = \dfrac{xy}{x^{2} + y^{2}}\) pour \((x, y) \neq (0, 0)\) et \(f(0, 0) = 0\). Sur les axes, \(f\) est nulle, donc \(\partial_{1} f(0, 0) = \partial_{2} f(0, 0) = 0\). Cependant, \(f(t, t) = \dfrac{1}{2}\) pour tout \(t \neq 0\). Ainsi, \(f\) n’est même pas continue en \((0, 0)\).
La figure ci-dessous montre pourquoi. En coordonnées polaires, \(f\) vaut \(\dfrac{1}{2} \sin(2\theta)\) : elle est constante sur chaque demi-droite issue de l’origine. Par conséquent, toutes les valeurs de \([-1/2, 1/2]\) sont prises dans tout voisinage de l’origine.
II. Applications différentiables
On cherche donc une notion plus exigeante, qui contrôle \(f\) dans toutes les directions à la fois. C’est le rôle de la différentielle, définie de façon intrinsèque, sans choisir de base.
1. Définition de la différentielle
On dit que \(f\) est différentiable en \(a \in U\) s’il existe une application linéaire \(\ell \in \mathcal{L}(E, F)\) telle que \[f(a + h) = f(a) + \ell(h) + o(h) \quad \text{quand } h \to 0.\] Cette application \(\ell\) est unique. On l’appelle la différentielle de \(f\) en \(a\), ou application linéaire tangente, et on la note \(df(a)\). Enfin, \(f\) est différentiable sur \(U\) si elle l’est en tout point de \(U\).
Montrons l’unicité. Soit \(\ell_{1}\) et \(\ell_{2}\) deux applications convenables. Par différence, \(\ell_{1}(h) – \ell_{2}(h) = o(h)\). Fixons \(v \in E\) et posons \(h = tv\) avec \(t \to 0^{+}\). Par linéarité, \(t (\ell_{1} – \ell_{2})(v) = o(t)\). En divisant par \(t\) puis en faisant tendre \(t\) vers \(0\), on obtient \(\ell_{1}(v) = \ell_{2}(v)\).
Si \(f\) est différentiable en \(a\), alors :
- \(f\) est continue en \(a\) ;
- \(f\) est dérivable en \(a\) selon tout vecteur \(v\), et \(D_{v} f(a) = df(a)(v)\).
D’abord, en dimension finie, \(df(a)\) est continue, donc \(df(a)(h) \to 0\) quand \(h \to 0\). Ainsi, \(f(a + h) \to f(a)\). Ensuite, pour \(v \neq 0\) fixé, on a \(f(a + tv) = f(a) + t\, df(a)(v) + o(t)\). En divisant par \(t\), on obtient la limite \(df(a)(v)\). Le cas \(v = 0\) est immédiat.
En particulier, la fonction de la partie I n’est pas différentiable en \((0, 0)\), puisqu’elle n’y est pas continue. De plus, la proposition fournit un test commode : si \(v \mapsto D_{v} f(a)\) n’est pas linéaire, alors \(f\) n’est pas différentiable en \(a\).
2. Premiers exemples
Une application constante est différentiable, de différentielle nulle. Une application linéaire \(u\) est différentiable en tout point, et \(du(a) = u\), car \(u(a + h) = u(a) + u(h)\) exactement. Enfin, si \(E = \mathbb{R}\), \(f\) est différentiable en \(a\) si et seulement si elle est dérivable en \(a\), et alors \(df(a)(h) = h f^{\prime}(a)\).
Sur un espace euclidien, soit \(f(x) = \|x\|^{2}\). Pour tous \(a, h\), on a \[f(a + h) = \|a\|^{2} + 2 \langle a, h \rangle + \|h\|^{2}.\] Or \(\|h\|^{2} = o(h)\) et \(h \mapsto 2 \langle a, h \rangle\) est linéaire. Donc \(f\) est différentiable en \(a\) et \(df(a)(h) = 2 \langle a, h \rangle\).
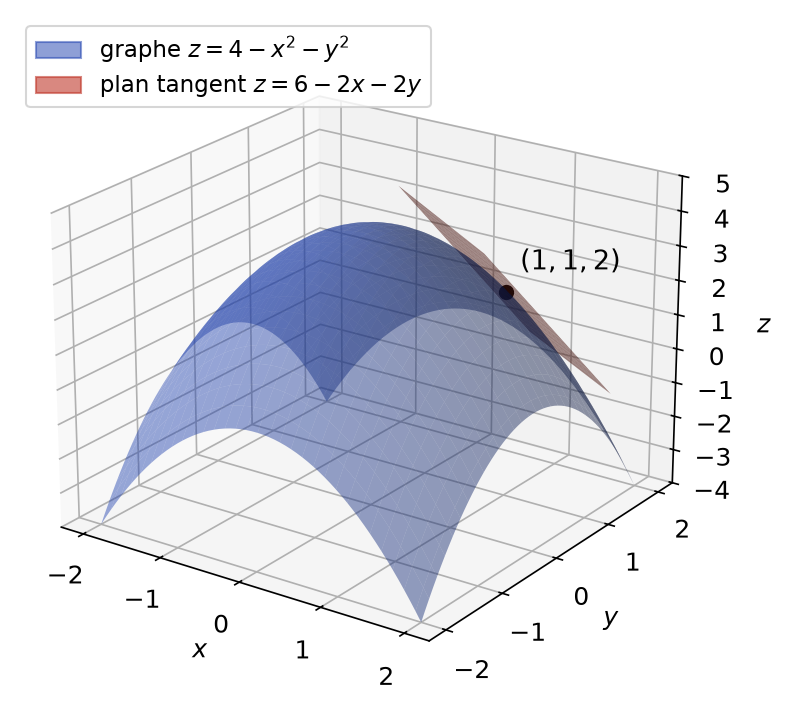
Géométriquement, pour \(f : \mathbb{R}^{2} \to \mathbb{R}\), l’application \(h \mapsto f(a) + df(a)(h)\) décrit le plan tangent au graphe de \(f\) au point \((a, f(a))\). Par exemple, pour \(f(x, y) = 4 – x^{2} – y^{2}\) et \(a = (1, 1)\), le plan tangent a pour équation \(z = 2 – 2(x – 1) – 2(y – 1)\), soit \(z = 6 – 2x – 2y\). La figure ci-dessous illustre ce contact d’ordre un.
III. Calcul différentiel en coordonnées : jacobienne et gradient
1. Différentielle et dérivées partielles
Dès qu’on choisit une base, la différentielle se calcule avec les dérivées partielles. C’est la formule la plus utilisée en pratique.
Soit \((e_{1}, \ldots, e_{n})\) une base de \(E\) et \(f\) différentiable en \(a\). Alors, pour tout \(h = \sum_{j=1}^{n} h_{j} e_{j}\), \[df(a)(h) = \sum_{j=1}^{n} h_{j}\, \partial_{j} f(a).\]
Par linéarité, \(df(a)(h) = \sum_{j} h_{j}\, df(a)(e_{j})\). Or \(df(a)(e_{j}) = D_{e_{j}} f(a) = \partial_{j} f(a)\) d’après la proposition de la partie II.
Soit \(f : U \subset \mathbb{R}^{n} \to \mathbb{R}^{p}\) de composantes \(f_{1}, \ldots, f_{p}\), différentiable en \(a\). La matrice jacobienne de \(f\) en \(a\) est la matrice de \(df(a)\) dans les bases canoniques : \[J_{f}(a) = ( \partial_{j} f_{i}(a) )_{1 \leq\, i \leq\, p,\ 1 \leq\, j \leq\, n} \in \mathcal{M}_{p,n}(\mathbb{R}).\] La ligne \(i\) contient les dérivées partielles de \(f_{i}\) ; la colonne \(j\) contient \(\partial_{j} f(a)\).
Soit \(\Phi(r, \theta) = (r \cos \theta, r \sin \theta)\) sur \(\mathbb{R}^{2}\). Ses dérivées partielles existent et sont continues. On verra en partie V que \(\Phi\) est alors différentiable, et \[J_{\Phi}(r, \theta) = \begin{pmatrix} \cos \theta -r \sin \theta \\ \sin \theta r \cos \theta \end{pmatrix}, \quad \det J_{\Phi}(r, \theta) = r.\]
2. Gradient d’une fonction numérique
On suppose maintenant que \(E\) est un espace euclidien et que \(f\) est à valeurs réelles. Alors \(df(a)\) est une forme linéaire. Par le théorème de représentation des formes linéaires, elle s’écrit comme un produit scalaire.
Soit \(f : U \to \mathbb{R}\) différentiable en \(a\). Le gradient de \(f\) en \(a\) est l’unique vecteur \(\nabla f(a) \in E\) tel que \[\forall h \in E, \quad df(a)(h) = \langle \nabla f(a), h \rangle.\]
Dans une base orthonormée \((e_{1}, \ldots, e_{n})\), on a \(\nabla f(a) = \sum_{j=1}^{n} \partial_{j} f(a)\, e_{j}\). De plus, si \(\nabla f(a) \neq 0\), le vecteur unitaire \(u\) qui maximise \(D_{u} f(a)\) est \(u = \dfrac{\nabla f(a)}{\|\nabla f(a)\|}\), et ce maximum vaut \(\|\nabla f(a)\|\).
La première formule découle de \(\langle \nabla f(a), e_{j} \rangle = df(a)(e_{j}) = \partial_{j} f(a)\). Ensuite, pour \(\|u\| = 1\), l’inégalité de Cauchy-Schwarz donne \(D_{u} f(a) = \langle \nabla f(a), u \rangle \leq\, \|\nabla f(a)\|\). Enfin, le cas d’égalité impose que \(u\) soit colinéaire à \(\nabla f(a)\), de même sens.
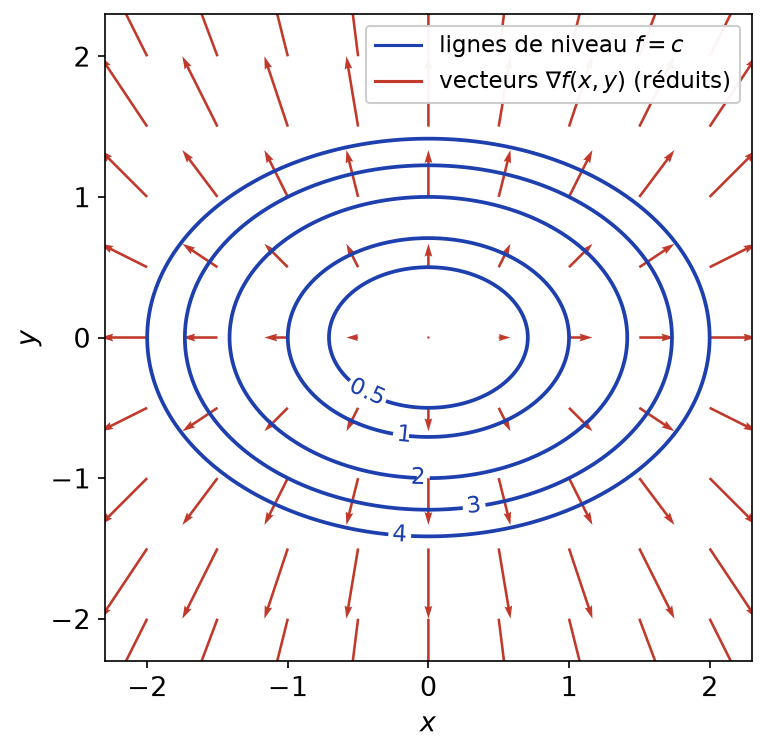
Ainsi, le gradient indique la direction de plus forte pente. De plus, on verra en partie VI qu’il est orthogonal aux lignes de niveau. Comme le montre la figure ci-dessous pour \(f(x, y) = x^{2} + 2y^{2}\), de gradient \((2x, 4y)\), les vecteurs gradients traversent les ellipses de niveau à angle droit.
IV. Opérations sur les applications différentiables
1. Combinaisons linéaires et applications multilinéaires
Si \(f\) et \(g\) sont différentiables en \(a\) et \(\lambda \in \mathbb{R}\), alors \(f + \lambda g\) l’est aussi, et \(d(f + \lambda g)(a) = df(a) + \lambda\, dg(a)\).
Soit \(M : E_{1} \times \cdots \times E_{p} \to F\) une application \(p\)-linéaire, les espaces étant de dimension finie. Alors \(M\) est différentiable en tout point \(a = (a_{1}, \ldots, a_{p})\), et \[dM(a)(h_{1}, \ldots, h_{p}) = \sum_{i=1}^{p} M(a_{1}, \ldots, a_{i-1}, h_{i}, a_{i+1}, \ldots, a_{p}).\]
Traitons le cas bilinéaire \(p = 2\). Pour tous \(a = (a_{1}, a_{2})\) et \(h = (h_{1}, h_{2})\), on développe : \[M(a_{1} + h_{1}, a_{2} + h_{2}) = M(a_{1}, a_{2}) + M(h_{1}, a_{2}) + M(a_{1}, h_{2}) + M(h_{1}, h_{2}).\] En dimension finie, \(M\) est continue, donc il existe \(C\) tel que \(\|M(x, y)\| \leq\, C \|x\| \|y\|\). Par conséquent, \(\|M(h_{1}, h_{2})\| \leq\, C \|h\|^{2} = o(h)\), avec \(\|h\| = \max(\|h_{1}\|, \|h_{2}\|)\). Le cas général se traite de la même façon.
Le produit matriciel \((A, B) \mapsto AB\) est bilinéaire, donc \(d(AB)(H, K) = HB + AK\). De même, le déterminant est \(n\)-linéaire en les colonnes. On en déduit \[d(\det)(A)(H) = \sum_{j=1}^{n} \det(C_{1}, \ldots, C_{j-1}, H_{j}, C_{j+1}, \ldots, C_{n}) = \operatorname{tr}( \operatorname{com}(A)^{T} H ),\] où \(C_{j}\) et \(H_{j}\) sont les colonnes de \(A\) et \(H\). En développant chaque déterminant selon sa colonne \(j\), on retrouve bien la trace annoncée. En particulier, \(d(\det)(I_{n})(H) = \operatorname{tr}(H)\).
2. Règle de la chaîne
Règle de la chaîne. Soit \(f : U \to F\) différentiable en \(a\), \(V\) un ouvert de \(F\) contenant \(f(U)\) et \(g : V \to G\) différentiable en \(f(a)\). Alors \(g \circ f\) est différentiable en \(a\), et \[d(g \circ f)(a) = dg(f(a)) \circ df(a).\] Matriciellement, \(J_{g \circ f}(a) = J_{g}(f(a))\, J_{f}(a)\).
Posons \(b = f(a)\) et \(k = f(a + h) – b = df(a)(h) + o(h)\). En particulier, \(k = O(h)\). Ensuite, \(g(b + k) = g(b) + dg(b)(k) + o(k)\), et \(o(k) = o(h)\). Enfin, par linéarité et continuité de \(dg(b)\), on a \(dg(b)(k) = dg(b)(df(a)(h)) + o(h)\). En regroupant, \(g(f(a + h)) = g(b) + dg(b) \circ df(a)(h) + o(h)\).
Dérivée le long d’un arc. Soit \(\gamma : I \to U\) un arc dérivable en \(t\) et \(f\) différentiable en \(\gamma(t)\). Alors \(f \circ \gamma\) est dérivable en \(t\) et \[(f \circ \gamma)^{\prime}(t) = df(\gamma(t))( \gamma^{\prime}(t) ).\] Dans une base, \((f \circ \gamma)^{\prime}(t) = \sum_{j} \gamma_{j}^{\prime}(t)\, \partial_{j} f(\gamma(t))\).
Changement de variables. Pour \(g(u, v) = f(x(u, v), y(u, v))\), la règle de la chaîne donne \[\dfrac{\partial g}{\partial u} = \dfrac{\partial x}{\partial u} \dfrac{\partial f}{\partial x} + \dfrac{\partial y}{\partial u} \dfrac{\partial f}{\partial y}, \qquad \dfrac{\partial g}{\partial v} = \dfrac{\partial x}{\partial v} \dfrac{\partial f}{\partial x} + \dfrac{\partial y}{\partial v} \dfrac{\partial f}{\partial y},\] les dérivées de \(f\) étant prises en \((x(u, v), y(u, v))\). Pour résoudre une équation aux dérivées partielles, on choisit \(u, v\) de façon qu’elle devienne \(\partial g / \partial v = 0\). Ensuite, on intègre à \(u\) fixé, puis on revient aux variables initiales.
En polaires, \(g(r, \theta) = f(r \cos \theta, r \sin \theta)\). On obtient \(\partial_{r} g = \cos \theta\, \partial_{x} f + \sin \theta\, \partial_{y} f\) et \(\partial_{\theta} g = -r \sin \theta\, \partial_{x} f + r \cos \theta\, \partial_{y} f\). Autrement dit, \(r\, \partial_{r} g = x\, \partial_{x} f + y\, \partial_{y} f\) et \(\partial_{\theta} g = x\, \partial_{y} f – y\, \partial_{x} f\).
3. Différentielle de l’inversion matricielle
L’ensemble \(GL_{n}(\mathbb{R})\) est un ouvert de \(\mathcal{M}_{n}(\mathbb{R})\). L’application \(\varphi : A \mapsto A^{-1}\) y est différentiable, et \[d\varphi(A)(H) = -A^{-1} H A^{-1}.\]
D’abord, \(GL_{n}(\mathbb{R}) = \det^{-1}(\mathbb{R}^{*})\) est ouvert, car \(\det\) est continue. Ensuite, \(A^{-1} = \dfrac{1}{\det A} \operatorname{com}(A)^{T}\) : les coefficients de \(\varphi(A)\) sont des fractions rationnelles des coefficients de \(A\), à dénominateur non nul. Ainsi, \(\varphi\) est différentiable, et même de classe \(C^{1}\). Enfin, on différentie l’identité \(A \varphi(A) = I_{n}\) par la règle du produit : \(H \varphi(A) + A\, d\varphi(A)(H) = 0\). On multiplie à gauche par \(A^{-1}\) et on conclut.
V. Applications de classe C¹
1. Définition et caractérisation
On dit que \(f : U \to F\) est de classe \(C^{1}\) sur \(U\) si \(f\) est différentiable sur \(U\) et si l’application \(df : U \to \mathcal{L}(E, F)\) est continue.
Soit \((e_{1}, \ldots, e_{n})\) une base de \(E\). L’application \(f\) est de classe \(C^{1}\) sur \(U\) si et seulement si ses dérivées partielles \(\partial_{1} f, \ldots, \partial_{n} f\) existent en tout point de \(U\) et sont continues sur \(U\). (Démonstration admise.)
Ce théorème est l’outil de base. En effet, les sommes, produits et composées de fonctions \(C^{1}\) sont \(C^{1}\). Ainsi, une fonction donnée par une formule explicite est \(C^{1}\) sur tout ouvert où la formule a un sens. Le travail ne commence qu’aux points problématiques.
Montrer qu’une fonction est \(C^{1}\). D’abord, on justifie le caractère \(C^{1}\) sur l’ouvert où la formule est « régulière », par opérations. Ensuite, au point problématique \(a\), on calcule chaque \(\partial_{j} f(a)\) par la définition, comme limite d’un taux d’accroissement. Enfin, on majore \(|\partial_{j} f(x) – \partial_{j} f(a)|\) par une quantité qui tend vers \(0\) quand \(x \to a\), souvent grâce à \(|x| \leq\, \sqrt{x^{2} + y^{2}}\).
Soit \(f(x, y) = \dfrac{x^{2} y^{2}}{x^{2} + y^{2}}\) et \(f(0, 0) = 0\). Hors de l’origine, \(f\) est \(C^{1}\) par opérations, et \(\partial_{x} f(x, y) = \dfrac{2x y^{4}}{(x^{2} + y^{2})^{2}}\). En l’origine, \(f(t, 0) = 0\), donc \(\partial_{x} f(0, 0) = 0\). De plus, \(y^{4} \leq\, (x^{2} + y^{2})^{2}\), d’où \(|\partial_{x} f(x, y)| \leq\, 2|x| \to 0\). Par symétrie, il en va de même pour \(\partial_{y} f\). Ainsi, \(f\) est \(C^{1}\) sur \(\mathbb{R}^{2}\).
2. Intégrale de la différentielle le long d’un arc
Soit \(f : U \to F\) de classe \(C^{1}\) et \(\gamma : [0, 1] \to U\) un arc de classe \(C^{1}\). Alors \[f(\gamma(1)) – f(\gamma(0)) = \int_{0}^{1} df(\gamma(t))( \gamma^{\prime}(t) ) dt.\]
D’après la règle de la chaîne, \(f \circ \gamma\) est dérivable, de dérivée \(t \mapsto df(\gamma(t))(\gamma^{\prime}(t))\). Cette dérivée est continue, car \(df \circ \gamma\) et \(\gamma^{\prime}\) le sont, et l’évaluation \((\ell, v) \mapsto \ell(v)\) est bilinéaire, donc continue. Le théorème fondamental de l’analyse s’applique donc à \(f \circ \gamma\) sur \([0, 1]\).
En prenant pour \(\gamma\) un segment \(t \mapsto a + t(b – a)\) inclus dans \(U\), on obtient \(f(b) – f(a) = \int_{0}^{1} df(a + t(b – a))(b – a)\, dt\). Par exemple, si \(\|df(x)\| \leq\, M\) sur un ouvert convexe, alors \(\|f(b) – f(a)\| \leq\, M \|b – a\|\) : c’est l’inégalité des accroissements finis.
3. Fonctions de différentielle nulle
Soit \(U\) un ouvert connexe par arcs et \(f : U \to F\) différentiable. Alors \(f\) est constante sur \(U\) si et seulement si \(df(x) = 0\) pour tout \(x \in U\).
Le sens direct est clair. Réciproquement, fixons \(a, b \in U\) et un chemin continu \(\gamma : [0, 1] \to U\) de \(a\) à \(b\). Soit \(A = \{ t \in [0, 1] : f(\gamma(t)) = f(a) \}\) et \(s = \sup A\). D’abord, \(A\) est fermé, car \(f \circ \gamma\) est continue ; donc \(s \in A\). Supposons \(s < 1\). Comme \(U\) est ouvert, une boule \(B = B(\gamma(s), r)\) est incluse dans \(U\). Pour \(y \in B\), le segment \([\gamma(s), y]\) est dans \(B\), et \(u \mapsto f(\gamma(s) + u(y – \gamma(s)))\) a une dérivée nulle sur \([0, 1]\). Donc \(f(y) = f(\gamma(s)) = f(a)\). Or, par continuité de \(\gamma\), \(\gamma(t) \in B\) pour \(t \in [s, s + \eta]\). Ainsi, \([s, s + \eta] \subset A\), ce qui contredit la définition de \(s\). Finalement, \(s = 1\) et \(f(b) = f(a)\).
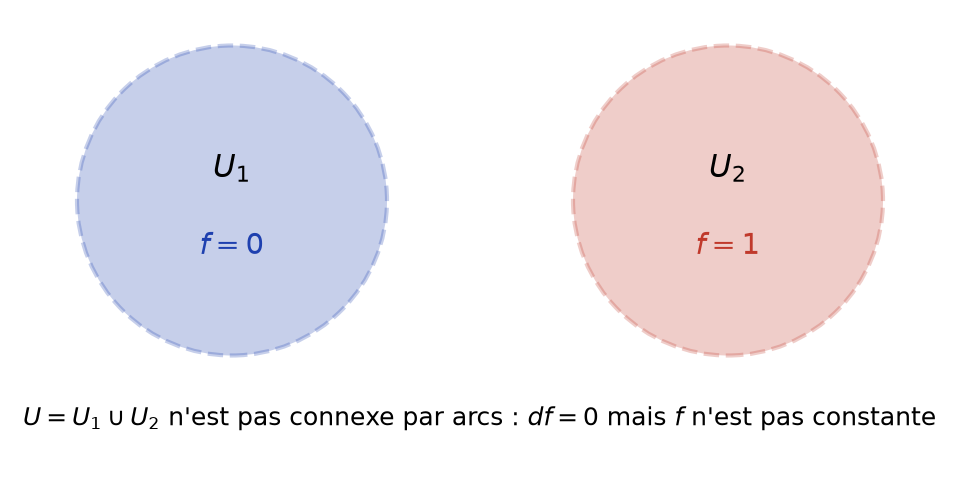
L’hypothèse de connexité par arcs est indispensable. Par exemple, sur la réunion de deux disques disjoints, la fonction égale à \(0\) sur l’un et à \(1\) sur l’autre a une différentielle nulle. Pourtant, elle n’est pas constante, comme l’illustre la figure ci-dessous.
VI. Vecteurs tangents et espace tangent
Cette dernière partie donne une première approche géométrique. On s’intéresse à une partie \(X\) de \(E\), par exemple une courbe ou une surface. On veut décrire les directions dans lesquelles on peut « partir » de \(x \in X\) en restant dans \(X\).
1. Définition
Soit \(X \subset E\) et \(x \in X\). Un vecteur \(v \in E\) est tangent à \(X\) en \(x\) s’il existe \(\varepsilon > 0\) et un arc \(\gamma : ]-\varepsilon, \varepsilon[ \to E\), à valeurs dans \(X\), dérivable en \(0\), tel que \(\gamma(0) = x\) et \(\gamma^{\prime}(0) = v\). On note \(T_{x} X\) l’ensemble de ces vecteurs.
Si \(X\) est un sous-espace vectoriel, alors \(T_{x} X = X\) pour tout \(x \in X\). En effet, \(\gamma(t) = x + tv\) convient pour \(v \in X\). Inversement, si \(\gamma\) est à valeurs dans \(X\), les taux \((\gamma(t) – x)/t\) sont dans \(X\), qui est fermé ; leur limite aussi. Cependant, \(T_{x} X\) n’est pas toujours un sous-espace vectoriel : pour \(X = \{ (x, y) : xy = 0 \}\), on a \(T_{(0,0)} X = X\), réunion de deux droites.
2. Espace tangent à une ligne de niveau
Soit \(g : U \to \mathbb{R}\) de classe \(C^{1}\), \(X = \{ x \in U : g(x) = 0 \}\) et \(x \in X\) tel que \(dg(x) \neq 0\). Alors \[T_{x} X = \ker dg(x).\] C’est un hyperplan de \(E\). Si \(E\) est euclidien, c’est l’orthogonal de \(\nabla g(x)\).
Prouvons l’inclusion \(T_{x} X \subset \ker dg(x)\). Soit \(v\) tangent et \(\gamma\) un arc associé. Pour \(t\) voisin de \(0\), \(g(\gamma(t)) = 0\). En dérivant en \(0\) par la règle de la chaîne, \(dg(x)(\gamma^{\prime}(0)) = 0\), c’est-à-dire \(v \in \ker dg(x)\). L’inclusion réciproque est admise : elle repose sur un résultat d’analyse hors programme.
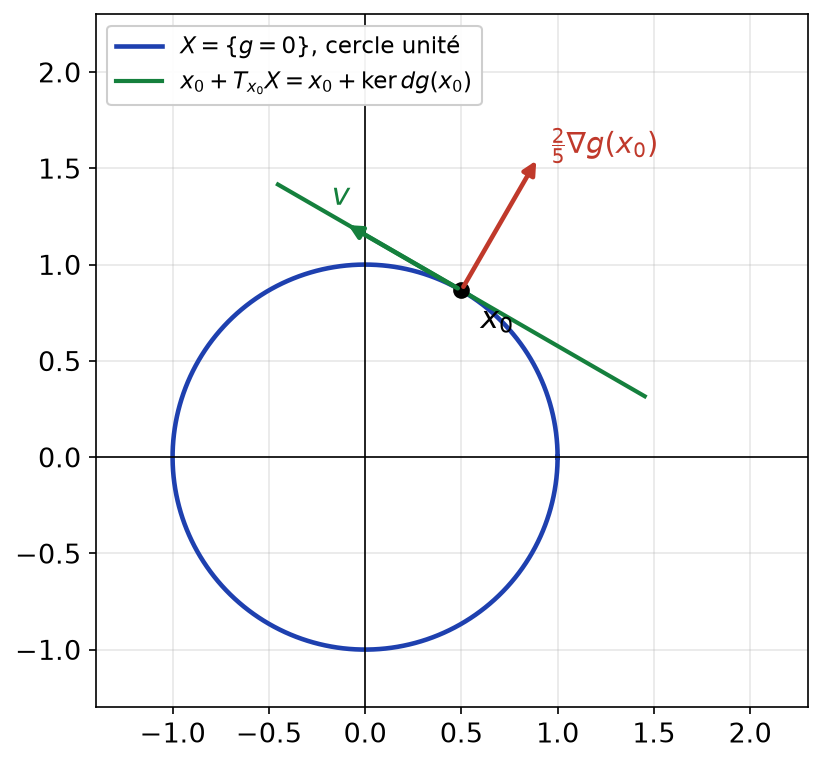
La figure ci-dessous illustre ce théorème pour le cercle unité, défini par \(g(x, y) = x^{2} + y^{2} – 1\). Le gradient \(\nabla g(x_{0}) = 2x_{0}\) est radial. Ainsi, la droite tangente, dirigée par \(\ker dg(x_{0})\), lui est orthogonale.
3. Plan tangent à une surface
Plan tangent à une surface \(g(x, y, z) = 0\). Soit \(A = (x_{0}, y_{0}, z_{0})\) un point de la surface tel que \(\nabla g(A) \neq 0\). Le plan tangent en \(A\) est le plan affine \(A + T_{A} X\), d’équation \[\partial_{x} g(A) (x – x_{0}) + \partial_{y} g(A) (y – y_{0}) + \partial_{z} g(A) (z – z_{0}) = 0.\] Autrement dit, \(\nabla g(A)\) est un vecteur normal au plan tangent.
Pour la sphère \(x^{2} + y^{2} + z^{2} = 9\) au point \(A = (1, 2, 2)\), on a \(\nabla g(A) = (2, 4, 4)\). Le plan tangent a donc pour équation \(2(x – 1) + 4(y – 2) + 4(z – 2) = 0\), soit \(x + 2y + 2z = 9\). De même, un graphe \(z = \varphi(x, y)\), avec \(\varphi\) de classe \(C^{1}\), est la ligne de niveau \(0\) de \(g = \varphi(x, y) – z\). Comme \(\partial_{z} g = -1\), le gradient ne s’annule jamais. On retrouve alors le plan tangent \(z = \varphi(x_{0}, y_{0}) + \partial_{x} \varphi (x – x_{0}) + \partial_{y} \varphi (y – y_{0})\).
Ce qu’il faut retenir
- La dérivée selon un vecteur est \(D_{v} f(a) = \lim_{t \to 0} \dfrac{f(a + tv) – f(a)}{t}\) ; son existence dans toutes les directions n’entraîne pas la continuité.
- La différentielle est l’unique \(df(a) \in \mathcal{L}(E, F)\) telle que \(f(a + h) = f(a) + df(a)(h) + o(h)\) ; alors \(f\) est continue en \(a\) et \(D_{v} f(a) = df(a)(v)\).
- Dans une base, \(df(a)(h) = \sum_{j} h_{j}\, \partial_{j} f(a)\), et la matrice jacobienne a pour coefficients \(\partial_{j} f_{i}(a)\).
- Sur un espace euclidien, \(df(a)(h) = \langle \nabla f(a), h \rangle\) ; le gradient indique la direction de plus forte pente.
- Pour \(M\) multilinéaire, \(dM(a)(h) = \sum_{i} M(a_{1}, \ldots, h_{i}, \ldots, a_{p})\) ; ainsi \(d(\det)(I_{n})(H) = \operatorname{tr} H\) et \(d(A^{-1}) = -A^{-1} H A^{-1}\).
- Règle de la chaîne : \(d(g \circ f)(a) = dg(f(a)) \circ df(a)\) et \((f \circ \gamma)^{\prime}(t) = df(\gamma(t))(\gamma^{\prime}(t))\).
- \(f\) est de classe \(C^{1}\) si et seulement si ses dérivées partielles existent et sont continues.
- Pour \(f\) de classe \(C^{1}\), \(f(\gamma(1)) – f(\gamma(0)) = \int_{0}^{1} df(\gamma(t))(\gamma^{\prime}(t))\, dt\).
- Sur un ouvert connexe par arcs, \(df = 0\) équivaut à \(f\) constante.
- Si \(dg(x) \neq 0\), l’espace tangent à \(\{ g = 0 \}\) en \(x\) est \(\ker dg(x)\) : le gradient est normal à la ligne de niveau.
Questions fréquentes sur calcul différentiel
Quelle différence entre dérivées partielles et différentielle ?
Les dérivées partielles ne décrivent la fonction que le long des axes, alors que la différentielle l’approche linéairement dans toutes les directions à la fois. Une fonction peut avoir des dérivées partielles en un point sans y être continue, par exemple xy/(x²+y²). En revanche, si f est différentiable en a, alors df(a)(h) est la somme des h_j multipliés par les dérivées partielles en a.
Comment prouver qu'une fonction est de classe C1 ?
On montre que ses dérivées partielles existent et sont continues sur l’ouvert. Hors des points problématiques, on invoque les opérations sur les fonctions C1. Au point délicat, on calcule chaque dérivée partielle par un taux d’accroissement, puis on majore sa variation par une quantité qui tend vers 0.
Comment écrire l'équation du plan tangent à une surface g(x, y, z) = 0 ?
Si g est de classe C1 et si son gradient en A ne s’annule pas, le plan tangent en A est l’ensemble des points M tels que le gradient de g en A soit orthogonal au vecteur AM. On écrit donc la somme des dérivées partielles de g en A multipliées par (x – x0), (y – y0) et (z – z0), égale à 0. Pour un graphe z = φ(x, y), on prend g = φ(x, y) – z.
À quoi sert la connexité par arcs dans ce chapitre ?
Elle garantit qu’une fonction de différentielle nulle sur un ouvert est constante. Sans elle, le résultat est faux : sur deux disques disjoints, une fonction peut valoir 0 sur l’un et 1 sur l’autre. De même, un champ peut être un gradient sur un demi-plan sans l’être sur le plan privé de l’origine.
Pour aller plus loin en maths spé
- Les énoncés : exercices de maths spé sur calcul différentiel
- À maîtriser avant : Compacité, connexité par arcs et dimension finie, Fonctions vectorielles d'une variable réelle
- Chapitre précédent : Exponentielle de matrice et systèmes différentiels
- Chapitre suivant : Fonctions de classe C^k et optimisation
- Le même thème en L3 : calcul différentiel, cours de maths en L3
- Tester vos connaissances : QCM de maths spé par chapitre
- Le sommaire : tous les chapitres de maths spé et les chapitres de maths sup