Ce cours d’applications linéaires L1 ouvre le cœur de l’algèbre linéaire du second semestre. Après les espaces vectoriels et les bases, on étudie enfin les applications qui respectent la structure. Vous y verrez la définition, les opérations sur \(\mathcal{L}(E, F)\), puis le noyau et l’image, avec la caractérisation de l’injectivité.
Le point central est le théorème du rang, démontré en détail. On en tire les équivalences entre injectif, surjectif et bijectif en dimension finie. Ensuite, le chapitre décrit les projecteurs et les symétries, puis les formes linéaires et les hyperplans.
Ces outils servent aussitôt pour les matrices d’applications linéaires et le changement de base. Ils reviendront ensuite en L2, avec la réduction des endomorphismes et la dualité.
Pour vous entraîner ensuite, travaillez les exercices de maths en L1 sur applications linéaires.
I. Définition des applications linéaires
Dans tout le chapitre, \(\mathbb{K}\) désigne \(\mathbb{R}\) ou \(\mathbb{C}\). Les lettres \(E\), \(F\) et \(G\) désignent des \(\mathbb{K}\)-espaces vectoriels. Une application linéaire est une application qui respecte la structure d’espace vectoriel. Autrement dit, elle transforme une combinaison linéaire en la combinaison linéaire des images.
Une application \(f : E \to F\) est dite linéaire si, pour tous \(x, y \in E\) et tout \(\lambda \in \mathbb{K}\), on a \(f(x + y) = f(x) + f(y)\) et \(f(\lambda x) = \lambda f(x)\).
On note \(\mathcal{L}(E, F)\) l’ensemble des applications linéaires de \(E\) dans \(F\). Une application linéaire de \(E\) dans \(E\) est un endomorphisme ; leur ensemble se note \(\mathcal{L}(E)\). Une application linéaire bijective est un isomorphisme. Enfin, un endomorphisme bijectif est un automorphisme.
En pratique, on regroupe les deux conditions en une seule. C’est la caractérisation la plus utilisée dans les exercices.
L’application \(f : E \to F\) est linéaire si et seulement si, pour tous \(x, y \in E\) et tous \(\lambda, \mu \in \mathbb{K}\) :
\[ f(\lambda x + \mu y) = \lambda f(x) + \mu f(y). \]
De plus, une application linéaire vérifie toujours \(f(0_E) = 0_F\) et \(f(-x) = -f(x)\).
Si \(f\) est linéaire, alors \(f(\lambda x + \mu y) = f(\lambda x) + f(\mu y) = \lambda f(x) + \mu f(y)\). Réciproquement, le choix \(\lambda = \mu = 1\) donne l’additivité. Ensuite, le choix \(\mu = 0\) donne l’homogénéité, car \(f(0_E) = f(0 \cdot 0_E) = 0 \cdot f(0_E) = 0_F\). Enfin, \(f(-x) = f((-1) x) = -f(x)\).
Pour montrer qu’une application est linéaire, on fixe \(x, y\) dans \(E\) et \(\lambda, \mu\) dans \(\mathbb{K}\). On calcule ensuite \(f(\lambda x + \mu y)\) et l’on fait apparaître \(\lambda f(x) + \mu f(y)\). Pour montrer au contraire qu’une application n’est pas linéaire, un seul contre-exemple suffit. Le plus rapide consiste souvent à tester \(f(0_E)\).
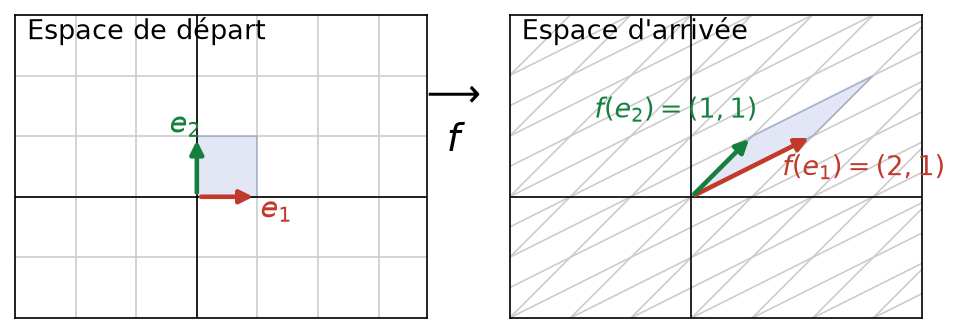
L’application \(f : \mathbb{R}^2 \to \mathbb{R}^2\), \((x, y) \mapsto (2x + y, x + y)\) est linéaire. En effet, ses coordonnées sont des combinaisons linéaires de \(x\) et \(y\). La dérivation \(D : \mathbb{R}[X] \to \mathbb{R}[X]\), \(P \mapsto P^{\prime}\) est aussi linéaire, tout comme \(\varphi : \mathcal{C}([0, 1], \mathbb{R}) \to \mathbb{R}\), \(g \mapsto \int_0^1 g(t)\, \mathrm{d}t\).
En revanche, \((x, y) \mapsto (x + 1, y)\) n’est pas linéaire, car l’image de \((0, 0)\) vaut \((1, 0)\). De même, \((x, y) \mapsto xy\) ne l’est pas : l’image de \(2(1, 1)\) vaut \(4\) et non \(2\).
Géométriquement, une application linéaire du plan envoie le quadrillage sur un quadrillage de parallélogrammes. Comme le montre la figure ci-dessous, tout est fixé par les images des deux vecteurs de base \(e_1\) et \(e_2\).
II. Opérations sur les applications linéaires
Les applications linéaires se combinent bien. On peut les additionner, les multiplier par un scalaire et les composer. Ainsi, on dispose de nouvelles structures algébriques.
1. L’espace vectoriel L(E, F)
Muni de l’addition \((f + g)(x) = f(x) + g(x)\) et de la multiplication externe \((\lambda f)(x) = \lambda f(x)\), l’ensemble \(\mathcal{L}(E, F)\) est un \(\mathbb{K}\)-espace vectoriel. C’est un sous-espace vectoriel de l’espace \(F^E\) de toutes les applications de \(E\) dans \(F\).
L’application nulle est linéaire, donc \(\mathcal{L}(E, F)\) n’est pas vide. Soient ensuite \(f, g\) linéaires et \(\alpha \in \mathbb{K}\). Pour \(x, y \in E\) et \(\lambda, \mu \in \mathbb{K}\), on a :
\[ (\alpha f + g)(\lambda x + \mu y) = \alpha \lambda f(x) + \alpha \mu f(y) + \lambda g(x) + \mu g(y) = \lambda (\alpha f + g)(x) + \mu (\alpha f + g)(y). \]
Par conséquent, \(\alpha f + g\) est linéaire. On conclut par la caractérisation des sous-espaces vectoriels.
2. Composition et réciproque
Si \(f \in \mathcal{L}(E, F)\) et \(g \in \mathcal{L}(F, G)\), alors \(g \circ f \in \mathcal{L}(E, G)\). De plus, si \(f\) est un isomorphisme, sa réciproque \(f^{-1}\) est linéaire, donc c’est un isomorphisme de \(F\) sur \(E\).
D’abord, \(g(f(\lambda x + \mu y)) = g(\lambda f(x) + \mu f(y)) = \lambda g(f(x)) + \mu g(f(y))\). Ensuite, soient \(u, v \in F\). Posons \(x = f^{-1}(u)\) et \(y = f^{-1}(v)\). Par linéarité de \(f\), on obtient \(f(\lambda x + \mu y) = \lambda u + \mu v\). En appliquant \(f^{-1}\), il vient \(f^{-1}(\lambda u + \mu v) = \lambda f^{-1}(u) + \mu f^{-1}(v)\).
L’ensemble des automorphismes de \(E\) se note \(\mathrm{GL}(E)\). C’est un groupe pour la composition, appelé groupe linéaire. On note aussi \(f^k = f \circ \cdots \circ f\) (\(k\) fois) et \(f^0 = \mathrm{Id}_E\).
La composition n’est pas commutative. Par exemple, dans \(\mathbb{R}^2\), prenons \(f(x, y) = (y, x)\) et \(g(x, y) = (x, 0)\). Alors \(f \circ g (x, y) = (0, x)\), tandis que \(g \circ f (x, y) = (y, 0)\). De même, \(f \circ g = 0\) n’entraîne pas \(f = 0\) ou \(g = 0\).
III. Noyau et image d’une application linéaire
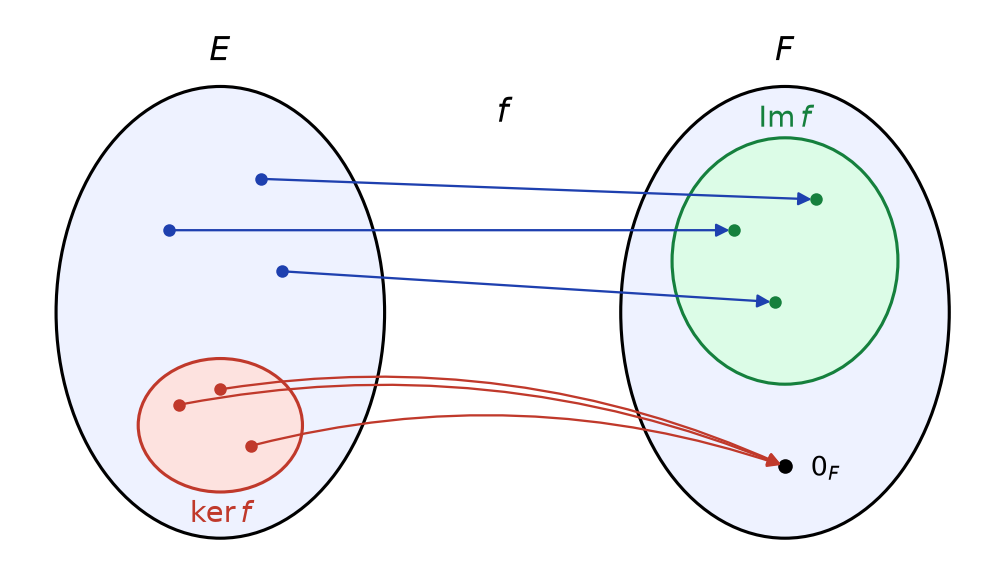
Deux sous-espaces sont attachés à toute application linéaire. Le noyau mesure ce que \(f\) « écrase », tandis que l’image mesure ce que \(f\) « atteint ».
Soit \(f \in \mathcal{L}(E, F)\). Le noyau de \(f\) est \(\ker f = \{x \in E \mid f(x) = 0_F\}\). L’image de \(f\) est \(\mathrm{Im}\, f = f(E) = \{f(x) \mid x \in E\}\).
La figure ci-dessous résume la situation. Les vecteurs du noyau sont tous envoyés sur \(0_F\). L’image est la partie de \(F\) effectivement atteinte.
Le noyau \(\ker f\) est un sous-espace vectoriel de \(E\), et l’image \(\mathrm{Im}\, f\) est un sous-espace vectoriel de \(F\). Plus généralement, l’image directe d’un sous-espace de \(E\) et l’image réciproque d’un sous-espace de \(F\) sont des sous-espaces vectoriels.
On a \(f(0_E) = 0_F\), donc \(0_E \in \ker f\). Si \(x, y \in \ker f\), alors \(f(\lambda x + \mu y) = \lambda \cdot 0_F + \mu \cdot 0_F = 0_F\). Ainsi, \(\ker f\) est stable par combinaison linéaire. De même, \(0_F = f(0_E)\) appartient à \(\mathrm{Im}\, f\). Enfin, \(\lambda f(x) + \mu f(y) = f(\lambda x + \mu y)\) appartient à \(\mathrm{Im}\, f\).
1. Injectivité et noyau
Soit \(f \in \mathcal{L}(E, F)\). Alors \(f\) est injective si et seulement si \(\ker f = \{0_E\}\). Par ailleurs, \(f\) est surjective si et seulement si \(\mathrm{Im}\, f = F\).
Supposons \(f\) injective. Si \(f(x) = 0_F = f(0_E)\), alors \(x = 0_E\). Donc \(\ker f = \{0_E\}\). Réciproquement, supposons \(\ker f = \{0_E\}\). Si \(f(x) = f(y)\), la linéarité donne \(f(x – y) = 0_F\). Par conséquent, \(x – y \in \ker f\), d’où \(x = y\). Le second point est la définition de la surjectivité.
2. Déterminer un noyau et une image
Si \((e_1, \ldots, e_n)\) est une famille génératrice de \(E\), alors \(\mathrm{Im}\, f = \mathrm{Vect}(f(e_1), \ldots, f(e_n))\).
Tout \(x \in E\) s’écrit \(x = \sum_{i=1}^n x_i e_i\). Donc \(f(x) = \sum_{i=1}^n x_i f(e_i)\) appartient à \(\mathrm{Vect}(f(e_1), \ldots, f(e_n))\). L’inclusion inverse vient du fait que \(\mathrm{Im}\, f\) est un sous-espace contenant chaque \(f(e_i)\).
Pour déterminer le noyau, on résout le système linéaire \(f(x) = 0\). On décrit ensuite l’ensemble des solutions par une base. Pour déterminer l’image, on calcule les images d’une base de \(E\). Puis on extrait de cette famille génératrice une base de \(\mathrm{Im}\, f\). Si besoin, on cherche enfin des équations de l’image.
Soit \(f : \mathbb{R}^3 \to \mathbb{R}^2\), \((x, y, z) \mapsto (x + y – z, 2x + 2y – 2z)\). Le noyau est le plan d’équation \(x + y – z = 0\). Une base en est \(((1, -1, 0), (1, 0, 1))\). L’image est engendrée par \(f(e_1) = (1, 2)\), \(f(e_2) = (1, 2)\) et \(f(e_3) = (-1, -2)\). Donc \(\mathrm{Im}\, f = \mathrm{Vect}((1, 2))\) : c’est une droite.
IV. Détermination par l’image d’une base
Une application linéaire est entièrement fixée par ce qu’elle fait sur une base. De plus, on peut choisir ces images librement. C’est le résultat fondamental qui relie applications linéaires et matrices.
Soit \((e_1, \ldots, e_n)\) une base de \(E\), et soient \(v_1, \ldots, v_n\) des vecteurs quelconques de \(F\). Il existe une unique application linéaire \(f : E \to F\) telle que \(f(e_i) = v_i\) pour tout \(i\).
Unicité : si \(f\) convient et si \(x = \sum x_i e_i\), alors nécessairement \(f(x) = \sum x_i v_i\). Existence : les coordonnées \(x_i\) de \(x\) sont uniques. On peut donc poser \(f(x) = \sum_{i=1}^n x_i v_i\). Les coordonnées de \(\lambda x + \mu y\) sont \(\lambda x_i + \mu y_i\). Ainsi, \(f\) est linéaire, et \(f(e_i) = v_i\).
Soit \(f \in \mathcal{L}(E, F)\) et \(\mathcal{B} = (e_1, \ldots, e_n)\) une base de \(E\).
- \(f\) est injective si et seulement si \((f(e_1), \ldots, f(e_n))\) est libre ;
- \(f\) est surjective si et seulement si \((f(e_1), \ldots, f(e_n))\) engendre \(F\) ;
- \(f\) est un isomorphisme si et seulement si \((f(e_1), \ldots, f(e_n))\) est une base de \(F\).
On a \(\sum x_i f(e_i) = 0\) si et seulement si \(\sum x_i e_i \in \ker f\). Donc la famille des images est libre exactement quand \(\ker f = \{0\}\). Le point sur la surjectivité découle de \(\mathrm{Im}\, f = \mathrm{Vect}(f(e_1), \ldots, f(e_n))\). Le troisième point combine les deux premiers.
On en déduit une conséquence très utile. Deux espaces de dimension finie sont isomorphes si et seulement s’ils ont la même dimension. En particulier, tout espace de dimension \(n\) est isomorphe à \(\mathbb{K}^n\), grâce à l’application « coordonnées dans une base ».
Cherchons \(f \in \mathcal{L}(\mathbb{R}^2)\) telle que \(f(1, 1) = (0, 2)\) et \(f(1, -1) = (2, 0)\). La famille \(((1, 1), (1,-1))\) est une base, donc \(f\) existe et est unique. Or \((x, y) = \frac{x + y}{2}(1, 1) + \frac{x – y}{2}(1, -1)\). Par conséquent, \(f(x, y) = (x – y, x + y)\).
V. Rang et théorème du rang
On suppose désormais que \(E\) est de dimension finie. Le rang mesure la « taille » de l’image. Le théorème du rang relie ensuite cette taille à celle du noyau.
Soit \(f \in \mathcal{L}(E, F)\) avec \(E\) de dimension finie. L’image \(\mathrm{Im}\, f\) est alors de dimension finie. On appelle rang de \(f\) le nombre \(\mathrm{rg}\, f = \dim \mathrm{Im}\, f\).
D’après la partie IV, \(\mathrm{rg}\, f\) est le rang de la famille \((f(e_1), \ldots, f(e_n))\). Par conséquent, \(\mathrm{rg}\, f \leq\, \dim E\). De plus, si \(F\) est de dimension finie, alors \(\mathrm{rg}\, f \leq\, \dim F\).
1. Le théorème du rang
Théorème du rang. Soit \(E\) de dimension finie et \(f \in \mathcal{L}(E, F)\). Alors :
\[ \dim E = \dim \ker f + \mathrm{rg}\, f. \]
Plus précisément, si \(S\) est un supplémentaire de \(\ker f\) dans \(E\), alors \(f\) induit un isomorphisme de \(S\) sur \(\mathrm{Im}\, f\).
En dimension finie, \(\ker f\) admet un supplémentaire \(S\). Ainsi, \(E = \ker f \oplus S\) et \(\dim S = \dim E – \dim \ker f\). Considérons la restriction \(g : S \to \mathrm{Im}\, f\), \(x \mapsto f(x)\). Elle est linéaire.
D’abord, \(g\) est injective. En effet, si \(x \in S\) et \(f(x) = 0\), alors \(x \in S \cap \ker f = \{0\}\).
Ensuite, \(g\) est surjective. Soit \(y = f(x)\) dans \(\mathrm{Im}\, f\). On écrit \(x = k + s\) avec \(k \in \ker f\) et \(s \in S\). Alors \(y = f(k) + f(s) = g(s)\).
Finalement, \(g\) est un isomorphisme. Donc \(\dim S = \dim \mathrm{Im}\, f\), ce qui donne la formule.
Soit \(f : \mathbb{R}^4 \to \mathbb{R}^2\), \((x, y, z, t) \mapsto (x + y, z + t)\). L’image contient \(f(e_1) = (1, 0)\) et \(f(e_3) = (0, 1)\), donc \(\mathrm{rg}\, f = 2\). Le théorème du rang donne alors \(\dim \ker f = 4 – 2 = 2\), sans résoudre de système. On vérifie d’ailleurs que \(\ker f = \mathrm{Vect}((1, -1, 0, 0), (0, 0, 1, -1))\).
Pour appliquer le théorème du rang, on calcule la dimension la plus facile, noyau ou image. On en déduit l’autre par \(\dim E = \dim \ker f + \mathrm{rg}\, f\). Ainsi, si l’on connaît \(\dim \ker f\) et une famille libre de l’image ayant le bon nombre de vecteurs, cette famille est une base de l’image.
2. Isomorphismes en dimension finie
Le théorème du rang a une conséquence spectaculaire. En dimension finie, et à dimensions égales, une seule des deux propriétés injectif ou surjectif suffit.
Soient \(E\) et \(F\) de dimension finie avec \(\dim E = \dim F = n\), et \(f \in \mathcal{L}(E, F)\). Les assertions suivantes sont équivalentes :
- \(f\) est injective ;
- \(f\) est surjective ;
- \(f\) est bijective ;
- \(\mathrm{rg}\, f = n\).
Par le théorème du rang, \(\mathrm{rg}\, f = n – \dim \ker f\). Or \(f\) est injective si et seulement si \(\dim \ker f = 0\), c’est-à-dire \(\mathrm{rg}\, f = n\). De même, \(f\) est surjective si et seulement si \(\dim \mathrm{Im}\, f = \dim F = n\). En effet, un sous-espace de même dimension finie que \(F\) est égal à \(F\). Les deux conditions sont donc équivalentes à \(\mathrm{rg}\, f = n\), et donc à la bijectivité.
L’hypothèse de dimension finie est indispensable. Dans \(\mathbb{R}[X]\), la dérivation \(P \mapsto P^{\prime}\) est surjective mais pas injective. À l’inverse, \(P \mapsto XP\) est injective mais pas surjective.
De même, pour un endomorphisme \(u\) d’un espace de dimension finie, il suffit de trouver \(v\) tel que \(u \circ v = \mathrm{Id}_E\). Alors \(u\) est inversible et \(v = u^{-1}\). En effet, \(u\) est alors surjective, donc bijective.
Soient \(f \in \mathcal{L}(E, F)\) et \(g \in \mathcal{L}(F, G)\), en dimension finie. Alors \(\mathrm{rg}(g \circ f) \leq\, \min(\mathrm{rg}\, f, \mathrm{rg}\, g)\). De plus, composer par un isomorphisme ne change pas le rang.
VI. Projecteurs et symétries
Les projections et les symétries sont les exemples géométriques les plus importants d’endomorphismes. Elles reposent sur une décomposition en somme directe \(E = F \oplus G\).
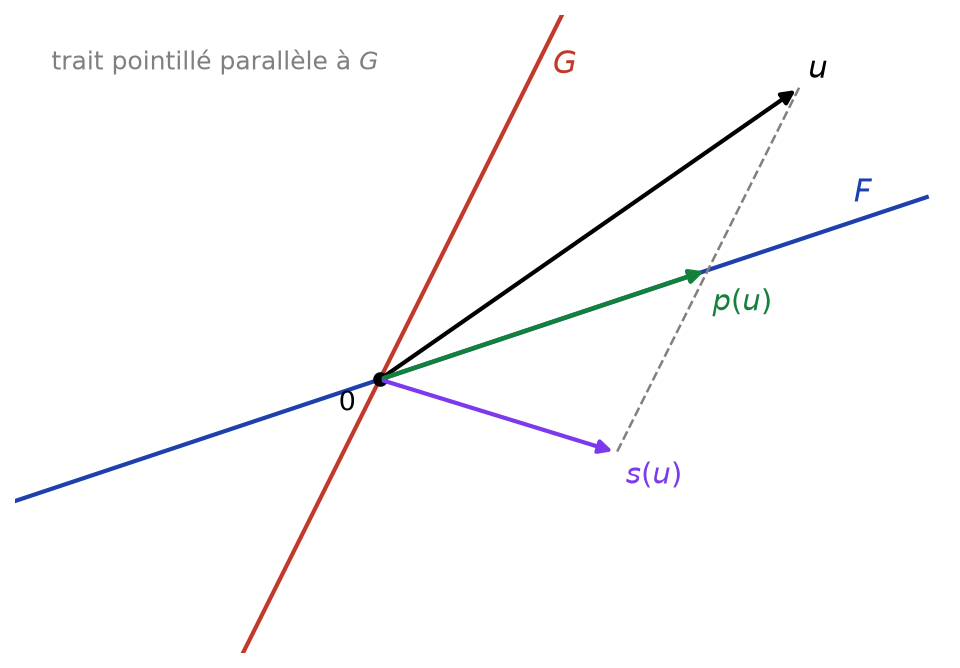
Soient \(F\) et \(G\) deux sous-espaces supplémentaires de \(E\). Tout \(x \in E\) s’écrit de façon unique \(x = x_F + x_G\) avec \(x_F \in F\) et \(x_G \in G\).
- La projection sur \(F\) parallèlement à \(G\) est \(p : x \mapsto x_F\).
- La symétrie par rapport à \(F\) parallèlement à \(G\) est \(s : x \mapsto x_F – x_G\).
La figure ci-dessous montre les deux constructions dans le plan. On trace la parallèle à \(G\) passant par l’extrémité de \(u\). Son intersection avec \(F\) donne \(p(u)\). Ensuite, \(s(u)\) est le symétrique de \(u\) par rapport à \(p(u)\).
Soit \(p \in \mathcal{L}(E)\). Alors \(p\) est un projecteur, c’est-à-dire une projection, si et seulement si \(p \circ p = p\). Dans ce cas, \(p\) est la projection sur \(\mathrm{Im}\, p = \ker(p – \mathrm{Id}_E)\) parallèlement à \(\ker p\), et \(E = \mathrm{Im}\, p \oplus \ker p\).
Une projection vérifie \(p(p(x)) = p(x_F) = x_F\), car \(x_F = x_F + 0\). Réciproquement, supposons \(p^2 = p\). D’abord, si \(y \in \mathrm{Im}\, p\), on écrit \(y = p(x)\), donc \(p(y) = p^2(x) = y\). Ainsi, \(\mathrm{Im}\, p = \ker(p – \mathrm{Id}_E)\).
Ensuite, tout \(x\) s’écrit \(x = p(x) + (x – p(x))\). Or \(p(x – p(x)) = p(x) – p^2(x) = 0\), donc \(E = \mathrm{Im}\, p + \ker p\). Enfin, si \(y\) est dans les deux, alors \(y = p(y) = 0\). La somme est donc directe, et \(p(x)\) est bien la composante de \(x\) sur \(\mathrm{Im}\, p\).
Soit \(s \in \mathcal{L}(E)\). Alors \(s\) est une symétrie si et seulement si \(s \circ s = \mathrm{Id}_E\). Dans ce cas, \(s\) est la symétrie par rapport à \(F = \ker(s – \mathrm{Id}_E)\) parallèlement à \(G = \ker(s + \mathrm{Id}_E)\). De plus, \(p = \frac{1}{2}(s + \mathrm{Id}_E)\) est la projection associée, et \(s = 2p – \mathrm{Id}_E\).
Si \(s\) est la symétrie par rapport à \(F\) parallèlement à \(G\), alors \(s = 2p – \mathrm{Id}_E\), où \(p\) est la projection correspondante. Réciproquement, supposons \(s^2 = \mathrm{Id}_E\) et posons \(p = \frac{1}{2}(s + \mathrm{Id}_E)\). On calcule \(p^2 = \frac{1}{4}(s^2 + 2s + \mathrm{Id}_E) = \frac{1}{2}(s + \mathrm{Id}_E) = p\). Donc \(p\) est un projecteur. De plus, \(p(x) = x\) équivaut à \(s(x) = x\), et \(p(x) = 0\) équivaut à \(s(x) = -x\). On conclut avec le théorème précédent.
Pour reconnaître un projecteur, on vérifie \(p \circ p = p\). Ensuite, on détermine ses éléments : \(\mathrm{Im}\, p\) en résolvant \(p(x) = x\), et \(\ker p\) en résolvant \(p(x) = 0\). Pour une symétrie, on vérifie \(s \circ s = \mathrm{Id}_E\), puis on résout \(s(x) = x\) et \(s(x) = -x\).
Dans \(\mathcal{M}_n(\mathbb{R})\), l’application \(s : M \mapsto M^{\mathrm{T}}\) vérifie \(s \circ s = \mathrm{Id}\). C’est donc la symétrie par rapport aux matrices symétriques, parallèlement aux matrices antisymétriques. Par conséquent, \(\mathcal{M}_n(\mathbb{R}) = \mathcal{S}_n(\mathbb{R}) \oplus \mathcal{A}_n(\mathbb{R})\).
VII. Formes linéaires et hyperplans
Le cas \(F = \mathbb{K}\) mérite une étude à part. Il permet de décrire simplement les sous-espaces définis par une seule équation.
Une forme linéaire sur \(E\) est une application linéaire de \(E\) dans \(\mathbb{K}\). Un hyperplan de \(E\) est le noyau d’une forme linéaire non nulle.
Sur \(\mathbb{K}^n\), les formes linéaires sont exactement les applications \((x_1, \ldots, x_n) \mapsto a_1 x_1 + \cdots + a_n x_n\). Sur \(\mathbb{R}_n[X]\), l’application \(P \mapsto P(1)\) est une forme linéaire. De même, \(P \mapsto \int_0^1 P(t)\, \mathrm{d}t\) en est une.
Soit \(\varphi\) une forme linéaire non nulle sur \(E\) et \(H = \ker \varphi\). Pour tout vecteur \(a \notin H\), on a \(E = H \oplus \mathrm{Vect}(a)\). En particulier, si \(\dim E = n\), alors \(\dim H = n – 1\).
On a \(\varphi(a) \neq 0\). Pour \(x \in E\), posons \(\lambda = \frac{\varphi(x)}{\varphi(a)}\). Alors \(\varphi(x – \lambda a) = 0\), donc \(x = (x – \lambda a) + \lambda a\) avec \(x – \lambda a \in H\). Ensuite, si \(\mu a \in H\), alors \(\mu \varphi(a) = 0\), donc \(\mu = 0\). En dimension finie, on peut aussi utiliser le théorème du rang : \(\varphi\) est non nulle, donc \(\mathrm{rg}\, \varphi = 1\) et \(\dim H = n – 1\).
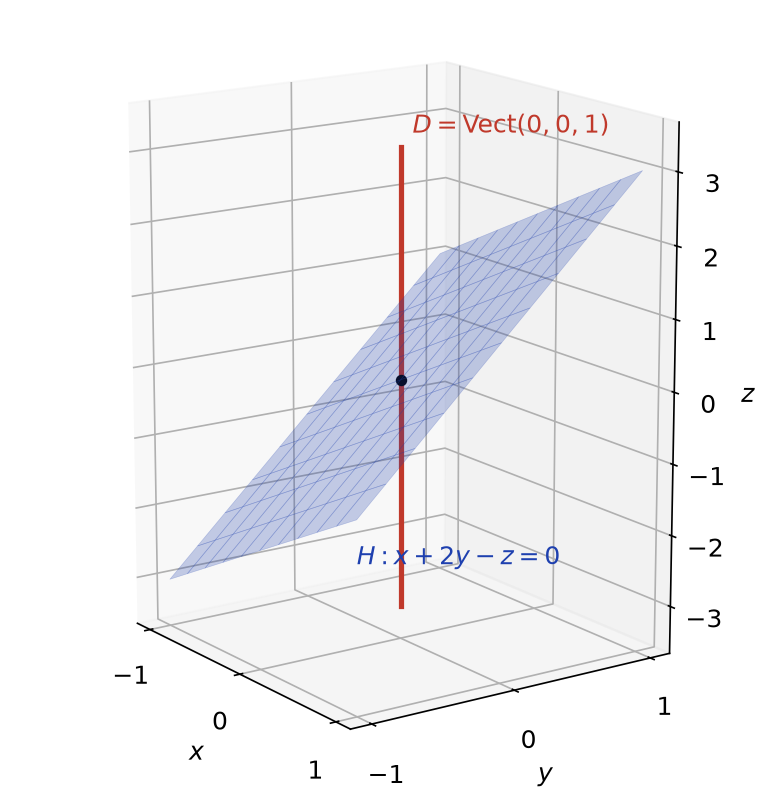
Dans \(\mathbb{R}^3\), les hyperplans sont donc les plans passant par l’origine. Comme le montre la figure ci-dessous, toute droite non contenue dans le plan \(H\) en est un supplémentaire.
Deux formes linéaires non nulles \(\varphi\) et \(\psi\) ont le même noyau si et seulement si elles sont proportionnelles : \(\psi = \lambda \varphi\) avec \(\lambda \neq 0\). Ainsi, un hyperplan possède une équation unique à un facteur non nul près.
Le sens réciproque est immédiat. Supposons ensuite \(\ker \varphi = \ker \psi = H\). Choisissons \(a \notin H\) et posons \(\lambda = \frac{\psi(a)}{\varphi(a)}\). Les formes \(\psi\) et \(\lambda \varphi\) coïncident sur \(H\), où elles sont nulles, et en \(a\). Or \(E = H \oplus \mathrm{Vect}(a)\). Par linéarité, elles sont donc égales.
En dimension finie, la réciproque du théorème est vraie : tout sous-espace de dimension \(n – 1\) est un hyperplan. En effet, on complète une base \((h_1, \ldots, h_{n-1})\) de ce sous-espace en une base de \(E\). Ensuite, on prend pour \(\varphi\) la forme « dernière coordonnée ».
Ce qu’il faut retenir
- Une application \(f\) est linéaire si \(f(\lambda x + \mu y) = \lambda f(x) + \mu f(y)\) ; elle vérifie alors \(f(0) = 0\).
- \(\mathcal{L}(E, F)\) est un espace vectoriel ; la composée de deux applications linéaires est linéaire, la réciproque d’un isomorphisme aussi.
- Le noyau et l’image sont des sous-espaces vectoriels ; \(f\) est injective si et seulement si \(\ker f = \{0\}\).
- Une application linéaire est déterminée par l’image d’une base, que l’on choisit librement.
- L’image d’une base engendre \(\mathrm{Im}\, f\) ; elle est libre si et seulement si \(f\) est injective.
- Théorème du rang : \(\dim E = \dim \ker f + \mathrm{rg}\, f\).
- Si \(\dim E = \dim F\) est finie : injective, surjective et bijective sont équivalentes.
- Projecteur : \(p^2 = p\) et \(E = \mathrm{Im}\, p \oplus \ker p\) ; symétrie : \(s^2 = \mathrm{Id}_E\) et \(s = 2p – \mathrm{Id}_E\).
- Un hyperplan est le noyau d’une forme linéaire non nulle ; en dimension \(n\), il est de dimension \(n – 1\).
Questions fréquentes sur applications linéaires
Comment montrer rapidement qu'une application est linéaire ?
On fixe deux vecteurs \(x, y\) et deux scalaires \(\lambda, \mu\), puis on vérifie que \(f(\lambda x + \mu y) = \lambda f(x) + \mu f(y)\). Si les coordonnées de \(f(x)\) sont des combinaisons linéaires des coordonnées de \(x\), c’est immédiat. Pour prouver qu’une application n’est pas linéaire, on teste d’abord \(f(0)\), puis \(f(2x)\).
Pourquoi le noyau suffit-il pour tester l'injectivité ?
Par linéarité, \(f(x) = f(y)\) équivaut à \(f(x – y) = 0\), c’est-à-dire \(x – y \in \ker f\). Ainsi, \(f\) est injective si et seulement si \(\ker f = \{0\}\). On n’a donc qu’une seule équation \(f(x) = 0\) à résoudre.
Le théorème du rang dit-il que E est la somme directe du noyau et de l'image ?
Non. Il donne seulement l’égalité des dimensions \(\dim E = \dim \ker f + \mathrm{rg}\, f\), et l’image vit d’ailleurs dans \(F\). Même pour un endomorphisme, le noyau et l’image peuvent se couper : pour \(f(x, y) = (y, 0)\), ils sont égaux. La somme est directe par exemple pour un projecteur.
Comment reconnaître un projecteur ou une symétrie ?
Un endomorphisme \(p\) est un projecteur si et seulement si \(p \circ p = p\) ; c’est alors la projection sur \(\mathrm{Im}\, p\) parallèlement à \(\ker p\). Un endomorphisme \(s\) est une symétrie si et seulement si \(s \circ s = \mathrm{Id}\). On obtient ses éléments en résolvant \(s(x) = x\) et \(s(x) = -x\).
Pour aller plus loin en L1
- Les énoncés : exercices de maths en L1 sur applications linéaires
- À maîtriser avant : Familles libres, bases et dimension
- Chapitre précédent : Familles libres, bases et dimension
- Chapitre suivant : Matrice d'une application linéaire et changement de base
- Le même thème en maths sup : applications linéaires, cours de maths sup
- Tester vos connaissances : QCM de maths en L1 par chapitre
- Le sommaire : tous les chapitres de maths de L1 et la licence de maths de L1 à L3