Ce chapitre sur les hyperplans en maths sup prolonge l’étude des applications linéaires du second semestre. Vous y rencontrez d’abord les formes linéaires et les formes coordonnées dans une base. Ensuite, le cours définit un hyperplan comme le noyau d’une forme non nulle, puis montre qu’il admet une droite pour supplémentaire. Vous apprenez aussi à comparer deux équations d’un même hyperplan.
La suite du cours décrit un sous-espace par un système d’équations et relie le nombre d’équations à la dimension. Elle installe ensuite la structure affine : points, vecteurs, translations, sous-espaces affines et leurs intersections.
Enfin, le chapitre hyperplans sup unifie toutes les équations linéaires de l’année sous la forme u(x) = a. Systèmes, équations différentielles, suites récurrentes et interpolation reçoivent ainsi une même lecture géométrique : une solution particulière plus le noyau.
Pour vous entraîner ensuite, travaillez les exercices de maths sup sur hyperplans et sous-espaces affines.
I. Formes linéaires sur un espace vectoriel
Dans tout le chapitre, \(\mathbb{K}\) désigne \(\mathbb{R}\) ou \(\mathbb{C}\) et \(E\) un \(\mathbb{K}\)-espace vectoriel. Les formes linéaires sont les applications linéaires les plus simples : elles prennent leurs valeurs dans \(\mathbb{K}\). Pourtant, elles suffisent à décrire tous les sous-espaces d’un espace de dimension finie. C’est pourquoi on commence par elles.
Une forme linéaire sur \(E\) est une application linéaire \(\varphi : E \to \mathbb{K}\). L’ensemble des formes linéaires sur \(E\) est l’espace vectoriel \(\mathcal{L}(E, \mathbb{K})\), noté aussi \(E^{*}\) et appelé dual de \(E\).
Sur \(\mathbb{R}^3\), l’application \((x, y, z) \mapsto 2x – y + 3z\) est une forme linéaire. De même, sur \(\mathbb{R}_n[X]\), l’évaluation \(P \mapsto P(1)\) en est une. Sur \(\mathcal{C}([0,1], \mathbb{R})\), l’intégrale \(f \mapsto \int_0^1 f(t)\,\mathrm{d}t\) est linéaire par linéarité de l’intégrale. Enfin, la trace \(M \mapsto \operatorname{tr}(M)\) est une forme linéaire sur \(\mathcal{M}_n(\mathbb{K})\).
En revanche, \((x, y) \mapsto xy\) n’est pas linéaire. Par exemple, l’image de \(2(1,1)\) vaut \(4\) et non \(2\). De même, \((x, y) \mapsto x + y + 1\) ne l’est pas, car l’image de \(0\) doit être nulle.
Une forme linéaire non nulle est toujours surjective. En effet, son image est un sous-espace de \(\mathbb{K}\), donc \(\{0\}\) ou \(\mathbb{K}\) tout entier. Par conséquent, si \(\varphi \neq 0\), alors \(\operatorname{rg} \varphi = 1\).
1. Formes coordonnées dans une base
On suppose désormais que \(E\) est de dimension finie \(n \geq\, 1\) et on fixe une base \(\mathcal{B} = (e_1, \ldots, e_n)\). Tout vecteur s’écrit alors de façon unique \(x = x_1 e_1 + \cdots + x_n e_n\).
Pour \(i \in \{1, \ldots, n\}\), la \(i\)-ième forme coordonnée relative à \(\mathcal{B}\) est l’application \(e_i^{*} : x \mapsto x_i\). Elle est caractérisée par \(e_i^{*}(e_j) = \delta_{i,j}\), où \(\delta_{i,j}\) vaut \(1\) si \(i = j\) et \(0\) sinon.
La famille \((e_1^{*}, \ldots, e_n^{*})\) est une base de \(E^{*}\). De plus, toute forme linéaire \(\varphi\) s’écrit
\[\varphi = \sum_{i=1}^{n} \varphi(e_i)\, e_i^{*}, \quad \text{autrement dit} \quad \varphi(x) = a_1 x_1 + \cdots + a_n x_n \ \text{avec} \ a_i = \varphi(e_i).\]
En particulier, \(\dim E^{*} = n\).
Soit \(\varphi \in E^{*}\) et \(x = \sum x_i e_i\). Par linéarité, \(\varphi(x) = \sum x_i \varphi(e_i) = \sum \varphi(e_i) e_i^{*}(x)\). Ainsi la famille est génératrice. Ensuite, si \(\sum \lambda_i e_i^{*} = 0\), on évalue en \(e_j\) : il reste \(\lambda_j = 0\). La famille est donc libre.
Autrement dit, dans une base, une forme linéaire est toujours une combinaison linéaire des coordonnées. Sa matrice dans la base \(\mathcal{B}\) (et la base \((1)\) de \(\mathbb{K}\)) est la ligne \(\begin{pmatrix} a_1 \cdots a_n \end{pmatrix}\).
Dans \(\mathbb{R}^2\), prenons la base \(e_1 = (1,0)\), \(e_2 = (1,1)\). Le vecteur \((x, y)\) vaut \((x – y) e_1 + y e_2\). Donc \(e_1^{*}(x, y) = x – y\) et \(e_2^{*}(x, y) = y\). Notez que \(e_1^{*}\) dépend de toute la base, et pas seulement de \(e_1\).
II. Hyperplans vectoriels
1. Définition et caractérisation
Un hyperplan de \(E\) est le noyau d’une forme linéaire non nulle. Si \(H = \ker \varphi\) avec \(\varphi \neq 0\), on dit que \(\varphi(x) = 0\) est une équation de \(H\).
Cette définition vaut en dimension quelconque. Par exemple, \(\{P \in \mathbb{K}[X] : P(1) = 0\}\) est un hyperplan de \(\mathbb{K}[X]\). De même, les fonctions continues d’intégrale nulle sur \([0,1]\) forment un hyperplan de \(\mathcal{C}([0,1], \mathbb{R})\).
Soit \(H\) un sous-espace de \(E\). Alors \(H\) est un hyperplan si et seulement si \(H\) admet une droite pour supplémentaire. Dans ce cas, pour tout vecteur \(a \notin H\), on a \(E = H \oplus \mathbb{K} a\).
Supposons \(H = \ker \varphi\) avec \(\varphi \neq 0\), et soit \(a \notin H\), donc \(\varphi(a) \neq 0\). Pour \(x \in E\), on pose \(\lambda = \dfrac{\varphi(x)}{\varphi(a)}\) et \(h = x – \lambda a\). Alors \(\varphi(h) = \varphi(x) – \lambda \varphi(a) = 0\), donc \(h \in H\) et \(x = h + \lambda a\). Ainsi \(E = H + \mathbb{K} a\). De plus, si \(\mu a \in H\), alors \(\mu \varphi(a) = 0\), donc \(\mu = 0\). La somme est donc directe.
Réciproquement, supposons \(E = H \oplus \mathbb{K} a\) avec \(a \neq 0\). Tout \(x\) s’écrit de façon unique \(x = h + \lambda a\). L’application \(\varphi : x \mapsto \lambda\) est linéaire, non nulle car \(\varphi(a) = 1\), et son noyau est exactement \(H\).
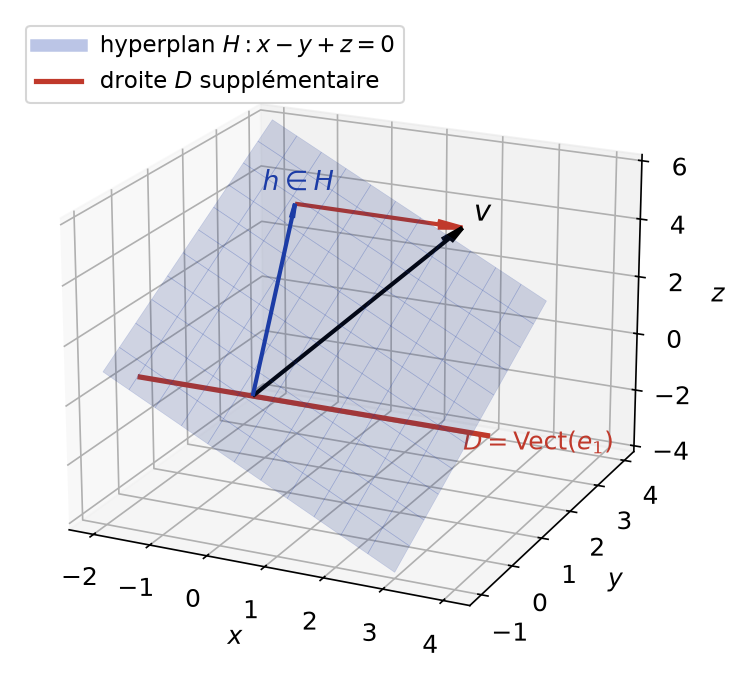
La démonstration fournit une formule utile : la composante de \(x\) sur la droite vaut \(\dfrac{\varphi(x)}{\varphi(a)}\, a\). Comme le montre la figure ci-dessous, tout vecteur \(v\) de \(\mathbb{R}^3\) se décompose en une partie dans le plan \(H\) et une partie sur la droite \(D\).
Si \(\dim E = n\), les hyperplans de \(E\) sont exactement les sous-espaces de dimension \(n – 1\). Dans \(\mathbb{R}^2\), ce sont les droites vectorielles ; dans \(\mathbb{R}^3\), les plans vectoriels.
En effet, un sous-espace de dimension \(n-1\) possède un supplémentaire, et celui-ci est de dimension \(1\). Inversement, d’après le théorème du rang, \(\dim \ker \varphi = n – \operatorname{rg} \varphi = n – 1\).
2. Équation d’un hyperplan dans une base
Soit \(\mathcal{B}\) une base de \(E\), de dimension \(n\). Une partie \(H\) est un hyperplan si et seulement s’il existe \((a_1, \ldots, a_n) \neq (0, \ldots, 0)\) tel que
\[H = \{x \in E : a_1 x_1 + a_2 x_2 + \cdots + a_n x_n = 0\},\]
où \((x_1, \ldots, x_n)\) sont les coordonnées de \(x\) dans \(\mathcal{B}\).
Pour écrire l’équation d’un hyperplan \(H = \mathrm{Vect}(v_1, \ldots, v_{n-1})\) donné par une base :
- on cherche \(a_1 x_1 + \cdots + a_n x_n = 0\) avec des inconnues \(a_1, \ldots, a_n\) ;
- on écrit que chaque \(v_k\) vérifie l’équation : cela donne \(n – 1\) équations en les \(a_i\) ;
- on choisit une solution non nulle, puis on vérifie sur chaque \(v_k\).
Dans \(\mathbb{R}^3\), on peut aussi prendre pour \((a_1, a_2, a_3)\) le produit vectoriel des deux générateurs.
Cherchons une équation de \(H = \mathrm{Vect}((1,2,0), (0,1,1))\). On veut \(a + 2b = 0\) et \(b + c = 0\). Avec \(b = 1\), on obtient \(a = -2\) et \(c = -1\). Donc \(H : -2x + y – z = 0\), soit \(2x – y + z = 0\). Enfin, on vérifie : \(2 – 2 + 0 = 0\) et \(0 – 1 + 1 = 0\).
3. Deux équations d’un même hyperplan
Une équation n’est pas unique : \(x + 2y = 0\) et \(3x + 6y = 0\) décrivent la même droite. Le théorème suivant montre que c’est la seule liberté possible.
Soient \(\varphi\) et \(\psi\) deux formes linéaires non nulles sur \(E\). Alors \(\ker \varphi = \ker \psi\) si et seulement s’il existe \(\lambda \in \mathbb{K}^{*}\) tel que \(\psi = \lambda \varphi\).
Le sens réciproque est immédiat. Pour le sens direct, notons \(H\) le noyau commun et prenons \(a \notin H\). Alors \(E = H \oplus \mathbb{K} a\). Posons \(\lambda = \dfrac{\psi(a)}{\varphi(a)}\), qui est non nul. Les formes \(\psi\) et \(\lambda \varphi\) sont nulles sur \(H\) et coïncident en \(a\). Elles coïncident donc sur \(H \oplus \mathbb{K} a = E\).
Le résultat concerne deux formes non nulles. Pour comparer deux équations \(a_1 x_1 + \cdots + a_n x_n = 0\) et \(b_1 x_1 + \cdots + b_n x_n = 0\), il faut donc vérifier que les \(n\)-uplets \((a_i)\) et \((b_i)\) sont proportionnels.
III. Intersections d’hyperplans et systèmes d’équations
1. Intersection de m hyperplans
Un système linéaire homogène de \(m\) équations à \(n\) inconnues décrit l’intersection de \(m\) hyperplans. On relie ici le nombre d’équations à la dimension de l’ensemble décrit.
Soient \(E\) de dimension \(n\) et \(\varphi_1, \ldots, \varphi_m\) des formes linéaires sur \(E\). On note \(r\) le rang de la famille \((\varphi_1, \ldots, \varphi_m)\) dans \(E^{*}\). Alors
\[\dim \bigcap_{k=1}^{m} \ker \varphi_k = n – r \geq\, n – m.\]
En particulier, l’intersection de \(m\) hyperplans est de dimension au moins \(n – m\), avec égalité si et seulement si les formes sont linéairement indépendantes.
On pose \(u : E \to \mathbb{K}^m\), \(x \mapsto (\varphi_1(x), \ldots, \varphi_m(x))\). Cette application est linéaire et son noyau est l’intersection cherchée. Dans une base de \(E\), la matrice de \(u\) a pour lignes les coefficients des \(\varphi_k\). Son rang est donc le rang des lignes, c’est-à-dire \(r\). Le théorème du rang donne alors \(\dim \ker u = n – r\). Enfin, \(r \leq\, m\), d’où l’inégalité.
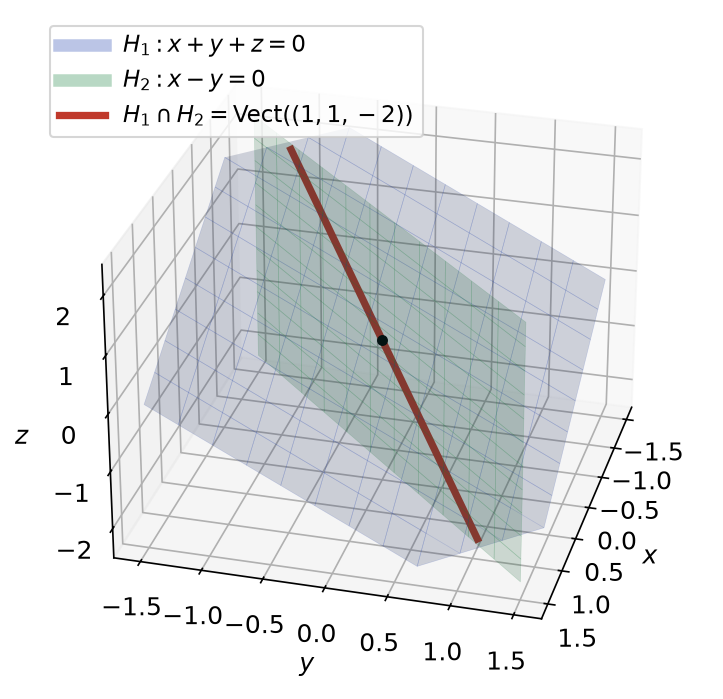
La figure ci-dessous illustre le cas \(n = 3\), \(m = 2\). Deux plans vectoriels distincts de \(\mathbb{R}^3\) ont des équations non proportionnelles ; ils se coupent donc selon une droite.
2. Décrire un sous-espace par un système d’équations
Si \(\dim E = n\), tout sous-espace \(F\) de dimension \(p\) est l’intersection de \(n – p\) hyperplans. Autrement dit, \(F\) est décrit par un système de \(n – p\) équations linéaires indépendantes, et on ne peut pas faire avec moins.
Soit \((e_1, \ldots, e_p)\) une base de \(F\), complétée en une base \((e_1, \ldots, e_n)\) de \(E\). Un vecteur est dans \(F\) si et seulement si ses coordonnées d’indices \(p+1, \ldots, n\) sont nulles. Ainsi \(F = \bigcap_{k=p+1}^{n} \ker e_k^{*}\), intersection de \(n – p\) hyperplans. De plus, d’après le théorème précédent, \(m\) équations donnent une dimension au moins \(n – m\). Il faut donc \(m \geq\, n – p\).
Pour obtenir un système d’équations de \(F = \mathrm{Vect}(v_1, \ldots, v_p)\), où la famille est libre :
- on cherche les formes \(a_1 x_1 + \cdots + a_n x_n\) qui s’annulent sur chaque \(v_k\) ; c’est un système de \(p\) équations en les \(a_i\) ;
- on en extrait une base de solutions, de cardinal \(n – p\) ;
- chaque solution donne une équation de \(F\).
Une autre voie consiste à écrire que \(x\) est combinaison des \(v_k\), puis à éliminer les paramètres.
Soit \(F = \mathrm{Vect}((1, 1, 1))\) dans \(\mathbb{R}^3\). Les formes nulles sur \((1,1,1)\) vérifient \(a + b + c = 0\). Une base de solutions est \((1, -1, 0)\), \((0, 1, -1)\). Par conséquent, \(F\) est décrit par \(x – y = 0\) et \(y – z = 0\).
IV. Structure affine d’un espace vectoriel
1. Points, vecteurs et translations
Un même élément de \(E\) peut être vu de deux façons. D’une part, c’est un point, une position. D’autre part, c’est un vecteur, un déplacement. Cette double lecture est la structure affine de \(E\).
Pour deux points \(a, b \in E\), on note \(\vec{ab} = b – a\). On a la relation de Chasles \(\vec{ab} + \vec{bc} = \vec{ac}\). Pour \(u \in E\), la translation de vecteur \(u\) est \(t_u : x \mapsto x + u\).
Pour tous \(u, v \in E\), on a \(t_u \circ t_v = t_{u+v}\) et \(t_0 = \mathrm{Id}_E\). Chaque translation est donc bijective, de réciproque \(t_{-u}\). En revanche, pour \(u \neq 0\), \(t_u\) n’est pas linéaire, car \(t_u(0) = u \neq 0\).
2. Sous-espaces affines
Une partie \(\mathcal{A}\) de \(E\) est un sous-espace affine s’il existe un point \(a \in E\) et un sous-espace vectoriel \(F\) tels que
\[\mathcal{A} = a + F = \{a + f : f \in F\}.\]
Le sous-espace \(F\) s’appelle la direction de \(\mathcal{A}\). Si \(\dim F = 1\), on parle de droite affine ; si \(\dim F = 2\), de plan affine.
Soit \(\mathcal{A} = a + F\). Alors :
- \(F = \{\vec{bc} : b, c \in \mathcal{A}\}\), donc la direction est unique ;
- pour tout \(b \in \mathcal{A}\), on a \(\mathcal{A} = b + F\) ;
- \(\mathcal{A}\) est un sous-espace vectoriel si et seulement si \(0 \in \mathcal{A}\).
Si \(b = a + f\) et \(c = a + g\) avec \(f, g \in F\), alors \(c – b = g – f \in F\). Inversement, \(f = \vec{a\,(a+f)}\). Cela prouve le premier point. Ensuite, si \(b = a + f_0 \in \mathcal{A}\), alors \(a + f = b + (f – f_0)\), et \(f – f_0\) décrit \(F\) quand \(f\) décrit \(F\). Enfin, si \(0 \in \mathcal{A}\), le deuxième point donne \(\mathcal{A} = 0 + F = F\).
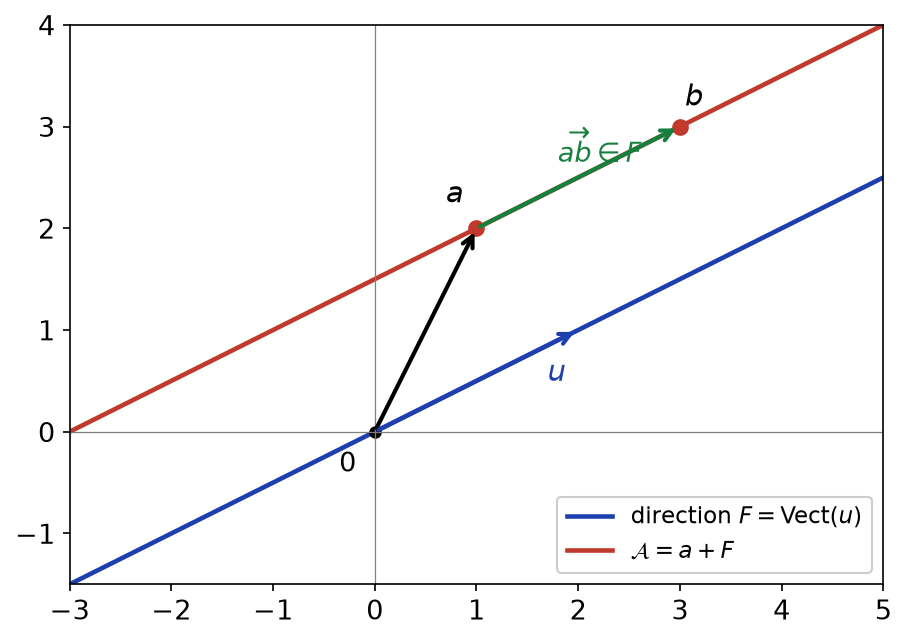
Comme le montre la figure ci-dessous, \(\mathcal{A} = a + F\) est l’image de la direction \(F\) par la translation \(t_a\). De plus, deux points \(a\) et \(b\) de \(\mathcal{A}\) définissent un vecteur \(\vec{ab}\) de \(F\).
Deux sous-espaces affines de même direction sont dits parallèles. Ainsi, \(a + F\) et \(b + F\) sont soit égaux, soit disjoints : ils sont égaux si et seulement si \(b – a \in F\).
3. Hyperplans affines
Un hyperplan affine est un sous-espace affine dont la direction est un hyperplan. Les hyperplans affines sont exactement les ensembles
\[\{x \in E : \varphi(x) = c\}, \quad \varphi \in E^{*} \setminus \{0\}, \ c \in \mathbb{K}.\]
La direction est alors \(\ker \varphi\). Dans une base, on obtient une équation \(a_1 x_1 + \cdots + a_n x_n = c\).
Comme \(\varphi \neq 0\), elle est surjective ; il existe donc \(x_0\) tel que \(\varphi(x_0) = c\). Alors \(\varphi(x) = c\) équivaut à \(\varphi(x – x_0) = 0\), soit \(x \in x_0 + \ker \varphi\). Réciproquement, \(a + \ker \varphi = \{x : \varphi(x) = \varphi(a)\}\).
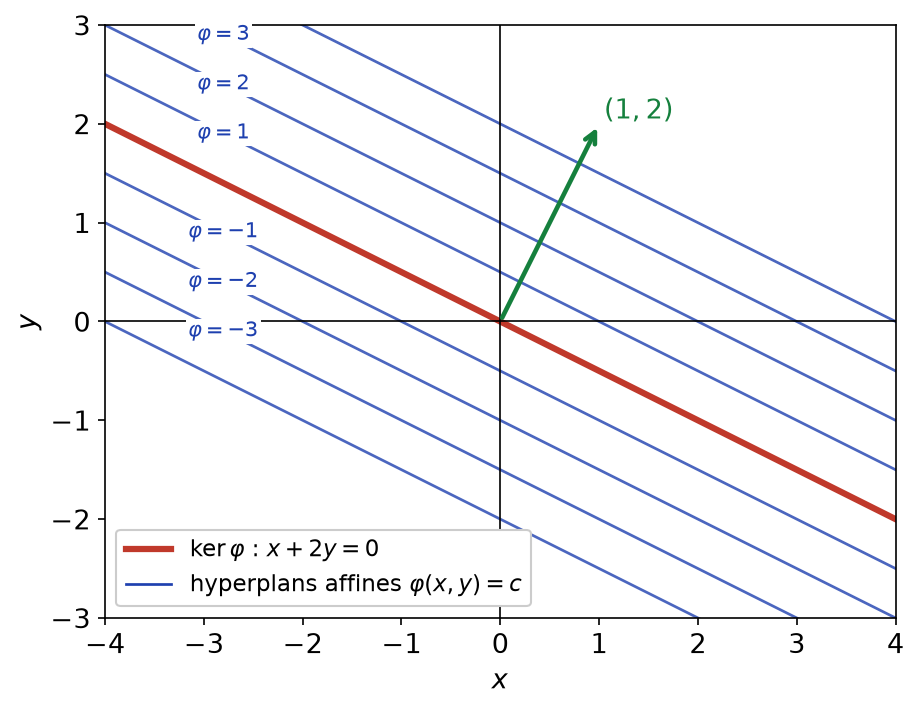
Les ensembles \(\{\varphi = c\}\) sont les lignes de niveau de \(\varphi\). Dans le plan, avec \(\varphi(x, y) = x + 2y\), on obtient la famille des droites parallèles à \(\ker \varphi\) tracées ci-dessous. On observe aussi que le vecteur \((1, 2)\) des coefficients est orthogonal à ces droites.
4. Intersection de sous-espaces affines
Soit \((\mathcal{A}_i)_{i \in I}\) une famille de sous-espaces affines de directions \(F_i\). Leur intersection est soit vide, soit un sous-espace affine de direction \(\bigcap_{i} F_i\).
Supposons l’intersection non vide et prenons-y un point \(a\). D’après la proposition précédente, \(\mathcal{A}_i = a + F_i\) pour tout \(i\). Donc \(x \in \bigcap \mathcal{A}_i\) si et seulement si \(x – a \in F_i\) pour tout \(i\). Autrement dit, \(\bigcap \mathcal{A}_i = a + \bigcap F_i\).
Soient \(\mathcal{A} = a + F\) et \(\mathcal{A}^{\prime} = b + G\). Alors \(\mathcal{A} \cap \mathcal{A}^{\prime} \neq \emptyset\) si et seulement si \(b – a \in F + G\). En particulier, si \(F + G = E\), l’intersection n’est jamais vide.
Si \(x = a + f = b + g\), alors \(b – a = f – g \in F + G\). Réciproquement, si \(b – a = f + g\), le point \(x = a + f = b – g\) est commun aux deux.
Pour déterminer l’intersection de sous-espaces affines :
- on décrit chacun par des équations cartésiennes, ou l’un par une représentation paramétrique ;
- on résout le système obtenu, par exemple par la méthode du pivot ;
- on conclut : ensemble vide si le système est incompatible, sinon un point particulier plus la direction \(\bigcap F_i\).
Dans \(\mathbb{R}^2\), les droites \(x + 2y = 3\) et \(2x – y = 1\) ont des directions distinctes. Leur somme vaut \(\mathbb{R}^2\) et leur intersection vaut \(\{0\}\). L’intersection est donc un unique point : le système donne \(x = 1\) et \(y = 1\). En revanche, les droites \(x + 2y = 3\) et \(x + 2y = 5\) sont parallèles et disjointes.
V. Les équations linéaires u(x) = a
1. Structure de l’ensemble des solutions
Voici le résultat qui unifie toute l’année. Soient \(E\) et \(F\) deux espaces vectoriels, \(u \in \mathcal{L}(E, F)\) et \(a \in F\). On étudie l’équation d’inconnue \(x \in E\) :
\[u(x) = a.\]
L’équation \(u(x) = 0\) s’appelle l’équation homogène associée.
L’ensemble \(S\) des solutions de \(u(x) = a\) est :
- vide si \(a \notin \operatorname{Im} u\) ;
- sinon, le sous-espace affine \(S = x_0 + \ker u\), où \(x_0\) est une solution particulière quelconque.
En dimension finie, lorsque \(S\) n’est pas vide, sa direction est de dimension \(\dim E – \operatorname{rg} u\).
L’équation a une solution exactement quand \(a \in \operatorname{Im} u\). Soit alors \(x_0\) une solution. Pour \(x \in E\), par linéarité, \(u(x) = a \Leftrightarrow u(x) = u(x_0) \Leftrightarrow u(x – x_0) = 0 \Leftrightarrow x – x_0 \in \ker u\). Ainsi \(S = x_0 + \ker u\). La dimension découle enfin du théorème du rang.
On retient la formule « solution générale \(=\) solution particulière \(+\) solution générale de l’équation homogène ». Elle vaut pour les systèmes, les équations différentielles linéaires, les suites récurrentes linéaires et l’interpolation.
2. Quatre lectures d’un même théorème
Systèmes linéaires. Le système \(AX = B\), avec \(A \in \mathcal{M}_{m,n}(\mathbb{K})\), est l’équation \(u(X) = B\) pour \(u : X \mapsto AX\). Il est compatible si et seulement si \(B\) est combinaison des colonnes de \(A\). Dans ce cas, ses solutions forment un sous-espace affine de dimension \(n – \operatorname{rg} A\). Géométriquement, c’est l’intersection de \(m\) hyperplans affines.
Équations différentielles. Soient \(a, b\) continues sur un intervalle \(I\). L’équation \(y^{\prime} + a y = b\) s’écrit \(u(y) = b\) avec \(u : y \mapsto y^{\prime} + a y\), linéaire de \(\mathcal{C}^1(I)\) dans \(\mathcal{C}^0(I)\). Son noyau est la droite engendrée par \(x \mapsto e^{-A(x)}\), où \(A\) est une primitive de \(a\). Les solutions forment donc une droite affine de \(\mathcal{C}^1(I)\).
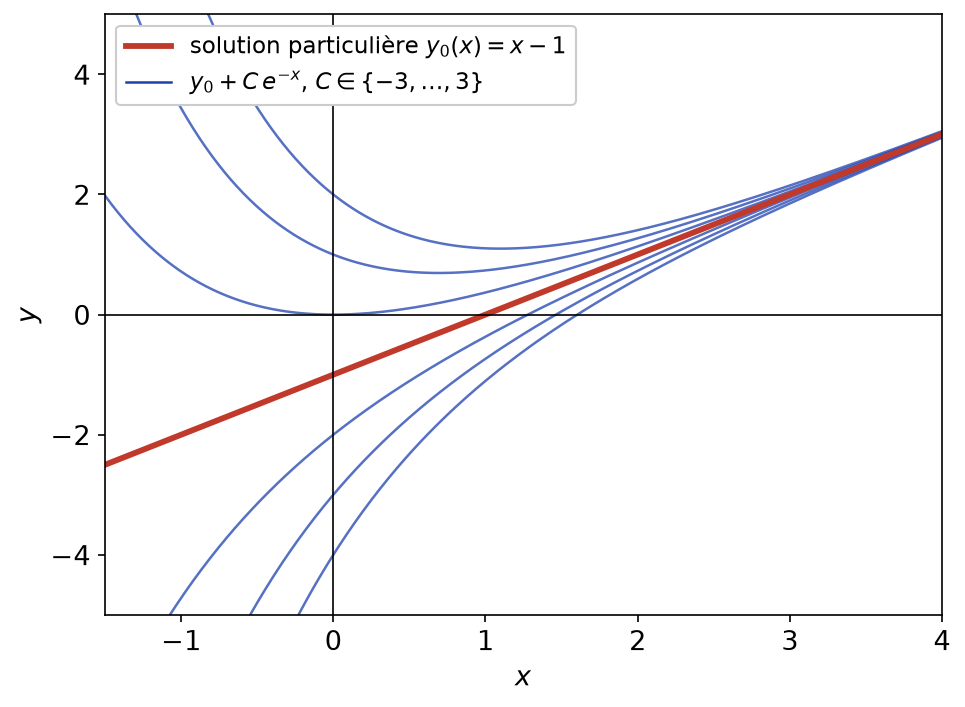
Pour \(y^{\prime} + y = x\) sur \(\mathbb{R}\), la fonction \(y_0(x) = x – 1\) convient, car \(1 + x – 1 = x\). Le noyau est \(\mathrm{Vect}(x \mapsto e^{-x})\). Les solutions sont donc les fonctions \(x \mapsto x – 1 + C e^{-x}\), \(C \in \mathbb{R}\). La figure ci-dessous représente cette droite affine de fonctions.
Suites récurrentes. L’ensemble des suites vérifiant \(u_{n+2} = \alpha u_{n+1} + \beta u_n + \gamma\) est l’ensemble des solutions de \(\Phi(u) = c\), où \(\Phi(u) = (u_{n+2} – \alpha u_{n+1} – \beta u_n)_n\) et \(c\) est la suite constante égale à \(\gamma\). C’est donc un plan affine de \(\mathbb{K}^{\mathbb{N}}\), dirigé par le plan des suites récurrentes linéaires homogènes.
Interpolation. Pour des réels distincts \(x_0, \ldots, x_p\), l’application \(P \mapsto (P(x_0), \ldots, P(x_p))\) est linéaire. Les polynômes prenant des valeurs imposées en ces points forment donc un sous-espace affine, dirigé par les multiples de \(\prod_k (X – x_k)\).
Pour résoudre une équation linéaire \(u(x) = a\) :
- on identifie l’espace de départ, l’espace d’arrivée et l’application linéaire \(u\) ;
- on détermine \(\ker u\), c’est-à-dire la solution générale de l’équation homogène ;
- on cherche une solution particulière, en devinant une forme adaptée au second membre ;
- on conclut \(S = x_0 + \ker u\), puis on exploite les conditions initiales ou supplémentaires.
L’ensemble des solutions d’une équation avec second membre non nul n’est jamais un sous-espace vectoriel. En effet, \(0\) n’est pas solution. Par conséquent, la somme de deux solutions n’est pas une solution ; en revanche, leur différence est solution de l’équation homogène.
Ce qu’il faut retenir
- Une forme linéaire est une application linéaire à valeurs dans \(\mathbb{K}\) ; dans une base, elle s’écrit \(a_1 x_1 + \cdots + a_n x_n\) avec \(a_i = \varphi(e_i)\).
- Les formes coordonnées \(e_i^{*}\) vérifient \(e_i^{*}(e_j) = \delta_{i,j}\) et forment une base de \(E^{*}\).
- Un hyperplan est le noyau d’une forme linéaire non nulle, ou de façon équivalente un sous-espace qui admet une droite pour supplémentaire.
- En dimension \(n\), les hyperplans sont les sous-espaces de dimension \(n – 1\).
- Deux équations définissent le même hyperplan si et seulement si elles sont proportionnelles.
- L’intersection de \(m\) hyperplans est de dimension \(n – r\), où \(r\) est le rang des formes ; un sous-espace de dimension \(p\) se décrit par \(n – p\) équations indépendantes.
- Un sous-espace affine s’écrit \(a + F\), avec une direction \(F\) unique et n’importe quel point \(a\) de l’ensemble.
- Une intersection de sous-espaces affines est vide ou affine, de direction l’intersection des directions ; \((a + F) \cap (b + G) \neq \emptyset\) équivaut à \(b – a \in F + G\).
- Les solutions de \(u(x) = a\) forment l’ensemble vide ou \(x_0 + \ker u\) : c’est le cas des systèmes, des équations différentielles linéaires, des suites récurrentes et de l’interpolation.
Questions fréquentes sur hyperplans et sous-espaces affines
Comment trouver l'équation d'un hyperplan donné par une base ?
On cherche des coefficients a_1, …, a_n tels que a_1 x_1 + … + a_n x_n s’annule sur chaque vecteur de la base de l’hyperplan. On obtient n – 1 équations linéaires en les a_i, dont on choisit une solution non nulle. Dans R^3, le produit vectoriel des deux générateurs donne directement les coefficients.
Deux équations différentes peuvent-elles définir le même hyperplan ?
Oui, mais seulement si elles sont proportionnelles. Deux formes linéaires non nulles ont le même noyau si et seulement si l’une est un multiple non nul de l’autre. Ainsi x + 2y = 0 et 3x + 6y = 0 décrivent la même droite.
Combien d'équations faut-il pour décrire un sous-espace ?
En dimension n, un sous-espace de dimension p se décrit par n – p équations linéaires indépendantes, et jamais par moins. Plus généralement, m équations de rang r définissent un sous-espace de dimension n – r.
Pourquoi l'ensemble des solutions de u(x) = a n'est-il pas un sous-espace vectoriel ?
Lorsque a est non nul, le vecteur nul n’est pas solution. L’ensemble des solutions est alors vide ou de la forme x_0 + ker u : c’est un sous-espace affine, translaté du noyau par une solution particulière.
Pour aller plus loin en maths sup
- Les énoncés : exercices de maths sup sur hyperplans et sous-espaces affines
- À maîtriser avant : Applications linéaires et théorème du rang
- Chapitre précédent : Applications linéaires et théorème du rang
- Chapitre suivant : Matrices, changements de base, rang et trace
- Tester vos connaissances : QCM de maths sup par chapitre
- Le sommaire : tous les chapitres de maths sup et les chapitres de maths spé