Ce corrigé linéaires sup rédige entièrement les 22 exercices sur les applications linéaires. Chaque solution suit la même démarche : vérifier la linéarité, calculer le noyau par un système, puis obtenir l’image à partir d’une famille génératrice. Ensuite, le théorème du rang sert de contrôle ou de raccourci.
Soyez attentifs à trois pièges fréquents. D’abord, l’anneau \(\mathcal{L}(E)\) n’est pas commutatif : on ne développe jamais \((p + q)^2\) comme un carré de réels. Ensuite, l’équivalence entre injectivité et bijectivité exige la dimension finie. Enfin, le théorème du rang ne donne pas une somme directe du noyau et de l’image. Des figures illustrent les projections, les plans images et l’interpolation obtenus. Les résultats finaux sont en gras pour faciliter votre relecture.
Les énoncés se trouvent sur la page exercices de maths sup sur applications linéaires.
Corrigé de l’exercice 1 : Reconnaître une application linéaire
- Soient \(u = (x, y)\), \(u^{\prime} = (x^{\prime}, y^{\prime})\) et \(\lambda \in \mathbb{R}\). On a \(f_1(\lambda u + u^{\prime}) = \big(\lambda x + x^{\prime} + \lambda y + y^{\prime},\ 2\lambda x + 2x^{\prime} – \lambda y – y^{\prime}\big)\). Ce vecteur est égal à \(\lambda f_1(u) + f_1(u^{\prime})\). Donc \(f_1\) est linéaire.
- On a \(f_2(0, 0) = (1, 0) \neq (0, 0)\). Or une application linéaire envoie le vecteur nul sur le vecteur nul. Donc \(f_2\) n’est pas linéaire.
- D’une part, \(f_3(-1, 0) = (1, 0)\). D’autre part, \(-f_3(1, 0) = (-1, 0)\). La relation \(f_3(\lambda u) = \lambda f_3(u)\) échoue pour \(\lambda = -1\). Donc \(f_3\) n’est pas linéaire.
- Soit \(I_2\) la matrice identité. Alors \(\det(2I_2) = 4\), alors que \(2 \det(I_2) = 2\). Le déterminant n’est donc pas linéaire sur \(\mathcal{M}_2(\mathbb{R})\).
- La dérivation est linéaire, et la multiplication par \(X\) aussi. En effet, \((\lambda P + Q)^{\prime} + X(\lambda P + Q) = \lambda(P^{\prime} + XP) + (Q^{\prime} + XQ)\). Donc \(f_5\) est un endomorphisme de \(\mathbb{R}[X]\).
- L’évaluation en \(0\) est linéaire, et l’intégrale sur \([0, 1]\) est linéaire. Par conséquent, leur somme est linéaire. Ainsi, \(f_6\) est une forme linéaire sur \(\mathcal{C}([0, 1], \mathbb{R})\).
- Pour \(f_1\), le noyau s’obtient en résolvant \(x + y = 0\) et \(2x – y = 0\). En ajoutant, \(3x = 0\), donc \(x = y = 0\). Ensuite, soit \(P \neq 0\) de degré \(d\). Alors \(\deg(XP) = d + 1\) et \(\deg P^{\prime} < d\), donc \(\deg(P^{\prime} + XP) = d + 1\) et \(f_5(P) \neq 0\). Enfin, la fonction \(g(t) = 4t – 1\) vérifie \(g(0) = -1\) et \(\int_0^1 g = 2 – 1 = 1\), donc \(f_6(g) = 0\) avec \(g \neq 0\). Les applications \(f_1\) et \(f_5\) sont injectives ; \(f_6\) ne l’est pas.
Point de méthode : pour réfuter la linéarité, on teste d’abord l’image de \(0\), puis un multiple simple comme \(-u\) ou \(2u\).
Corrigé de l’exercice 2 : Noyau et image dans R3
- On résout \(f(x, y, z) = 0\) :
\[\begin{cases} x – y + z = 0 \\ 2x + y – z = 0 \\ x + 2y – 2z = 0 \end{cases}\]
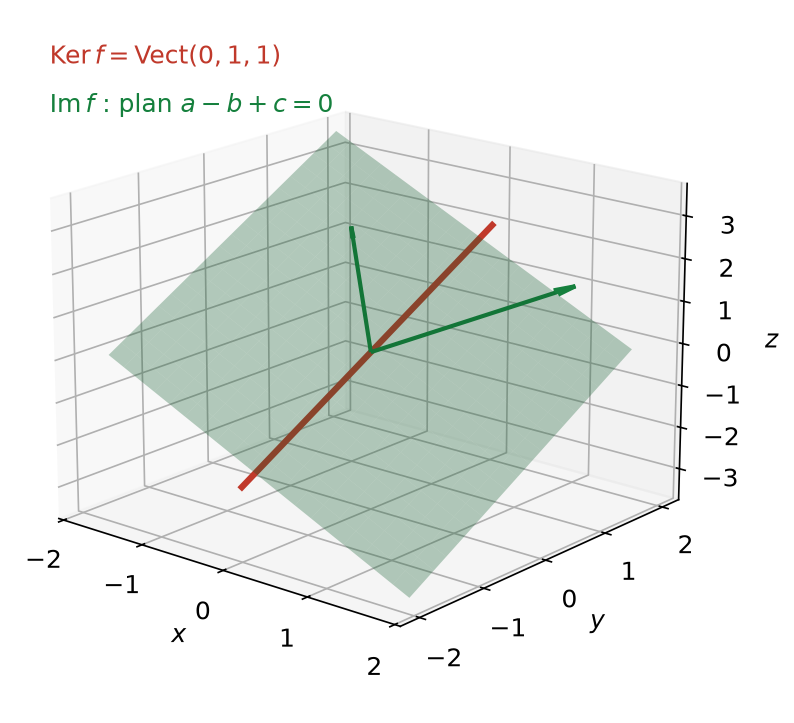
En additionnant les deux premières lignes, on obtient \(3x = 0\), donc \(x = 0\). Ensuite, la première donne \(y = z\), et la troisième est alors vérifiée. Ainsi, \(\ker f = \mathrm{Vect}\big((0, 1, 1)\big)\). - L’image est engendrée par les images de la base canonique : \(f(e_1) = (1, 2, 1)\), \(f(e_2) = (-1, 1, 2)\) et \(f(e_3) = (1, -1, -2)\). On remarque que \(f(e_3) = -f(e_2)\). De plus, \(f(e_1)\) et \(f(e_2)\) ne sont pas colinéaires. Donc \(\big((1, 2, 1), (-1, 1, 2)\big)\) est une base de \(\operatorname{Im} f\). Par ailleurs, la troisième coordonnée de \(f(x, y, z)\) est la deuxième moins la première. Tout vecteur \((a, b, c)\) de l’image vérifie donc \(c = b – a\). Ce plan est de dimension 2, comme \(\operatorname{Im} f\). Par conséquent, \(\operatorname{Im} f\) est le plan d’équation \(a – b + c = 0\).
- On a \(\dim \ker f + \operatorname{rg} f = 1 + 2 = 3 = \dim \mathbb{R}^3\). Le théorème du rang est bien vérifié. L’application \(f\) n’est ni injective (noyau non nul) ni surjective (rang 2).
- Le vecteur \((1, 1, 0)\) vérifie \(1 – 1 + 0 = 0\), donc il est dans l’image. On résout \(x – y + z = 1\) et \(2x + y – z = 1\). En ajoutant, \(3x = 2\), donc \(x = \frac{2}{3}\). Ensuite, \(z – y = \frac{1}{3}\). Le vecteur \((\frac{2}{3}, -\frac{1}{3}, 0)\) convient : on vérifie que \(f\) l’envoie sur \((1, 1, 0)\). Les antécédents sont les vecteurs \((\frac{2}{3}, -\frac{1}{3} + t, t)\), \(t \in \mathbb{R}\). C’est un antécédent particulier plus le noyau.
La figure ci-dessous montre le résultat : le noyau est une droite, l’image est un plan qui contient les deux vecteurs de base trouvés.
Corrigé de l’exercice 3 : Un endomorphisme de R2[X]
- Si \(\deg P \leq\, 2\), alors \(\deg(XP^{\prime}) \leq\, 2\). Donc \(\varphi(P) \in \mathbb{R}_2[X]\). De plus, la dérivation et la multiplication par \(X\) sont linéaires. Ainsi, \(\varphi\) est un endomorphisme de \(\mathbb{R}_2[X]\).
- On calcule \(\varphi(1) = 1\), \(\varphi(X) = X – X = 0\) et \(\varphi(X^2) = X^2 – 2X^2 = -X^2\). Donc, pour \(P = a + bX + cX^2\), on obtient \(\varphi(P) = a – cX^2\). Ce polynôme est nul si et seulement si \(a = c = 0\). Par conséquent, \(\ker \varphi = \mathrm{Vect}(X)\), \(\operatorname{Im} \varphi = \mathrm{Vect}(1, X^2)\) et \(\operatorname{rg} \varphi = 2\).
- La famille \((X, 1, X^2)\) est la base canonique, à l’ordre près. Donc \(\mathbb{R}_2[X] = \ker \varphi \oplus \operatorname{Im} \varphi\).
- On a \(\varphi(\varphi(X^2)) = \varphi(-X^2) = X^2 \neq \varphi(X^2)\). Donc \(\varphi\) n’est pas un projecteur. En revanche, \(\varphi^2(a + bX + cX^2) = \varphi(a – cX^2) = a + cX^2\). Ainsi \(\varphi^2\) garde les composantes sur \(1\) et \(X^2\), et annule celle sur \(X\). Par suite, \(\varphi^4 = \varphi^2\). Donc \(\varphi^2\) est la projection sur \(\mathrm{Vect}(1, X^2)\) parallèlement à \(\mathrm{Vect}(X)\).
Corrigé de l’exercice 4 : Un projecteur du plan
- On calcule \(p(p(x, y)) = p(2x – 2y, x – y)\). La première coordonnée vaut \(2(2x – 2y) – 2(x – y) = 2x – 2y\). La seconde vaut \((2x – 2y) – (x – y) = x – y\). Donc \(p \circ p = p\), et \(p\) est un projecteur.
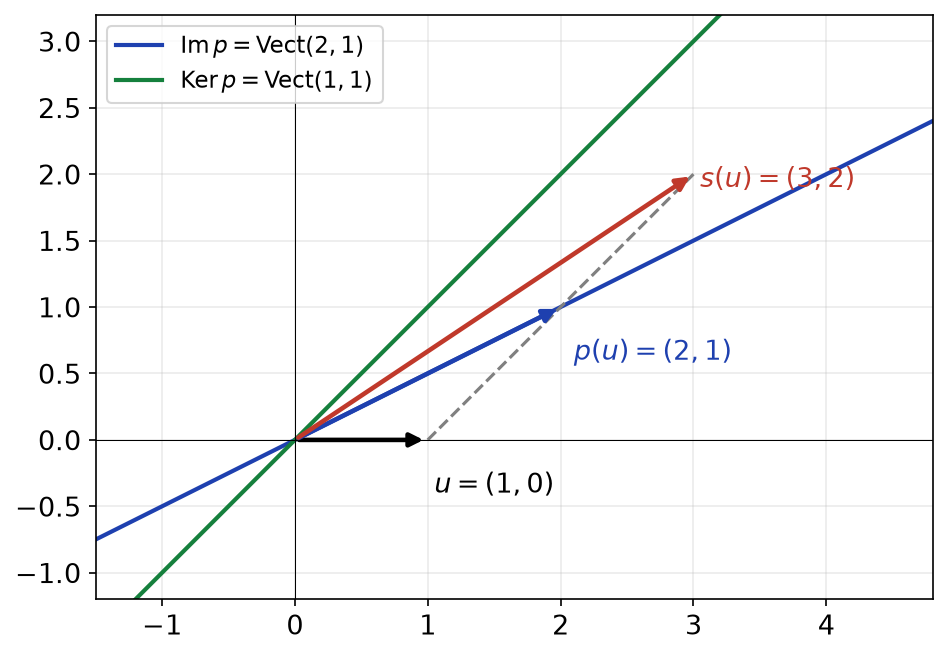
- D’abord, \(p(x, y) = 0\) équivaut à \(x = y\). Donc \(\ker p = \mathrm{Vect}\big((1, 1)\big)\). Ensuite, \(p(x, y) = (x – y)(2, 1)\), donc \(\operatorname{Im} p \subset \mathrm{Vect}\big((2, 1)\big)\). L’égalité vient de \(p(1, 0) = (2, 1)\). Ainsi, \(p\) est la projection sur la droite \(\mathrm{Vect}\big((2, 1)\big)\) parallèlement à la droite \(\mathrm{Vect}\big((1, 1)\big)\).
- On a \(p(1, 0) = (2, 1)\). La composante dans le noyau est \((1, 0) – p(1, 0) = (-1, -1)\). Donc \((1, 0) = (2, 1) + (-1, -1)\), avec \((2, 1) \in \operatorname{Im} p\) et \((-1, -1) \in \ker p\).
- On obtient \(q(x, y) = (x – 2x + 2y,\ y – x + y) = (-x + 2y,\ -x + 2y)\). De plus, \(q^2 = \mathrm{id} – 2p + p^2 = \mathrm{id} – p = q\). Enfin, \(\operatorname{Im} q = \ker p\) et \(\ker q = \operatorname{Im} p\). Donc \(q\) est la projection sur \(\mathrm{Vect}\big((1, 1)\big)\) parallèlement à \(\mathrm{Vect}\big((2, 1)\big)\).
Corrigé de l’exercice 5 : Une symétrie du plan
- On calcule \(s(s(x, y)) = s(3x – 4y, 2x – 3y)\). La première coordonnée vaut \(3(3x – 4y) – 4(2x – 3y) = x\). La seconde vaut \(2(3x – 4y) – 3(2x – 3y) = y\). Donc \(s \circ s = \mathrm{id}\) : \(s\) est une symétrie, et \(s\) est bijective avec \(s^{-1} = s\).
- D’abord, \(s(x, y) = (x, y)\) équivaut à \(2x – 4y = 0\), c’est-à-dire \(x = 2y\). Ensuite, \(s(x, y) = -(x, y)\) équivaut à \(4x – 4y = 0\), soit \(x = y\). Donc \(\ker(s – \mathrm{id}) = \mathrm{Vect}\big((2, 1)\big)\) et \(\ker(s + \mathrm{id}) = \mathrm{Vect}\big((1, 1)\big)\) : \(s\) est la symétrie par rapport à \(\mathrm{Vect}\big((2, 1)\big)\) parallèlement à \(\mathrm{Vect}\big((1, 1)\big)\).
- On calcule \(2p – \mathrm{id}\) : \((4x – 4y – x,\ 2x – 2y – y) = (3x – 4y,\ 2x – 3y)\). Donc \(s = 2p – \mathrm{id}\) : c’est la symétrie associée au projecteur de l’exercice 4, et \(s(1, 0) = (3, 2)\).
La figure ci-dessous résume les exercices 4 et 5. Le vecteur \(p(u)\) est le milieu du segment joignant \(u\) à \(s(u)\).
Corrigé de l’exercice 6 : Espaces isomorphes et dimension
- On a \(\dim \mathbb{R}_3[X] = 4\), \(\dim \mathcal{M}_2(\mathbb{R}) = 4\) et \(\dim \mathcal{L}(\mathbb{R}^2) = 2 \times 2 = 4\). L’application \(a + bX + cX^2 + dX^3 \mapsto \begin{pmatrix} a b \\ c d \end{pmatrix}\) est linéaire. Elle envoie la base canonique de \(\mathbb{R}_3[X]\) sur la base canonique de \(\mathcal{M}_2(\mathbb{R})\). C’est donc un isomorphisme.
- L’application \((a, b, c) \mapsto \begin{pmatrix} a b \\ b c \end{pmatrix}\) est linéaire de \(\mathbb{R}^3\) dans \(\mathcal{S}_2(\mathbb{R})\). Elle est injective, car la matrice nulle impose \(a = b = c = 0\). Elle est aussi surjective, car toute matrice symétrique a cette forme. Donc \(\mathcal{S}_2(\mathbb{R})\) est isomorphe à \(\mathbb{R}^3\), et \(\dim \mathcal{S}_2(\mathbb{R}) = 3\).
- Soit \(f \in \mathcal{L}(\mathbb{R}^3, \mathbb{R}^2)\). Son rang est au plus \(2\). Par le théorème du rang, \(\dim \ker f = 3 – \operatorname{rg} f \geq\, 1\). Donc \(f\) n’est pas injective. De même, si \(g \in \mathcal{L}(\mathbb{R}^2, \mathbb{R}^3)\), alors \(\operatorname{rg} g \leq\, 2 < 3\). Aucune injection linéaire de \(\mathbb{R}^3\) dans \(\mathbb{R}^2\), aucune surjection linéaire de \(\mathbb{R}^2\) sur \(\mathbb{R}^3\) n’existe.
- On a \(\dim \mathbb{R}_2[X] = 3\) et \(\dim \mathcal{M}_{2,3}(\mathbb{R}) = 6\). Donc \(\dim \mathcal{L}(\mathbb{R}_2[X], \mathcal{M}_{2,3}(\mathbb{R})) = 3 \times 6 = 18\).
Corrigé de l’exercice 7 : Projection sur un plan parallèlement à une droite
- Le vecteur \(w = (1, 2, 0)\) vérifie \(1 + 2 + 0 = 3 \neq 0\), donc \(w \notin P\). Ainsi \(P \cap D = \{0\}\), car \(D\) est une droite. De plus, \(\dim P + \dim D = 2 + 1 = 3\). Par conséquent, \(\mathbb{R}^3 = P \oplus D\).
- Soit \(u = (x, y, z)\). On cherche \(t\) tel que \(u – tw \in P\). Cela s’écrit \((x – t) + (y – 2t) + z = 0\), soit \(t = \frac{x + y + z}{3}\). Alors \(p(u) = u – tw\). On obtient \(p(x, y, z) = (\dfrac{2x – y – z}{3},\ \dfrac{-2x + y – 2z}{3},\ z)\).
- La symétrie vérifie \(s = 2p – \mathrm{id}\), c’est-à-dire \(s(u) = u – 2tw\). On obtient \(s(x, y, z) = (\dfrac{x – 2y – 2z}{3},\ \dfrac{-4x – y – 4z}{3},\ z)\).
- Pour \(w\) : \(p(1, 2, 0) = (0, 0, 0)\) et \(s(1, 2, 0) = (-1, -2, 0) = -w\), comme attendu pour un vecteur de \(D\). Pour \((1, -1, 0)\), qui est dans \(P\) : \(p(1, -1, 0) = (\frac{3}{3}, \frac{-3}{3}, 0) = (1, -1, 0)\), et de même \(s(1, -1, 0) = (1, -1, 0)\). Les formules sont cohérentes avec la définition géométrique.
Corrigé de l’exercice 8 : Construire une application linéaire par l’image d’une base
- Une application linéaire est déterminée de façon unique par l’image d’une base, choisie librement. D’où l’existence et l’unicité de \(u\). Par linéarité, \(u(x, y, z) = x(1, 1, 0) + y(0, 1, 1) + z(1, 2, 1)\). Donc \(u(x, y, z) = (x + z,\ x + y + 2z,\ y + z)\). Le noyau s’obtient avec \(x = -z\) et \(y = -z\) ; la deuxième équation est alors vérifiée. Ainsi, \(\ker u = \mathrm{Vect}\big((1, 1, -1)\big)\). Ensuite, \(u(e_3) = u(e_1) + u(e_2)\), et \(u(e_1)\), \(u(e_2)\) ne sont pas colinéaires. Par conséquent, \(\operatorname{Im} u = \mathrm{Vect}\big((1, 1, 0), (0, 1, 1)\big)\), plan d’équation \(a – b + c = 0\).
- On a \((2, 0) = (1, 1) + (1, -1)\). Si \(v\) existait, sa linéarité imposerait \(v(2, 0) = (1, 0) + (0, 1) = (1, 1)\). Or on demande \(v(2, 0) = (1, 2)\). Une telle application \(v\) n’existe donc pas.
- On complète \(k = (1, 1, 1)\) en une base \((k, e_1, e_2)\) de \(\mathbb{R}^3\). C’est bien une base, car \(k \notin \mathrm{Vect}(e_1, e_2)\). On pose alors \(w(k) = 0\), \(w(e_1) = e_1\) et \(w(e_2) = e_2\). Comme \(e_3 = k – e_1 – e_2\), on obtient \(w(e_3) = -e_1 – e_2\). Ainsi, \(w(x, y, z) = (x – z,\ y – z,\ 0)\). Vérifions : \(\operatorname{Im} w = \mathrm{Vect}(e_1, e_2)\) est le plan \(z = 0\). Par le théorème du rang, \(\dim \ker w = 1\), et \(k \in \ker w\). Donc \(\ker w = \mathrm{Vect}(k)\).
- Si \(\ker f = \operatorname{Im} f\), le théorème du rang donne \(3 = 2 \dim \ker f\). C’est impossible, car \(3\) est impair. Aucun endomorphisme de \(\mathbb{R}^3\) n’a un noyau égal à son image.
Corrigé de l’exercice 9 : Image directe et image réciproque
- Soit \(y \in f(A + A^{\prime})\). Alors \(y = f(a + a^{\prime}) = f(a) + f(a^{\prime})\), avec \(a \in A\) et \(a^{\prime} \in A^{\prime}\). Donc \(y \in f(A) + f(A^{\prime})\). Réciproquement, un élément \(f(a) + f(a^{\prime})\) de \(f(A) + f(A^{\prime})\) s’écrit \(f(a + a^{\prime})\). Ainsi, \(f(A + A^{\prime}) = f(A) + f(A^{\prime})\).
- Soit \(x = a + k\) avec \(a \in A\) et \(k \in \ker f\). Alors \(f(x) = f(a) \in f(A)\), donc \(x \in f^{-1}(f(A))\). Réciproquement, si \(f(x) \in f(A)\), il existe \(a \in A\) tel que \(f(x) = f(a)\). Alors \(k = x – a\) vérifie \(f(k) = 0\), et \(x = a + k\). Donc \(f^{-1}(f(A)) = A + \ker f\).
- Si \(y = f(x)\) avec \(f(x) \in B\), alors \(y \in B\) et \(y \in \operatorname{Im} f\). Réciproquement, si \(y \in B \cap \operatorname{Im} f\), on écrit \(y = f(x)\). Alors \(f(x) \in B\), donc \(x \in f^{-1}(B)\). Ainsi, \(f(f^{-1}(B)) = B \cap \operatorname{Im} f\).
- Le noyau vérifie \(x = -y\) et \(z = -y\). Donc \(\ker f = \mathrm{Vect}\big((1, -1, 1)\big)\). Ensuite, \(f(e_1) = (1, 0)\), d’où \(f(A) = \mathrm{Vect}\big((1, 0)\big)\). D’après la question 2, \(f^{-1}(f(A)) = \mathrm{Vect}\big((1, 0, 0), (1, -1, 1)\big)\). On retrouve ce résultat directement : \(f(x, y, z) \in \mathrm{Vect}\big((1, 0)\big)\) équivaut à \(y + z = 0\). Enfin, \(f(x, y, z) \in \mathrm{Vect}\big((1, 1)\big)\) équivaut à \(x + y = y + z\), soit \(x = z\). Donc \(f^{-1}(f(A))\) est le plan \(y + z = 0\), et \(f^{-1}(B)\) est le plan \(x = z\).
Corrigé de l’exercice 10 : Noyaux et images sur les matrices carrées
- La transposition est linéaire, donc \(\varphi\) l’est aussi. Ensuite, \(\varphi(M) = 0\) équivaut à \(M^{T} = M\). Donc \(\ker \varphi = \mathcal{S}_2(\mathbb{R})\), de dimension 3. Le théorème du rang donne \(\operatorname{rg} \varphi = 4 – 3 = 1\). Par ailleurs, \((M – M^{T})^{T} = M^{T} – M = -(M – M^{T})\). Donc \(\operatorname{Im} \varphi\) est contenue dans l’espace \(\mathcal{A}_2(\mathbb{R})\) des matrices antisymétriques. Cet espace est la droite engendrée par \(\begin{pmatrix} 0 1 \\ -1 0 \end{pmatrix}\). Par égalité des dimensions, \(\operatorname{Im} \varphi = \mathcal{A}_2(\mathbb{R})\).
- Soit \(M = \begin{pmatrix} a b \\ c d \end{pmatrix}\). Alors \(AM = \begin{pmatrix} a + c b + d \\ a + c b + d \end{pmatrix}\). Ce produit est nul si et seulement si \(c = -a\) et \(d = -b\). Donc \(\ker \psi = \{\begin{pmatrix} a b \\ -a -b \end{pmatrix}\}\), de dimension 2. Ensuite, \(\operatorname{Im} \psi\) est contenue dans l’ensemble des matrices à deux lignes égales, de dimension 2. Le rang vaut \(4 – 2 = 2\). Donc \(\operatorname{Im} \psi = \{\begin{pmatrix} \alpha \beta \\ \alpha \beta \end{pmatrix}\}\), de dimension 2.
- On calcule \(A^2 = \begin{pmatrix} 2 2 \\ 2 2 \end{pmatrix} = 2A\). Par conséquent, \(\psi^2(M) = A^2 M = 2AM\), soit \(\psi^2 = 2\psi\). Posons \(\pi = \frac{1}{2}\psi\). Alors \(\pi^2 = \frac{1}{4}\psi^2 = \frac{1}{2}\psi = \pi\). Donc \(\pi\) est la projection sur \(\operatorname{Im} \psi\) parallèlement à \(\ker \psi\).
Corrigé de l’exercice 11 : Dérivation et multiplication par X
- Tout polynôme \(Q = \sum a_k X^k\) admet pour antécédent \(\sum \frac{a_k}{k + 1} X^{k+1}\). Donc \(D\) est surjective. En revanche, \(D(1) = 0\) avec \(1 \neq 0\). Ainsi, \(D\) est surjective et non injective.
- Si \(XP = 0\), alors \(P = 0\), car \(\deg(XP) = \deg P + 1\) dès que \(P \neq 0\). De plus, tout polynôme \(XP\) s’annule en \(0\), donc \(1\) n’a pas d’antécédent. Ainsi, \(T\) est injective et non surjective.
- Pour tout \(P\), on a \(D(T(P)) = (XP)^{\prime} = P + XP^{\prime}\) et \(T(D(P)) = XP^{\prime}\). La différence vaut \(P\). Donc \(D \circ T – T \circ D = \mathrm{id}_E\), et \(\mathcal{L}(E)\) n’est pas commutatif puisque \(D \circ T \neq T \circ D\).
- On a \(D \circ T(X^k) = (k + 1) X^k\). Soit \(S\) l’endomorphisme défini sur la base canonique par \(S(X^k) = \frac{X^k}{k + 1}\). Alors \(S \circ (D \circ T)\) et \((D \circ T) \circ S\) valent l’identité sur chaque \(X^k\), donc partout. Ainsi, \(D \circ T\) est un automorphisme, d’inverse \(X^k \mapsto \dfrac{X^k}{k + 1}\).
- On a \(T \circ D(X^k) = k X^k\). Pour \(P = \sum a_k X^k\), on obtient \(T \circ D(P) = \sum k a_k X^k\). Il est nul si et seulement si \(a_k = 0\) pour tout \(k \geq\, 1\). Donc \(\ker(T \circ D) = \mathbb{R}_0[X]\) et \(\operatorname{Im}(T \circ D) = \{P \mid P(0) = 0\}\). Aucune contradiction : l’équivalence entre injectivité et surjectivité exige la dimension finie, et \(\mathbb{R}[X]\) est de dimension infinie. Les questions 1 et 2 en donnent des contre-exemples.
Corrigé de l’exercice 12 : Injectivité et bijectivité sur les polynômes
- Si \(\deg P \leq\, n\), alors \(\deg P(X + 1) \leq\, n\), donc \(\varphi(P) \in \mathbb{R}_n[X]\). De plus, \((\lambda P + Q)(X + 1) = \lambda P(X + 1) + Q(X + 1)\). Donc \(\varphi\) est un endomorphisme de \(\mathbb{R}_n[X]\).
- Soit \(P \neq 0\), de degré \(d\) et de coefficient dominant \(a_d\). Le polynôme \(P(X + 1)\) a le même terme dominant \(a_d X^d\). Par conséquent, \(\varphi(P)\) a pour terme dominant \(2a_d X^d\), qui est non nul. Donc \(\ker \varphi = \{0\}\). Comme \(\mathbb{R}_n[X]\) est de dimension finie, l’endomorphisme injectif \(\varphi\) est bijectif.
- On cherche \(P = aX^2 + bX + c\). On a \(P(X + 1) = aX^2 + (2a + b)X + (a + b + c)\). Donc \(\varphi(P) = 2aX^2 + (2a + 2b)X + (a + b + 2c)\). L’égalité avec \(X^2\) donne \(a = \frac{1}{2}\), puis \(b = -\frac{1}{2}\) et \(c = 0\). L’unique solution est \(P = \dfrac{X^2 – X}{2} = \dfrac{X(X – 1)}{2}\).
- Pour tout entier \(k\), on a \(k^2 = P(k) + P(k + 1)\). Donc
\[\sum_{k=0}^{n} (-1)^k k^2 = \sum_{k=0}^{n} (-1)^k P(k) – \sum_{j=1}^{n+1} (-1)^j P(j) = P(0) + (-1)^n P(n + 1).\]
Or \(P(0) = 0\) et \(P(n + 1) = \frac{n(n + 1)}{2}\). Ainsi, \(\displaystyle\sum_{k=0}^{n} (-1)^k k^2 = (-1)^n \frac{n(n + 1)}{2}\). Par exemple, pour \(n = 3\), on trouve \(0 – 1 + 4 – 9 = -6\).
Corrigé de l’exercice 13 : Interpolation de Lagrange par un isomorphisme
- L’évaluation en un point est linéaire, donc \(\varphi\) est linéaire. Soit \(P \in \ker \varphi\). Alors \(P\) admet les \(n + 1\) racines distinctes \(a_0, \ldots, a_n\), alors que \(\deg P \leq\, n\). Donc \(P = 0\), et \(\varphi\) est injective. De plus, \(\dim \mathbb{R}_n[X] = n + 1 = \dim \mathbb{R}^{n+1}\). Par conséquent, \(\varphi\) est un isomorphisme.
- La surjectivité de \(\varphi\) donne l’existence d’un antécédent de \((b_0, \ldots, b_n)\). Son injectivité donne l’unicité. Il existe donc un unique \(P \in \mathbb{R}_n[X]\) tel que \(P(a_i) = b_i\) pour tout \(i\).
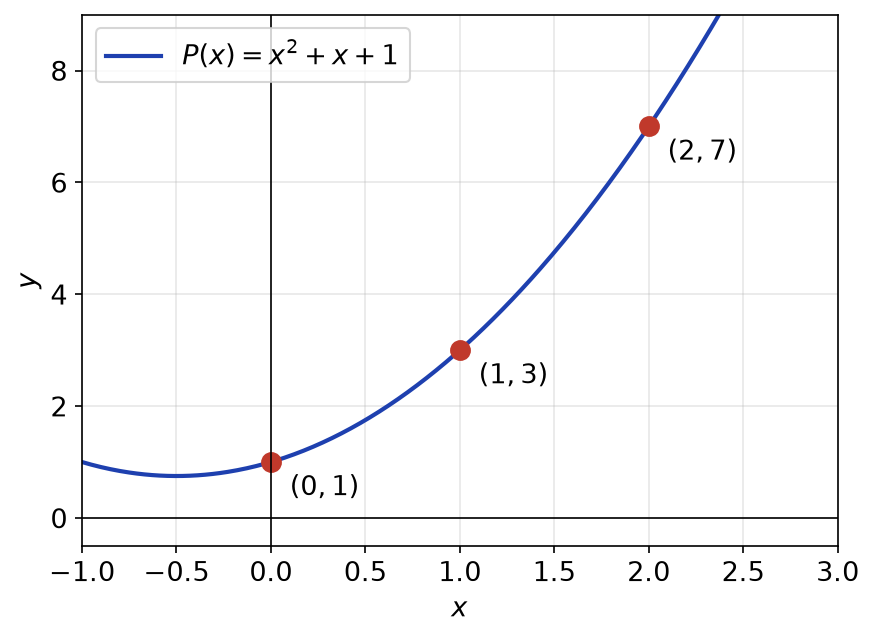
- On cherche \(P = aX^2 + bX + c\). La condition \(P(0) = 1\) donne \(c = 1\). Ensuite, \(P(1) = 3\) donne \(a + b = 2\), et \(P(2) = 7\) donne \(4a + 2b = 6\), soit \(2a + b = 3\). Par soustraction, \(a = 1\), puis \(b = 1\). Le polynôme cherché est \(P = X^2 + X + 1\).
- L’application \(P \mapsto P(a_0)\) est une forme linéaire non nulle, car elle envoie \(1\) sur \(1\). Son rang vaut donc \(1\). Par le théorème du rang, son noyau est de dimension \((n + 1) – 1 = n\).
Comme le montre la figure ci-dessous, la parabole obtenue passe bien par les trois points imposés.
Corrigé de l’exercice 14 : Supplémentaire du noyau et forme géométrique du rang
- Le noyau vérifie \(x = y\) et \(x + y + z = 0\), donc \(z = -2x\). Ainsi, \(\ker g = \mathrm{Vect}\big((1, 1, -2)\big)\). Le théorème du rang donne \(\operatorname{rg} g = 3 – 1 = 2 = \dim \mathbb{R}^2\). Donc \(g\) est surjective, de rang 2.
- Le vecteur \((1, 1, -2)\) a une troisième coordonnée non nulle, donc il n’est pas dans \(S\). Ainsi \(S \cap \ker g = \{0\}\). De plus, \(\dim S + \dim \ker g = 3\). Par conséquent, \(\mathbb{R}^3 = S \oplus \ker g\).
- La restriction s’écrit \((x, y, 0) \mapsto (x + y, x – y)\). On résout \(x + y = a\) et \(x – y = b\) : \(x = \frac{a + b}{2}\) et \(y = \frac{a – b}{2}\). La solution existe et est unique. Donc \(g_{|S}\) est un isomorphisme, d’inverse \((a, b) \mapsto (\dfrac{a + b}{2}, \dfrac{a – b}{2}, 0)\).
- Le vecteur \((1, 1, -2)\) a une deuxième coordonnée non nulle, donc il n’est pas dans \(S^{\prime}\). Comme à la question 2, \(S^{\prime}\) est un supplémentaire de \(\ker g\). La restriction s’écrit \((x, 0, z) \mapsto (x + z, x)\). On résout \(x = b\) et \(z = a – b\). Donc \(g_{|S^{\prime}}\) est un isomorphisme, d’inverse \((a, b) \mapsto (b, 0, a – b)\). À retenir : le supplémentaire du noyau n’est pas unique, mais tous sont isomorphes à l’image. C’est la forme géométrique du théorème du rang.
Corrigé de l’exercice 15 : Endomorphisme de carré nul
- Soit \(y = f(x) \in \operatorname{Im} f\). Alors \(f(y) = f^2(x) = 0\). Donc \(\operatorname{Im} f \subset \ker f\).
- D’après la question 1, \(\operatorname{rg} f \leq\, \dim \ker f\). Le théorème du rang donne \(\operatorname{rg} f + \dim \ker f = 3\). Donc \(2 \operatorname{rg} f \leq\, 3\), soit \(\operatorname{rg} f \leq\, 1\). Comme \(f \neq 0\), on a \(\operatorname{rg} f \geq\, 1\). Ainsi, \(\operatorname{rg} f = 1\) et \(\dim \ker f = 2\).
- Pour \(f(x, y, z) = (z, 0, 0)\), on a \(f(f(x, y, z)) = f(z, 0, 0) = (0, 0, 0)\). Le noyau est le plan \(z = 0\), et l’image est la droite \(\mathrm{Vect}(e_1)\). On a bien \(\operatorname{rg} f = 1\), \(\dim \ker f = 2\) et \(\operatorname{Im} f \subset \ker f\).
- Comme \(u \notin \ker f\), on a \(f(u) \neq 0\). De plus, \(f(u) \in \operatorname{Im} f \subset \ker f\). On complète la famille libre \((f(u))\) en une base \((f(u), v)\) de \(\ker f\), qui est de dimension 2. Montrons que \((u, f(u), v)\) est libre. Supposons \(a u + b f(u) + c v = 0\). En appliquant \(f\), on obtient \(a f(u) = 0\), car \(f^2(u) = 0\) et \(f(v) = 0\). Donc \(a = 0\). Il reste \(b f(u) + c v = 0\), d’où \(b = c = 0\). La famille libre \((u, f(u), v)\) a 3 vecteurs : c’est une base de \(\mathbb{R}^3\).
Corrigé de l’exercice 16 : Anneau L(E) et polynôme annulateur
- Posons \(p_1(x, y) = (x, 0)\), \(p_2(x, y) = (0, y)\) et \(\sigma(x, y) = (y, x)\). D’une part, \(p_1 \circ \sigma(x, y) = (y, 0)\). D’autre part, \(\sigma \circ p_1(x, y) = (0, x)\). Ces applications diffèrent. Donc \(p_1\) et \(\sigma\) ne commutent pas, et \(p_1 \circ p_2 = 0\) avec \(p_1 \neq 0\) et \(p_2 \neq 0\).
- On a \(f^2 – 3f = -2\,\mathrm{id}_E\), donc \(f \circ (3\,\mathrm{id}_E – f) = 2\,\mathrm{id}_E\). Les deux facteurs commutent, car ce sont des polynômes en \(f\). Ainsi, \(f \circ \frac{1}{2}(3\,\mathrm{id}_E – f) = \frac{1}{2}(3\,\mathrm{id}_E – f) \circ f = \mathrm{id}_E\). Donc \(f \in \mathrm{GL}(E)\) et \(f^{-1} = \dfrac{3}{2}\mathrm{id}_E – \dfrac{1}{2} f\).
- On calcule \((f – \mathrm{id}_E)^2 = f^2 – 2f + \mathrm{id}_E\). Or \(f^2 = 3f – 2\,\mathrm{id}_E\). Donc \((f – \mathrm{id}_E)^2 = f – \mathrm{id}_E\). Ainsi, \(f – \mathrm{id}_E\) est un projecteur.
- Posons \(p = f – \mathrm{id}_E\). C’est un projecteur, donc \(E = \ker p \oplus \operatorname{Im} p\), avec \(\ker p = \ker(f – \mathrm{id}_E)\). De plus, \(\operatorname{Im} p = \ker(p – \mathrm{id}_E) = \ker(f – 2\,\mathrm{id}_E)\). Donc \(E = \ker(f – \mathrm{id}_E) \oplus \ker(f – 2\,\mathrm{id}_E)\). Concrètement, tout \(x\) s’écrit \(x = (2x – f(x)) + (f(x) – x)\).
- On a \(f^2(x, y) = f(x, x + 2y) = (x, 3x + 4y)\). Par ailleurs, \(3f(x, y) – 2(x, y) = (x, 3x + 4y)\). L’hypothèse est donc vérifiée. Ensuite, \(f(x, y) = (x, y)\) équivaut à \(x + y = 0\), et \(f(x, y) = 2(x, y)\) équivaut à \(x = 0\). Donc \(\ker(f – \mathrm{id}) = \mathrm{Vect}\big((1, -1)\big)\) et \(\ker(f – 2\,\mathrm{id}) = \mathrm{Vect}\big((0, 1)\big)\).
Corrigé de l’exercice 17 : Rang d’une composée
- D’une part, \(\operatorname{Im}(g \circ f) = g(\operatorname{Im} f) \subset \operatorname{Im} g\), donc \(\operatorname{rg}(g \circ f) \leq\, \operatorname{rg} g\). D’autre part, \(g(\operatorname{Im} f)\) est l’image de l’espace \(\operatorname{Im} f\) par une application linéaire. Sa dimension est donc au plus \(\dim \operatorname{Im} f\). Ainsi, \(\operatorname{rg}(g \circ f) \leq\, \min(\operatorname{rg} f, \operatorname{rg} g)\).
- Si \(g\) est injective, sa restriction à \(\operatorname{Im} f\) est injective. Elle réalise donc un isomorphisme de \(\operatorname{Im} f\) sur \(g(\operatorname{Im} f)\), d’où \(\operatorname{rg}(g \circ f) = \operatorname{rg} f\). Si \(f\) est surjective, alors \(\operatorname{Im}(g \circ f) = g(F) = \operatorname{Im} g\). Le rang est donc invariant par composition avec une injection à gauche ou une surjection à droite, en particulier avec un isomorphisme.
- Notons \(g^{\prime}\) la restriction de \(g\) à \(\operatorname{Im} f\). Son image est \(\operatorname{Im}(g \circ f)\), et son noyau est \(\ker g \cap \operatorname{Im} f\). Le théorème du rang donne \(\operatorname{rg} f = \dim(\ker g \cap \operatorname{Im} f) + \operatorname{rg}(g \circ f)\). Or \(\dim(\ker g \cap \operatorname{Im} f) \leq\, \dim \ker g = \dim F – \operatorname{rg} g\). Donc \(\operatorname{rg}(g \circ f) \geq\, \operatorname{rg} f + \operatorname{rg} g – \dim F\).
- On applique la question 3 avec \(f = g = h\) et \(F = E\). On obtient \(0 = \operatorname{rg}(h \circ h) \geq\, 2 \operatorname{rg} h – n\). Donc \(\operatorname{rg} h \leq\, \dfrac{n}{2}\). On retrouve le résultat de l’exercice 15 pour \(n = 3\).
Corrigé de l’exercice 18 : Noyau et image de f et de f au carré
- Si \(f(x) = 0\), alors \(f^2(x) = f(0) = 0\). Ensuite, \(f^2(x) = f(f(x)) \in \operatorname{Im} f\). Donc \(\ker f \subset \ker f^2\) et \(\operatorname{Im} f^2 \subset \operatorname{Im} f\).
- Le théorème du rang donne \(\dim \ker f + \operatorname{rg} f = n = \dim \ker f^2 + \operatorname{rg} f^2\). Avec les inclusions de la question 1, \(\ker f = \ker f^2\) équivaut à \(\dim \ker f = \dim \ker f^2\). Cela équivaut à \(\operatorname{rg} f = \operatorname{rg} f^2\), puis à \(\operatorname{Im} f = \operatorname{Im} f^2\). Les deux égalités sont donc équivalentes.
- Supposons \(\ker f = \ker f^2\). Soit \(x \in \ker f \cap \operatorname{Im} f\), avec \(x = f(y)\). Alors \(f^2(y) = f(x) = 0\), donc \(y \in \ker f^2 = \ker f\), et \(x = f(y) = 0\). Réciproquement, supposons \(\ker f \cap \operatorname{Im} f = \{0\}\). Soit \(x \in \ker f^2\). Alors \(f(x) \in \operatorname{Im} f\) et \(f(f(x)) = 0\), donc \(f(x) \in \ker f \cap \operatorname{Im} f\). Ainsi \(f(x) = 0\). Donc \(\ker f = \ker f^2\) si et seulement si \(\ker f \cap \operatorname{Im} f = \{0\}\).
- Par le théorème du rang, \(\dim \ker f + \dim \operatorname{Im} f = n\). Dans ce cas, une somme directe est égale à \(E\) dès que l’intersection est nulle. Donc les conditions précédentes équivalent à \(E = \ker f \oplus \operatorname{Im} f\).
- Pour \(\varphi\) de l’exercice 3, on a vu que \(\ker \varphi = \mathrm{Vect}(X)\) et \(\operatorname{Im} \varphi = \mathrm{Vect}(1, X^2)\) sont supplémentaires. De plus, \(\varphi^2(a + bX + cX^2) = a + cX^2\), donc \(\ker \varphi^2 = \mathrm{Vect}(X) = \ker \varphi\). En revanche, pour la dérivation \(D\) sur \(\mathbb{R}_1[X]\), on a \(\ker D = \operatorname{Im} D = \mathbb{R}_0[X]\), et \(D^2 = 0\). Dans ce second cas, \(\ker D \neq \ker D^2 = \mathbb{R}_1[X]\), et la somme n’est pas directe.
Corrigé de l’exercice 19 : Somme de deux projecteurs
- Développons, en prenant garde à l’ordre des facteurs : \((p + q)^2 = p^2 + p \circ q + q \circ p + q^2 = p + 0 + 0 + q\). Donc \(p + q\) est un projecteur.
- Si \((p + q)^2 = p + q\), le même développement donne \(p \circ q + q \circ p = 0\). En composant à gauche par \(p\), on obtient \(p \circ q + p \circ q \circ p = 0\). En composant à droite par \(p\), on obtient \(p \circ q \circ p + q \circ p = 0\). Par soustraction, \(p \circ q = q \circ p\). Enfin, la relation de départ devient \(2\, p \circ q = 0\). Donc \(p \circ q = q \circ p = 0\).
- D’abord, \(\operatorname{Im}(p + q) \subset \operatorname{Im} p + \operatorname{Im} q\). Réciproquement, soit \(y = p(a) + q(b)\). Alors \((p + q)(y) = p(a) + p(q(b)) + q(p(a)) + q(b) = y\). Donc \(y \in \operatorname{Im}(p + q)\). La somme est directe : si \(x \in \operatorname{Im} p \cap \operatorname{Im} q\), alors \(x = p(x) = p(q(x)) = 0\). Ensuite, \(\ker p \cap \ker q \subset \ker(p + q)\) est clair. Si \((p + q)(x) = 0\), on applique \(p\) : \(p(x) + p(q(x)) = p(x) = 0\). De même, \(q(x) = 0\). Donc \(\operatorname{Im}(p + q) = \operatorname{Im} p \oplus \operatorname{Im} q\) et \(\ker(p + q) = \ker p \cap \ker q\).
Point de méthode : dans \(\mathcal{L}(E)\), on ne simplifie jamais \(p \circ q + q \circ p\) en \(2\, p \circ q\) sans avoir prouvé la commutation.
Corrigé de l’exercice 20 : Commutation avec un projecteur
- Supposons \(f \circ p = p \circ f\). Si \(x \in \operatorname{Im} p\), alors \(p(f(x)) = f(p(x)) = f(x)\), donc \(f(x) \in \operatorname{Im} p\). Si \(x \in \ker p\), alors \(p(f(x)) = f(p(x)) = 0\), donc \(f(x) \in \ker p\). Réciproquement, supposons les deux sous-espaces stables. Écrivons \(x = a + b\), avec \(a \in \operatorname{Im} p\) et \(b \in \ker p\). Alors \(f(p(x)) = f(a)\). De plus, \(p(f(x)) = p(f(a)) + p(f(b)) = f(a) + 0\). Donc \(f \circ p = p \circ f\) si et seulement si \(\operatorname{Im} p\) et \(\ker p\) sont stables par \(f\).
- Ici, \(\operatorname{Im} p = \mathrm{Vect}\big((2, 1)\big)\) et \(\ker p = \mathrm{Vect}\big((1, 1)\big)\). Une droite est stable par \(f\) si et seulement si l’image de son vecteur directeur lui est colinéaire. Donc \(f\) commute avec \(p\) si et seulement si \(f(2, 1) = \alpha(2, 1)\) et \(f(1, 1) = \beta(1, 1)\). Or \((x, y) = (x – y)(2, 1) + (-x + 2y)(1, 1)\). Donc \(f(x, y) = \big((2\alpha – \beta)x + (2\beta – 2\alpha)y,\ (\alpha – \beta)x + (2\beta – \alpha)y\big)\), avec \(\alpha, \beta \in \mathbb{R}\).
- La question précédente montre que \(f = \alpha p + \beta(\mathrm{id} – p)\). En effet, \(p(x, y) = (x – y)(2, 1)\) et \((\mathrm{id} – p)(x, y) = (-x + 2y)(1, 1)\). L’ensemble cherché est donc \(\mathrm{Vect}(p, \mathrm{id} – p)\). Ces deux projecteurs sont non nuls et d’images distinctes, donc non colinéaires. C’est un sous-espace de \(\mathcal{L}(\mathbb{R}^2)\) de dimension 2.
Corrigé de l’exercice 21 : Applications linéaires nulles sur un sous-espace
- L’application nulle appartient à \(W\). Si \(f, g \in W\) et \(\lambda \in \mathbb{R}\), alors pour tout \(a \in A\), \((\lambda f + g)(a) = 0\). Donc \(W\) est un sous-espace vectoriel de \(\mathcal{L}(E, F)\).
- La restriction est linéaire. Elle est injective : si \(f \in W\) et \(f_{|B} = 0\), alors \(f\) est nulle sur \(A\) et sur \(B\), donc sur \(A + B = E\). Elle est surjective : soit \(g \in \mathcal{L}(B, F)\). On pose \(f(a + b) = g(b)\) pour \(a \in A\) et \(b \in B\). Cette définition a un sens car la décomposition est unique. De plus, \(f\) est linéaire, nulle sur \(A\), et \(f_{|B} = g\). Donc \(\rho\) est un isomorphisme.
- On a \(\dim B = n – k\). Par conséquent, \(\dim W = \dim \mathcal{L}(B, F) = (n – k)m\).
- Ici, \(n = 3\), \(k = 1\) et \(m = 2\), donc la dimension vaut \(2 \times 2 = 4\). On prend \(B = \mathrm{Vect}(e_1, e_2)\) : \(f\) est déterminée par \(f(e_1)\) et \(f(e_2)\), puis \(f(e_3) = -f(e_1) – f(e_2)\). Une base est formée des applications \((x – z, 0)\), \((y – z, 0)\), \((0, x – z)\) et \((0, y – z)\).
Corrigé de l’exercice 22 : Problème : l’opérateur de différence et la somme des carrés
- La linéarité vient de \((\lambda P + Q)(X + 1) = \lambda P(X + 1) + Q(X + 1)\). De plus, \(\deg \Delta(P) \leq\, 3\) si \(\deg P \leq\, 3\). On calcule ensuite : \(\Delta(1) = 0\), \(\Delta(X) = 1\), \(\Delta(X^2) = 2X + 1\). Enfin, \(\Delta(X^3) = (X + 1)^3 – X^3 = 3X^2 + 3X + 1\).
- Soit \(P = a_d X^d + \cdots\), avec \(a_d \neq 0\) et \(d \geq\, 1\). Par la formule du binôme, \((X + 1)^d – X^d = d X^{d-1} + \cdots\). Les termes de degré inférieur de \(P\) donnent des différences de degré au plus \(d – 2\). Donc \(\Delta(P)\) a pour terme dominant \(d\, a_d X^{d-1}\), et \(\deg \Delta(P) = d – 1\).
- Les constantes sont dans le noyau. Réciproquement, si \(\deg P \geq\, 1\), la question 2 montre que \(\Delta(P) \neq 0\). Donc \(\ker \Delta = \mathbb{R}_0[X]\).
- Le théorème du rang donne \(\operatorname{rg} \Delta = 4 – 1 = 3\). De plus, la question 2 montre que \(\operatorname{Im} \Delta \subset \mathbb{R}_2[X]\), espace de dimension 3. Par égalité des dimensions, \(\operatorname{Im} \Delta = \mathbb{R}_2[X]\).
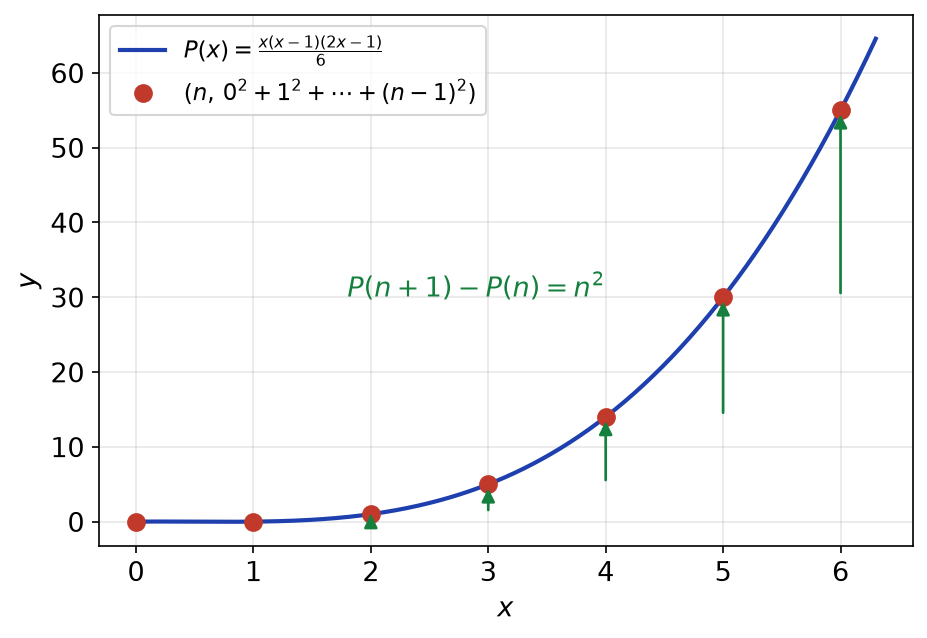
- Comme \(X^2 \in \operatorname{Im} \Delta\), il existe \(P_0\) tel que \(\Delta(P_0) = X^2\). Le polynôme \(P = P_0 – P_0(0)\) convient, car \(\Delta\) annule les constantes. Pour l’unicité, deux solutions diffèrent d’un élément de \(\ker \Delta\), donc d’une constante, nulle car les deux s’annulent en \(0\). Cherchons \(P = aX^3 + bX^2 + cX\). D’après la question 1, \(\Delta(P) = 3aX^2 + (3a + 2b)X + (a + b + c)\). On obtient \(a = \frac{1}{3}\), puis \(b = -\frac{1}{2}\), puis \(c = \frac{1}{6}\). Donc \(P = \dfrac{2X^3 – 3X^2 + X}{6} = \dfrac{X(X – 1)(2X – 1)}{6}\).
- Pour tout entier \(k\), on a \(P(k + 1) – P(k) = k^2\). Par télescopage, \(\sum_{k=0}^{n} k^2 = P(n + 1) – P(0) = P(n + 1)\). Donc \(\displaystyle\sum_{k=1}^{n} k^2 = \frac{n(n + 1)(2n + 1)}{6}\).
- On a \(\Delta^2(X^3) = \Delta(3X^2 + 3X + 1) = 3(2X + 1) + 3 = 6X + 6\), puis \(\Delta^3(X^3) = 6\). Donc \(\Delta^3 \neq 0\). Ensuite, chaque application de \(\Delta\) fait baisser le degré d’une unité, ou donne \(0\). Par conséquent, \(\Delta^4(P) = 0\) pour tout \(P \in \mathbb{R}_3[X]\). Enfin, \(\operatorname{Im} \Delta^2 = \Delta(\operatorname{Im} \Delta) = \Delta(\mathbb{R}_2[X]) = \mathbb{R}_1[X]\), d’après la question 2 appliquée à \(1\), \(X\) et \(X^2\). Ainsi, \(\Delta^4 = 0\), \(\Delta^3 \neq 0\) et \(\operatorname{rg} \Delta^2 = 2\).
La figure ci-dessous illustre la question 6. Les points \(\big(n, 0^2 + \cdots + (n – 1)^2\big)\) sont sur la courbe de \(P\), et chaque saut vertical vaut un carré.
Revenir aux énoncés des exercices
Pour aller plus loin en maths sup
- Le cours : applications linéaires, cours de maths sup
- Les énoncés : exercices de maths sup sur applications linéaires
- À maîtriser avant : Espaces vectoriels de dimension finie
- Chapitre précédent : Espaces vectoriels de dimension finie
- Chapitre suivant : Formes linéaires, hyperplans et sous-espaces affines
- Le même thème en L1 : applications linéaires, exercices de maths en L1
- Tester vos connaissances : QCM de maths sup par chapitre
- Le sommaire : tous les chapitres de maths sup et les chapitres de maths spé