Ce corrigé espérance spé suit toujours le même ordre : d’abord justifier l’existence de l’espérance ou du moment d’ordre 2, ensuite calculer. Les théorèmes sont cités par leur nom : formule de transfert, théorème de Fubini pour les familles positives, Cauchy-Schwarz, Bienaymé-Tchebychev.
Plusieurs points de vigilance reviennent. La formule \(E(XY) = E(X)E(Y)\) exige l’indépendance, contrairement à la linéarité. Une covariance nulle ne prouve pas l’indépendance. De même, pour une variable de comptage, écrivez-la toujours en somme d’indicatrices avant de calculer sa variance. Enfin, dans les inégalités de concentration, vérifiez l’inclusion d’événements qui permet d’appliquer l’inégalité, souvent la seule étape délicate. Les figures illustrent les résultats obtenus : lois, bornes comparées, approximations et simulations.
Les énoncés se trouvent sur la page exercices de maths spé sur espérance et variance.
Corrigé de l’exercice 1 : Loi géométrique par la formule des queues
- L’événement \((X \geq\, n)\) signifie que les \(n – 1\) premières épreuves sont des échecs. Par le calcul direct :
\[P(X \geq\, n) = \sum_{k=n}^{+\infty} p q^{k-1} = p q^{n-1} \cdot \frac{1}{1 – q} = q^{n-1}.\]
Ainsi, \(P(X \geq\, n) = q^{n-1}\) pour tout \(n \geq\, 1\). - La variable \(X\) est à valeurs dans \(\mathbb{N}^*\). La formule des queues donne donc, dans \([0, +\infty]\) :
\[E(X) = \sum_{n=1}^{+\infty} q^{n-1} = \frac{1}{1 – q}.\]
Par conséquent, \(E(X) = \dfrac{1}{p}\). - La famille \((k(k-1) p q^{k-1})_{k \geq\, 1}\) est positive. D’après le cours sur les séries entières, pour \(|x| < 1\), on a \(\sum_{k \geq\, 2} k(k-1) x^{k-2} = \frac{2}{(1-x)^3}\) (dérivée seconde de \(\frac{1}{1-x}\)). Avec \(x = q\), la série converge. Par la formule de transfert :
\[E(X(X-1)) = pq \sum_{k=2}^{+\infty} k(k-1) q^{k-2} = pq \cdot \frac{2}{p^3} = \frac{2q}{p^2}.\]
Donc \(E(X(X-1)) = \dfrac{2q}{p^2}\). - D’abord, \(X^2 = X(X-1) + X\) est d’espérance finie. Ensuite, par König-Huygens :
\[V(X) = E(X(X-1)) + E(X) – E(X)^2 = \frac{2q}{p^2} + \frac{p}{p^2} – \frac{1}{p^2} = \frac{2q + p – 1}{p^2} = \frac{q}{p^2}.\]
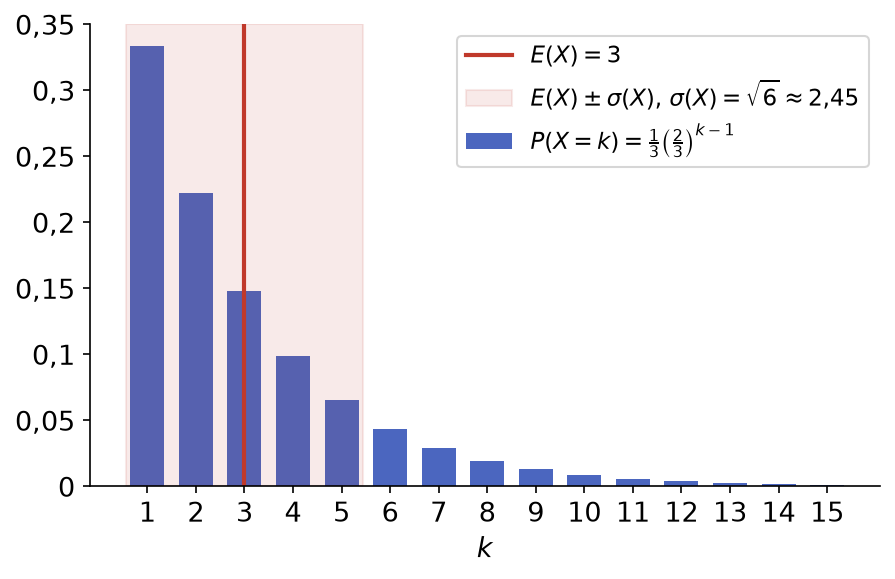
Ainsi \(V(X) = \dfrac{q}{p^2}\). Pour \(p = \frac{1}{3}\) : \(E(X) = 3\), \(V(X) = 6\) et \(\sigma(X) = \sqrt{6} \approx 2{,}45\). La figure ci-dessous représente cette loi avec sa moyenne et la bande \(E(X) \pm \sigma(X)\).
Point de méthode : pour une loi à valeurs entières, les probabilités de queue fournissent souvent l’espérance sans aucune dérivation de série.
Corrigé de l’exercice 2 : Loi de Poisson et formule de transfert
- On a \(0 < \frac{1}{1+X} \leq\, 1\). La variable est bornée, donc d’espérance finie. Par transfert :
\[E(\frac{1}{1+X}) = \sum_{k=0}^{+\infty} \frac{1}{k+1} e^{-\lambda} \frac{\lambda^k}{k!} = \frac{e^{-\lambda}}{\lambda} \sum_{k=0}^{+\infty} \frac{\lambda^{k+1}}{(k+1)!} = \frac{e^{-\lambda}}{\lambda}(e^{\lambda} – 1).\]
Donc \(E(\frac{1}{1+X}) = \dfrac{1 – e^{-\lambda}}{\lambda}\). - D’après la formule de transfert, \(t^X\) est d’espérance finie si et seulement si \(\sum |t|^k e^{-\lambda} \frac{\lambda^k}{k!}\) converge. Or cette série exponentielle converge pour tout réel \(t\). Ensuite :
\[E(t^X) = e^{-\lambda} \sum_{k=0}^{+\infty} \frac{(\lambda t)^k}{k!} = e^{-\lambda} e^{\lambda t}.\]
Ainsi \(E(t^X) = e^{\lambda(t – 1)}\) pour tout \(t \in \mathbb{R}\). - Les termes d’indice 0, 1 et 2 sont nuls. Par transfert, la série étant à termes positifs :
\[E(X(X-1)(X-2)) = \sum_{k=3}^{+\infty} e^{-\lambda} \frac{\lambda^k}{(k-3)!} = \lambda^3 e^{-\lambda} \sum_{j=0}^{+\infty} \frac{\lambda^j}{j!} = \lambda^3.\]
De plus, \(X^3 = X(X-1)(X-2) + 3X^2 – 2X\), en développant. Enfin, \(E(X^2) = V(X) + E(X)^2 = \lambda + \lambda^2\). Par linéarité :
\[E(X^3) = \lambda^3 + 3(\lambda + \lambda^2) – 2\lambda.\]
Donc \(E(X^3) = \lambda^3 + 3\lambda^2 + \lambda\).
Corrigé de l’exercice 3 : Loi uniforme sur un ensemble d’entiers
- La variable ne prend qu’un nombre fini de valeurs : tous ses moments existent. Par transfert :
\[E(X) = \frac{1}{n} \sum_{k=1}^{n} k = \frac{n+1}{2}, \qquad E(X^2) = \frac{1}{n} \sum_{k=1}^{n} k^2 = \frac{(n+1)(2n+1)}{6}.\]
Ensuite, par König-Huygens :
\[V(X) = \frac{(n+1)(2n+1)}{6} – \frac{(n+1)^2}{4} = \frac{(n+1)\big(2(2n+1) – 3(n+1)\big)}{12} = \frac{(n+1)(n-1)}{12}.\]
Ainsi \(E(X) = \frac{n+1}{2}\) et \(V(X) = \frac{n^2 – 1}{12}\). - Par transfert, avec une somme géométrique :
\[E(2^X) = \frac{1}{n} \sum_{k=1}^{n} 2^k = \frac{2^{n+1} – 2}{n}.\]
De même, \(E(1/X) = \frac{1}{n} \sum_{k=1}^{n} \frac{1}{k}\). Donc \(E(2^X) = \frac{2^{n+1} – 2}{n}\) et \(E(\frac{1}{X}) = \frac{H_n}{n}\). - Pour \(1 \leq\, k \leq\, n\), l’événement \((X \geq\, k)\) contient \(n – k + 1\) valeurs. Donc \(P(X \geq\, k) = \frac{n – k + 1}{n}\), et cette probabilité est nulle pour \(k > n\). Par conséquent :
\[E(X) = \sum_{k=1}^{n} \frac{n – k + 1}{n} = \frac{1}{n} \sum_{j=1}^{n} j = \frac{n+1}{2}.\]
On retrouve bien \(E(X) = \frac{n+1}{2}\).
Corrigé de l’exercice 4 : Une variable d’espérance infinie
- Les nombres \(\frac{1}{n(n+1)}\) sont positifs. De plus, \(\frac{1}{n(n+1)} = \frac{1}{n} – \frac{1}{n+1}\). La somme télescopique vaut donc :
\[\sum_{n=1}^{N} \frac{1}{n(n+1)} = 1 – \frac{1}{N+1} \xrightarrow[N \to +\infty]{ 1.\]
On définit donc bien une loi de probabilité sur \(\mathbb{N}^*\). - Par le même télescopage, \(P(X \geq\, n) = \sum_{k \geq\, n} (\frac{1}{k} – \frac{1}{k+1}) = \frac{1}{n}\). Première méthode : la formule des queues donne \(E(X) = \sum_{n \geq\, 1} \frac{1}{n} = +\infty\), car la série harmonique diverge. Seconde méthode : par définition, \(E(X) = \sum_{n \geq\, 1} \frac{n}{n(n+1)} = \sum_{n \geq\, 1} \frac{1}{n+1} = +\infty\). Ainsi \(P(X \geq\, n) = \frac{1}{n}\) et \(E(X) = +\infty\) : \(X\) n’est pas d’espérance finie.
- Par transfert, \(E(\sqrt{X}) = \sum_{n \geq\, 1} \frac{\sqrt{n}}{n(n+1)}\). Or \(\frac{\sqrt{n}}{n(n+1)} \sim \frac{1}{n^{3/2}}\), terme général d’une série de Riemann convergente. Donc \(\sqrt{X}\) est d’espérance finie.
- De même, \(\frac{n^{\alpha}}{n(n+1)} \sim \frac{1}{n^{2 – \alpha}}\). La série à termes positifs converge si et seulement si \(2 – \alpha > 1\). Par conséquent, \(X^{\alpha}\) est d’espérance finie si et seulement si \(\alpha < 1\).
Corrigé de l’exercice 5 : Somme et différence de variables de Poisson
- Les variables \(X\) et \(Y\) sont indépendantes et d’espérance finie. Donc \(E(XY) = E(X) E(Y) = \lambda \mu\). Par linéarité, \(E(X + Y) = \lambda + \mu\). De plus, l’indépendance annule la covariance, donc \(V(X + Y) = V(X) + V(Y)\). Ainsi \(E(XY) = \lambda\mu\), \(E(X + Y) = \lambda + \mu\) et \(V(X + Y) = \lambda + \mu\).
- On a \(V(X – Y) = V(X) + V(-Y) + 2\mathrm{Cov}(X, -Y) = V(X) + V(Y)\), car \(V(-Y) = V(Y)\) et la covariance est nulle. Ensuite, par bilinéarité et symétrie :
\[\mathrm{Cov}(X + Y, X – Y) = V(X) – \mathrm{Cov}(X, Y) + \mathrm{Cov}(Y, X) – V(Y) = \lambda – \mu.\]
Donc \(V(X – Y) = \lambda + \mu\) et \(\mathrm{Cov}(X + Y, X – Y) = \lambda – \mu\). - Si \(\lambda = \mu\), la covariance est nulle. Cependant, l’événement \((X + Y = 0)\) équivaut à \((X = 0, Y = 0)\), donc il impose \(X – Y = 0\). Ainsi \(P(X + Y = 0, X – Y = 1) = 0\). En revanche, \(P(X + Y = 0) = e^{-2\lambda} > 0\) et \(P(X – Y = 1) \geq\, P(X = 1, Y = 0) = \lambda e^{-2\lambda} > 0\). Les variables \(X + Y\) et \(X – Y\) sont non corrélées mais pas indépendantes.
Point de méthode : pour prouver que deux variables ne sont pas indépendantes, il suffit d’exhiber deux valeurs \(a\) et \(b\) telles que \(P(U = a, V = b) = 0\) alors que \(P(U = a) P(V = b) > 0\). Une covariance nulle ne suffit jamais à conclure dans l’autre sens.
Corrigé de l’exercice 6 : Variables centrées réduites
- Soit \(a > 0\) et \(b\) réel. D’abord, \(E(aX + b) = a E(X) + b\), qui est nul si et seulement si \(b = -a E(X)\). Ensuite, \(V(aX + b) = a^2 V(X)\), qui vaut 1 si et seulement si \(a = \frac{1}{\sigma(X)}\), puisque \(a > 0\). Le couple unique est \(a = \frac{1}{\sigma(X)}\), \(b = -\frac{E(X)}{\sigma(X)}\), ce qui donne \(X^* = \frac{X – E(X)}{\sigma(X)}\).
- Pour \(X \sim \mathcal{G}(p)\), on a \(E(X) = \frac{1}{p}\) et \(\sigma(X) = \frac{\sqrt{q}}{p}\). Pour \(Y \sim \mathcal{P}(\lambda)\), on a \(E(Y) = \lambda\) et \(\sigma(Y) = \sqrt{\lambda}\). Donc \(X^* = \dfrac{pX – 1}{\sqrt{q}}\) et \(Y^* = \dfrac{Y – \lambda}{\sqrt{\lambda}}\).
- L’inégalité de Bienaymé-Tchebychev appliquée à \(Y^*\), centrée de variance 1, donne \(P(|Y^*| \geq\, 2) \leq\, \frac{1}{4}\). Or \((|Y^*| \geq\, 2) = (|Y – \lambda| \geq\, 2\sqrt{\lambda})\). Ainsi \(Y\) appartient à \(]\lambda – 2\sqrt{\lambda}, \lambda + 2\sqrt{\lambda}[\) avec une probabilité au moins \(\frac{3}{4}\).
Corrigé de l’exercice 7 : Minimum et maximum de deux dés
- L’événement \((M \geq\, n)\) équivaut à \((X_1 \geq\, n) \cap (X_2 \geq\, n)\). Par indépendance, \(P(M \geq\, n) = (\frac{7 – n}{6})^2\). La variable \(M\) est à valeurs dans \(\{1, \ldots, 6\}\). La formule des queues donne donc :
\[E(M) = \sum_{n=1}^{6} \frac{(7-n)^2}{36} = \frac{36 + 25 + 16 + 9 + 4 + 1}{36} = \frac{91}{36}.\]
Ainsi \(E(M) = \frac{91}{36} \approx 2{,}53\). - On a \((M^{\prime} \geq\, n) = \overline{(M^{\prime} \leq\, n – 1)}\), et \(P(M^{\prime} \leq\, n – 1) = (\frac{n-1}{6})^2\) par indépendance. Donc :
\[E(M^{\prime}) = \sum_{n=1}^{6} (1 – \frac{(n-1)^2}{36}) = 6 – \frac{0 + 1 + 4 + 9 + 16 + 25}{36} = 6 – \frac{55}{36} = \frac{161}{36}.\]
Ainsi \(E(M^{\prime}) = \frac{161}{36} \approx 4{,}47\). - Pour deux réels, le minimum plus le maximum vaut la somme. Par linéarité, \(E(M) + E(M^{\prime}) = E(X_1) + E(X_2) = 7\). On vérifie bien \(\frac{91}{36} + \frac{161}{36} = \frac{252}{36} = 7\).
- Avec \(k\) dés indépendants à \(N\) faces, \(P(\min \geq\, n) = (\frac{N – n + 1}{N})^k\) pour \(1 \leq\, n \leq\, N\). En posant \(j = N – n + 1\) : \(E(\min) = \dfrac{1}{N^k} \sum_{j=1}^{N} j^k\). Pour \(k = 2\) et \(N = 6\), on retrouve \(\frac{91}{36}\).
Point de méthode : pour un minimum de variables indépendantes, on calcule toujours \(P(\min \geq\, n)\), qui se factorise ; pour un maximum, on passe par \(P(\max \leq\, n)\), qui se factorise aussi. La formule des queues donne ensuite l’espérance sans connaître la loi ponctuelle.
Corrigé de l’exercice 8 : Minimum de deux variables géométriques
- Par indépendance et d’après l’exercice 1 :
\[P(Z \geq\, n) = P(X \geq\, n) P(Y \geq\, n) = \big((1-p)(1-r)\big)^{n-1}.\]
Posons \(s = 1 – (1-p)(1-r) = p + r – pr\), qui appartient à \(]0, 1[\). Alors, pour \(n \geq\, 1\), \(P(Z = n) = P(Z \geq\, n) – P(Z \geq\, n+1) = (1-s)^{n-1} s\). Donc \(Z \sim \mathcal{G}(p + r – pr)\). - D’après les résultats sur la loi géométrique : \(E(Z) = \dfrac{1}{p + r – pr}\) et \(V(Z) = \dfrac{(1-p)(1-r)}{(p + r – pr)^2}\).
- Par la formule des probabilités totales sur le système complet \((X = k)_{k \geq\, 1}\), puis par indépendance :
\[P(X = Y) = \sum_{k=1}^{+\infty} p(1-p)^{k-1} r(1-r)^{k-1} = \frac{pr}{1 – (1-p)(1-r)}.\]
Ainsi \(P(X = Y) = \dfrac{pr}{p + r – pr}\).
Corrigé de l’exercice 9 : Covariance nulle sans indépendance
- Par symétrie, \(E(X) = \frac{-1 + 0 + 1}{3} = 0\). Ensuite, \(Y\) suit la loi de Bernoulli de paramètre \(P(X \neq 0) = \frac{2}{3}\). Donc \(E(Y) = \frac{2}{3}\) et \(V(Y) = \frac{2}{3} \cdot \frac{1}{3}\). Enfin, \(V(X) = E(X^2) = E(Y)\). Ainsi \(E(X) = 0\), \(E(Y) = V(X) = \frac{2}{3}\) et \(V(Y) = \frac{2}{9}\).
- On a \(XY = X^3 = X\), car \(X\) prend ses valeurs dans \(\{-1, 0, 1\}\). Donc \(\mathrm{Cov}(X, Y) = E(X) – E(X) E(Y) = 0\). La covariance est nulle.
- D’une part, \(P(X = 0, Y = 1) = 0\), car \(X = 0\) impose \(Y = 0\). D’autre part, \(P(X = 0) P(Y = 1) = \frac{1}{3} \cdot \frac{2}{3} = \frac{2}{9}\). Les variables ne sont donc pas indépendantes : \(Y\) est même une fonction de \(X\).
- Par la formule de la variance d’une somme, \(V(X + Y) = V(X) + V(Y) + 2 \cdot 0 = \frac{2}{3} + \frac{2}{9} = \frac{8}{9}\). Vérifions avec la loi. Si \(X = -1\) ou \(X = 0\), alors \(X + Y = 0\) ; si \(X = 1\), alors \(X + Y = 2\). Ainsi \(X + Y = 2B\) avec \(B \sim \mathcal{B}(1/3)\). Donc \(V(X + Y) = 4 \cdot \frac{1}{3} \cdot \frac{2}{3}\). Les deux méthodes donnent \(V(X + Y) = \frac{8}{9}\).
Corrigé de l’exercice 10 : Espérance d’une variable complexe
- On a \(|Z| = 1\) : la variable est bornée, donc d’espérance finie. Par transfert, puisque \(\omega \neq 1\) (car \(n \geq\, 2\)) et \(\omega^n = 1\) :
\[E(Z) = \frac{1}{n} \sum_{k=0}^{n-1} \omega^k = \frac{1}{n} \cdot \frac{1 – \omega^n}{1 – \omega} = 0.\]
De plus, \(|Z|^2 = 1\), donc \(E(|Z|^2) = 1\). Ainsi \(E(Z) = 0\) et \(E(|Z|^2) = 1\) : les racines de l’unité, également pondérées, ont pour barycentre l’origine. - On a \(Z^m = (\omega^m)^X\). Si \(n\) divise \(m\), alors \(\omega^m = 1\) et \(E(Z^m) = 1\). Sinon, \(\omega^m \neq 1\) et \((\omega^m)^n = 1\), et le même calcul de somme géométrique donne 0. Donc \(E(Z^m) = 1\) si \(n \mid m\), et \(E(Z^m) = 0\) sinon.
- On a \(|e^{itY}| = 1\), donc \(e^{itY}\) est d’espérance finie. Par transfert :
\[E(e^{itY}) = \sum_{k=0}^{+\infty} e^{itk} e^{-\lambda} \frac{\lambda^k}{k!} = e^{-\lambda} \sum_{k=0}^{+\infty} \frac{(\lambda e^{it})^k}{k!} = e^{-\lambda} e^{\lambda e^{it}}.\]
Ainsi \(E(e^{itY}) = \exp\big(\lambda(e^{it} – 1)\big)\). - On écrit \(\lambda(e^{it} – 1) = \lambda(\cos t – 1) + i\lambda \sin t\). Donc \(E(e^{itY}) = e^{\lambda(\cos t – 1)} \big(\cos(\lambda \sin t) + i \sin(\lambda \sin t)\big)\). De plus, \(E(e^{itY}) = E(\cos(tY)) + i E(\sin(tY))\) par définition de l’espérance complexe. En identifiant : \(E(\cos(tY)) = e^{\lambda(\cos t – 1)} \cos(\lambda \sin t)\) et \(E(\sin(tY)) = e^{\lambda(\cos t – 1)} \sin(\lambda \sin t)\).
Corrigé de l’exercice 11 : Une minoration par Cauchy-Schwarz
- La variable \(|U|\) admet un moment d’ordre 2, donc \(|U|\) est d’espérance finie. L’inégalité de Cauchy-Schwarz appliquée à \(|U|\) et à la constante 1 donne \(E(|U|)^2 \leq\, E(U^2) E(1)\). Donc \(E(|U|) \leq\, \sqrt{E(U^2)}\).
- Si \(X = 0\), les deux membres de \(X = X \mathbf{1}_{(X \geq\, 1)}\) sont nuls ; sinon, l’indicatrice vaut 1. Ensuite, Cauchy-Schwarz appliquée à \(X\) et \(\mathbf{1}_{(X \geq\, 1)}\) donne :
\[E(X)^2 = E\big(X \mathbf{1}_{(X \geq\, 1)}\big)^2 \leq\, E(X^2) \, E\big(\mathbf{1}_{(X \geq\, 1)}^2\big) = E(X^2) \, P(X \geq\, 1).\]
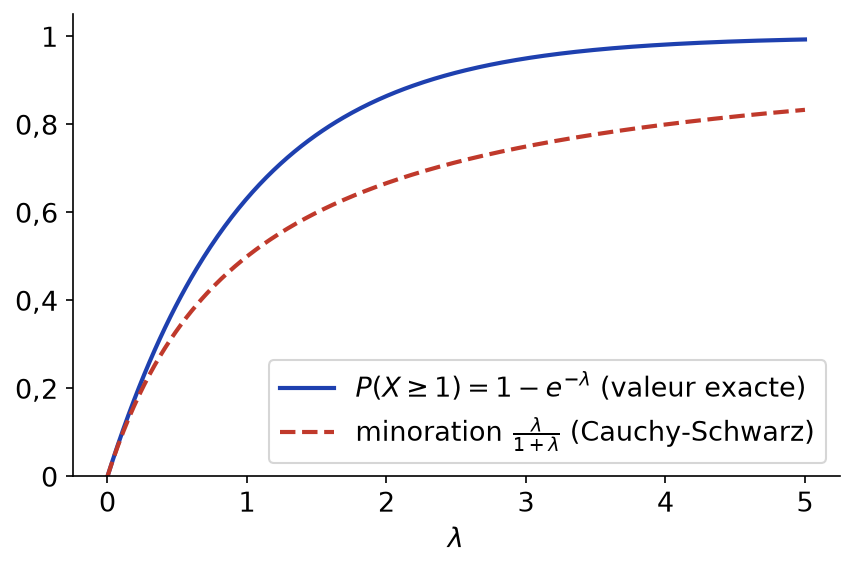
Enfin, \(E(X^2) \geq\, E(X)^2 > 0\). On peut diviser : \(P(X \geq\, 1) \geq\, \dfrac{E(X)^2}{E(X^2)}\). - Pour \(X \sim \mathcal{P}(\lambda)\), on a \(E(X) = \lambda\) et \(E(X^2) = \lambda + \lambda^2\). Donc \(P(X \geq\, 1) \geq\, \frac{\lambda^2}{\lambda + \lambda^2} = \frac{\lambda}{1 + \lambda}\). La valeur exacte est \(1 – e^{-\lambda}\). La comparaison équivaut à \(e^{-\lambda} \leq\, \frac{1}{1+\lambda}\), c’est-à-dire \(e^{\lambda} \geq\, 1 + \lambda\), inégalité de convexité classique. Ainsi \(\frac{\lambda}{1+\lambda} \leq\, P(X \geq\, 1) = 1 – e^{-\lambda}\). La figure ci-dessous montre que la minoration est très bonne pour \(\lambda\) petit, puis devient grossière.

- Pour \(X \sim \mathcal{B}(n, p)\), on a \(E(X) = np\) et \(E(X^2) = np(1-p) + n^2p^2\). Donc :
\[P(X \geq\, 1) \geq\, \frac{n^2p^2}{np(1-p) + n^2p^2} = \frac{np}{1 – p + np}.\]
Ainsi \(P(X \geq\, 1) \geq\, \dfrac{np}{1 – p + np}\).
Point de méthode : multiplier par une indicatrice qui ne change pas la variable, puis appliquer Cauchy-Schwarz, donne une minoration de probabilité. C’est la « méthode du second moment ».
Corrigé de l’exercice 12 : Nombre de points fixes d’une permutation
- Notons \(A_i = (\sigma(i) = i)\). Alors \(N = \sum_{i=1}^{n} \mathbf{1}_{A_i}\). Les permutations qui fixent \(i\) sont en bijection avec les permutations des \(n – 1\) autres éléments. Donc \(P(A_i) = \frac{(n-1)!}{n!} = \frac{1}{n}\). Par linéarité, \(E(N) = n \cdot \frac{1}{n}\). Ainsi \(E(N) = 1\).
- Pour \(i \neq j\), de même, \(P(A_i \cap A_j) = \frac{(n-2)!}{n!} = \frac{1}{n(n-1)}\). Donc :
\[\mathrm{Cov}(\mathbf{1}_{A_i}, \mathbf{1}_{A_j}) = \frac{1}{n(n-1)} – \frac{1}{n^2} = \frac{n – (n-1)}{n^2(n-1)}.\]
Ainsi \(\mathrm{Cov}(\mathbf{1}_{A_i}, \mathbf{1}_{A_j}) = \dfrac{1}{n^2(n-1)}\). - Chaque indicatrice a pour variance \(\frac{1}{n}(1 – \frac{1}{n})\). Il y a \(n(n-1)\) couples \((i, j)\) avec \(i \neq j\). Par la formule de la variance d’une somme :
\[V(N) = n \cdot \frac{n-1}{n^2} + n(n-1) \cdot \frac{1}{n^2(n-1)} = \frac{n-1}{n} + \frac{1}{n}.\]
Donc \(V(N) = 1\), quel que soit \(n \geq\, 2\). - L’inégalité de Markov donne \(P(N \geq\, 3) \leq\, \frac{E(N)}{3} = \frac{1}{3}\). Ensuite, \((N \geq\, 3) \subset (|N – 1| \geq\, 2)\), donc Bienaymé-Tchebychev donne \(P(N \geq\, 3) \leq\, \frac{V(N)}{4}\). Ainsi \(P(N \geq\, 3) \leq\, \frac{1}{3}\) par Markov et \(P(N \geq\, 3) \leq\, \frac{1}{4}\) par Bienaymé-Tchebychev.
Point de méthode : ce résultat remarquable s’interprète simplement. Le nombre moyen de points fixes vaut 1, et sa variance aussi, exactement comme pour une loi de Poisson de paramètre 1. D’ailleurs, on montre que la loi de \(N\) converge vers \(\mathcal{P}(1)\) quand \(n\) tend vers l’infini. Retenez surtout le schéma : indicatrices, puis probabilités d’intersections deux à deux, puis formule de la variance d’une somme.
Corrigé de l’exercice 13 : Urnes vides
- Notons \(E_i\) l’événement « l’urne \(i\) est vide ». Chaque boule évite l’urne \(i\) avec probabilité \(1 – \frac{1}{n}\), indépendamment des autres. Donc \(P(E_i) = (1 – \frac{1}{n})^m = a\). Comme \(N = \sum \mathbf{1}_{E_i}\), on obtient par linéarité : \(E(N) = n(1 – \frac{1}{n})^m\).
- Pour \(i \neq j\), chaque boule évite les deux urnes avec probabilité \(1 – \frac{2}{n}\). Donc \(P(E_i \cap E_j) = (1 – \frac{2}{n})^m = b\). Ainsi \(\mathrm{Cov}(\mathbf{1}_{E_i}, \mathbf{1}_{E_j}) = b – a^2\). Par la formule de la variance d’une somme :
\[V(N) = n a(1 – a) + n(n-1)(b – a^2).\]
Donc \(V(N) = n(1 – \frac{1}{n})^m(1 – (1 – \frac{1}{n})^m) + n(n-1)((1 – \frac{2}{n})^m – (1 – \frac{1}{n})^{2m})\). - Pour \(m = n = 10\) : \(a = 0{,}9^{10} \approx 0{,}3487\) et \(b = 0{,}8^{10} \approx 0{,}1074\). Donc \(E(N) \approx 3{,}487\). Ensuite, \(10 a(1-a) \approx 2{,}271\) et \(90(b – a^2) \approx -1{,}278\). Ainsi \(E(N) \approx 3{,}49\) et \(V(N) \approx 0{,}99\).
- Posons \(a_n = (1 – \frac{1}{n})^n\) et \(b_n = (1 – \frac{2}{n})^n\). D’abord, \(1 – \frac{2}{n} \leq\, (1 – \frac{1}{n})^2\), donc \(b_n \leq\, a_n^2\). Le terme de covariance est négatif, d’où \(V(N_n) \leq\, n a_n(1 – a_n) \leq\, \frac{n}{4}\). Ensuite, \(a_n = e^{n \ln(1 – 1/n)} \to e^{-1}\). Soit \(\varepsilon > 0\). Pour \(n\) assez grand, \(|a_n – e^{-1}| < \frac{\varepsilon}{2}\). Alors l’inégalité triangulaire donne \((|\frac{N_n}{n} – e^{-1}| \geq\, \varepsilon) \subset (|\frac{N_n}{n} – a_n| \geq\, \frac{\varepsilon}{2})\). Or \(E(N_n / n) = a_n\). Par Bienaymé-Tchebychev :
\[P(|\frac{N_n}{n} – e^{-1}| \geq\, \varepsilon) \leq\, \frac{4 V(N_n)}{n^2 \varepsilon^2} \leq\, \frac{1}{n \varepsilon^2}.\]
Cette borne tend vers 0 : la proportion d’urnes vides se concentre autour de \(e^{-1} \approx 0{,}37\).
Point de méthode : les indicatrices \(\mathbf{1}_{E_i}\) ne sont pas indépendantes : savoir qu’une urne est vide rend les autres un peu plus remplies. C’est pourquoi les covariances sont négatives. Remarquez aussi l’astuce qui simplifie la fin : majorer le terme de covariance par 0 plutôt que de chercher sa limite.
Corrigé de l’exercice 14 : Coefficient de corrélation de deux comptages
- Les variables centrées \(U – E(U)\) et \(V – E(V)\) admettent un moment d’ordre 2. L’inégalité de Cauchy-Schwarz leur donne \(E\big((U – E(U))(V – E(V))\big)^2 \leq\, V(U) V(V)\). En prenant la racine : \(|\mathrm{Cov}(U, V)| \leq\, \sigma(U) \sigma(V)\), donc \(|\rho| \leq\, 1\).
- Les lancers sont indépendants et chacun donne « 1 » avec probabilité \(\frac{1}{6}\). Donc \(X \sim \mathcal{B}(n, 1/6)\), \(Y \sim \mathcal{B}(n, 1/6)\) et \(V(X) = V(Y) = \frac{5n}{36}\).
- Notons \(A_i\) : « le lancer \(i\) donne 1 » et \(B_j\) : « le lancer \(j\) donne 6 ». Par bilinéarité, \(\mathrm{Cov}(X, Y) = \sum_{i, j} \mathrm{Cov}(\mathbf{1}_{A_i}, \mathbf{1}_{B_j})\). Pour \(i \neq j\), les lancers sont indépendants, donc la covariance est nulle. Pour \(i = j\), les événements sont incompatibles, donc \(\mathrm{Cov} = 0 – \frac{1}{36}\). Ainsi \(\mathrm{Cov}(X, Y) = -\frac{n}{36}\). Par conséquent :
\[\rho = \frac{-n/36}{5n/36} = -\frac{1}{5}.\]
Donc \(\mathrm{Cov}(X, Y) = -\frac{n}{36}\) et \(\rho = -\frac{1}{5}\). Le signe négatif traduit que plus de « 1 » laisse moins de place aux « 6 ». - Par la formule de la variance d’une somme : \(V(X + Y) = \frac{5n}{36} + \frac{5n}{36} – \frac{2n}{36} = \frac{8n}{36}\). Par ailleurs, \(X + Y\) compte les lancers qui donnent 1 ou 6, donc \(X + Y \sim \mathcal{B}(n, 1/3)\) et \(V(X + Y) = n \cdot \frac{1}{3} \cdot \frac{2}{3}\). Les deux calculs donnent \(V(X + Y) = \frac{2n}{9}\).
Corrigé de l’exercice 15 : Inégalité de Markov et borne exponentielle
- La variable \(X\) est positive et \(E(X) = \lambda\). L’inégalité de Markov avec \(a = 2\lambda\) donne : \(P(X \geq\, 2\lambda) \leq\, \frac{\lambda}{2\lambda} = \frac{1}{2}\).
- On a \((X \geq\, 2\lambda) \subset (|X – \lambda| \geq\, \lambda)\). Bienaymé-Tchebychev donne alors \(P(X \geq\, 2\lambda) \leq\, \frac{V(X)}{\lambda^2}\). Donc \(P(X \geq\, 2\lambda) \leq\, \frac{1}{\lambda}\).
- D’après l’exercice 2 avec \(e^{tX} = (e^t)^X\), on a \(E(e^{tX}) = e^{\lambda(e^t – 1)}\). Ensuite, la fonction exponentielle est croissante, donc \((X \geq\, 2\lambda) = (e^{tX} \geq\, e^{2\lambda t})\) pour \(t > 0\). Par Markov appliquée à \(e^{tX}\), positive :
\[P(X \geq\, 2\lambda) \leq\, \frac{E(e^{tX})}{e^{2\lambda t}} = \exp\big(\lambda(e^t – 1) – 2\lambda t\big).\]
Ainsi \(P(X \geq\, 2\lambda) \leq\, \exp\big(\lambda(e^t – 1 – 2t)\big)\) pour tout \(t > 0\). - La fonction \(h(t) = e^t – 1 – 2t\) a pour dérivée \(e^t – 2\). Elle est donc minimale en \(t = \ln 2 > 0\), où \(h(\ln 2) = 2 – 1 – 2\ln 2 = 1 – 2\ln 2\). Par conséquent, \(P(X \geq\, 2\lambda) \leq\, e^{\lambda(1 – 2\ln 2)}\). Or \(e^{1 – 2\ln 2} = \frac{e}{4}\), d’où \(P(X \geq\, 2\lambda) \leq\, (\frac{e}{4})^{\lambda}\).
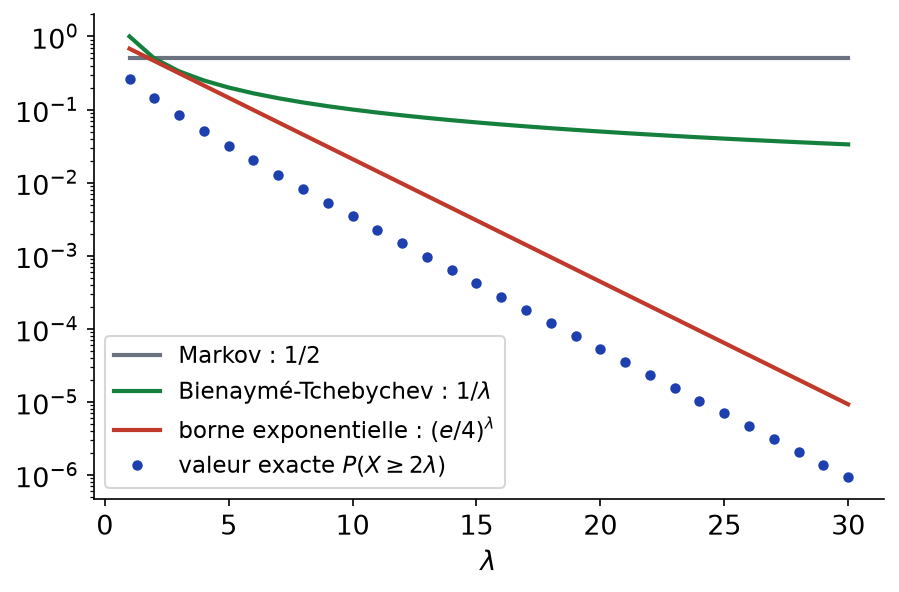
- Pour \(\lambda = 10\), Markov donne \(0{,}5\), Bienaymé-Tchebychev donne \(0{,}1\) et la borne exponentielle donne \((e/4)^{10} \approx 0{,}021\). La borne exponentielle est la meilleure, et elle décroît géométriquement en \(\lambda\), comme la vraie valeur \(0{,}0035\). La figure ci-dessous compare les trois bornes à la valeur exacte, en échelle logarithmique.

Point de méthode : appliquer Markov à \(e^{tX}\), puis optimiser en \(t\), fournit une inégalité de concentration exponentielle dès que \(E(e^{tX})\) est calculable.
Corrigé de l’exercice 16 : Taille d’échantillon par Bienaymé-Tchebychev
- On a \(F_n = \frac{S_n}{n}\), où \(S_n \sim \mathcal{B}(n, 1/2)\) compte les « pile ». Donc \(E(F_n) = \frac{1}{n} \cdot \frac{n}{2}\) et \(V(F_n) = \frac{1}{n^2} \cdot \frac{n}{4}\). Ainsi \(E(F_n) = \frac{1}{2}\) et \(V(F_n) = \frac{1}{4n}\).
- Par Bienaymé-Tchebychev :
\[P(|F_n – 0{,}5| \geq\, 0{,}05) \leq\, \frac{1}{4n \cdot 0{,}0025} = \frac{100}{n}.\]
Cette borne est inférieure à \(0{,}05\) dès que \(n \geq\, 2000\). Donc \(n = 2000\) lancers suffisent. - Ici \(V(F_n) = \frac{p(1-p)}{n} \leq\, \frac{1}{4n}\), car \(p(1-p) \leq\, \frac{1}{4}\) pour tout \(p \in [0, 1]\). Donc :
\[P(|F_n – p| \geq\, 0{,}01) \leq\, \frac{1}{4n \cdot 10^{-4}} = \frac{2500}{n}.\]
Cette borne vaut au plus \(0{,}1\) dès que \(n \geq\, 25\,000\). Ainsi \(25\,000\) lancers suffisent, quel que soit \(p\). - Les indicatrices \(X_i\) de « pile au lancer \(i\) » sont indépendantes, de même loi \(\mathcal{B}(p)\) et bornées. La loi faible des grands nombres affirme que, pour tout \(\varepsilon > 0\), \(P(|F_n – p| \geq\, \varepsilon) \to 0\). Les questions 2 et 3 en donnent une version quantitative, avec la vitesse \(\frac{1}{4n\varepsilon^2}\). Sur la figure de l’énoncé, les trajectoires restent en effet dans la bande pour \(n\) grand.
Corrigé de l’exercice 17 : Une seconde formule des queues
- Pour \(n \geq\, 1\), on a \(n P(X \geq\, n) = \sum_{k \geq\, n} n P(X = k)\). La famille \((n P(X = k))_{1 \leq\, n \leq\, k}\) est positive. Le théorème de Fubini pour les familles positives permet donc d’intervertir :
\[\sum_{n=1}^{+\infty} n P(X \geq\, n) = \sum_{k=1}^{+\infty} P(X = k) \sum_{n=1}^{k} n = \sum_{k=0}^{+\infty} \frac{k(k+1)}{2} P(X = k).\]
Par la formule de transfert, la somme vaut \(E(\frac{X(X+1)}{2})\) dans \([0, +\infty]\). - On a \(X^2 \leq\, X(X+1) \leq\, 2X^2\) pour \(X\) à valeurs dans \(\mathbb{N}\). Donc \(E(X^2)\) est finie si et seulement si \(E(X(X+1))\) l’est. Ainsi \(X\) admet un moment d’ordre 2 si et seulement si \(\sum n P(X \geq\, n)\) converge.
- Pour \(X \sim \mathcal{G}(p)\), on a \(\sum_{n \geq\, 1} n q^{n-1} = \frac{1}{(1-q)^2} = \frac{1}{p^2}\). Donc \(E(X^2) + E(X) = \frac{2}{p^2}\) et \(E(X^2) = \frac{2}{p^2} – \frac{1}{p} = \frac{2 – p}{p^2}\). Enfin :
\[V(X) = \frac{2 – p}{p^2} – \frac{1}{p^2} = \frac{1 – p}{p^2}.\]
On retrouve \(V(X) = \frac{q}{p^2}\). - La suite \((\frac{1}{n^2})\) décroît de 1 vers 0 : elle définit bien des probabilités de queue. Pour \(n \geq\, 1\) :
\[P(X = n) = \frac{1}{n^2} – \frac{1}{(n+1)^2} = \frac{2n + 1}{n^2 (n+1)^2}.\]
La formule des queues donne \(E(X) = \sum_{n \geq\, 1} \frac{1}{n^2} = \frac{\pi^2}{6}\), qui est fini. En revanche, \(\sum n P(X \geq\, n) = \sum \frac{1}{n}\) diverge. Donc \(E(X) = \frac{\pi^2}{6}\), mais \(X\) n’admet pas de moment d’ordre 2.
Corrigé de l’exercice 18 : Loi faible pour des variables corrélées
- On a \(E(Y_k) = 0\) et \(V(Y_k) = E(Y_k^2) = 1\). Par linéarité, \(E(X_k) = 0\). Ensuite, \(Y_k\) et \(Y_{k+1}\) sont indépendantes. Donc \(E(X_k) = 0\) et \(V(X_k) = 1 + 1 = 2\).
- Par bilinéarité, \(\mathrm{Cov}(X_k, X_{k+1}) = \mathrm{Cov}(Y_k + Y_{k+1}, Y_{k+1} + Y_{k+2})\). Parmi les quatre termes, seul \(\mathrm{Cov}(Y_{k+1}, Y_{k+1}) = 1\) est non nul. Si \(|k – l| \geq\, 2\), les variables \(X_k\) et \(X_l\) font intervenir des \(Y_j\) distincts, donc toutes les covariances sont nulles. Ainsi \(\mathrm{Cov}(X_k, X_{k+1}) = 1\) et \(\mathrm{Cov}(X_k, X_l) = 0\) si \(|k – l| \geq\, 2\) ; les \(X_k\) ne sont pas indépendantes, puisque deux voisines ont une covariance non nulle.
- Première méthode, par la formule de la variance d’une somme : il y a \(n\) variances égales à 2 et \(n – 1\) couples de voisins. Donc \(V(S_n) = 2n + 2(n – 1)\). Seconde méthode : \(S_n = Y_1 + 2(Y_2 + \cdots + Y_n) + Y_{n+1}\), somme de variables indépendantes. Donc \(V(S_n) = 1 + 4(n – 1) + 1\). Dans les deux cas, \(V(S_n) = 4n – 2\).
- On a \(E(S_n / n) = 0\) et \(V(S_n / n) = \frac{4n – 2}{n^2}\). Par Bienaymé-Tchebychev :
\[P(|\frac{S_n}{n}| \geq\, \varepsilon) \leq\, \frac{4n – 2}{n^2 \varepsilon^2} \leq\, \frac{4}{n \varepsilon^2}.\]
Cette borne tend vers 0 : la loi faible reste vraie sans indépendance. - Par Cauchy-Schwarz, \(|\mathrm{Cov}(X_k, X_{k+1})| \leq\, \sigma(X_k) \sigma(X_{k+1}) \leq\, C\). Les seules covariances non nulles portent sur les \(n – 1\) couples de voisins. Donc \(V(S_n) \leq\, nC + 2(n-1)C \leq\, 3nC\). Ensuite, \(E(S_n / n) = m\) et \(V(S_n / n) \leq\, \frac{3C}{n}\). Par Bienaymé-Tchebychev, \(P(|S_n / n – m| \geq\, \varepsilon) \leq\, \dfrac{3C}{n \varepsilon^2}\).
Point de méthode : seule la variance de \(S_n\) intervient dans la loi faible. Ainsi, une dépendance à courte portée ne ralentit la convergence que d’un facteur constant : ici, la variance est multipliée par 2 par rapport au cas de variables indépendantes de variance 2.
Corrigé de l’exercice 19 : Polynômes de Bernstein
- La variable \(S_n\) prend les valeurs \(k \in \{0, \ldots, n\}\) avec probabilité \(\binom\,{n}{k} x^k (1-x)^{n-k}\). La formule de transfert donne donc \(E(f(S_n / n)) = B_n(f)(x)\). Pour \(f(t) = t\) : \(B_n(f)(x) = \frac{E(S_n)}{n} = x\). Pour \(f(t) = t^2\) : \(E(S_n^2) = V(S_n) + E(S_n)^2 = nx(1-x) + n^2x^2\). Donc \(B_n(t)(x) = x\) et \(B_n(t^2)(x) = x^2 + \dfrac{x(1-x)}{n}\).
- Par linéarité et inégalité triangulaire, \(|B_n(f)(x) – f(x)| = |E(f(S_n/n) – f(x))| \leq\, E(|f(S_n/n) – f(x)|)\). Notons \(A = (|S_n/n – x| < \delta)\). Sur \(A\), l’écart est au plus \(\varepsilon\). Sur le complémentaire, il est au plus \(2\|f\|_{\infty}\). Donc :
\[E(|f(S_n/n) – f(x)|) \leq\, \varepsilon + 2\|f\|_{\infty} P(|\frac{S_n}{n} – x| \geq\, \delta).\]
Or \(V(S_n / n) = \frac{x(1-x)}{n} \leq\, \frac{1}{4n}\). Bienaymé-Tchebychev majore donc la probabilité par \(\frac{1}{4n\delta^2}\). Ainsi \(|B_n(f)(x) – f(x)| \leq\, \varepsilon + \dfrac{\|f\|_{\infty}}{2n\delta^2}\) pour tout \(x \in [0, 1]\). - La fonction \(f\) est continue sur le segment \([0, 1]\). Le théorème de Heine assure son uniforme continuité, donc l’existence de \(\delta\). Le majorant obtenu ne dépend pas de \(x\). Pour \(n \geq\, \frac{\|f\|_{\infty}}{2\varepsilon\delta^2}\), on a donc \(\|B_n(f) – f\|_{\infty} \leq\, 2\varepsilon\). Par conséquent, \((B_n(f))\) converge uniformément vers \(f\) sur \([0, 1]\).
- Si \(f\) est \(L\)-lipschitzienne, \(|f(S_n/n) – f(x)| \leq\, L|S_n/n – x|\). Ensuite, la question 1 de l’exercice 11 appliquée à \(U = S_n/n – x\), centrée, donne :
\[\|B_n(f) – f\|_{\infty} \leq\, L \sup_{x} \sqrt{\frac{x(1-x)}{n}} \leq\, \frac{L}{2\sqrt{n}}.\]
Pour \(f(t) = |t – \frac{1}{2}|\), de rapport \(L = 1\), on obtient \(\|B_n(f) – f\|_{\infty} \leq\, \frac{1}{2\sqrt{n}}\), soit \(\frac{1}{16}\) pour \(n = 64\). La figure ci-dessous montre les approximations pour \(n = 4\), 16 et 64. L’écart maximal se situe au point anguleux \(x = \frac{1}{2}\).
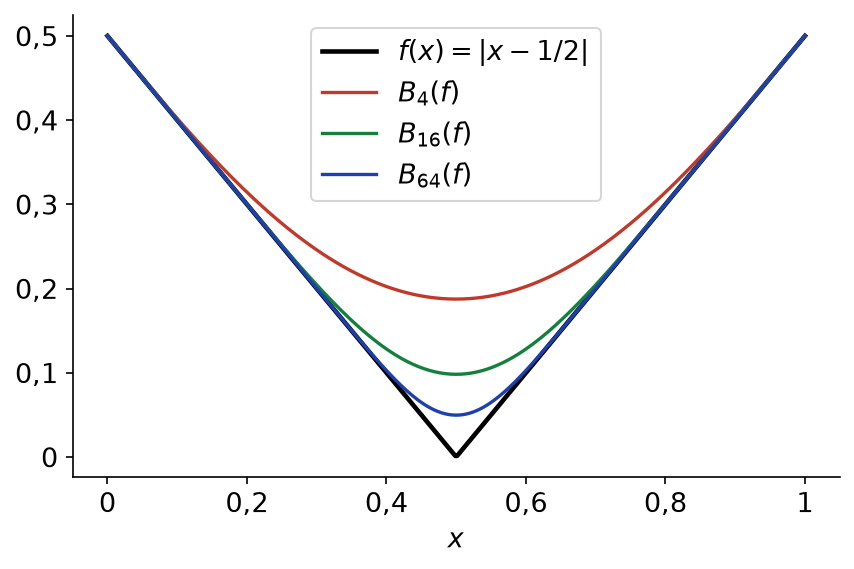
Point de méthode : découper selon que \(S_n/n\) est proche ou non de \(x\), puis contrôler l’événement « loin » par Bienaymé-Tchebychev, est le schéma type d’une preuve de convergence probabiliste.
Corrigé de l’exercice 20 : Problème, le collectionneur de vignettes
- Après l’obtention de \(k – 1\) vignettes distinctes, chaque achat donne une vignette nouvelle avec probabilité \(\frac{n – (k-1)}{n}\), indépendamment des achats précédents. Le nombre d’achats jusqu’au premier succès suit donc une loi géométrique. Ainsi \(G_k \sim \mathcal{G}(\frac{n – k + 1}{n})\) ; pour \(k = 1\), le paramètre vaut 1 et \(G_1 = 1\).
- On a \(T_n = G_1 + G_2 + \cdots + G_n\). Par linéarité, \(E(T_n) = \sum_{k=1}^{n} \frac{n}{n – k + 1}\). En posant \(j = n – k + 1\) : \(E(T_n) = n \sum_{j=1}^{n} \frac{1}{j} = n H_n\).
- Pour \(n = 6\), \(H_6 = 1 + \frac{1}{2} + \frac{1}{3} + \frac{1}{4} + \frac{1}{5} + \frac{1}{6} = \frac{49}{20}\). Donc \(E(T_6) = \frac{147}{10}\). Pour \(n = 50\), \(H_{50} \approx 4{,}499\). Ainsi \(E(T_6) = 14{,}7\) et \(E(T_{50}) \approx 225\).
- Les \(G_k\) sont indépendantes, donc \(V(T_n) = \sum_{k} V(G_k)\). Ensuite, \(V(G_k) = \frac{1 – p_k}{p_k^2} \leq\, \frac{1}{p_k^2} = \frac{n^2}{(n – k + 1)^2}\). Par conséquent :
\[V(T_n) \leq\, n^2 \sum_{j=1}^{n} \frac{1}{j^2} \leq\, n^2 \sum_{j=1}^{+\infty} \frac{1}{j^2} = \frac{\pi^2 n^2}{6}.\]
Donc \(V(T_n) \leq\, \dfrac{\pi^2 n^2}{6}\). - On applique Bienaymé-Tchebychev à \(T_n\), d’espérance \(n H_n\), avec l’écart \(\varepsilon n \ln n > 0\) (car \(n \geq\, 2\)) :
\[P(|T_n – nH_n| \geq\, \varepsilon n \ln n) \leq\, \frac{V(T_n)}{\varepsilon^2 n^2 (\ln n)^2} \leq\, \frac{\pi^2}{6 \varepsilon^2 (\ln n)^2}.\]
C’est la majoration demandée. - Par comparaison série-intégrale, \(H_n \sim \ln n\). Soit \(\varepsilon > 0\). Il existe donc \(n_0\) tel que \(|\frac{H_n}{\ln n} – 1| < \frac{\varepsilon}{2}\) pour \(n \geq\, n_0\). Par l’inégalité triangulaire :
\[|\frac{T_n}{n \ln n} – 1| \leq\, \frac{|T_n – nH_n|}{n \ln n} + |\frac{H_n}{\ln n} – 1|.\]
Pour \(n \geq\, n_0\), l’événement \((|\frac{T_n}{n\ln n} – 1| \geq\, \varepsilon)\) est donc inclus dans \((|T_n – nH_n| \geq\, \frac{\varepsilon}{2} n \ln n)\). La question précédente, avec \(\frac{\varepsilon}{2}\), donne :
\[P(|\frac{T_n}{n \ln n} – 1| \geq\, \varepsilon) \leq\, \frac{2\pi^2}{3 \varepsilon^2 (\ln n)^2} \xrightarrow[n \to +\infty]{ 0.\]
Ainsi \(\frac{T_n}{n \ln n}\) se concentre autour de 1 : il faut environ \(n \ln n\) achats pour compléter la collection. La figure ci-dessous compare \(E(T_n)\), \(n \ln n\) et des réalisations simulées.
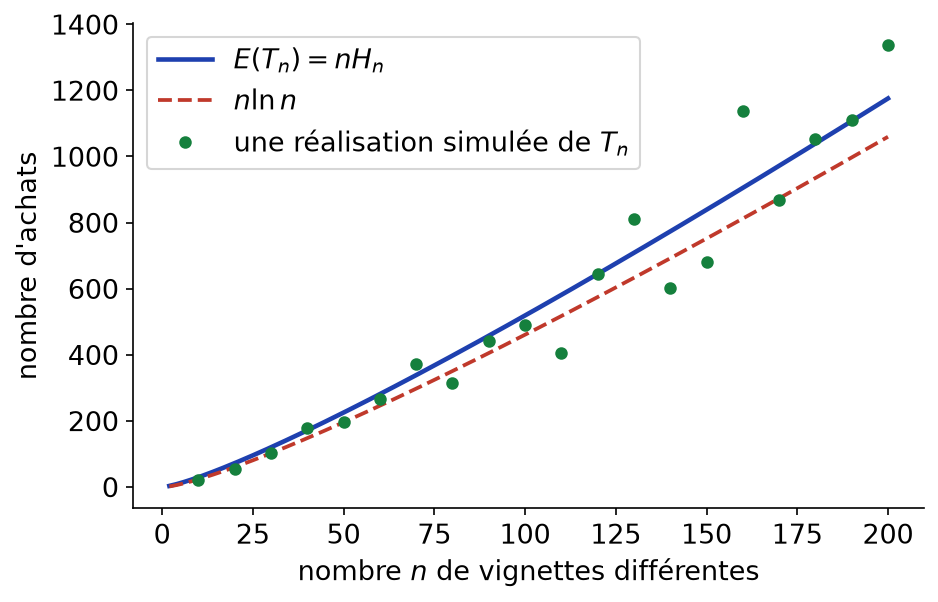
Point de méthode : décomposer un temps d’attente en somme de temps géométriques indépendants donne à la fois l’espérance, la variance et une loi des grands nombres.
Revenir aux énoncés des exercices
Pour aller plus loin en maths spé
- Le cours : espérance et variance, cours de maths spé
- Les énoncés : exercices de maths spé sur espérance et variance
- À maîtriser avant : Variables aléatoires discrètes et lois usuelles
- Chapitre précédent : Variables aléatoires discrètes et lois usuelles
- Chapitre suivant : Fonctions génératrices
- Le même thème en maths sup : espérance et variance, exercices de maths sup
- Tester vos connaissances : QCM de maths spé par chapitre
- Le sommaire : tous les chapitres de maths spé et les chapitres de maths sup