Ce chapitre sur les variables aléatoires discrètes prolonge directement l’étude des espaces probabilisés. Il se place au second semestre de maths spé, juste avant l’espérance et les fonctions génératrices. Ce cours de variables aléatoires spé définit d’abord la loi d’une variable, la loi d’une variable image et la loi conditionnelle sachant un événement.
Vous étudierez ensuite les couples de variables, avec loi conjointe et lois marginales, puis la loi d’une somme ou d’un minimum. Viennent ensuite l’indépendance des familles de variables, le lemme des coalitions et l’existence de suites i.i.d.
Enfin, le chapitre installe les deux modèles centraux du programme. D’une part, la loi géométrique décrit le rang du premier succès et se caractérise par l’absence de mémoire. D’autre part, la loi de Poisson modélise les événements rares. Ces outils reviennent dans presque tous les sujets de concours.
Pour vous entraîner ensuite, travaillez les exercices de maths spé sur variables aléatoires discrètes.
I. Variables aléatoires discrètes et loi
Dans tout le chapitre, \((\Omega, \mathcal{A}, P)\) désigne un espace probabilisé. Les résultats du chapitre précédent sur les tribus et la \(\sigma\)-additivité sont donc disponibles. Une variable aléatoire discrète est une fonction du résultat de l’expérience qui ne prend qu’un nombre au plus dénombrable de valeurs.
1. Définition et loi
Soit \(E\) un ensemble. Une variable aléatoire discrète à valeurs dans \(E\) est une application \(X : \Omega \to E\) telle que :
- l’ensemble image \(X(\Omega)\) est au plus dénombrable ;
- pour tout \(x \in X(\Omega)\), l’ensemble \(X^{-1}(\{x\}) = (X = x)\) appartient à \(\mathcal{A}\).
Lorsque \(E \subset \mathbb{R}\), on parle de variable aléatoire discrète réelle.
Pour toute partie \(A\) de \(E\), l’ensemble \((X \in A)\) est la réunion des \((X = x)\) pour \(x \in A \cap X(\Omega)\). C’est une réunion au plus dénombrable d’événements, donc un événement. Par conséquent, on peut définir sa probabilité.
L’application \(P_X : A \mapsto P(X \in A)\), définie sur \(\mathcal{P}(X(\Omega))\), est une probabilité. On l’appelle la loi de \(X\). Elle est entièrement déterminée par la famille \(\big(P(X = x)\big)_{x \in X(\Omega)}\), qui est une famille de réels positifs de somme \(1\).
D’abord, \(P_X(X(\Omega)) = P(\Omega) = 1\). Ensuite, si \((A_n)\) est une suite de parties deux à deux disjointes, les événements \((X \in A_n)\) sont deux à deux disjoints. Leur réunion est \((X \in \bigcup A_n)\). La \(\sigma\)-additivité de \(P\) donne donc celle de \(P_X\). Enfin, par \(\sigma\)-additivité, \(P_X(A) = \sum_{x \in A} P(X = x)\), ce qui prouve la dernière affirmation.
Réciproquement, toute distribution de probabilités discrète est la loi d’une variable aléatoire. En pratique, déterminer la loi de \(X\) revient donc à donner \(X(\Omega)\) et les nombres \(P(X = x)\). On écrit \(X \sim Y\) lorsque deux variables ont la même loi.
Posons \(P(X = k) = \dfrac{1}{k(k+1)}\) pour \(k \in \mathbb{N}^*\). Ces nombres sont positifs et, par télescopage, \(\sum_{k=1}^{n} (\dfrac{1}{k} – \dfrac{1}{k+1}) = 1 – \dfrac{1}{n+1} \to 1\). Ainsi, on définit bien une loi sur \(\mathbb{N}^*\). De plus, \(P(X \geq\, n) = \dfrac{1}{n}\) par le même calcul.
2. Variable image et loi conditionnelle
Si \(X\) est une variable aléatoire discrète à valeurs dans \(E\) et \(f : E \to F\) une application, alors \(f(X) = f \circ X\) est une variable aléatoire discrète. Sa loi est donnée, pour \(y \in f(X(\Omega))\), par
\[P\big(f(X) = y\big) = \sum_{x \in X(\Omega),\ f(x) = y} P(X = x).\]
En effet, \(f(X)(\Omega) = f(X(\Omega))\) est au plus dénombrable. De plus, \((f(X) = y)\) est la réunion disjointe des \((X = x)\) pour \(f(x) = y\).
Soit \(B\) un événement tel que \(P(B) > 0\). La loi conditionnelle de \(X\) sachant \(B\) est la loi de \(X\) pour la probabilité \(P_B\) : elle est donnée par les nombres \(P(X = x \mid B)\), pour \(x \in X(\Omega)\).
Avec la loi précédente, la loi de \(X\) sachant \((X \geq\, n)\) vérifie, pour \(k \geq\, n\),
\[P(X = k \mid X \geq\, n) = \dfrac{P(X = k)}{P(X \geq\, n)} = \dfrac{n}{k(k+1)}.\]
Pour \(k < n\), cette probabilité est nulle.
II. Couples et vecteurs de variables aléatoires
On étudie souvent plusieurs grandeurs issues de la même expérience. Il faut alors connaître leurs valeurs simultanées, et pas seulement chacune séparément.
1. Loi conjointe et lois marginales
Si \(X\) et \(Y\) sont deux variables aléatoires discrètes sur \(\Omega\), le couple \(Z = (X, Y)\) est une variable aléatoire discrète. Sa loi est appelée loi conjointe de \(X\) et \(Y\). Elle est donnée par les nombres \(P(X = x, Y = y)\). Les lois de \(X\) et de \(Y\) sont les lois marginales du couple.
Pour tout \(x \in X(\Omega)\),
\[P(X = x) = \sum_{y \in Y(\Omega)} P(X = x, Y = y).\]
De même, pour tout \(y \in Y(\Omega)\), \(P(Y = y) = \sum_{x \in X(\Omega)} P(X = x, Y = y)\).
C’est la formule des probabilités totales, appliquée au système complet \(\big((Y = y)\big)_{y \in Y(\Omega)}\). Ainsi, la loi conjointe détermine les lois marginales. En revanche, les lois marginales ne déterminent pas la loi conjointe.
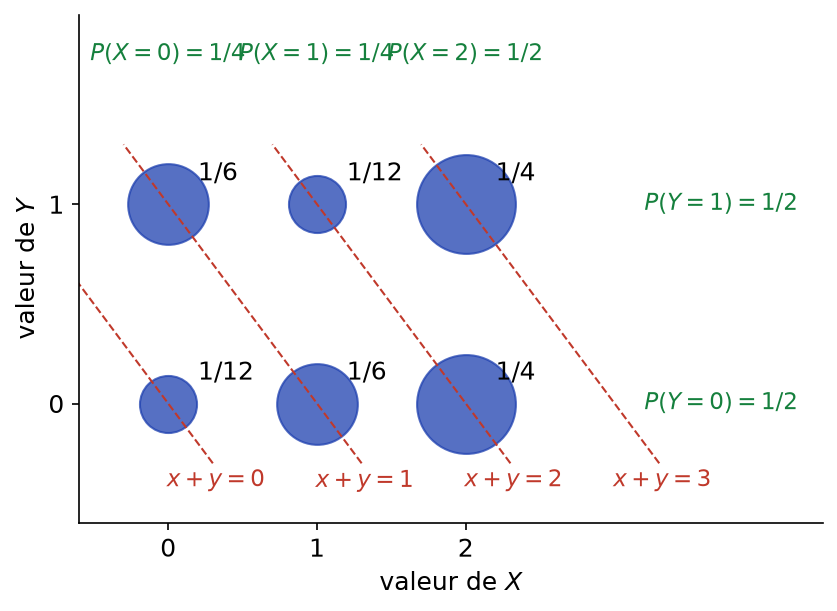
Soit \(X\) à valeurs dans \(\{0, 1, 2\}\) et \(Y\) à valeurs dans \(\{0, 1\}\), de loi conjointe
\[\begin{array}{c|ccc} X = 0 X = 1 X = 2 \\ \hline Y = 0 1/12 1/6 1/4 \\ Y = 1 1/6 1/12 1/4 \end{array}\]
En sommant les colonnes, \(P(X = 0) = P(X = 1) = \dfrac14\) et \(P(X = 2) = \dfrac12\). En sommant les lignes, \(P(Y = 0) = P(Y = 1) = \dfrac12\). La figure ci-dessous représente chaque probabilité par l’aire d’un disque.
2. Loi d’une somme, d’un minimum, d’un maximum
Une variable définie à partir du couple, comme \(X + Y\), est une variable image \(f(X, Y)\). Sa loi se lit donc sur la loi conjointe. Dans la figure précédente, les points d’une même droite \(x + y = s\) donnent l’événement \((X + Y = s)\).
Pour la loi de \(S = X + Y\), avec \(X\) et \(Y\) à valeurs dans \(\mathbb{N}\), on découpe selon la valeur de \(X\) :
\[P(S = n) = \sum_{k=0}^{n} P(X = k, Y = n – k).\]
Pour un maximum ou un minimum, on passe par la fonction de répartition : \((\max(X, Y) \leq\, n) = (X \leq\, n) \cap (Y \leq\, n)\) et \((\min(X, Y) > n) = (X > n) \cap (Y > n)\). Ensuite, \(P(M = n) = P(M \leq\, n) – P(M \leq\, n – 1)\).
Dans l’exemple du tableau, \(P(X + Y = 2) = P(X = 2, Y = 0) + P(X = 1, Y = 1) = \dfrac14 + \dfrac1{12} = \dfrac13\). De même, on trouve \(P(X + Y = 0) = \dfrac1{12}\), \(P(X + Y = 1) = \dfrac13\) et \(P(X + Y = 3) = \dfrac14\).
Plus généralement, pour \(n\) variables \(X_1, \ldots, X_n\), le vecteur \((X_1, \ldots, X_n)\) est une variable aléatoire discrète. Sa loi est la loi conjointe, et les lois des \(X_i\) sont ses lois marginales.
III. Variables aléatoires indépendantes
1. Indépendance de deux variables
Deux variables aléatoires discrètes \(X\) et \(Y\) sont indépendantes si, pour tout \(x \in X(\Omega)\) et tout \(y \in Y(\Omega)\),
\[P(X = x, Y = y) = P(X = x)\,P(Y = y).\]
On note alors \(X \perp\!\!\!\perp Y\).
Si \(X\) et \(Y\) sont indépendantes, alors pour toutes parties \(A \subset X(\Omega)\) et \(B \subset Y(\Omega)\), \(P(X \in A, Y \in B) = P(X \in A)\,P(Y \in B)\). De plus, pour toutes fonctions \(f\) et \(g\), les variables \(f(X)\) et \(g(Y)\) sont indépendantes.
Les familles sont sommables, car à termes positifs de somme au plus \(1\). Par sommation par paquets,
\[P(X \in A, Y \in B) = \sum_{x \in A} \sum_{y \in B} P(X = x)P(Y = y) = P(X \in A)\,P(Y \in B).\]
Ensuite, \((f(X) = u) = (X \in f^{-1}(\{u\}))\) et \((g(Y) = v) = (Y \in g^{-1}(\{v\}))\). Le premier point donne donc l’indépendance de \(f(X)\) et \(g(Y)\).
Pour prouver l’indépendance de \(X\) et \(Y\), on vérifie la factorisation de \(P(X = x, Y = y)\) pour tous les couples. Il suffit aussi d’écrire \(P(X = x, Y = y) = a_x\,b_y\) avec des réels positifs : on montre alors que \(P(X = x)\) est proportionnel à \(a_x\) et \(P(Y = y)\) à \(b_y\). Pour réfuter l’indépendance, un seul couple suffit, par exemple une probabilité conjointe nulle alors que les marginales sont non nulles.
Dans l’exemple du tableau, \(P(X = 0, Y = 0) = \dfrac1{12}\), alors que \(P(X = 0)P(Y = 0) = \dfrac18\). Les variables \(X\) et \(Y\) ne sont donc pas indépendantes.
Si \(X\) et \(Y\) sont indépendantes, la loi conditionnelle de \(Y\) sachant \((X = x)\) est la loi de \(Y\), pour tout \(x\) tel que \(P(X = x) > 0\). Autrement dit, connaître \(X\) ne renseigne pas sur \(Y\).
2. Familles de variables indépendantes
Des variables \(X_1, \ldots, X_n\) sont mutuellement indépendantes si, pour tous \(x_1 \in X_1(\Omega), \ldots, x_n \in X_n(\Omega)\),
\[P(X_1 = x_1, \ldots, X_n = x_n) = \prod_{i=1}^{n} P(X_i = x_i).\]
Une famille quelconque \((X_i)_{i \in I}\) est indépendante si toute sous-famille finie l’est.
L’indépendance deux à deux ne suffit pas. Par exemple, si \(X\) et \(Y\) sont indépendantes de loi uniforme sur \(\{0, 1\}\) et \(Z = |X – Y|\), les trois variables sont indépendantes deux à deux, mais pas mutuellement.
Pour une famille indépendante, les sous-familles restent indépendantes. De plus, les événements \((X_i \in A_i)\) forment une famille d’événements indépendants. Le résultat suivant permet de regrouper les variables en paquets.
Lemme des coalitions. Soit \(X_1, \ldots, X_n\) des variables mutuellement indépendantes et \(1 \leq\, m < n\). Alors, pour toutes fonctions \(f\) et \(g\), les variables \(f(X_1, \ldots, X_m)\) et \(g(X_{m+1}, \ldots, X_n)\) sont indépendantes. Le résultat s’étend à plus de deux paquets disjoints.
Posons \(U = (X_1, \ldots, X_m)\) et \(V = (X_{m+1}, \ldots, X_n)\). Pour \(u = (x_1, \ldots, x_m)\) et \(v = (x_{m+1}, \ldots, x_n)\), la définition donne
\[P(U = u, V = v) = \prod_{i=1}^{m} P(X_i = x_i) \times \prod_{i=m+1}^{n} P(X_i = x_i).\]
En sommant sur \(x_{m+1}, \ldots, x_n\), le second produit vaut \(1\) et l’on obtient \(P(U = u)\). De même pour \(P(V = v)\). Ainsi, \(U\) et \(V\) sont indépendantes. On conclut par la propriété sur \(f(U)\) et \(g(V)\).
Si \(X_1, X_2, X_3, X_4\) sont indépendantes, alors \(X_1 + X_2\) et \(X_3 X_4\) sont indépendantes. De même, \(S_{n-1} = X_1 + \cdots + X_{n-1}\) est indépendante de \(X_n\). Cette remarque sert constamment dans les récurrences sur les sommes.
3. Suites de variables indépendantes
Pour toute suite \((\mu_n)\) de lois discrètes, il existe un espace probabilisé et une suite \((X_n)\) de variables aléatoires indépendantes telles que \(X_n\) suit la loi \(\mu_n\) pour tout \(n\). Ce résultat est admis.
En particulier, il existe des suites i.i.d., c’est-à-dire indépendantes et identiquement distribuées. Elles modélisent la répétition infinie d’une même expérience, par exemple une suite de lancers de pièce. C’est ce théorème qui donne un sens au « rang du premier succès » de la partie V.
IV. Rappels sur les lois finies usuelles
- Loi uniforme sur un ensemble fini \(E\) de cardinal \(n\) : \(P(X = x) = \dfrac1n\) pour tout \(x \in E\).
- Loi de Bernoulli \(\mathcal{B}(p)\), avec \(p \in [0, 1]\) : \(X(\Omega) \subset \{0, 1\}\), \(P(X = 1) = p\) et \(P(X = 0) = 1 – p\).
- Loi binomiale \(\mathcal{B}(n, p)\) : \(P(X = k) = \dbinom{n}{k} p^k (1 – p)^{n – k}\) pour \(0 \leq\, k \leq\, n\).
Si \(X_1, \ldots, X_n\) sont indépendantes de même loi \(\mathcal{B}(p)\), alors \(S_n = X_1 + \cdots + X_n\) suit la loi \(\mathcal{B}(n, p)\).
L’événement \((S_n = k)\) est la réunion disjointe des \((X_1 = \varepsilon_1, \ldots, X_n = \varepsilon_n)\), pour les \(\varepsilon \in \{0, 1\}^n\) ayant exactement \(k\) coordonnées égales à \(1\). Par indépendance, chacun a pour probabilité \(p^k(1-p)^{n-k}\). Or il y a \(\binom\,{n}{k}\) tels \(n\)-uplets. On obtient donc la loi binomiale.
Ainsi, la loi binomiale compte les succès dans \(n\) épreuves de Bernoulli indépendantes. Par conséquent, si \(X \sim \mathcal{B}(n, p)\) et \(Y \sim \mathcal{B}(m, p)\) sont indépendantes, alors \(X + Y \sim \mathcal{B}(n + m, p)\). On peut le voir par le lemme des coalitions, ou par la formule de Vandermonde.
On lance \(10\) fois une pièce qui donne pile avec probabilité \(0{,}3\), et l’on note \(X\) le nombre de piles. Les lancers sont indépendants, donc \(X \sim \mathcal{B}(10\,;\,0{,}3)\). Par exemple, \(P(X = 0) = 0{,}7^{10} \approx 0{,}028\). De plus, \(10 – X\) compte les faces : il suit donc la loi \(\mathcal{B}(10\,;\,0{,}7)\).
V. La loi géométrique
1. Définition et rang du premier succès
Soit \(p \in \,]0, 1[\) et \(q = 1 – p\). Une variable \(X\) suit la loi géométrique \(\mathcal{G}(p)\) si \(X(\Omega) = \mathbb{N}^*\) et, pour tout \(k \geq\, 1\),
\[P(X = k) = p\,q^{k-1}.\]
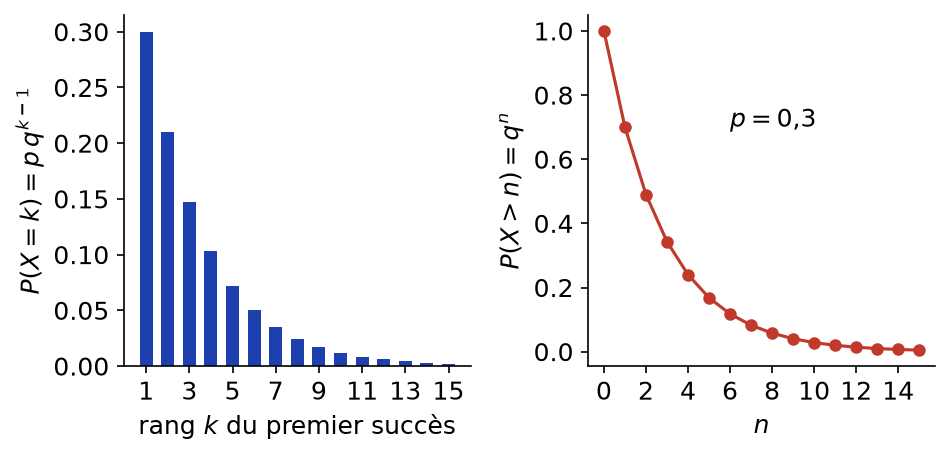
Ces nombres sont positifs et \(\sum_{k \geq\, 1} p q^{k-1} = \dfrac{p}{1 – q} = 1\). Ils définissent donc bien une loi. La figure ci-dessous montre la décroissance géométrique des probabilités, puis la probabilité de dépasser \(n\).
Soit \((X_n)_{n \geq\, 1}\) une suite i.i.d. de loi \(\mathcal{B}(p)\), avec \(p \in \,]0, 1[\). On pose \(T = \min\{n \geq\, 1,\ X_n = 1\}\), avec \(T = +\infty\) si aucun succès n’a lieu. Alors \(P(T = +\infty) = 0\) et \(T\) suit la loi \(\mathcal{G}(p)\). On dit que \(T\) est le rang du premier succès.
Pour \(k \geq\, 1\), \((T = k) = (X_1 = 0) \cap \cdots \cap (X_{k-1} = 0) \cap (X_k = 1)\). Par indépendance, \(P(T = k) = q^{k-1} p\). Ensuite, \((T = +\infty)\) est l’intersection de la suite décroissante des événements \(B_n = (X_1 = 0, \ldots, X_n = 0)\). Par continuité décroissante, \(P(T = +\infty) = \lim q^n = 0\).
Si \(X \sim \mathcal{G}(p)\), alors pour tout \(n \in \mathbb{N}\), \(P(X > n) = q^n\).
En effet, \((X > n)\) signifie que les \(n\) premières épreuves sont des échecs. Par le calcul, \(\sum_{k > n} p q^{k-1} = p\,\dfrac{q^n}{1 – q} = q^n\).
2. Absence de mémoire
Si \(X \sim \mathcal{G}(p)\), alors pour tous \(n, k \in \mathbb{N}\),
\[P(X > n + k \mid X > n) = P(X > k).\]
Réciproquement, si \(X\) est à valeurs dans \(\mathbb{N}^*\), vérifie \(P(X > n) > 0\) pour tout \(n\) et cette relation, alors \(X\) suit une loi géométrique.
Sens direct : \((X > n + k) \subset (X > n)\), donc le quotient vaut \(\dfrac{q^{n+k}}{q^n} = q^k\). Réciproque : posons \(u_n = P(X > n)\). L’hypothèse s’écrit \(u_{n+k} = u_n u_k\), avec \(u_0 = 1\). Par récurrence, \(u_n = u_1^n\). Or \(u_n \to P(X = +\infty) = 0\) par continuité décroissante, donc \(u_1 < 1\). De plus \(u_1 > 0\). En posant \(q = u_1\), on obtient \(P(X = n) = u_{n-1} – u_n = (1 – q)q^{n-1}\).
Concrètement, savoir que l’on a attendu \(n\) épreuves sans succès ne change rien à la suite. Comme le montre la figure ci-dessous, la courbe conditionnelle est la courbe initiale, simplement décalée.
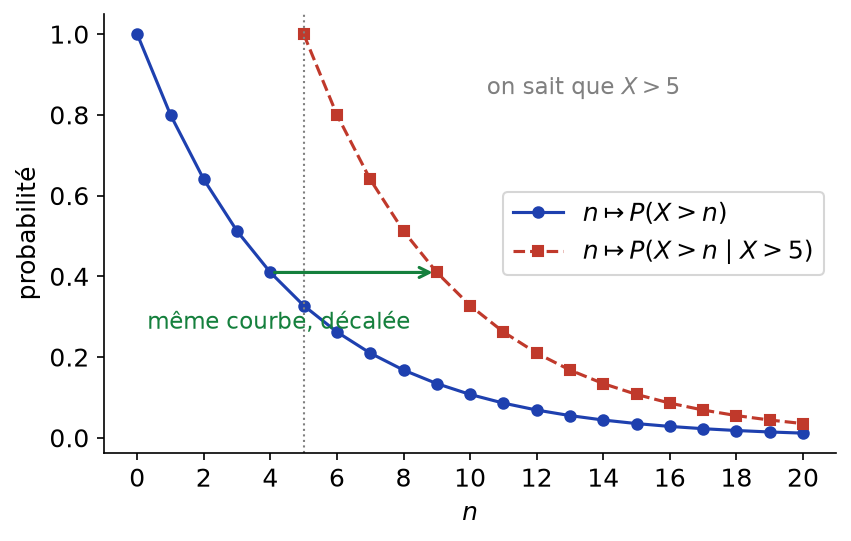
Pour reconnaître une loi géométrique, on cherche une situation de « premier succès » dans des épreuves de Bernoulli indépendantes. Par le calcul, on vérifie que \(P(X = k) = a\,r^{k-1}\) pour \(k \geq\, 1\), avec \(0 < r < 1\). La condition de somme \(1\) impose alors \(a = 1 – r\), donc \(X \sim \mathcal{G}(1 – r)\). Si la variable commence à \(0\), on étudie \(X + 1\).
Si \(X \sim \mathcal{G}(p)\) et \(Y \sim \mathcal{G}(p^{\prime})\) sont indépendantes, alors \(P(\min(X, Y) > n) = P(X > n)P(Y > n) = \big(q(1 – p^{\prime})\big)^n\). Ainsi, \(\min(X, Y)\) suit la loi géométrique de paramètre \(1 – q(1 – p^{\prime})\).
VI. La loi de Poisson
1. Définition
Soit \(\lambda > 0\). Une variable \(X\) suit la loi de Poisson \(\mathcal{P}(\lambda)\) si \(X(\Omega) = \mathbb{N}\) et, pour tout \(k \in \mathbb{N}\),
\[P(X = k) = e^{-\lambda}\dfrac{\lambda^k}{k!}.\]
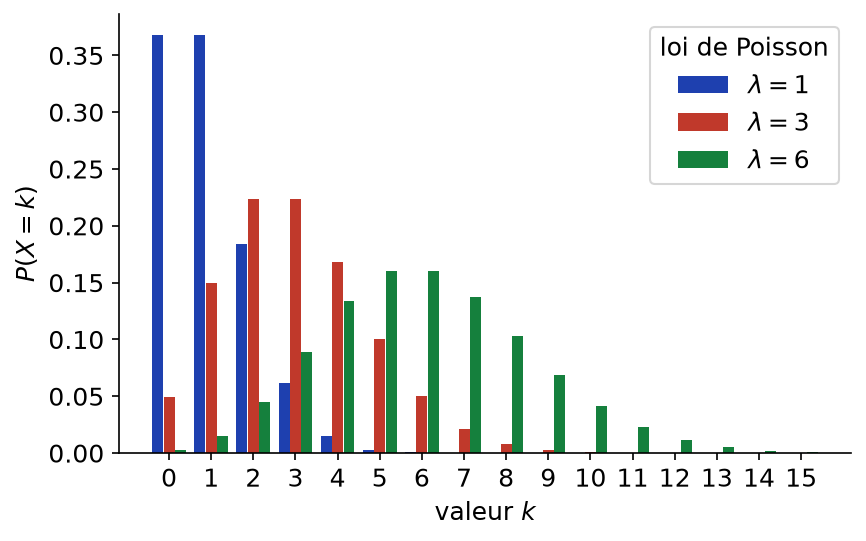
La série exponentielle donne \(\sum_{k \geq\, 0} \dfrac{\lambda^k}{k!} = e^{\lambda}\), donc la somme vaut bien \(1\). D’autre part, le rapport \(\dfrac{P(X = k)}{P(X = k – 1)} = \dfrac{\lambda}{k}\) est supérieur à \(1\) tant que \(k < \lambda\). Les probabilités croissent donc jusqu’à \(\lfloor \lambda \rfloor\), puis décroissent, comme le montre la figure ci-dessous.
Si \(X \sim \mathcal{P}(\lambda)\) et \(Y \sim \mathcal{P}(\mu)\) sont indépendantes, alors \(X + Y \sim \mathcal{P}(\lambda + \mu)\).
Pour \(n \in \mathbb{N}\), par indépendance puis par la formule du binôme,
\[P(X + Y = n) = \sum_{k=0}^{n} e^{-\lambda}\dfrac{\lambda^k}{k!}\, e^{-\mu}\dfrac{\mu^{n-k}}{(n-k)!} = \dfrac{e^{-(\lambda + \mu)}}{n!}\sum_{k=0}^{n}\binom\,{n}{k}\lambda^k \mu^{n-k} = e^{-(\lambda + \mu)}\dfrac{(\lambda + \mu)^n}{n!}.\]
2. Loi des événements rares
La loi de Poisson modélise le nombre d’occurrences d’un phénomène rare : pannes, appels, défauts, désintégrations. Le théorème suivant justifie ce modèle.
Approximation binomiale-Poisson. Soit \((p_n)\) une suite de \([0, 1]\) telle que \(n p_n \to \lambda > 0\), et \(X_n \sim \mathcal{B}(n, p_n)\). Alors, pour tout \(k \in \mathbb{N}\),
\[\lim_{n \to +\infty} P(X_n = k) = e^{-\lambda}\dfrac{\lambda^k}{k!}.\]
Fixons \(k\). Pour \(n \geq\, k\),
\[P(X_n = k) = \dfrac{n(n-1)\cdots(n-k+1)}{n^k}\cdot\dfrac{(n p_n)^k}{k!}\cdot(1 – p_n)^{n-k}.\]
Le premier facteur tend vers \(1\), et le deuxième vers \(\dfrac{\lambda^k}{k!}\). Ensuite, \(p_n \to 0\), donc \((n – k)\ln(1 – p_n) \sim -n p_n \to -\lambda\). Ainsi, \((1 – p_n)^{n-k} \to e^{-\lambda}\).
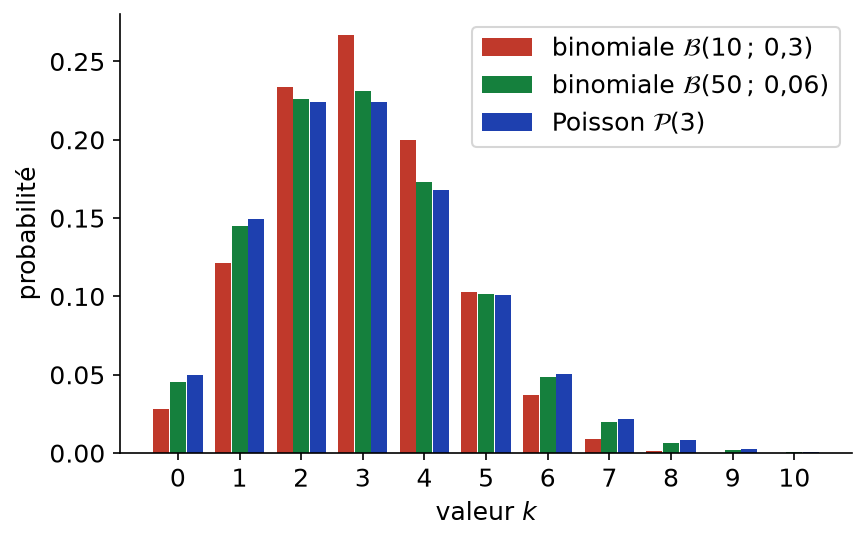
En pratique, on remplace \(\mathcal{B}(n, p)\) par \(\mathcal{P}(np)\) lorsque \(n\) est grand et \(p\) petit. La figure ci-dessous compare \(\mathcal{B}(10\,;\,0{,}3)\), \(\mathcal{B}(50\,;\,0{,}06)\) et \(\mathcal{P}(3)\) : l’accord s’améliore quand \(n\) augmente à \(np\) fixé.
Pour reconnaître une loi de Poisson, on montre que \(P(X = k) = C\,\dfrac{a^k}{k!}\) pour tout \(k \in \mathbb{N}\), avec \(a > 0\). La condition de somme \(1\) impose alors \(C = e^{-a}\), donc \(X \sim \mathcal{P}(a)\). Autre signe : le rapport \(\dfrac{P(X = k)}{P(X = k – 1)}\) vaut \(\dfrac{a}{k}\). Enfin, une somme de variables de Poisson indépendantes, ou une limite de lois binomiales avec \(np_n \to a\), conduit aussi à \(\mathcal{P}(a)\).
Un standard reçoit en moyenne \(2\) appels par minute. On modélise leur nombre \(N\) par la loi \(\mathcal{P}(2)\). Ainsi, la probabilité qu’aucun appel n’arrive vaut \(e^{-2} \approx 0{,}135\). De même, \(P(N \leq\, 2) = e^{-2}(1 + 2 + 2) = 5e^{-2} \approx 0{,}677\).
L’espérance et la variance de ces lois seront calculées au chapitre suivant. Retenez déjà que le paramètre \(\lambda\) d’une loi de Poisson s’interprète comme un nombre moyen d’occurrences.
Ce qu’il faut retenir
- Une variable aléatoire discrète prend un nombre au plus dénombrable de valeurs ; sa loi est donnée par les \(P(X = x)\), positifs et de somme \(1\).
- La loi de \(f(X)\) s’obtient en regroupant les valeurs \(x\) qui ont la même image.
- La loi conjointe donne les lois marginales par sommation, mais la réciproque est fausse.
- Loi d’une somme : \(P(X + Y = n) = \sum_k P(X = k, Y = n – k)\) ; pour un maximum ou un minimum, passer par \(P(M \leq\, n)\) ou \(P(m > n)\).
- Indépendance : factorisation de la loi conjointe ; \(f(X)\) et \(g(Y)\) héritent de l’indépendance.
- Lemme des coalitions : des fonctions de paquets disjoints de variables indépendantes sont indépendantes.
- Il existe des suites i.i.d. de lois données ; le rang du premier succès suit \(\mathcal{G}(p)\), avec \(P(X > n) = q^n\).
- La loi géométrique est la seule loi sur \(\mathbb{N}^*\) sans mémoire.
- La somme de deux variables de Poisson indépendantes est de Poisson, de paramètre la somme des paramètres.
- La loi \(\mathcal{P}(np)\) approche \(\mathcal{B}(n, p)\) pour \(n\) grand et \(p\) petit : c’est la loi des événements rares.
Questions fréquentes sur variables aléatoires discrètes
Comment montrer que deux variables aléatoires discrètes sont indépendantes ?
On vérifie que \(P(X = x, Y = y) = P(X = x)P(Y = y)\) pour tous les couples de valeurs. Il suffit souvent de constater que la loi conjointe s’écrit \(a_x b_y\) : les marginales sont alors proportionnelles à \(a_x\) et à \(b_y\). Pour réfuter l’indépendance, un seul couple suffit, par exemple une case de probabilité nulle alors que les marginales sont non nulles.
À quoi sert le lemme des coalitions ?
Il affirme que des fonctions de paquets disjoints de variables indépendantes sont indépendantes. Par exemple, \(X_1 + X_2\) et \(X_3X_4\) sont indépendantes si les \(X_i\) le sont. On l’utilise surtout dans les récurrences, car \(S_{n-1} = X_1 + \cdots + X_{n-1}\) est alors indépendante de \(X_n\).
Comment reconnaître une loi géométrique ?
On cherche le rang du premier succès dans une suite d’épreuves de Bernoulli indépendantes de même paramètre. Par le calcul, on montre que \(P(X = k) = a\,r^{k-1}\) pour \(k \geq\, 1\), avec \(0 < r < 1\), ou que \(P(X > n) = r^n\). Alors \(X\) suit la loi géométrique de paramètre \(1 – r\).
Quand peut-on approcher une loi binomiale par une loi de Poisson ?
Lorsque le nombre d’épreuves \(n\) est grand et la probabilité de succès \(p\) petite, on remplace \(\mathcal{B}(n, p)\) par \(\mathcal{P}(np)\). Le théorème du cours l’affirme : si \(np_n \to \lambda\), alors \(P(X_n = k)\) tend vers \(e^{-\lambda}\lambda^k/k!\). C’est la loi des événements rares.
Pour aller plus loin en maths spé
- Les énoncés : exercices de maths spé sur variables aléatoires discrètes
- À maîtriser avant : Ensembles dénombrables et espaces probabilisés
- Chapitre précédent : Ensembles dénombrables et espaces probabilisés
- Chapitre suivant : Espérance, variance et loi faible des grands nombres
- Le même thème en L2 : variables aléatoires discrètes, cours de maths en L2
- Tester vos connaissances : QCM de maths spé par chapitre
- Le sommaire : tous les chapitres de maths spé et les chapitres de maths sup