Ce corrigé variables aléatoires discrètes rédige entièrement les 22 exercices de la fiche, comme on l’attend en partiel. Chaque espérance commence par la justification de la convergence absolue de la série, puis le calcul suit, souvent par une série géométrique dérivée ou une série exponentielle.
Les solutions utilisent systématiquement la linéarité et les indicatrices dès qu’une variable compte des événements. Pour les sommes indépendantes, la fonction génératrice ou la convolution donne la loi. De plus, des figures montrent les lois obtenues et comparent les bornes de Bienaymé-Tchebychev aux probabilités exactes.
Soyez vigilant sur trois points : l’indépendance doit être justifiée avant d’additionner des variances ; une covariance nulle ne suffit pas à conclure à l’indépendance ; enfin, une variable positive peut ne pas avoir d’espérance.
Les énoncés se trouvent sur la page exercices de maths en L2 sur variables aléatoires discrètes.
Corrigé de l’exercice 1 : Loi uniforme discrète
- La variable \(X\) est finie, donc elle admet des moments de tout ordre. D’abord, \(E(X) = \frac{1}{n} \sum_{k = 1}^{n} k = \frac{1}{n} \cdot \frac{n(n + 1)}{2} = \frac{n + 1}{2}\). Ensuite, par le théorème de transfert, \(E(X^2) = \frac{1}{n} \sum_{k = 1}^{n} k^2 = \frac{(n + 1)(2n + 1)}{6}\). La formule de König-Huygens donne alors
\[V(X) = \frac{(n + 1)(2n + 1)}{6} – \frac{(n + 1)^2}{4} = \frac{(n + 1)\big(2(2n + 1) – 3(n + 1)\big)}{12} = \frac{(n + 1)(n – 1)}{12}.\]
Ainsi, \(E(X) = \frac{n + 1}{2}\) et \(V(X) = \frac{n^2 – 1}{12}\). - Pour \(x \in [k, k + 1[\), l’événement \(\{X \leq\, x\}\) est égal à \(\{X \leq\, k\}\), réunion disjointe de \(k\) événements de probabilité \(\frac{1}{n}\). Donc \(F_X(x) = \frac{k}{n}\). De plus, \(F_X = 0\) sur \(]-\infty, 1[\) et \(F_X = 1\) sur \([n, +\infty[\).
- L’application \(k \mapsto n + 1 – k\) est une bijection de \(\{1, \ldots, n\}\) sur lui-même. Par conséquent, pour tout \(k\), \(P(Y = k) = P(X = n + 1 – k) = \frac{1}{n}\). Donc \(Y\) suit la loi uniforme sur \(\{1, \ldots, n\}\). En particulier, \(E(Y) = E(X)\). Or, par linéarité, \(E(Y) = n + 1 – E(X)\). Ainsi, \(2E(X) = n + 1\).
- Pour \(n = 6\), on obtient \(E(X) = 3{,}5\) et \(V(X) = \frac{35}{12}\). L’écart type vaut \(\sqrt{35/12} \approx 1{,}71\).
Point de méthode : une symétrie de la loi donne souvent l’espérance sans calcul ; ici, la loi est symétrique par rapport à \(\frac{n + 1}{2}\).
Corrigé de l’exercice 2 : Maximum et minimum de deux dés
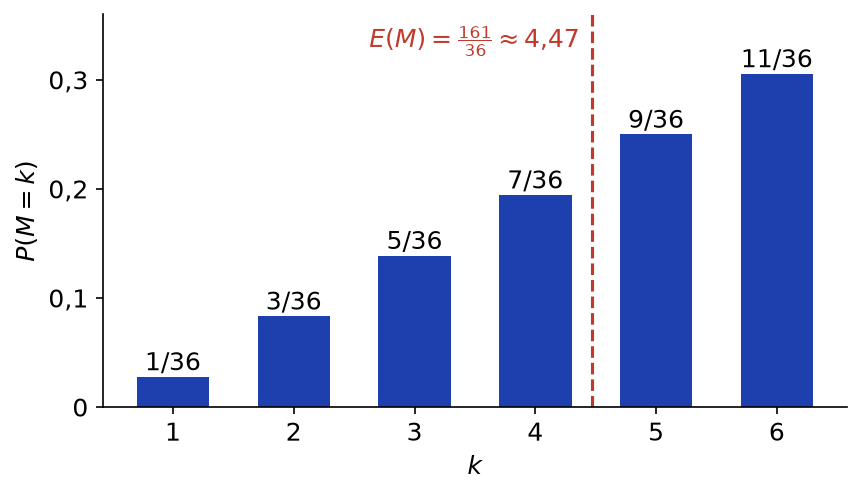
- On a \(\{M \leq\, k\} = \{X \leq\, k\} \cap \{Y \leq\, k\}\). Par indépendance, \(P(M \leq\, k) = \frac{k}{6} \cdot \frac{k}{6} = \frac{k^2}{36}\). Ensuite, \(P(M = k) = P(M \leq\, k) – P(M \leq\, k – 1)\). Donc \(P(M = k) = \frac{k^2 – (k – 1)^2}{36} = \frac{2k – 1}{36}\) pour \(1 \leq\, k \leq\, 6\). On vérifie que \(\sum_{k = 1}^{6} (2k – 1) = 36\).
- On calcule \(E(M) = \frac{1}{36} \sum_{k = 1}^{6} (2k^2 – k) = \frac{2 \times 91 – 21}{36}\). Ainsi, \(E(M) = \frac{161}{36} \approx 4{,}47\). La figure ci-dessous montre la loi obtenue : elle est croissante, ce qui place l’espérance au-dessus de \(3{,}5\).

- De même, \(\{m \geq\, k\} = \{X \geq\, k\} \cap \{Y \geq\, k\}\), donc \(P(m \geq\, k) = \frac{(7 – k)^2}{36}\). Par différence, \(P(m = k) = P(m \geq\, k) – P(m \geq\, k + 1)\). Donc \(P(m = k) = \frac{(7 – k)^2 – (6 – k)^2}{36} = \frac{13 – 2k}{36}\).
- Parmi les deux nombres \(X\) et \(Y\), l’un est le maximum et l’autre le minimum. Donc \(M + m = X + Y\). Par linéarité, \(E(m) = E(X) + E(Y) – E(M) = 7 – \frac{161}{36}\). Ainsi, \(E(m) = \frac{91}{36} \approx 2{,}53\). On retrouve ce résultat directement : \(\sum_k k(13 – 2k) = 13 \times 21 – 2 \times 91 = 91\).
Point de méthode : pour un maximum, passez par \(P(M \leq\, k)\) ; pour un minimum, par \(P(m \geq\, k)\). L’indépendance transforme alors l’intersection en produit.
Corrigé de l’exercice 3 : Loi lue sur une fonction de répartition
- La fonction \(F_X\) est constante par morceaux et saute en \(-1\), \(0\), \(2\) et \(3\). La hauteur de chaque saut vaut \(P(X = x)\). Donc \(X(\Omega) = \{-1, 0, 2, 3\}\), avec \(P(X = -1) = 0{,}2\), \(P(X = 0) = 0{,}3\), \(P(X = 2) = 0{,}4\) et \(P(X = 3) = 0{,}1\).
- On a \(P(0 < X \leq\, 2) = F_X(2) – F_X(0) = 0{,}9 – 0{,}5 = 0{,}4\). Ensuite, \(P(X < 2) = F_X(2) – P(X = 2) = 0{,}5\). Enfin, \(P(X \geq\, 0) = 1 – P(X = -1) = 0{,}8\). Les trois probabilités valent \(0{,}4\), \(0{,}5\) et \(0{,}8\).
- D’abord, \(E(X) = -0{,}2 + 0 + 0{,}8 + 0{,}3 = 0{,}9\). Ensuite, \(E(X^2) = 0{,}2 + 0 + 1{,}6 + 0{,}9 = 2{,}7\). Donc \(E(X) = 0{,}9\) et \(V(X) = 2{,}7 – 0{,}81 = 1{,}89\).
- La variable \(Y = X^2\) prend les valeurs \(1\), \(0\), \(4\) et \(9\). Comme \(x \mapsto x^2\) est injective sur \(X(\Omega)\), \(P(Y = 0) = 0{,}3\), \(P(Y = 1) = 0{,}2\), \(P(Y = 4) = 0{,}4\) et \(P(Y = 9) = 0{,}1\). Ainsi, \(E(Y) = 0{,}2 + 1{,}6 + 0{,}9 = 2{,}7\), ce qui coïncide avec \(E(X^2)\) obtenu par transfert.
Corrigé de l’exercice 4 : Tirages avec et sans remise
- Avec remise, les trois tirages sont indépendants et donnent une boule rouge avec probabilité \(0{,}4\). Donc \(X \sim \mathcal{B}(3 ; 0{,}4)\). Ainsi, \(P(X = 0) = 0{,}216\), \(P(X = 1) = 0{,}432\), \(P(X = 2) = 0{,}288\) et \(P(X = 3) = 0{,}064\). De plus, \(E(X) = 1{,}2\) et \(V(X) = 3 \times 0{,}4 \times 0{,}6 = 0{,}72\).
- Sans remise, tous les sous-ensembles de trois boules sont équiprobables, et il y en a \(\binom\,{10}{3} = 120\). Donc \(X\) suit la loi hypergéométrique \(P(X = k) = \binom\,{4}{k} \binom\,{6}{3 – k} / 120\). On obtient \(P(X = 0) = \frac{20}{120} = \frac{1}{6}\), \(P(X = 1) = \frac{60}{120} = \frac{1}{2}\), \(P(X = 2) = \frac{36}{120} = \frac{3}{10}\) et \(P(X = 3) = \frac{4}{120} = \frac{1}{30}\). La somme des numérateurs vaut bien \(120\).
- On calcule \(E(X) = \frac{60 + 72 + 12}{120} = 1{,}2\). Ensuite, \(E(X^2) = \frac{60 + 144 + 36}{120} = 2\). Donc \(E(X) = 1{,}2\) et \(V(X) = 2 – 1{,}44 = 0{,}56\).
- Les espérances sont égales, mais la variance sans remise est plus petite. En effet, \(\frac{0{,}56}{0{,}72} = \frac{7}{9}\). Ce rapport vaut \(\frac{N – n}{N – 1}\) avec \(N = 10\) et \(n = 3\). Intuitivement, tirer sans remise réduit l’aléa, car chaque tirage renseigne sur la composition restante.
Corrigé de l’exercice 5 : Moments de la loi géométrique
- La série entière \(\sum x^k\) a pour rayon \(1\) et pour somme \(\frac{1}{1 – x}\) sur \(]-1, 1[\). D’après le théorème de dérivation terme à terme des séries entières, \(\sum_{k \geq\, 1} k x^{k – 1} = \frac{1}{(1 – x)^2}\) et \(\sum_{k \geq\, 2} k(k – 1) x^{k – 2} = \frac{2}{(1 – x)^3}\) pour \(|x| < 1\).
- Les termes \(k P(X = k) = p k q^{k – 1}\) sont positifs. Leur série converge, car \(0 < q < 1\). Donc \(X\) admet une espérance, et \(E(X) = \frac{p}{(1 – q)^2} = \frac{1}{p}\). De même, par transfert, \(E(X(X – 1)) = p q \sum_{k \geq\, 2} k(k – 1) q^{k – 2} = \frac{2pq}{p^3} = \frac{2q}{p^2}\). Comme \(X^2 = X(X – 1) + X\), la variable \(X^2\) admet une espérance. Ensuite,
\[V(X) = \frac{2q}{p^2} + \frac{1}{p} – \frac{1}{p^2} = \frac{2q + p – 1}{p^2} = \frac{q}{p^2}.\]
Ainsi, \(E(X) = \frac{1}{p}\) et \(V(X) = \frac{q}{p^2}\). - On somme une série géométrique : \(P(X > n) = \sum_{k \geq\, n + 1} p q^{k – 1} = p q^n \cdot \frac{1}{1 – q} = q^n\). Ensuite, \(\{X > m + n\} \subset \{X > m\}\), donc \(P(X > m + n \mid X > m) = \frac{q^{m + n}}{q^m} = q^n\). C’est bien \(P(X > n)\) : la loi géométrique est sans mémoire.
- Le rang du premier 6 suit la loi \(\mathcal{G}(1/6)\). Donc l’espérance vaut \(6\), la variance vaut \(\frac{5/6}{1/36} = 30\), et \(P(X > 10) = (\frac{5}{6})^{10} \approx 0{,}162\).
Corrigé de l’exercice 6 : Loi de Poisson, moments et mode
- Les termes \(k e^{-\lambda} \frac{\lambda^k}{k!}\) sont positifs. De plus, \(\sum_{k \geq\, 1} k \frac{\lambda^k}{k!} = \lambda \sum_{j \geq\, 0} \frac{\lambda^j}{j!} = \lambda e^{\lambda}\). Donc \(E(X) = \lambda\). De même, \(E(X(X – 1)) = e^{-\lambda} \lambda^2 \sum_{j \geq\, 0} \frac{\lambda^j}{j!} = \lambda^2\). Par conséquent, \(X^2 = X(X – 1) + X\) admet une espérance, égale à \(\lambda^2 + \lambda\). Finalement, \(V(X) = \lambda^2 + \lambda – \lambda^2 = \lambda\).
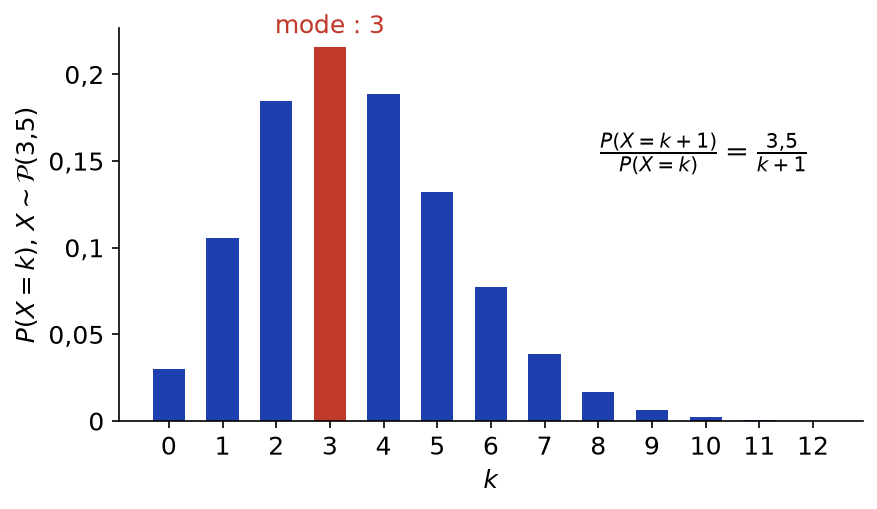
- On calcule \(\frac{P(X = k + 1)}{P(X = k)} = \frac{\lambda}{k + 1}\). Ce quotient dépasse \(1\) si et seulement si \(k + 1 < \lambda\). Pour \(\lambda = 3{,}5\), la suite \(P(X = k)\) croît tant que \(k \leq\, 2\), puis décroît à partir de \(k = 3\). La valeur la plus probable est donc \(3\), avec \(P(X = 3) \approx 0{,}216\). La figure ci-dessous le confirme.

- La fonction \(k \mapsto \frac{1}{k + 1}\) est bornée, donc le transfert s’applique. On obtient
\[E(\frac{1}{X + 1}) = e^{-\lambda} \sum_{k \geq\, 0} \frac{\lambda^k}{(k + 1)!} = \frac{e^{-\lambda}}{\lambda} \sum_{j \geq\, 1} \frac{\lambda^j}{j!} = \frac{e^{-\lambda}(e^{\lambda} – 1)}{\lambda}.\]
Ainsi, \(E(\frac{1}{X + 1}) = \frac{1 – e^{-\lambda}}{\lambda}\). - On somme sur les indices pairs : \(P(X \in 2\mathbb{N}) = e^{-\lambda} \sum_{k \geq\, 0} \frac{\lambda^{2k}}{(2k)!} = e^{-\lambda} \operatorname{ch} \lambda\). Donc \(P(X \text{ pair}) = \frac{1 + e^{-2\lambda}}{2}\), qui est toujours supérieur à \(\frac{1}{2}\).
Corrigé de l’exercice 7 : Une variable aléatoire sans espérance
- Les nombres \(\frac{1}{n(n + 1)}\) sont positifs. De plus, \(\frac{1}{n(n + 1)} = \frac{1}{n} – \frac{1}{n + 1}\), donc la somme partielle vaut \(1 – \frac{1}{N + 1}\). Elle tend vers \(1\) : on a bien une loi de probabilité.
- Par le même télescopage, \(P(X \geq\, n) = \sum_{k \geq\, n} (\frac{1}{k} – \frac{1}{k + 1})\). Donc \(P(X \geq\, n) = \frac{1}{n}\).
- On a \(n P(X = n) = \frac{1}{n + 1}\), terme général d’une série divergente. Donc \(X\), qui est positive, n’admet pas d’espérance : \(E(X) = +\infty\). En revanche, \(\frac{\sqrt{n}}{n(n + 1)} \leq\, \frac{1}{n^{3/2}}\), terme d’une série de Riemann convergente. Donc \(\sqrt{X}\) admet une espérance.
- On écrit \(P(Y \geq\, k) = \sum_{j = k}^{N} P(Y = j)\). Puis on échange les deux sommes finies : \(\sum_{k = 1}^{N} \sum_{j = k}^{N} P(Y = j) = \sum_{j = 1}^{N} \sum_{k = 1}^{j} P(Y = j) = \sum_{j = 1}^{N} j P(Y = j)\). Ainsi, \(E(Y) = \sum_{k = 1}^{N} P(Y \geq\, k)\).
- La variable \(Y_N\) prend ses valeurs dans \(\{1, \ldots, N\}\). Pour \(k \leq\, N\), on a \(\{\min(X, N) \geq\, k\} = \{X \geq\, k\}\). Donc, d’après la question précédente, \(E(Y_N) = \sum_{k = 1}^{N} \frac{1}{k} = H_N\). Ainsi, \(E(Y_N) = H_N \to +\infty\), ce qui confirme l’absence d’espérance de \(X\).
Point de méthode : pour une variable positive, l’existence de l’espérance se ramène à la convergence d’une série à termes positifs ; un équivalent ou une comparaison suffit.
Corrigé de l’exercice 8 : Théorème de transfert et convergence absolue
- La fonction \(k \mapsto \frac{1}{k}\) est bornée par \(1\) sur \(\mathbb{N}^*\), donc \(\frac{1}{X}\) admet une espérance. Par transfert, \(E(\frac{1}{X}) = \sum_{k \geq\, 1} \frac{1}{k} p q^{k – 1} = \frac{p}{q} \sum_{k \geq\, 1} \frac{q^k}{k}\). Or \(\sum_{k \geq\, 1} \frac{x^k}{k} = -\ln(1 – x)\) pour \(|x| < 1\). Donc \(E(\frac{1}{X}) = -\frac{p}{q} \ln(1 – q) = -\frac{p \ln p}{q}\).
- La variable \((-1)^X\) est bornée. Par transfert, \(E\big((-1)^X\big) = \sum_{k \geq\, 1} (-1)^k p q^{k – 1} = -p \sum_{j \geq\, 0} (-q)^j\). Ainsi, \(E\big((-1)^X\big) = -\frac{p}{1 + q}\). Ensuite, \((-1)^X = 2 \cdot \mathbf{1}_{\{X \text{ pair}\}} – 1\). Par linéarité, \(P(X \text{ pair}) = \frac{1}{2}(1 – \frac{p}{1 + q}) = \frac{1 + q – p}{2(1 + q)} = \frac{q}{1 + q}\), car \(1 – p = q\). Directement, \(\sum_{j \geq\, 1} p q^{2j – 1} = \frac{pq}{1 – q^2} = \frac{q}{1 + q}\). Les deux méthodes donnent \(P(X \text{ pair}) = \frac{q}{1 + q}\).
- La variable \(a^X\) est positive. D’après le transfert, elle admet une espérance si et seulement si \(\sum_k a^k p q^{k – 1}\) converge. Cette série géométrique converge si et seulement si \(aq < 1\). Donc \(a^X\) admet une espérance si et seulement si \(a < \frac{1}{q}\), et alors \(E(a^X) = ap \sum_{k \geq\, 1} (aq)^{k – 1} = \frac{ap}{1 – aq}\).
- Ici \(p = q = \frac{1}{2}\) et \(a = 2\), donc \(aq = 1\). Les termes \(2^k \cdot 2^{-k} = 1\) forment une série divergente. Le gain n’a pas d’espérance : \(E(2^X) = +\infty\). C’est le paradoxe dit de Saint-Pétersbourg.
Corrigé de l’exercice 9 : Points fixes d’une permutation aléatoire
- Les permutations qui fixent \(i\) correspondent aux permutations des \(n – 1\) autres éléments. Donc \(P(A_i) = \frac{(n – 1)!}{n!} = \frac{1}{n}\). Ensuite, \(X = \sum_{i = 1}^{n} \mathbf{1}_{A_i}\). Par linéarité, \(E(X) = n \cdot \frac{1}{n} = 1\).
- De même, les permutations qui fixent \(i\) et \(j\) sont au nombre de \((n – 2)!\). Donc \(P(A_i \cap A_j) = \frac{1}{n(n – 1)}\). Or \(E(\mathbf{1}_{A_i} \mathbf{1}_{A_j}) = P(A_i \cap A_j)\). Ainsi, \(\operatorname{Cov}(\mathbf{1}_{A_i}, \mathbf{1}_{A_j}) = \frac{1}{n(n – 1)} – \frac{1}{n^2} = \frac{1}{n^2(n – 1)}\).
- Chaque indicatrice a pour variance \(\frac{1}{n}(1 – \frac{1}{n})\). La formule de la variance d’une somme comporte \(n(n – 1)\) couples ordonnés \((i, j)\) avec \(i \neq j\). Donc
\[V(X) = n \cdot \frac{n – 1}{n^2} + n(n – 1) \cdot \frac{1}{n^2(n – 1)} = \frac{n – 1}{n} + \frac{1}{n} = 1.\]
Ainsi, \(V(X) = 1\), quel que soit \(n \geq\, 2\). - Si \(X \geq\, 11\), alors \(|X – 1| \geq\, 10\). L’inégalité de Bienaymé-Tchebychev donne \(P(X \geq\, 11) \leq\, \frac{V(X)}{10^2}\). Donc cette probabilité est au plus \(0{,}01\).
Point de méthode : une variable de comptage s’écrit comme une somme d’indicatrices ; l’espérance vient alors sans la loi, et la variance ne demande que les probabilités des intersections deux à deux.
Corrigé de l’exercice 10 : Couple de variables et covariance
- On somme par ligne et par colonne. La loi de \(X\) est \(P(X = 0) = 0{,}3\), \(P(X = 1) = 0{,}3\), \(P(X = 2) = 0{,}4\) ; celle de \(Y\) est \(P(Y = 0) = 0{,}6\), \(P(Y = 1) = 0{,}4\). Or \(P(X = 0, Y = 0) = 0{,}1\), tandis que \(P(X = 0) P(Y = 0) = 0{,}18\). Donc \(X\) et \(Y\) ne sont pas indépendantes.
- On calcule \(E(X) = 0{,}3 + 0{,}8 = 1{,}1\) et \(E(X^2) = 0{,}3 + 1{,}6 = 1{,}9\), d’où \(V(X) = 1{,}9 – 1{,}21 = 0{,}69\). Ensuite, \(E(Y) = 0{,}4\) et \(V(Y) = 0{,}4 \times 0{,}6 = 0{,}24\). Enfin, \(E(XY) = 1 \times 0{,}1 + 2 \times 0{,}1 = 0{,}3\). Donc \(\operatorname{Cov}(X, Y) = 0{,}3 – 1{,}1 \times 0{,}4 = -0{,}14\).
- On a \(\rho(X, Y) = \frac{-0{,}14}{\sqrt{0{,}69 \times 0{,}24}} = \frac{-0{,}14}{\sqrt{0{,}1656}}\). Ainsi, \(\rho(X, Y) \approx -0{,}344\) : la corrélation est négative et modérée.
- On divise la colonne \(y = 1\) par \(P(Y = 1) = 0{,}4\). Sachant \(Y = 1\), \(X\) vaut \(0\), \(1\), \(2\) avec les probabilités \(0{,}5\), \(0{,}25\), \(0{,}25\), et son espérance conditionnelle vaut \(0{,}25 + 0{,}5 = 0{,}75\). Elle est inférieure à \(E(X) = 1{,}1\), ce qui est cohérent avec une covariance négative.
- La variable \(S\) prend les valeurs \(0\) à \(3\). On regroupe les cases de même somme : \(P(S = 0) = 0{,}1\), \(P(S = 1) = 0{,}2 + 0{,}2 = 0{,}4\), \(P(S = 2) = 0{,}1 + 0{,}3 = 0{,}4\) et \(P(S = 3) = 0{,}1\). Ainsi, \(E(S) = 1{,}5\) et \(E(S^2) = 0{,}4 + 1{,}6 + 0{,}9 = 2{,}9\). Donc \(V(S) = 2{,}9 – 2{,}25 = 0{,}65\). On retrouve \(0{,}69 + 0{,}24 – 0{,}28 = 0{,}65\).
Corrigé de l’exercice 11 : Loi conjointe factorisée et indépendance
- La famille est positive si et seulement si \(a \geq\, 0\). Par sommation par paquets, \(\sum_{i, j} \frac{1}{i!\, j!} = \sum_i \frac{1}{i!} \sum_j \frac{1}{j!} = e^2\). La somme vaut \(1\) si et seulement si \(a = e^{-2}\).
- On a \(P(X = i) = \sum_{j \geq\, 0} \frac{e^{-2}}{i!\, j!} = \frac{e^{-2} e}{i!} = e^{-1} \frac{1}{i!}\). Donc \(X \sim \mathcal{P}(1)\), et de même \(Y \sim \mathcal{P}(1)\).
- Pour tous \(i, j\), \(P(X = i) P(Y = j) = \frac{e^{-2}}{i!\, j!} = P(X = i, Y = j)\). Les variables sont indépendantes, donc \(\operatorname{Cov}(X, Y) = 0\).
- D’après le cours, la somme de deux variables de Poisson indépendantes suit une loi de Poisson de paramètre la somme. Donc \(X + Y \sim \mathcal{P}(2)\) et \(P(X + Y = 2) = e^{-2} \frac{2^2}{2!} = 2e^{-2} \approx 0{,}271\).
Corrigé de l’exercice 12 : Minimum de deux lois géométriques indépendantes
- On a \(\{Z > n\} = \{X > n\} \cap \{Y > n\}\). Par indépendance, et d’après l’exercice 5, \(P(Z > n) = (1 – p)^n (1 – r)^n = \big((1 – p)(1 – r)\big)^n\).
- Posons \(s = 1 – (1 – p)(1 – r) = p + r – pr\), qui appartient à \(]0, 1[\). Alors \(P(Z = n) = P(Z > n – 1) – P(Z > n) = (1 – s)^{n – 1} – (1 – s)^n = s (1 – s)^{n – 1}\). Donc \(Z \sim \mathcal{G}(p + r – pr)\) et \(E(Z) = \frac{1}{p + r – pr}\).
- On décompose selon la valeur commune : \(P(X = Y) = \sum_{k \geq\, 1} P(X = k) P(Y = k) = pr \sum_{k \geq\, 1} \big((1 – p)(1 – r)\big)^{k – 1}\). Donc \(P(X = Y) = \frac{pr}{p + r – pr}\).
- Ici \(p = r = \frac{1}{2}\), donc \(s = \frac{3}{4}\). Le nombre moyen de lancers simultanés vaut \(\frac{4}{3}\), et la probabilité d’un premier pile au même lancer vaut \(\frac{1/4}{3/4} = \frac{1}{3}\).
Corrigé de l’exercice 13 : Covariance nulle et indépendance
- Par symétrie, \(E(X) = 0\) et \(E(XY) = E(X^3) = 0\). Donc \(\operatorname{Cov}(X, Y) = 0\). Cependant, \(P(X = 0, Y = 1) = 0\), alors que \(P(X = 0) P(Y = 1) = \frac{1}{3} \cdot \frac{2}{3} = \frac{2}{9}\). La covariance est nulle, mais \(X\) et \(Y\) ne sont pas indépendantes.
- Le sens direct est dans le cours. Réciproquement, \(UV\) est l’indicatrice de \(\{U = 1, V = 1\}\). Donc \(\operatorname{Cov}(U, V) = P(U = 1, V = 1) – P(U = 1) P(V = 1)\). Si elle est nulle, la formule de produit vaut pour le couple \((1, 1)\). Ensuite, \(P(U = 1, V = 0) = P(U = 1) – P(U = 1, V = 1) = P(U = 1)\big(1 – P(V = 1)\big)\). On traite de même \((0, 1)\), puis \((0, 0)\) par complémentaire. Pour des variables de Bernoulli, indépendance et covariance nulle sont donc équivalentes.
- Par bilinéarité, \(\operatorname{Cov}(X, aX + b) = a V(X)\). De plus, \(\sigma(aX + b) = |a| \sigma(X)\). Donc \(\rho(X, aX + b) = \frac{a}{|a|}\), qui vaut \(1\) si \(a > 0\) et \(-1\) si \(a < 0\).
- Pour tout réel \(t\), \(V(Y – tX) = V(X) t^2 – 2 \operatorname{Cov}(X, Y) t + V(Y) \geq\, 0\). Si \(|\rho| = 1\), le discriminant réduit \(\operatorname{Cov}(X, Y)^2 – V(X)V(Y)\) est nul. Le trinôme admet donc une racine double \(t_0 = \frac{\operatorname{Cov}(X, Y)}{V(X)}\). Ainsi, \(V(Y – t_0 X) = 0\), et \(Y – t_0 X\) est presque sûrement égale à une constante \(b\). Donc \(Y = t_0 X + b\) presque sûrement.
Corrigé de l’exercice 14 : Somme de deux lois uniformes indépendantes
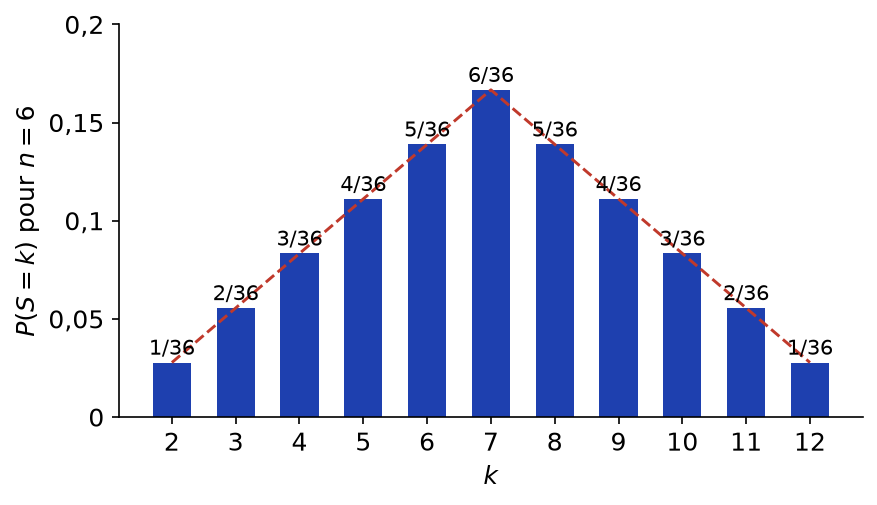
- La variable \(S\) prend ses valeurs dans \(\{2, \ldots, 2n\}\). Par indépendance, \(P(S = k) = \sum_i P(X = i) P(Y = k – i)\), où \(i\) vérifie \(1 \leq\, i \leq\, n\) et \(1 \leq\, k – i \leq\, n\). Chaque terme vaut \(\frac{1}{n^2}\). On compte donc les entiers \(i\) de \([\max(1, k – n), \min(n, k – 1)]\). Ainsi, \(P(S = k) = \frac{k – 1}{n^2}\) pour \(2 \leq\, k \leq\, n + 1\), et \(P(S = k) = \frac{2n + 1 – k}{n^2}\) pour \(n + 1 \leq\, k \leq\, 2n\). C’est une loi triangulaire, comme le montre la figure ci-dessous pour \(n = 6\).

- Par linéarité, \(E(S) = 2 \cdot \frac{n + 1}{2} = n + 1\). Par indépendance, les variances s’ajoutent. Donc \(E(S) = n + 1\) et \(V(S) = \frac{n^2 – 1}{6}\).
- La variable \(D\) prend les valeurs \(0\) à \(n – 1\). D’abord, \(P(D = 0) = P(X = Y) = \frac{n}{n^2} = \frac{1}{n}\). Ensuite, pour \(k \geq\, 1\), les couples tels que \(X – Y = k\) sont \((k + j, j)\) avec \(1 \leq\, j \leq\, n – k\). Il y en a \(n – k\), et autant pour \(Y – X = k\). Donc \(P(D = k) = \frac{2(n – k)}{n^2}\) pour \(1 \leq\, k \leq\, n – 1\). Enfin, \(\frac{1}{n} + \frac{2}{n^2} \cdot \frac{n(n – 1)}{2} = \frac{1}{n} + \frac{n – 1}{n} = 1\).
- Pour \(n = 6\), le maximum de \(P(S = k)\) est atteint en \(k = n + 1 = 7\). La somme la plus probable est \(7\), avec probabilité \(\frac{6}{36} = \frac{1}{6}\).
Corrigé de l’exercice 15 : Reconnaître une loi par sa fonction génératrice
- On écrit \(G(t) = \frac{t/3}{1 – \frac{2}{3} t}\). C’est la fonction génératrice de \(\mathcal{G}(1/3)\), et la fonction génératrice caractérise la loi. Ensuite, \(G^{\prime}(t) = \frac{3}{(3 – 2t)^2}\) et \(G^{\prime\prime}(t) = \frac{12}{(3 – 2t)^3}\). Le rayon vaut \(\frac{3}{2} > 1\), donc \(E(X) = G^{\prime}(1) = 3\) et \(G^{\prime\prime}(1) = 12\). Ainsi, \(X \sim \mathcal{G}(1/3)\), \(E(X) = 3\) et \(V(X) = 12 + 3 – 9 = 6\).
- On a \(G(t) = (\frac{2}{3} + \frac{1}{3} t)^4\). Donc \(X \sim \mathcal{B}(4, 1/3)\). Ensuite, \(G^{\prime}(t) = \frac{4}{3} (\frac{2 + t}{3})^3\) et \(G^{\prime\prime}(t) = \frac{4}{3} (\frac{2 + t}{3})^2\). Ainsi, \(G^{\prime}(1) = \frac{4}{3}\) et \(G^{\prime\prime}(1) = \frac{4}{3}\). Donc \(E(X) = \frac{4}{3}\) et \(V(X) = \frac{4}{3} + \frac{4}{3} – \frac{16}{9} = \frac{8}{9}\), conforme à \(npq\).
- On développe : \(e^{3(t^2 – 1)} = e^{-3} \sum_{k \geq\, 0} \frac{3^k}{k!} t^{2k}\). Par unicité des coefficients, \(X\) prend les valeurs paires, avec \(P(X = 2k) = e^{-3} \frac{3^k}{k!}\) : ainsi, \(X = 2Z\) avec \(Z \sim \mathcal{P}(3)\). Ensuite, \(G^{\prime}(t) = 6t\, G(t)\) et \(G^{\prime\prime}(t) = (6 + 36t^2) G(t)\). Donc \(G^{\prime}(1) = 6\) et \(G^{\prime\prime}(1) = 42\). Ainsi, \(E(X) = 6\) et \(V(X) = 42 + 6 – 36 = 12\), ce qui vaut bien \(4 V(Z)\).
- Par indépendance, la fonction génératrice de la somme est le produit. Elle vaut \(G(t) = (\frac{pt}{1 – qt})^r\). Notons \(G_1\) la fonction génératrice de \(\mathcal{G}(p)\). Alors \(G^{\prime}(1) = r G_1^{\prime}(1) = \frac{r}{p}\) et \(G^{\prime\prime}(1) = r(r – 1) G_1^{\prime}(1)^2 + r G_1^{\prime\prime}(1) = \frac{r(r – 1) + 2rq}{p^2}\). Donc
\[V = \frac{r(r – 1) + 2rq}{p^2} + \frac{r}{p} – \frac{r^2}{p^2} = \frac{r(2q + p – 1)}{p^2} = \frac{rq}{p^2}.\]
On obtient \(E = \frac{r}{p}\) et \(V = \frac{rq}{p^2}\), comme l’annoncent la linéarité et l’additivité des variances.
Corrigé de l’exercice 16 : Somme de variables de Poisson indépendantes
- Par indépendance, \(G_S(t) = G_X(t) G_Y(t) = e^{\lambda(t – 1)} e^{\mu(t – 1)} = e^{(\lambda + \mu)(t – 1)}\). On reconnaît la fonction génératrice de \(\mathcal{P}(\lambda + \mu)\). Par unicité, \(S \sim \mathcal{P}(\lambda + \mu)\).
- Pour \(n \in \mathbb{N}\), on décompose selon la valeur de \(X\) :
\[P(S = n) = \sum_{k = 0}^{n} e^{-\lambda} \frac{\lambda^k}{k!} e^{-\mu} \frac{\mu^{n – k}}{(n – k)!} = \frac{e^{-(\lambda + \mu)}}{n!} \sum_{k = 0}^{n} \binom\,{n}{k} \lambda^k \mu^{n – k}.\]
La formule du binôme donne \(P(S = n) = e^{-(\lambda + \mu)} \frac{(\lambda + \mu)^n}{n!}\). - Pour \(0 \leq\, k \leq\, n\), on a \(\{X = k, S = n\} = \{X = k, Y = n – k\}\). Donc
\[P(X = k \mid S = n) = \frac{e^{-\lambda} \frac{\lambda^k}{k!} \cdot e^{-\mu} \frac{\mu^{n – k}}{(n – k)!}}{e^{-(\lambda + \mu)} \frac{(\lambda + \mu)^n}{n!}} = \binom\,{n}{k} (\frac{\lambda}{\lambda + \mu})^k (\frac{\mu}{\lambda + \mu})^{n – k}.\]
Sachant \(S = n\), \(X\) suit la loi \(\mathcal{B}(n, \frac{\lambda}{\lambda + \mu})\). - Ici, \(\frac{\lambda}{\lambda + \mu} = 0{,}4\) et \(n = 5\). La probabilité cherchée vaut \(\binom\,{5}{2} (0{,}4)^2 (0{,}6)^3 = 10 \times 0{,}16 \times 0{,}216 = 0{,}3456\).
Corrigé de l’exercice 17 : Amincissement d’une loi de Poisson
- On a \(\{X = j, Y = k\} = \{N = j + k, X = j\}\). Donc, par la définition de la loi conditionnelle,
\[P(X = j, Y = k) = e^{-\lambda} \frac{\lambda^{j + k}}{(j + k)!} \binom\,{j + k}{j} p^j q^k = e^{-\lambda} \frac{(\lambda p)^j (\lambda q)^k}{j!\, k!}.\]
Comme \(e^{-\lambda} = e^{-\lambda p} e^{-\lambda q}\), on obtient \(P(X = j, Y = k) = e^{-\lambda p} \frac{(\lambda p)^j}{j!} \cdot e^{-\lambda q} \frac{(\lambda q)^k}{k!}\). - On somme sur \(k\) la série exponentielle : \(P(X = j) = e^{-\lambda p} \frac{(\lambda p)^j}{j!}\). De même pour \(Y\). Donc \(X \sim \mathcal{P}(\lambda p)\), \(Y \sim \mathcal{P}(\lambda q)\), et la loi conjointe est le produit des marginales : \(X\) et \(Y\) sont indépendantes. Ce résultat est remarquable, car \(X\) et \(Y\) dépendent toutes deux de \(N\).
- Pour \(|t| \leq\, 1\), la formule des probabilités totales donne \(P(X = j) = \sum_{n \geq\, j} P(N = n) \binom\,{n}{j} p^j q^{n – j}\). La famille double \((P(N = n) \binom\,{n}{j} p^j q^{n – j} t^j)_{j \leq\, n}\) est sommable, car sa somme en module est \(\sum_n P(N = n)(q + p|t|)^n \leq\, 1\). On somme donc d’abord en \(j\) par la formule du binôme : \(G_X(t) = \sum_n P(N = n) (q + pt)^n\). Donc \(G_X(t) = G_N(q + pt) = e^{\lambda(q + pt – 1)} = e^{\lambda p (t – 1)}\), qui est la fonction génératrice de \(\mathcal{P}(\lambda p)\).
- Par bilinéarité et indépendance de \(X\) et \(Y\), \(\operatorname{Cov}(X, N) = \operatorname{Cov}(X, X) + \operatorname{Cov}(X, Y) = V(X)\). Donc \(\operatorname{Cov}(X, N) = \lambda p\).
- On a \(X \sim \mathcal{P}(3)\). En moyenne, il y a \(3\) acheteurs, et \(P(X = 0) = e^{-3} \approx 0{,}050\).
Point de méthode : pour un couple défini en deux étapes, écrivez la loi conjointe comme produit « loi de la première étape × loi conditionnelle », puis cherchez une factorisation.
Corrigé de l’exercice 18 : Dés truqués et somme uniforme
- D’après l’exercice 14, \(P(S = 2) = \frac{1}{36}\) et \(P(S = 7) = \frac{1}{6}\). La loi de \(S\) n’est donc pas uniforme pour deux dés équilibrés.
- On a \(G_X(t) = \sum_{k = 1}^{6} P(X = k) t^k = t \sum_{k = 1}^{6} P(X = k) t^{k – 1}\). Donc \(G_X(t) = t P(t)\) avec \(P(t) = \sum_{j = 0}^{5} P(X = j + 1) t^j\), de degré au plus \(5\) ; de même pour \(Y\).
- Par indépendance, \(G_S = G_X G_Y = t^2 P Q\). Si \(S\) est uniforme, \(G_S(t) = \frac{1}{11} \sum_{k = 2}^{12} t^k = \frac{t^2}{11} \sum_{k = 0}^{10} t^k\). Pour \(t \neq 0\), on simplifie par \(t^2\). Deux polynômes égaux en une infinité de points sont égaux. Donc \(P Q = \frac{1}{11} \sum_{k = 0}^{10} t^k\). Ce polynôme est de degré \(10\). Or \(\deg P \leq\, 5\), \(\deg Q \leq\, 5\) et \(\deg(PQ) = \deg P + \deg Q\). Donc \(\deg P = \deg Q = 5\).
- Pour \(t \neq 1\), \(\sum_{k = 0}^{10} t^k = \frac{t^{11} – 1}{t – 1}\), qui ne s’annule que si \(t^{11} = 1\), c’est-à-dire \(t = 1\) sur \(\mathbb{R}\). Or ce cas est exclu, et la somme vaut \(11\) en \(t = 1\). Donc ce polynôme n’a pas de racine réelle. En revanche, \(P\) est un polynôme réel de degré impair. Ses limites en \(\pm\infty\) sont infinies et de signes opposés. D’après le théorème des valeurs intermédiaires, \(P\) a une racine réelle \(t_0\). Alors \(t_0\) annule \(PQ\), ce qui est absurde. Aucun truquage ne rend la somme uniforme sur \(\{2, \ldots, 12\}\).
Corrigé de l’exercice 19 : Inégalité de Markov et qualité de la majoration
- On a \(P(X \geq\, 10) = P(X > 9) = (\frac{1}{2})^9\). Donc \(P(X \geq\, 10) = \frac{1}{512} \approx 0{,}00195\).
- D’abord, \(E(X) = 2\). Markov donne \(P(X \geq\, 10) \leq\, \frac{2}{10} = 0{,}2\). Ensuite, \(E(X^2) = V(X) + E(X)^2 = 2 + 4 = 6\). Or \(\{X \geq\, 10\} = \{X^2 \geq\, 100\}\), car \(X \geq\, 0\). Les deux majorations valent donc \(0{,}2\) et \(0{,}06\).
- Si \(X \geq\, 10\), alors \(|X – 2| \geq\, 8\). Par Bienaymé-Tchebychev, \(P(X \geq\, 10) \leq\, \frac{V(X)}{64}\). Donc \(P(X \geq\, 10) \leq\, \frac{2}{64} = \frac{1}{32} \approx 0{,}031\).
- Avec \(a = 1{,}8\), on a \(aq = 0{,}9 < 1\). D’après l’exercice 8, \(E(a^X) = \frac{0{,}9}{1 – 0{,}9} = 9\). Ensuite, \(t \mapsto a^t\) est croissante, donc \(\{X \geq\, 10\} = \{a^X \geq\, a^{10}\}\). Markov donne \(P(X \geq\, 10) \leq\, \frac{9}{1{,}8^{10}} \approx \frac{9}{357{,}0}\). Cette majoration vaut environ \(0{,}025\) : c’est la meilleure des quatre, mais elle reste treize fois trop grande.
- Soit \(\theta \in \,]0, 1]\) et \(X\) valant \(a\) avec probabilité \(\theta\) et \(0\) sinon. Alors \(E(X) = a\theta\) et \(P(X \geq\, a) = \theta\). Ainsi, \(P(X \geq\, a) = \frac{E(X)}{a}\) : l’inégalité de Markov ne peut pas être améliorée en général.
Point de méthode : plus la fonction croissante \(\varphi\) appliquée avant Markov croît vite, plus la majoration de \(P(X \geq\, a)\) par \(E(\varphi(X)) / \varphi(a)\) est fine, à condition que \(E(\varphi(X))\) soit finie.
Corrigé de l’exercice 20 : Bienaymé-Tchebychev et nombre de lancers
- On a \(F_n = \frac{S_n}{n}\), où \(S_n \sim \mathcal{B}(n, 1/2)\) compte les piles. Donc \(E(F_n) = \frac{1}{2}\) et \(V(F_n) = \frac{1}{n^2} \cdot \frac{n}{4} = \frac{1}{4n}\).
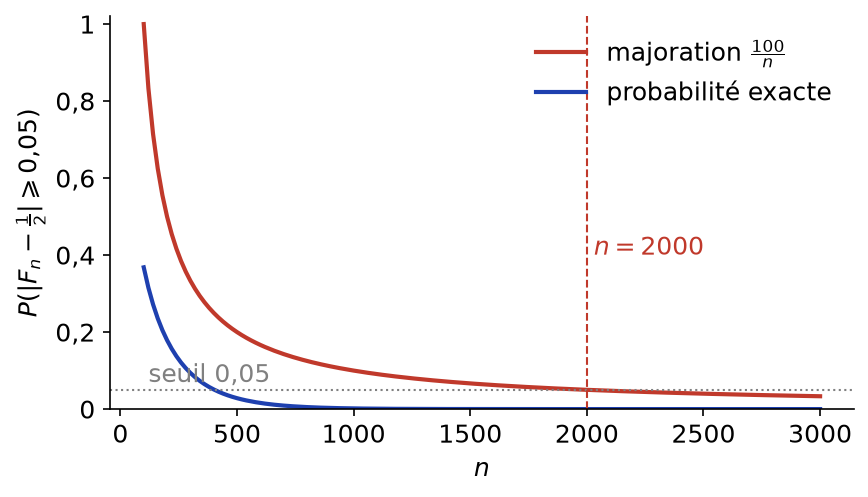
- L’inégalité de Bienaymé-Tchebychev donne \(P\big(|F_n – \frac{1}{2}| \geq\, 0{,}05\big) \leq\, \frac{1}{4n \times 0{,}0025}\). Cette borne vaut \(\frac{100}{n}\).
- On veut \(P\big(|F_n – \frac{1}{2}| \geq\, 0{,}05\big) \leq\, 0{,}05\). Il suffit que \(\frac{100}{n} \leq\, 0{,}05\). Donc \(n = 2000\) lancers suffisent. Comme le montre la figure ci-dessous, la probabilité exacte passe sous \(0{,}05\) bien plus tôt, vers \(n = 400\). La borne est sûre, mais pessimiste.

- Soit \(F_n\) la fréquence observée. Alors \(E(F_n) = p\) et \(V(F_n) = \frac{p(1 – p)}{n} \leq\, \frac{1}{4n}\), car \(p(1 – p) \leq\, \frac{1}{4}\). Ainsi, \(P(|F_n – p| \geq\, 0{,}02) \leq\, \frac{1}{4n \times 0{,}0004} = \frac{625}{n}\). Pour \(n = 12\,500\), la borne vaut \(0{,}05\). Donc l’erreur est inférieure à \(0{,}02\) avec probabilité au moins \(0{,}95\), quel que soit \(p\).
Corrigé de l’exercice 21 : Une loi faible des grands nombres sans indépendance
- La variable \(Y_k\) prend les valeurs \(0\) et \(1\), et \(P(Y_k = 1) = P(X_k = 1) P(X_{k + 1} = 1) = p^2\) par indépendance. Donc \(Y_k \sim \mathcal{B}(p^2)\), \(E(Y_k) = p^2\) et \(V(Y_k) = p^2(1 – p^2)\).
- On a \(Y_k Y_{k + 1} = X_k X_{k + 1}^2 X_{k + 2} = X_k X_{k + 1} X_{k + 2}\), car \(X_{k + 1}^2 = X_{k + 1}\). Donc \(E(Y_k Y_{k + 1}) = p^3\). Ainsi, \(\operatorname{Cov}(Y_k, Y_{k + 1}) = p^3 – p^4\). Si \(l \geq\, k + 2\), \(Y_k\) est fonction de \((X_k, X_{k + 1})\) et \(Y_l\) de \((X_l, X_{l + 1})\). Ces deux vecteurs portent sur des indices disjoints. D’après le lemme des coalitions, \(Y_k\) et \(Y_l\) sont indépendantes. Donc leur covariance est nulle.
- Comme \(p \in \,]0, 1[\), on a \(p^3 – p^4 = p^3(1 – p) \neq 0\). Les variables \(Y_k\) et \(Y_{k + 1}\) ne sont donc pas indépendantes. Dans la formule de la variance d’une somme, seuls les \(n – 1\) couples \((k, k + 1)\) contribuent. Donc
\[V(S_n) = n p^2 (1 – p^2) + 2(n – 1)(p^3 – p^4).\]
En particulier, \(V(S_n) \leq\, C n\), avec \(C = p^2(1 – p^2) + 2p^3(1 – p)\). - Par linéarité, \(E(\frac{S_n}{n}) = p^2\). L’inégalité de Bienaymé-Tchebychev donne
\[P(|\frac{S_n}{n} – p^2| \geq\, \varepsilon) \leq\, \frac{V(S_n)}{n^2 \varepsilon^2} \leq\, \frac{C}{n \varepsilon^2}.\]
Cette borne tend vers \(0\) : la fréquence des doubles succès converge en probabilité vers \(p^2\).
Point de méthode : la loi faible des grands nombres ne demande pas l’indépendance, mais seulement \(V(S_n) = o(n^2)\) ; il suffit de contrôler les covariances.
Corrigé de l’exercice 22 : Problème, le collectionneur de vignettes
- Après avoir obtenu \(k – 1\) vignettes distinctes, chaque paquet apporte une vignette nouvelle avec probabilité \(\frac{N – k + 1}{N}\), indépendamment des autres paquets. Donc \(T_k\) est le rang du premier succès dans une suite d’épreuves de Bernoulli indépendantes. Ainsi, \(T_k \sim \mathcal{G}(\frac{N – k + 1}{N})\). De plus, les durées successives s’enchaînent sans recouvrement jusqu’à la \(N\)-ième vignette. Donc \(T = T_1 + \cdots + T_N\).
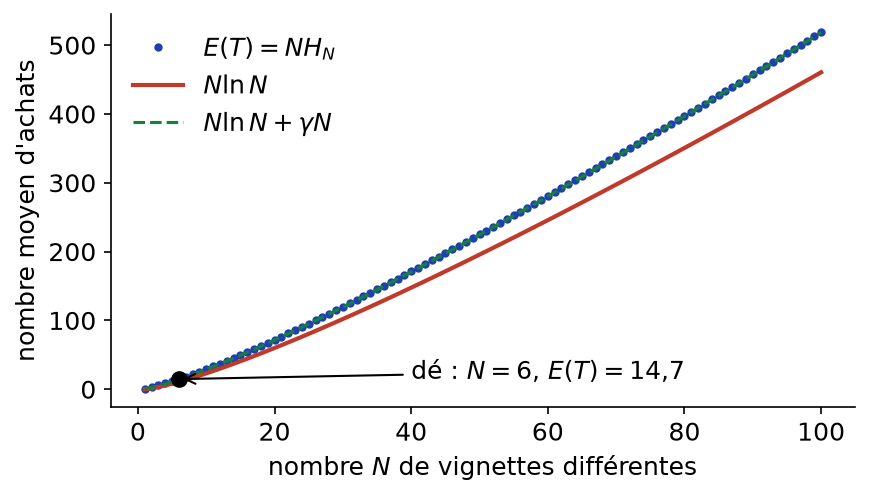
- Par linéarité, \(E(T) = \sum_{k = 1}^{N} \frac{N}{N – k + 1}\). On pose \(j = N – k + 1\), qui parcourt \(\{1, \ldots, N\}\). Donc \(E(T) = N \sum_{j = 1}^{N} \frac{1}{j} = N H_N\).
- D’après l’exercice 5, \(V(T_k) = \frac{1 – p_k}{p_k^2}\) avec \(p_k = \frac{N – k + 1}{N}\). Donc \(V(T_k) = \frac{k – 1}{N} \cdot \frac{N^2}{(N – k + 1)^2} = \frac{N(k – 1)}{(N – k + 1)^2}\). Comme \(k – 1 \leq\, N\), on a \(V(T_k) \leq\, \frac{N^2}{(N – k + 1)^2}\). Par indépendance, les variances s’ajoutent :
\[V(T) \leq\, N^2 \sum_{j = 1}^{N} \frac{1}{j^2} \leq\, \frac{\pi^2}{6} N^2.\]
La majoration demandée est établie. - Pour \(N = 6\), \(E(T) = 6(1 + \frac{1}{2} + \frac{1}{3} + \frac{1}{4} + \frac{1}{5} + \frac{1}{6}) = 6 \times \frac{49}{20} = 14{,}7\). Ensuite, \(V(T) = \sum_{k = 1}^{6} \frac{6(k – 1)}{(7 – k)^2} = 0 + \frac{6}{25} + \frac{12}{16} + \frac{18}{9} + \frac{24}{4} + \frac{30}{1}\). Donc \(E(T) = 14{,}7\) et \(V(T) = 38{,}99\), soit un écart type d’environ \(6{,}24\).
- La fonction \(t \mapsto \frac{1}{t}\) est décroissante sur \(]0, +\infty[\). Pour \(j \geq\, 1\), \(\frac{1}{j} \geq\, \int_j^{j + 1} \frac{dt}{t}\). En sommant, \(H_N \geq\, \ln(N + 1)\). Pour \(j \geq\, 2\), \(\frac{1}{j} \leq\, \int_{j – 1}^{j} \frac{dt}{t}\). En sommant de \(2\) à \(N\), puis en ajoutant \(1\), on obtient \(\ln(N + 1) \leq\, H_N \leq\, 1 + \ln N\).
- Posons \(R_N = \frac{T}{N \ln N}\). Alors \(E(R_N) = \frac{H_N}{\ln N}\), et la question 5 donne \(1 \leq\, E(R_N) \leq\, 1 + \frac{1}{\ln N}\). De plus, \(V(R_N) \leq\, \frac{\pi^2}{6 \ln^2 N}\). Pour \(N\) assez grand, \(\frac{1}{\ln N} < \frac{\varepsilon}{2}\). Alors \(|R_N – 1| \geq\, \varepsilon\) entraîne \(|R_N – E(R_N)| \geq\, \frac{\varepsilon}{2}\). D’après Bienaymé-Tchebychev,
\[P(|R_N – 1| \geq\, \varepsilon) \leq\, \frac{4 V(R_N)}{\varepsilon^2} \leq\, \frac{2\pi^2}{3 \varepsilon^2 \ln^2 N}.\]
Cette borne tend vers \(0\) : \(\frac{T}{N \ln N}\) converge en probabilité vers \(1\). La figure ci-dessous compare \(N H_N\) et \(N \ln N\).
- L’événement \(\{T > n\}\) signifie qu’une vignette au moins manque après \(n\) achats. C’est la réunion des événements \(B_i\) : « la vignette \(i\) n’apparaît pas dans les \(n\) premiers paquets ». Par indépendance des paquets, \(P(B_i) = (1 – \frac{1}{N})^n\). La sous-additivité donne alors \(P(T > n) \leq\, N (1 – \frac{1}{N})^n\). Pour le dé, \(6 \times (\frac{5}{6})^{30} \approx 6 \times 0{,}00421\). La probabilité qu’il faille plus de \(30\) lancers est donc inférieure à \(0{,}026\).
Point de méthode : décomposer un temps d’attente en étapes géométriques indépendantes donne l’espérance par linéarité et la concentration par Bienaymé-Tchebychev.
Revenir aux énoncés des exercices
Pour aller plus loin en L2
- Le cours : variables aléatoires discrètes, cours de maths en L2
- Les énoncés : exercices de maths en L2 sur variables aléatoires discrètes
- À maîtriser avant : Espaces probabilisés et conditionnement, Séries numériques à termes positifs
- Chapitre précédent : Espaces probabilisés et conditionnement
- Chapitre suivant : Suites et séries de fonctions
- Le même thème en maths spé : variables aléatoires discrètes, exercices de maths spé
- Tester vos connaissances : QCM de maths en L2 par chapitre
- Le sommaire : tous les chapitres de maths de L2 et la licence de maths de L1 à L3