Ce cours sur les espaces euclidiens L2 construit la géométrie à partir d’une seule donnée : le produit scalaire. Vous y verrez comment définir norme, angle et orthogonalité sans repère, avec des énoncés valables aussi pour les matrices et les espaces de fonctions.
Le chapitre se place au second semestre, après l’algèbre linéaire du premier. Il démontre l’inégalité de Cauchy-Schwarz, le théorème de Pythagore et le procédé de Gram-Schmidt. Ensuite, il étudie le supplémentaire orthogonal et la projection orthogonale, qui donne la distance à un sous-espace. Enfin, il présente les espaces hermitiens et la méthode des moindres carrés.
Ces outils servent directement dans la suite. En effet, le théorème spectral, les formes quadratiques et les séries de Fourier reposent tous sur eux, de même que l’ajustement de données en statistique.
Pour vous entraîner ensuite, travaillez les exercices de maths en L2 sur espaces euclidiens.
I. Produit scalaire et espaces euclidiens
Dans tout le chapitre, \(E\) désigne un espace vectoriel réel. L’objectif est de définir longueurs, angles et orthogonalité à partir d’une seule donnée algébrique. Ainsi, la géométrie ne dépend plus d’un repère choisi à l’avance. De plus, les mêmes énoncés s’appliqueront à \(\mathbb{R}^n\), aux matrices et aux espaces de fonctions.
1. Formes bilinéaires symétriques
Une forme bilinéaire sur \(E\) est une application \(\varphi : E \times E \to \mathbb{R}\) linéaire par rapport à chacune de ses variables. Elle est symétrique si \(\varphi(x,y) = \varphi(y,x)\) pour tous \(x, y \in E\).
Elle est positive si \(\varphi(x,x) \geq\, 0\) pour tout \(x\), et définie si \(\varphi(x,x) = 0\) entraîne \(x = 0\).
En dimension finie, une forme bilinéaire se code par une matrice. Soit en effet \(\mathcal{B} = (e_1, \ldots, e_n)\) une base de \(E\). On pose \(A = (\varphi(e_i, e_j))_{i,j}\). Alors, pour \(x\) et \(y\) de colonnes de coordonnées \(X\) et \(Y\), on a \(\varphi(x,y) = X^{T} A Y\). Par conséquent, \(\varphi\) est symétrique si et seulement si \(A\) est symétrique.
Un produit scalaire sur \(E\) est une forme bilinéaire symétrique, définie et positive. On le note souvent \(\langle x, y \rangle\).
Un espace réel muni d’un produit scalaire est un espace préhilbertien réel. S’il est de dimension finie, on parle d’espace euclidien.
Pour montrer que \(\varphi\) est un produit scalaire, vérifiez dans cet ordre :
- la symétrie \(\varphi(y,x) = \varphi(x,y)\) ;
- la linéarité par rapport à une seule variable (la symétrie donne l’autre) ;
- la positivité \(\varphi(x,x) \geq\, 0\) ;
- le caractère défini : si \(\varphi(x,x) = 0\), alors \(x = 0\).
Pour la positivité en dimension finie, écrivez \(\varphi(x,x)\) comme une somme de carrés. Pour une intégrale, utilisez qu’une fonction continue, positive et d’intégrale nulle est nulle.
2. Exemples fondamentaux
Sur \(\mathbb{R}^n\), le produit scalaire canonique est \(\langle x, y \rangle = \sum_{i=1}^{n} x_i y_i\). Il est défini, car \(\sum x_i^2 = 0\) impose que tous les \(x_i\) soient nuls.
Sur \(\mathcal{M}_n(\mathbb{R})\), la formule \(\langle A, B \rangle = \operatorname{tr}(A^{T} B) = \sum_{i,j} a_{ij} b_{ij}\) définit aussi un produit scalaire.
Sur \(E = C([a,b], \mathbb{R})\) avec \(a < b\), on pose \(\langle f, g \rangle = \int_a^b f(t) g(t) \, dt\). La symétrie et la bilinéarité viennent de la linéarité de l’intégrale. Ensuite, \(\langle f, f \rangle = \int_a^b f^2 \geq\, 0\). Enfin, si cette intégrale est nulle, la fonction continue et positive \(f^2\) est nulle, donc \(f = 0\).
La continuité est indispensable dans le dernier exemple. Sur l’espace des fonctions continues par morceaux, une fonction nulle sauf en un point a une intégrale de carré nulle. Autrement dit, la forme y est seulement positive, et non définie.
II. Norme euclidienne et inégalité de Cauchy-Schwarz
La norme euclidienne associée au produit scalaire est \(\|x\| = \sqrt{\langle x, x \rangle}\). La distance associée est \(d(x,y) = \|x – y\|\).
En développant par bilinéarité, on obtient l’identité \(\|x + y\|^2 = \|x\|^2 + 2 \langle x, y \rangle + \|y\|^2\). Cette égalité est le point de départ de presque tous les calculs du chapitre.
Inégalité de Cauchy-Schwarz. Pour tous \(x, y \in E\), on a \(|\langle x, y \rangle| \leq\, \|x\| \, \|y\|\).
De plus, il y a égalité si et seulement si \(x\) et \(y\) sont colinéaires.
Si \(x = 0\), les deux membres sont nuls. Supposons donc \(x \neq 0\). Pour tout réel \(t\), on a
\[ 0 \leq\, \|t x + y\|^2 = t^2 \|x\|^2 + 2 t \langle x, y \rangle + \|y\|^2 . \]
Ce trinôme en \(t\) garde un signe constant. Son discriminant est donc négatif ou nul : \(4 \langle x, y \rangle^2 – 4 \|x\|^2 \|y\|^2 \leq\, 0\). C’est exactement l’inégalité annoncée.
En cas d’égalité, le discriminant est nul. Le trinôme admet alors une racine \(t_0\), d’où \(\|t_0 x + y\| = 0\). Par conséquent, \(y = -t_0 x\), et les vecteurs sont colinéaires. La réciproque est immédiate.
La figure ci-dessous donne le sens géométrique de l’inégalité. Le vecteur \(y\) se décompose en une composante le long de \(x\) et une composante orthogonale. Le produit scalaire ne « voit » que la première, dont la longueur est au plus \(\|y\|\).
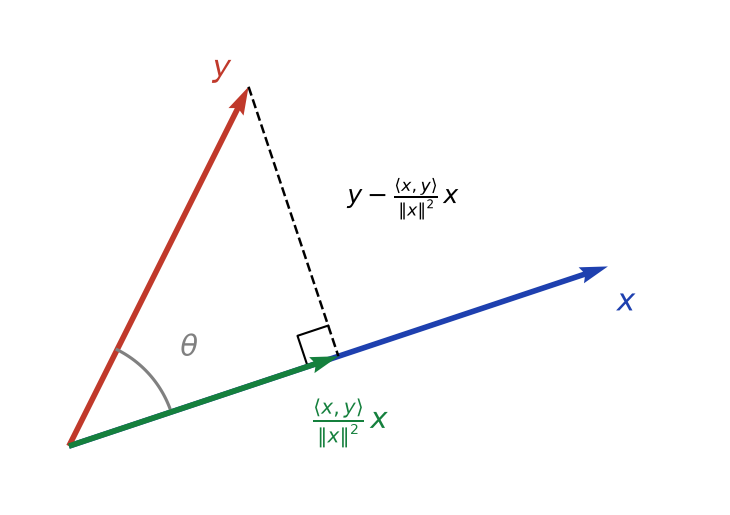
Ainsi, lorsque \(x\) et \(y\) sont non nuls, le quotient \(\frac{\langle x, y \rangle}{\|x\| \|y\|}\) appartient à \([-1, 1]\). On définit donc l’angle non orienté \(\theta \in [0, \pi]\) par \(\cos \theta = \frac{\langle x, y \rangle}{\|x\| \|y\|}\).
L’application \(x \mapsto \|x\|\) est une norme. En particulier, elle vérifie l’inégalité triangulaire \(\|x + y\| \leq\, \|x\| + \|y\|\).
La séparation et l’homogénéité sont immédiates. Pour l’inégalité triangulaire, on utilise Cauchy-Schwarz :
\[ \|x + y\|^2 = \|x\|^2 + 2 \langle x, y \rangle + \|y\|^2 \leq\, \|x\|^2 + 2 \|x\| \|y\| + \|y\|^2 = (\|x\| + \|y\|)^2 . \]
Il suffit ensuite de prendre la racine carrée.
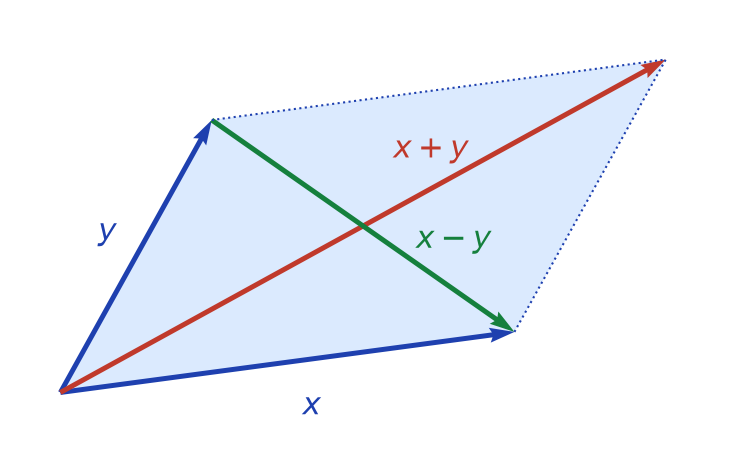
Identité du parallélogramme : \(\|x + y\|^2 + \|x – y\|^2 = 2 ( \|x\|^2 + \|y\|^2 )\).
Identité de polarisation : \(\langle x, y \rangle = \frac{1}{4} ( \|x + y\|^2 – \|x – y\|^2 )\).
Ces deux formules s’obtiennent en ajoutant, puis en retranchant, les développements de \(\|x + y\|^2\) et \(\|x – y\|^2\). Comme le montre la figure ci-dessous, la première relie les diagonales d’un parallélogramme à ses côtés.
La polarisation montre que la norme détermine le produit scalaire. En revanche, une norme qui ne vérifie pas l’identité du parallélogramme ne provient d’aucun produit scalaire. C’est le cas de \(\|x\|_\infty = \max |x_i|\) sur \(\mathbb{R}^2\).
III. Orthogonalité et bases orthonormées
1. Vecteurs orthogonaux et théorème de Pythagore
Deux vecteurs \(x\) et \(y\) sont orthogonaux si \(\langle x, y \rangle = 0\). Une famille \((x_i)\) est orthogonale si ses vecteurs sont deux à deux orthogonaux. Elle est orthonormée si, de plus, chaque vecteur est de norme 1.
Théorème de Pythagore. Deux vecteurs \(x\) et \(y\) sont orthogonaux si et seulement si \(\|x + y\|^2 = \|x\|^2 + \|y\|^2\).
Plus généralement, si \((x_1, \ldots, x_p)\) est orthogonale, alors \(\| \sum x_i \|^2 = \sum \|x_i\|^2\).
La réciproque est fausse pour trois vecteurs ou plus. Par exemple, dans \(\mathbb{R}^2\), prenez \(x_1 = (1,0)\), \(x_2 = (0,1)\), \(x_3 = (1,-1)\) : ici \(\|x_1 + x_2 + x_3\|^2 = 4 = 1 + 1 + 2\), alors que \(x_1\) et \(x_3\) ne sont pas orthogonaux.
Une famille orthogonale de vecteurs non nuls est libre.
Supposons \(\sum \lambda_i x_i = 0\). Faisons le produit scalaire avec \(x_j\). Tous les termes d’indice \(i \neq j\) disparaissent, d’où \(\lambda_j \|x_j\|^2 = 0\). Comme \(x_j \neq 0\), on obtient \(\lambda_j = 0\).
2. Calculs dans une base orthonormée
Soit \((e_1, \ldots, e_n)\) une base orthonormée de l’espace euclidien \(E\). Pour tous \(x, y \in E\) :
\[ x = \sum_{i=1}^{n} \langle e_i, x \rangle e_i, \qquad \langle x, y \rangle = \sum_{i=1}^{n} x_i y_i, \qquad \|x\|^2 = \sum_{i=1}^{n} x_i^2 , \]
où \(x_i = \langle e_i, x \rangle\) et \(y_i = \langle e_i, y \rangle\) sont les coordonnées.
Autrement dit, dans une base orthonormée, tout produit scalaire se calcule comme le produit scalaire canonique. Les coordonnées s’obtiennent sans résoudre de système : un produit scalaire suffit.
Dans \(\mathbb{R}^2\) canonique, \(e_1 = \frac{1}{\sqrt{2}}(1,1)\) et \(e_2 = \frac{1}{\sqrt{2}}(1,-1)\) forment une base orthonormée. Pour \(x = (3,1)\), on trouve \(\langle e_1, x \rangle = 2\sqrt{2}\) et \(\langle e_2, x \rangle = \sqrt{2}\). Donc \(x = 2\sqrt{2}\, e_1 + \sqrt{2}\, e_2\). On vérifie enfin que \(8 + 2 = 10 = \|x\|^2\).
IV. Procédé d’orthonormalisation de Gram-Schmidt
Tout espace euclidien possède-t-il une base orthonormée ? La réponse est oui, et la preuve est constructive. En effet, le procédé de Gram-Schmidt transforme une famille libre quelconque en famille orthonormée, étape par étape.
Soit \((v_1, \ldots, v_p)\) une famille libre de \(E\). Il existe une unique famille orthonormée \((e_1, \ldots, e_p)\) telle que, pour tout \(k\) :
- \(\operatorname{Vect}(e_1, \ldots, e_k) = \operatorname{Vect}(v_1, \ldots, v_k)\) ;
- \(\langle e_k, v_k \rangle > 0\).
On raisonne par récurrence sur \(k\). D’abord, \(e_1 = v_1 / \|v_1\|\) convient, et c’est le seul choix possible.
Supposons ensuite \(e_1, \ldots, e_{k-1}\) construits. On pose
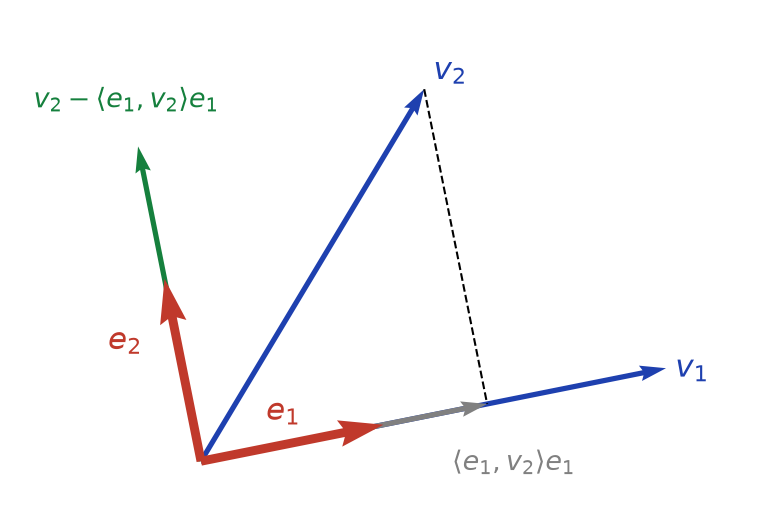
\[ w_k = v_k – \sum_{i=1}^{k-1} \langle e_i, v_k \rangle e_i . \]
Pour \(j < k\), on a \(\langle e_j, w_k \rangle = \langle e_j, v_k \rangle – \langle e_j, v_k \rangle = 0\). De plus, \(w_k \neq 0\) : sinon \(v_k\) appartiendrait à \(\operatorname{Vect}(v_1, \ldots, v_{k-1})\), ce que la liberté interdit. On pose alors \(e_k = w_k / \|w_k\|\). Enfin, \(\langle e_k, v_k \rangle = \langle e_k, w_k \rangle = \|w_k\| > 0\).
Pour l’unicité, \(e_k\) est un vecteur unitaire de \(\operatorname{Vect}(v_1, \ldots, v_k)\) orthogonal à \(\operatorname{Vect}(v_1, \ldots, v_{k-1})\), qui est un hyperplan de cet espace. Il n’y a que deux tels vecteurs, opposés, et la condition de signe en choisit un.
La figure ci-dessous illustre la deuxième étape. On retire de \(v_2\) sa composante le long de \(e_1\), puis on normalise le reste.
Pour orthonormaliser \((v_1, \ldots, v_p)\) :
- calculez \(e_1 = v_1 / \|v_1\|\) ;
- pour \(k \geq\, 2\), calculez les produits \(\langle e_i, v_k \rangle\) pour \(i < k\), puis \(w_k\), puis \(e_k = w_k / \|w_k\|\) ;
- vérifiez à la fin que les \(e_k\) sont deux à deux orthogonaux.
Pour éviter les racines carrées, vous pouvez d’abord construire une famille seulement orthogonale, puis normaliser tout à la fin.
Tout espace euclidien admet une base orthonormée. De plus, toute famille orthonormée se complète en une base orthonormée.
Sur \(\mathbb{R}_1[X]\), on pose \(\langle P, Q \rangle = \int_0^1 P(t) Q(t) \, dt\). On part de \((1, X)\). D’abord, \(\|1\| = 1\), donc \(e_1 = 1\). Ensuite, \(\langle 1, X \rangle = \frac{1}{2}\), d’où \(w_2 = X – \frac{1}{2}\).
On calcule \(\|w_2\|^2 = \int_0^1 (t – \frac{1}{2})^2 dt = \frac{1}{12}\). Finalement, \(e_2 = 2\sqrt{3} ( X – \frac{1}{2} )\).
V. Orthogonal d’un sous-espace et projection orthogonale
1. Orthogonal d’une partie
L’orthogonal d’une partie \(A\) de \(E\) est \(A^{\perp} = \{ x \in E : \langle x, a \rangle = 0 \text{ pour tout } a \in A \}\). C’est toujours un sous-espace vectoriel de \(E\).
Pour tout sous-espace \(F\), on a \(F \cap F^{\perp} = \{0\}\) et \(F \subset (F^{\perp})^{\perp}\). De plus, si \(F = \operatorname{Vect}(f_1, \ldots, f_p)\), alors \(x \in F^{\perp}\) si et seulement si \(\langle x, f_i \rangle = 0\) pour tout \(i\).
En effet, un vecteur de \(F \cap F^{\perp}\) est orthogonal à lui-même, donc nul. Ainsi, \(F\) et \(F^{\perp}\) sont toujours en somme directe. La question est de savoir si cette somme vaut \(E\) tout entier.
Si \(F\) est un sous-espace de dimension finie de l’espace préhilbertien \(E\), alors \(E = F \oplus F^{\perp}\). On dit que \(F^{\perp}\) est le supplémentaire orthogonal de \(F\).
Si de plus \(E\) est euclidien, alors \(\dim F^{\perp} = \dim E – \dim F\) et \((F^{\perp})^{\perp} = F\).
Soit \((e_1, \ldots, e_p)\) une base orthonormée de \(F\), fournie par Gram-Schmidt. Pour \(x \in E\), posons \(p = \sum \langle e_i, x \rangle e_i \in F\). Alors \(\langle e_j, x – p \rangle = \langle e_j, x \rangle – \langle e_j, x \rangle = 0\) pour tout \(j\). Donc \(x – p \in F^{\perp}\), et \(x = p + (x – p)\).
La somme est donc égale à \(E\), et elle est directe. En dimension finie, la formule des dimensions en découle. Enfin, \(F \subset (F^{\perp})^{\perp}\) et ces deux espaces ont la même dimension.
En dimension infinie, un sous-espace de dimension infinie peut avoir un orthogonal réduit à \(\{0\}\). Par exemple, dans \(C([0,1])\) muni du produit scalaire intégral, les fonctions nulles en 0 forment un tel sous-espace. Dans ce cas, \(F \oplus F^{\perp} \neq E\).
2. Projection orthogonale
Soit \(F\) de dimension finie. La projection orthogonale sur \(F\) est la projection \(p_F\) sur \(F\) parallèlement à \(F^{\perp}\). Si \((e_1, \ldots, e_p)\) est une base orthonormée de \(F\), alors
\[ p_F(x) = \sum_{i=1}^{p} \langle e_i, x \rangle e_i . \]
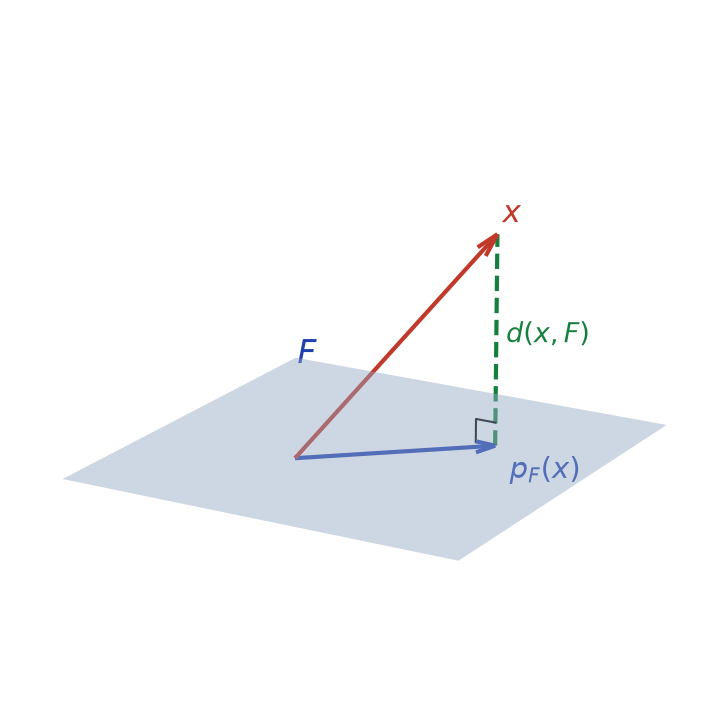
Le vecteur \(p_F(x)\) est caractérisé par deux conditions : \(p_F(x) \in F\) et \(x – p_F(x) \in F^{\perp}\). Ces conditions permettent de le calculer même sans base orthonormée.
Meilleure approximation. Soit \(F\) de dimension finie et \(x \in E\). Alors \(p_F(x)\) est l’unique vecteur de \(F\) le plus proche de \(x\) :
\[ d(x, F) = \inf_{y \in F} \|x – y\| = \|x – p_F(x)\| , \qquad d(x,F)^2 = \|x\|^2 – \|p_F(x)\|^2 . \]
Soit \(y \in F\). Le vecteur \(p_F(x) – y\) appartient à \(F\), tandis que \(x – p_F(x)\) appartient à \(F^{\perp}\). Par le théorème de Pythagore,
\[ \|x – y\|^2 = \|x – p_F(x)\|^2 + \|p_F(x) – y\|^2 \geq\, \|x – p_F(x)\|^2 . \]
L’égalité a lieu si et seulement si \(y = p_F(x)\). La seconde formule vient de Pythagore appliqué à \(x = p_F(x) + (x – p_F(x))\).
La figure ci-dessous représente cette situation dans l’espace. Le segment vert, perpendiculaire au plan \(F\), réalise la distance de \(x\) à \(F\).
Pour calculer \(p_F(x)\) et \(d(x,F)\) :
- si vous disposez d’une base orthonormée de \(F\), appliquez directement la formule de projection ;
- sinon, écrivez \(p_F(x) = \sum \lambda_i f_i\) et imposez \(\langle x – p_F(x), f_j \rangle = 0\) pour tout \(j\) : vous obtenez un système linéaire ;
- si \(F^{\perp}\) est plus petit que \(F\), projetez sur \(F^{\perp}\), puis utilisez \(p_F(x) = x – p_{F^{\perp}}(x)\).
Par exemple, pour un hyperplan \(H = n^{\perp}\) avec \(n \neq 0\), on obtient \(d(x, H) = \frac{|\langle n, x \rangle|}{\|n\|}\).
Inégalité de Bessel. Si \((e_1, \ldots, e_p)\) est orthonormée, alors pour tout \(x\), on a \(\sum_{i=1}^{p} \langle e_i, x \rangle^2 \leq\, \|x\|^2\).
En effet, le membre de gauche vaut \(\|p_F(x)\|^2\), avec \(F = \operatorname{Vect}(e_1, \ldots, e_p)\). Cette inégalité jouera un rôle central dans l’étude des séries de Fourier.
Dans \(\mathbb{R}^3\), soit \(D = \operatorname{Vect}(u)\) avec \(u = (1,1,1)\). Pour \(x = (1,2,6)\), on a \(\langle u, x \rangle = 9\) et \(\|u\|^2 = 3\). Donc \(p_D(x) = 3u = (3,3,3)\). La distance de \(x\) à \(D\) vaut \(\|(-2,-1,3)\| = \sqrt{14}\).
VI. Espaces préhilbertiens complexes et hermitiens
Sur un espace complexe, la formule \(\sum x_i y_i\) ne convient pas. En effet, \(x_1^2\) peut être négatif, par exemple pour \(x_1 = i\). On corrige ce défaut en conjuguant l’une des variables.
Soit \(E\) un espace vectoriel complexe. Un produit scalaire hermitien est une application \(\langle \cdot, \cdot \rangle : E \times E \to \mathbb{C}\) telle que :
- elle est linéaire par rapport à la seconde variable ;
- elle est à symétrie hermitienne : \(\langle y, x \rangle = \overline{\langle x, y \rangle}\) ;
- elle est définie positive : \(\langle x, x \rangle \in \mathbb{R}_+\), et \(\langle x, x \rangle = 0\) seulement pour \(x = 0\).
On dit alors que \(E\) est préhilbertien complexe. En dimension finie, \(E\) est un espace hermitien.
Avec cette convention, la forme est semi-linéaire à gauche : \(\langle \lambda x, y \rangle = \overline{\lambda} \langle x, y \rangle\). Certains cours adoptent la convention inverse. Vérifiez toujours laquelle est utilisée avant de calculer.
Sur \(\mathbb{C}^n\), le produit hermitien canonique est \(\langle x, y \rangle = \sum_{k=1}^{n} \overline{x_k} y_k\). En particulier, \(\langle x, x \rangle = \sum |x_k|^2\). Sur \(C([a,b], \mathbb{C})\), on pose de même \(\langle f, g \rangle = \int_a^b \overline{f(t)} g(t) \, dt\).
Les résultats des parties II à V restent vrais, avec les adaptations suivantes :
- \(\|x + y\|^2 = \|x\|^2 + 2 \operatorname{Re} \langle x, y \rangle + \|y\|^2\) ;
- Cauchy-Schwarz s’écrit \(|\langle x, y \rangle| \leq\, \|x\| \|y\|\), avec un module ;
- la projection est \(p_F(x) = \sum \langle e_i, x \rangle e_i\), l’ordre des variables comptant désormais.
Pour Cauchy-Schwarz, la démonstration change légèrement. On choisit un complexe \(\omega\) de module 1 tel que \(\langle x, \omega y \rangle\) soit réel positif. Ensuite, on applique l’argument du trinôme à \(x\) et \(\omega y\).
Dans un espace hermitien, \(\|x + y\|^2 = \|x\|^2 + \|y\|^2\) équivaut seulement à \(\operatorname{Re} \langle x, y \rangle = 0\). Par exemple, dans \(\mathbb{C}\), \(x = 1\) et \(y = i\) vérifient cette égalité, alors que \(\langle x, y \rangle = i \neq 0\).
VII. Méthode des moindres carrés
En pratique, un système linéaire \(AX = b\) a souvent plus d’équations que d’inconnues. Il n’a alors généralement aucune solution. On cherche donc le « meilleur compromis » : le vecteur \(X\) qui rend \(\|AX – b\|\) minimal pour la norme euclidienne.
Soit \(A \in \mathcal{M}_{n,p}(\mathbb{R})\) et \(b \in \mathbb{R}^n\). Un vecteur \(X_0 \in \mathbb{R}^p\) minimise \(\|AX – b\|\) si et seulement s’il vérifie les équations normales
\[ A^{T} A X_0 = A^{T} b . \]
Si les colonnes de \(A\) sont libres, alors \(A^{T} A\) est inversible et la solution est unique.
Quand \(X\) parcourt \(\mathbb{R}^p\), le vecteur \(AX\) parcourt \(F = \operatorname{Im} A\). D’après le théorème de meilleure approximation, \(\|AX – b\|\) est minimal si et seulement si \(AX_0 = p_F(b)\). Autrement dit, \(b – AX_0\) doit être orthogonal à chaque colonne de \(A\). Cela s’écrit \(A^{T}(b – AX_0) = 0\).
Supposons enfin les colonnes libres. Si \(A^{T} A X = 0\), alors \(X^{T} A^{T} A X = \|AX\|^2 = 0\). Donc \(AX = 0\), puis \(X = 0\). Ainsi, \(A^{T} A\) est inversible.
Pour ajuster une droite \(y = ax + b\) à des points \((x_i, y_i)\), \(1 \leq\, i \leq\, n\) :
- écrivez le système \(a x_i + b = y_i\) sous la forme \(A \begin{pmatrix} a \\ b \end{pmatrix} = Y\), où la ligne \(i\) de \(A\) est \((x_i \;\; 1)\) ;
- formez \(A^{T} A = \begin{pmatrix} \sum x_i^2 \sum x_i \\ \sum x_i n \end{pmatrix}\) et \(A^{T} Y = \begin{pmatrix} \sum x_i y_i \\ \sum y_i \end{pmatrix}\) ;
- résolvez ce système \(2 \times 2\), puis vérifiez que la somme des résidus est nulle.
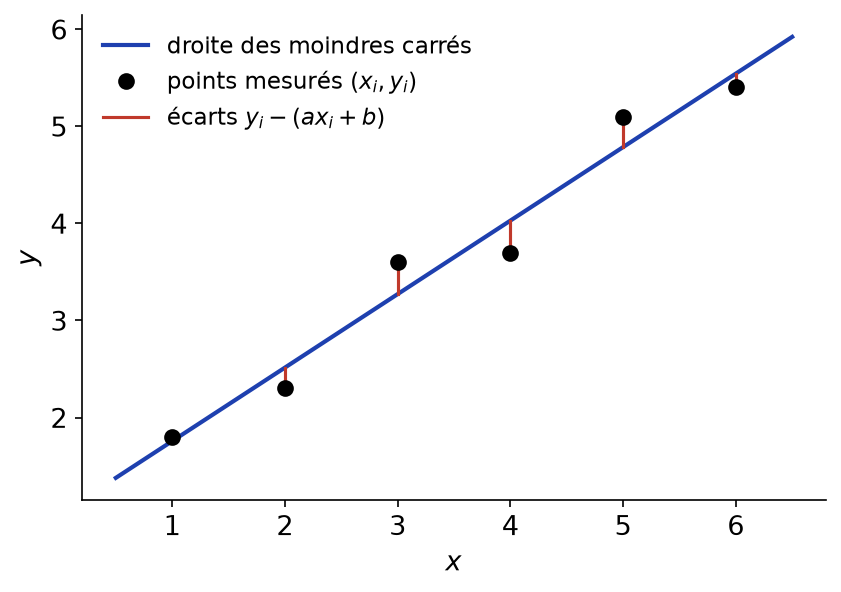
La figure ci-dessous montre la droite obtenue. Elle rend minimale la somme des carrés des écarts verticaux, dessinés en rouge.
Prenons les trois points \((0,0)\), \((1,1)\) et \((2,1)\). On a \(\sum x_i^2 = 5\), \(\sum x_i = 3\), \(n = 3\), \(\sum x_i y_i = 3\) et \(\sum y_i = 2\). Le système s’écrit \(5a + 3b = 3\) et \(3a + 3b = 2\).
Par soustraction, \(2a = 1\), donc \(a = \frac{1}{2}\) et \(b = \frac{1}{6}\). Les résidus valent \(-\frac{1}{6}\), \(\frac{1}{3}\) et \(-\frac{1}{6}\) : leur somme est bien nulle.
La même idée fonctionne dans un espace de fonctions. Par exemple, minimiser \(\int_0^1 (f – P)^2\) sur les polynômes \(P\) de degré au plus \(n\) revient à projeter \(f\) sur \(\mathbb{R}_n[X]\). C’est l’approximation « en moyenne quadratique ».
Ce qu’il faut retenir
- Un produit scalaire est une forme bilinéaire, symétrique, définie et positive. Vérifiez les quatre points, en particulier le caractère défini.
- Le développement \(\|x + y\|^2 = \|x\|^2 + 2 \langle x, y \rangle + \|y\|^2\) sert partout.
- Cauchy-Schwarz : \(|\langle x, y \rangle| \leq\, \|x\| \|y\|\), avec égalité exactement pour des vecteurs colinéaires.
- Une famille orthogonale de vecteurs non nuls est libre. Dans une base orthonormée, les coordonnées sont les \(\langle e_i, x \rangle\).
- Gram-Schmidt transforme une famille libre en famille orthonormée engendrant les mêmes sous-espaces successifs.
- Si \(F\) est de dimension finie, alors \(E = F \oplus F^{\perp}\). En dimension infinie, cela peut échouer.
- La projection orthogonale \(p_F(x)\) est le point de \(F\) le plus proche de \(x\), et \(d(x,F)^2 = \|x\|^2 – \|p_F(x)\|^2\).
- Dans un espace hermitien, on conjugue la première variable et on remplace \(\langle x, y \rangle\) par \(\operatorname{Re} \langle x, y \rangle\) dans les développements.
- Moindres carrés : on résout les équations normales \(A^{T} A X = A^{T} b\), c’est-à-dire qu’on projette \(b\) sur \(\operatorname{Im} A\).
Questions fréquentes sur espaces euclidiens
Quelle différence entre espace préhilbertien et espace euclidien ?
Un espace préhilbertien réel est un espace vectoriel réel muni d’un produit scalaire, sans condition de dimension. Un espace euclidien est un espace préhilbertien réel de dimension finie. Certains résultats, comme \(E = F \oplus F^{\perp}\) pour tout sous-espace \(F\), ne sont garantis qu’en dimension finie.
Comment montrer qu'une forme est définie positive ?
En dimension finie, écrivez \(\varphi(x,x)\) comme une somme de carrés de formes linéaires indépendantes, puis constatez que tous ces carrés sont nuls seulement pour \(x = 0\). Pour un produit scalaire intégral, utilisez qu’une fonction continue, positive et d’intégrale nulle est la fonction nulle.
Pourquoi le procédé de Gram-Schmidt ne produit-il jamais de vecteur nul ?
À l’étape \(k\), le vecteur \(w_k\) est \(v_k\) moins une combinaison de \(v_1, \ldots, v_{k-1}\). S’il était nul, \(v_k\) serait dans \(\operatorname{Vect}(v_1, \ldots, v_{k-1})\), ce qui contredit la liberté de la famille de départ. On peut donc toujours normaliser.
Que calcule-t-on vraiment avec les moindres carrés ?
On cherche \(X\) minimisant \(\|AX – b\|\). Cela revient à projeter orthogonalement \(b\) sur l’image de \(A\), ce qui donne les équations normales \(A^{T} A X = A^{T} b\). L’erreur minimale est la distance de \(b\) à \(\operatorname{Im} A\).
Pour aller plus loin en L2
- Les énoncés : exercices de maths en L2 sur espaces euclidiens
- Chapitre précédent : Intégrales dépendant d'un paramètre
- Chapitre suivant : Isométries, endomorphismes symétriques et théorème spectral
- Tester vos connaissances : QCM de maths en L2 par chapitre
- Le sommaire : tous les chapitres de maths de L2 et la licence de maths de L1 à L3