Ce cours sur les formes quadratiques L2 prolonge le chapitre sur les espaces euclidiens. On y abandonne la positivité du produit scalaire pour étudier des formes bilinéaires symétriques quelconques, leur forme polaire et leur matrice dans une base. La relation de congruence remplace alors la similitude.
Le cœur du chapitre est la réduction de Gauss, qui écrit toute forme comme combinaison de carrés de formes linéaires indépendantes. La loi d’inertie de Sylvester montre ensuite que la signature ne dépend pas de la réduction choisie. Le théorème spectral fournit enfin une réduction dans une base orthonormée.
Ces outils ont une traduction géométrique directe : la classification des coniques du plan et des quadriques de l’espace. Ils serviront aussi en calcul différentiel, pour étudier la nature d’un point critique à l’aide de la matrice hessienne.
Pour vous entraîner ensuite, travaillez les exercices de maths en L2 sur formes quadratiques.
I. Formes bilinéaires et formes quadratiques
Dans tout le chapitre, \(E\) désigne un \(\mathbb{R}\)-espace vectoriel de dimension finie \(n \geq\, 1\). Le produit scalaire du chapitre sur les espaces euclidiens est un cas particulier d’objet plus général : la forme bilinéaire symétrique. Ici, on abandonne la positivité. Ainsi, on pourra rencontrer des vecteurs non nuls de « carré » nul, ou même négatif.
1. Formes bilinéaires et matrice dans une base
Une forme bilinéaire sur \(E\) est une application \(b : E \times E \to \mathbb{R}\) linéaire par rapport à chacune de ses deux variables. Elle est dite symétrique si \(b(x, y) = b(y, x)\) pour tous \(x, y \in E\).
Fixons une base \(\mathcal{B} = (e_1, \ldots, e_n)\) de \(E\). Par bilinéarité, \(b\) est entièrement déterminée par les \(n^2\) nombres \(b(e_i, e_j)\). On les range dans une matrice carrée.
La matrice de \(b\) dans la base \(\mathcal{B}\) est \(A = \big(b(e_i, e_j)\big)_{1 \leq\, i, j \leq\, n}\). Si \(X\) et \(Y\) sont les colonnes de coordonnées de \(x\) et \(y\), alors
\[b(x, y) = \sum_{i=1}^{n} \sum_{j=1}^{n} a_{ij}\, x_i\, y_j = X^{T} A\, Y.\]
De plus, \(b\) est symétrique si et seulement si \(A\) est symétrique.
Sur \(\mathbb{R}^2\), posons \(b(x, y) = x_1 y_1 + 3 x_1 y_2 + 3 x_2 y_1 – 2 x_2 y_2\). Le coefficient de \(x_i y_j\) se place en ligne \(i\) et en colonne \(j\). Donc la matrice de \(b\) dans la base canonique est \(\begin{pmatrix} 1 3 \\ 3 -2 \end{pmatrix}\). Elle est symétrique, donc \(b\) l’est aussi.
2. Changement de base et matrices congruentes
Une même forme bilinéaire possède une matrice dans chaque base. Cependant, la loi de transformation diffère de celle des endomorphismes.
Soient \(\mathcal{B}\) et \(\mathcal{B}^{\prime}\) deux bases de \(E\), et \(P\) la matrice de passage de \(\mathcal{B}\) à \(\mathcal{B}^{\prime}\). Si \(A\) et \(A^{\prime}\) sont les matrices de \(b\) dans ces bases, alors \(A^{\prime} = P^{T} A P\).
Les colonnes de coordonnées vérifient \(X = P X^{\prime}\) et \(Y = P Y^{\prime}\). Par conséquent, \(b(x, y) = (P X^{\prime})^{T} A (P Y^{\prime}) = X^{\prime T} (P^{T} A P) Y^{\prime}\). Enfin, une matrice est caractérisée par ces valeurs pour tous \(X^{\prime}, Y^{\prime}\), d’où \(A^{\prime} = P^{T} A P\).
Deux matrices \(A, A^{\prime} \in \mathcal{M}_n(\mathbb{R})\) sont congruentes s’il existe \(P \in GL_n(\mathbb{R})\) telle que \(A^{\prime} = P^{T} A P\). C’est une relation d’équivalence. Autrement dit, deux matrices sont congruentes si et seulement si elles représentent la même forme bilinéaire dans deux bases.
Congruence et similitude sont deux relations différentes. Par exemple, \(I_2\) et \(\mathrm{diag}(1, 4)\) sont congruentes, avec \(P = \mathrm{diag}(1, 2)\). En revanche, elles ne sont pas semblables, car seule l’identité est semblable à \(I_2\). Le rang reste toutefois invariant, puisque \(P\) et \(P^{T}\) sont inversibles. On définit donc le rang de \(b\) comme le rang de n’importe laquelle de ses matrices.
3. Formes quadratiques et forme polaire
Une application \(q : E \to \mathbb{R}\) est une forme quadratique s’il existe une forme bilinéaire symétrique \(b\) telle que \(q(x) = b(x, x)\) pour tout \(x \in E\).
Si \(q\) est une forme quadratique, la forme bilinéaire symétrique \(b\) telle que \(q(x) = b(x, x)\) est unique. On l’appelle la forme polaire de \(q\), et on a les identités de polarisation
\[b(x, y) = \frac{1}{2}\big(q(x + y) – q(x) – q(y)\big) = \frac{1}{4}\big(q(x + y) – q(x – y)\big).\]
Par bilinéarité et symétrie, \(q(x + y) = b(x, x) + 2 b(x, y) + b(y, y)\). On isole \(b(x, y)\), ce qui donne la première formule. Ensuite, \(q(x – y) = q(x) – 2 b(x, y) + q(y)\), et la différence fournit la seconde. Ainsi, \(b\) s’exprime à l’aide de \(q\) seule, d’où l’unicité.
En coordonnées, une forme quadratique est un polynôme homogène de degré \(2\) : \(q(x) = X^{T} A X = \sum_i a_{ii} x_i^2 + 2 \sum_{i < j} a_{ij} x_i x_j\). La matrice de \(q\) est, par définition, celle de sa forme polaire.
Pour écrire la matrice d’une forme quadratique donnée par un polynôme homogène de degré \(2\) :
- le coefficient de \(x_i^2\) se place sur la diagonale, en position \((i, i)\) ;
- le coefficient de \(x_i x_j\), avec \(i \neq j\), est partagé en deux entre les positions \((i, j)\) et \((j, i)\).
La forme polaire s’obtient ensuite par dédoublement : \(x_i^2\) devient \(x_i y_i\), et \(x_i x_j\) devient \(\frac{1}{2}(x_i y_j + x_j y_i)\).
Soit \(q(x, y, z) = 2x^2 – y^2 + 4xy – 6yz\) sur \(\mathbb{R}^3\). Sa matrice dans la base canonique est
\[A = \begin{pmatrix} 2 2 0 \\ 2 -1 -3 \\ 0 -3 0 \end{pmatrix}.\]
Sa forme polaire est donc \(b(u, v) = 2 x x^{\prime} – y y^{\prime} + 2(x y^{\prime} + y x^{\prime}) – 3(y z^{\prime} + z y^{\prime})\), où \(u = (x, y, z)\) et \(v = (x^{\prime}, y^{\prime}, z^{\prime})\).
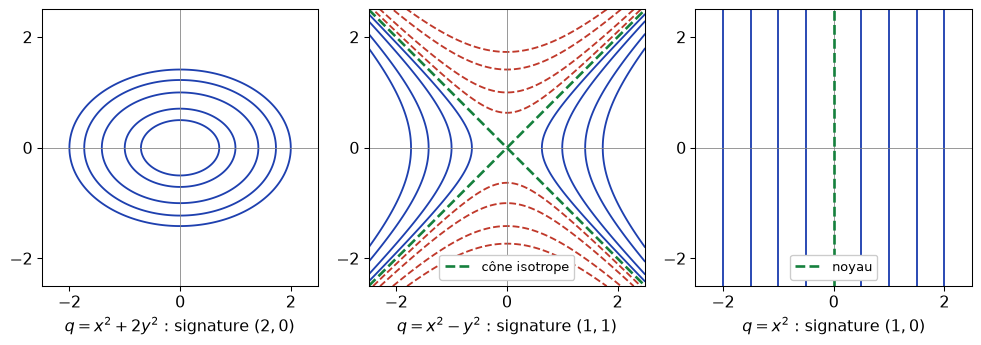
Les lignes de niveau \(q(x) = c\) donnent une image parlante d’une forme quadratique du plan. En effet, comme le montre la figure ci-dessous, elles sont des ellipses, des hyperboles ou des droites parallèles selon la forme. On verra que ce comportement est gouverné par la signature.
II. Orthogonalité et cône isotrope
Dans cette partie, \(q\) est une forme quadratique sur \(E\), de forme polaire \(b\). On transpose le vocabulaire euclidien, mais certaines propriétés familières tombent.
Deux vecteurs \(x, y\) sont \(q\)-orthogonaux si \(b(x, y) = 0\). L’orthogonal d’une partie \(F\) est \(F^{\perp} = \{y \in E,\ \forall x \in F,\ b(x, y) = 0\}\) ; c’est un sous-espace vectoriel. Le noyau de \(q\) est \(\ker q = E^{\perp}\). La forme \(q\) est non dégénérée si \(\ker q = \{0\}\).
Un vecteur \(x\) est isotrope si \(q(x) = 0\). Le cône isotrope de \(q\) est \(C(q) = \{x \in E,\ q(x) = 0\}\). La forme \(q\) est définie si \(C(q) = \{0\}\).
On a toujours \(\ker q \subset C(q)\). En revanche, l’inclusion est souvent stricte. De plus, \(C(q)\) est stable par multiplication par un scalaire, d’où le mot « cône ». Cependant, ce n’est pas un sous-espace vectoriel en général.
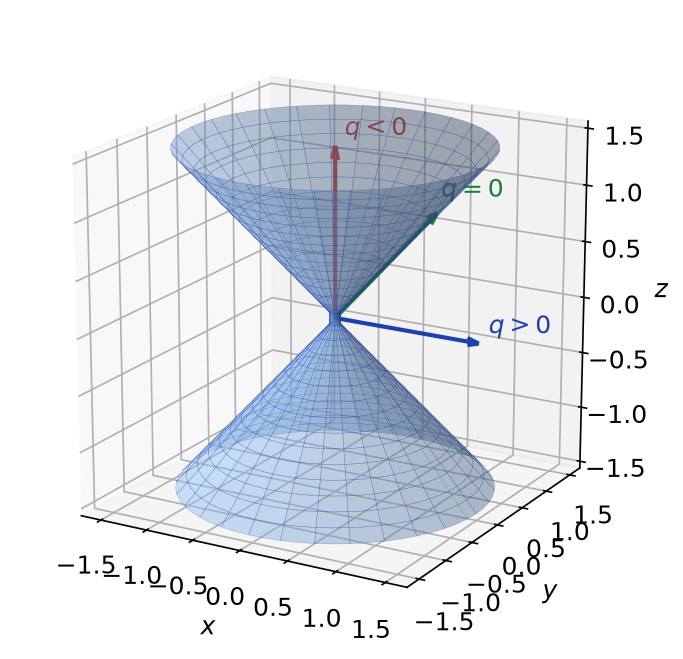
Sur \(\mathbb{R}^3\), soit \(q(x, y, z) = x^2 + y^2 – z^2\). Sa matrice \(\mathrm{diag}(1, 1, -1)\) est inversible, donc \(\ker q = \{0\}\). Pourtant, \(C(q)\) est le cône de révolution d’équation \(x^2 + y^2 = z^2\). Par exemple, \(u = (1, 0, 1)\) et \(v = (-1, 0, 1)\) sont isotropes, mais \(q(u + v) = -4 \neq 0\).
La figure ci-dessous représente ce cône. À l’extérieur, \(q\) prend des valeurs positives ; à l’intérieur, elle est négative. Le cône sépare donc les deux régions de signe.
En dimension finie, le noyau se lit sur la matrice. En effet, \(y \in \ker q\) équivaut à \(X^{T} A Y = 0\) pour tout \(X\), c’est-à-dire à \(AY = 0\). Ainsi, \(\ker q\) correspond au noyau de \(A\), et \(q\) est non dégénérée si et seulement si \(A\) est inversible.
Soit \(F\) un sous-espace de \(E\). Alors \(\dim F^{\perp} \geq\, n – \dim F\), avec égalité si \(q\) est non dégénérée. En revanche, même dans ce cas, \(F \cap F^{\perp}\) peut être non nul.
Soit \((f_1, \ldots, f_p)\) une base de \(F\). Alors \(F^{\perp}\) est l’intersection des noyaux des formes linéaires \(\varphi_k = b(f_k, \cdot)\). Une intersection de \(p\) hyperplans ou moins est de dimension au moins \(n – p\). Si \(q\) est non dégénérée, l’application \(x \mapsto b(x, \cdot)\) de \(E\) dans \(E^{*}\) est injective, donc les \(\varphi_k\) sont libres. Par conséquent, la dimension vaut exactement \(n – p\). Enfin, avec l’exemple précédent, \(F = \mathrm{Vect}(u)\) vérifie \(F \subset F^{\perp}\), car \(u\) est isotrope.
Toute forme quadratique sur \(E\) admet une base \(q\)-orthogonale. Dans une telle base \((e_1, \ldots, e_n)\), la matrice de \(q\) est diagonale et \(q(x) = \sum_{i=1}^{n} q(e_i)\, x_i^2\).
On raisonne par récurrence sur \(n\). Si \(q = 0\), toute base convient. Sinon, on choisit \(e_1\) tel que \(q(e_1) \neq 0\). La forme linéaire \(b(e_1, \cdot)\) est non nulle, donc \(H = \{e_1\}^{\perp}\) est un hyperplan. De plus, \(e_1 \notin H\), d’où \(E = \mathrm{Vect}(e_1) \oplus H\). Ensuite, on applique l’hypothèse de récurrence à la restriction de \(q\) à \(H\). Enfin, on complète la base obtenue par \(e_1\).
III. Réduction de Gauss
La démonstration précédente est constructive, mais peu pratique. La méthode de Gauss fournit directement une écriture de \(q\) comme combinaison de carrés de formes linéaires indépendantes. C’est l’outil de calcul central du chapitre.
Réduction de Gauss d’une forme \(q(x_1, \ldots, x_n)\).
- Cas 1 : un carré est présent, par exemple \(a x_1^2\) avec \(a \neq 0\). On regroupe tous les termes contenant \(x_1\) : \(a x_1^2 + x_1 L(x_2, \ldots, x_n) = a(x_1 + \frac{L}{2a})^2 – \frac{L^2}{4a}\). Le reste ne dépend plus de \(x_1\).
- Cas 2 : aucun carré, mais un terme \(a x_1 x_2\) avec \(a \neq 0\). On écrit \(a x_1 x_2 + x_1 L_2 + x_2 L_1 = a(x_1 + \frac{L_1}{a})(x_2 + \frac{L_2}{a}) – \frac{L_1 L_2}{a}\), où \(L_1, L_2\) ne dépendent que de \(x_3, \ldots, x_n\). Puis on utilise \(uv = \frac{1}{4}\big((u + v)^2 – (u – v)^2\big)\).
- On recommence avec la forme restante, qui a au moins une variable de moins.
La méthode de Gauss aboutit à \(q = \sum_{i=1}^{r} \lambda_i\, \ell_i^2\), où les \(\lambda_i\) sont des réels non nuls et \(\ell_1, \ldots, \ell_r\) des formes linéaires linéairement indépendantes. De plus, \(r\) est le rang de \(q\).
À chaque étape, la nouvelle forme linéaire contient une variable absente des suivantes. Donc la matrice des \(\ell_i\) est échelonnée, et les \(\ell_i\) sont libres. On les complète en une base \((\ell_1, \ldots, \ell_n)\) de \(E^{*}\). Soit \((f_1, \ldots, f_n)\) la base de \(E\) dont c’est la base duale. Dans cette base, la matrice de \(q\) est \(\mathrm{diag}(\lambda_1, \ldots, \lambda_r, 0, \ldots, 0)\), de rang \(r\).
Réduisons \(q(x, y, z) = x^2 + 2y^2 + 3z^2 + 2xy + 2xz\). Les termes en \(x\) forment \(x^2 + 2x(y + z) = (x + y + z)^2 – (y + z)^2\). Ainsi, \(q = (x + y + z)^2 + y^2 – 2yz + 2z^2\). Ensuite, \(y^2 – 2yz = (y – z)^2 – z^2\). Finalement,
\[q(x, y, z) = (x + y + z)^2 + (y – z)^2 + z^2.\]
Les trois formes linéaires sont indépendantes, donc \(q\) est de rang \(3\) et ne prend que des valeurs positives.
Pour \(q(x, y, z) = xy + yz + zx\), aucun carré n’apparaît. On écrit d’abord \(xy + z(x + y) = (x + z)(y + z) – z^2\). Puis, avec \(u = x + z\) et \(v = y + z\), on a \(uv = \frac{1}{4}(u + v)^2 – \frac{1}{4}(u – v)^2\). Donc
\[q(x, y, z) = \frac{1}{4}(x + y + 2z)^2 – \frac{1}{4}(x – y)^2 – z^2.\]
Pour obtenir une base \(q\)-orthogonale à partir de \(q = \sum \lambda_i \ell_i^2\), on forme la matrice \(L\) dont les lignes sont les coefficients des \(\ell_i\), complétée si besoin en une matrice inversible. Les colonnes de \(L^{-1}\) forment alors une base \(q\)-orthogonale. En effet, dans cette base, les nouvelles coordonnées sont exactement \(\ell_1(x), \ldots, \ell_n(x)\).
IV. Rang, signature et loi d’inertie de Sylvester
La décomposition de Gauss n’est pas unique : les formes \(\ell_i\) et les coefficients \(\lambda_i\) dépendent des choix faits. Cependant, le nombre de coefficients positifs, lui, ne change pas. C’est le contenu du théorème suivant.
Loi d’inertie de Sylvester. Soit \(q\) une forme quadratique sur \(E\) et \((e_1, \ldots, e_n)\) une base \(q\)-orthogonale. Le nombre \(s\) d’indices tels que \(q(e_i) > 0\) et le nombre \(t\) d’indices tels que \(q(e_i) < 0\) ne dépendent pas de la base \(q\)-orthogonale choisie. Le couple \((s, t)\) est la signature de \(q\), et \(s + t\) est son rang.
Soient deux bases \(q\)-orthogonales, avec \(s\) et \(s^{\prime}\) vecteurs positifs. Notons \(F\) l’espace engendré par les \(s\) vecteurs positifs de la première base. Pour \(x \in F\) non nul, \(q(x) = \sum q(e_i) x_i^2 > 0\). Notons ensuite \(G\) l’espace engendré par les \(n – s^{\prime}\) autres vecteurs de la seconde base. De même, \(q(x) \leq\, 0\) pour tout \(x \in G\). Par conséquent, \(F \cap G = \{0\}\), donc \(s + (n – s^{\prime}) \leq\, n\), soit \(s \leq\, s^{\prime}\). Par symétrie des rôles, \(s = s^{\prime}\). On applique enfin le même argument à \(-q\) pour \(t\).
En pratique, la signature se lit sur une réduction de Gauss : \(s\) est le nombre de \(\lambda_i > 0\) et \(t\) le nombre de \(\lambda_i < 0\). Ainsi, \(xy + yz + zx\) a pour signature \((1, 2)\).
Une forme \(q\) est positive si \(q(x) \geq\, 0\) pour tout \(x\), et définie positive si de plus \(q(x) = 0 \Rightarrow x = 0\). En dimension \(n\), \(q\) est positive si et seulement si \(t = 0\), et définie positive si et seulement si sa signature est \((n, 0)\).
Toute matrice symétrique réelle \(A\) de signature \((s, t)\) est congruente à \(\mathrm{diag}(I_s, -I_t, 0_{n-s-t})\). Deux matrices symétriques réelles sont congruentes si et seulement si elles ont la même signature.
Dans une base \(q\)-orthogonale, on remplace chaque \(e_i\) tel que \(q(e_i) \neq 0\) par \(e_i / \sqrt{|q(e_i)|}\). On range ensuite les vecteurs dans l’ordre : positifs, négatifs, puis isotropes. La réciproque découle de la loi d’inertie, car la signature ne dépend que de la forme.
En dimension \(2\), écrivons \(q(x, y) = a x^2 + 2bxy + c y^2\) avec \(a \neq 0\). Alors \(q = a(x + \frac{b}{a} y)^2 + \frac{ac – b^2}{a} y^2\). Donc, si \(ac – b^2 > 0\), la signature est \((2, 0)\) ou \((0, 2)\), selon le signe de \(a\). Si \(ac – b^2 < 0\), elle vaut \((1, 1)\). Enfin, si \(ac – b^2 = 0\), le rang vaut \(1\).
Le déterminant d’une matrice est multiplié par \(\det(P)^2 > 0\) lors d’une congruence. Son signe est donc un invariant : si \(q\) est non dégénérée, il vaut \((-1)^{t}\).
V. Réduction dans une base orthonormée
Supposons maintenant \(E = \mathbb{R}^n\) muni de son produit scalaire usuel. On cherche une base à la fois \(q\)-orthogonale et orthonormée. Le théorème spectral répond à la question.
Soit \(q(x) = X^{T} A X\), avec \(A\) symétrique réelle. Il existe une base orthonormée \((u_1, \ldots, u_n)\) formée de vecteurs propres de \(A\), de valeurs propres \(\lambda_1, \ldots, \lambda_n\). Dans cette base, avec les coordonnées \(x^{\prime}_i\),
\[q(x) = \lambda_1 x_1^{\prime 2} + \lambda_2 x_2^{\prime 2} + \cdots + \lambda_n x_n^{\prime 2}.\]
En particulier, \(s\) est le nombre de valeurs propres strictement positives et \(t\) celui des valeurs propres strictement négatives, comptées avec multiplicité.
D’après le théorème spectral, \(A = P D P^{T}\) avec \(P\) orthogonale et \(D\) diagonale. Comme \(P^{-1} = P^{T}\), on a \(P^{T} A P = D\) : la matrice de \(q\) dans la base des colonnes de \(P\) est donc \(D\). Ici, similitude et congruence coïncident. La signature découle alors de la loi d’inertie.
Si \(\lambda_{\min}\) et \(\lambda_{\max}\) sont la plus petite et la plus grande valeur propre de \(A\), alors \(\lambda_{\min} \|x\|^2 \leq\, q(x) \leq\, \lambda_{\max} \|x\|^2\) pour tout \(x\). Les bornes sont atteintes sur des vecteurs propres associés.
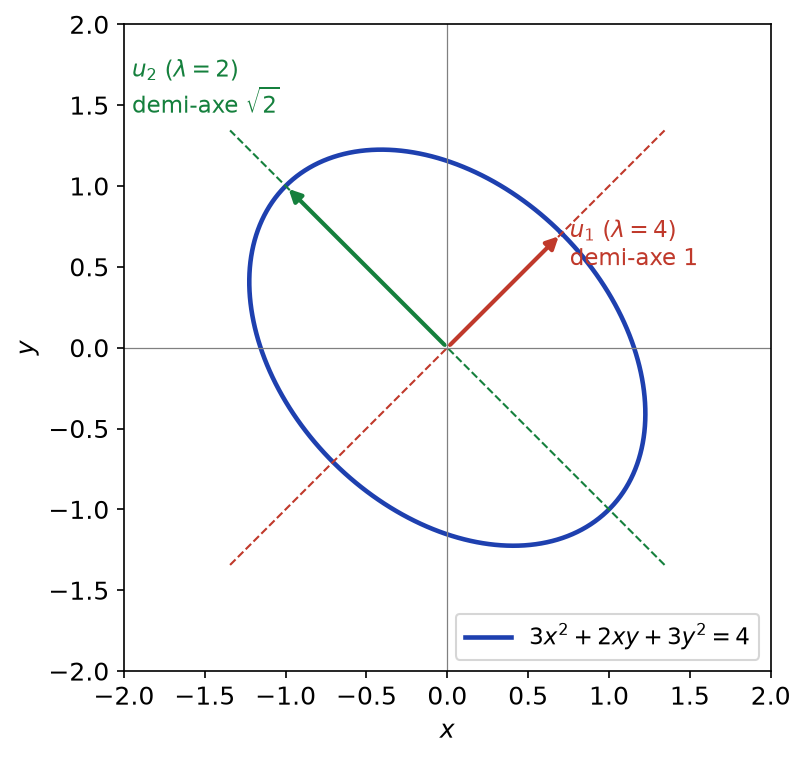
Soit \(q(x, y) = 3x^2 + 2xy + 3y^2\), de matrice \(\begin{pmatrix} 3 1 \\ 1 3 \end{pmatrix}\). Ses valeurs propres sont \(4\), associée à \(u_1 = \frac{1}{\sqrt{2}}(1, 1)\), et \(2\), associée à \(u_2 = \frac{1}{\sqrt{2}}(-1, 1)\). Donc \(q = 4X^2 + 2Y^2\) dans la base orthonormée \((u_1, u_2)\). Par conséquent, la courbe \(q(x, y) = 4\) a pour équation \(X^2 + \frac{Y^2}{2} = 1\) : c’est une ellipse.
La figure suivante montre cette ellipse et ses axes. Le grand axe est porté par le vecteur propre de la plus petite valeur propre. En effet, le demi-axe dans la direction \(u_i\) vaut \(\sqrt{4 / \lambda_i}\).
Les coefficients d’une réduction de Gauss ne sont pas les valeurs propres. Par exemple, Gauss donne \(3x^2 + 2xy + 3y^2 = 3(x + \frac{y}{3})^2 + \frac{8}{3} y^2\). Seuls les signes sont les mêmes, par la loi d’inertie. De plus, la base associée n’est pas orthonormée : elle ne conserve pas les longueurs, donc pas la forme exacte des courbes.
VI. Classification des coniques
La réduction dans une base orthonormée a une traduction géométrique directe. En effet, un changement de repère orthonormé conserve les distances, donc la forme des courbes. On se place dans le plan muni d’un repère orthonormé.
Une conique est l’ensemble des points \((x, y)\) vérifiant une équation
\[a x^2 + 2bxy + c y^2 + 2dx + 2ey + f = 0,\]
où \((a, b, c) \neq (0, 0, 0)\). Sa partie quadratique est \(q(x, y) = a x^2 + 2bxy + c y^2\), de matrice \(A = \begin{pmatrix} a b \\ b c \end{pmatrix}\). On note \(\delta = \det A = ac – b^2\).
Pour réduire l’équation d’une conique :
- diagonaliser \(A\) dans une base orthonormée directe \((u_1, u_2)\), puis exprimer \(x, y\) en fonction des nouvelles coordonnées \(X, Y\) ;
- substituer : la partie quadratique devient \(\lambda_1 X^2 + \lambda_2 Y^2\) et la partie linéaire reste linéaire ;
- compléter les carrés, ce qui revient à translater l’origine ;
- reconnaître une équation réduite, puis revenir aux coordonnées initiales pour les éléments remarquables.
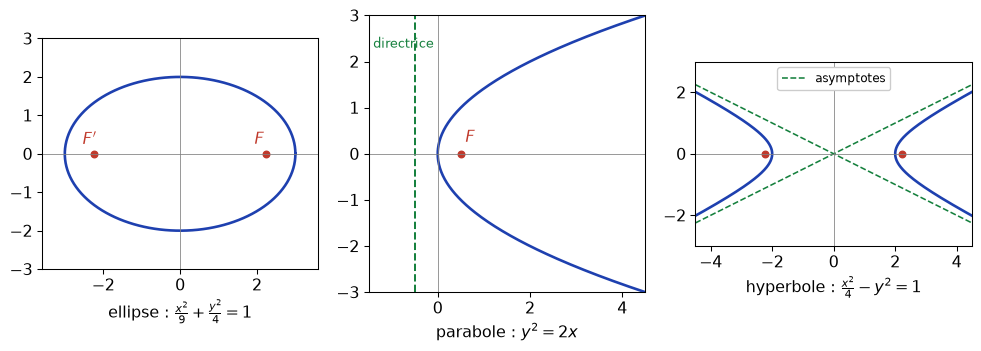
Les équations réduites non dégénérées sont au nombre de trois. Pour l’ellipse, \(\frac{x^2}{a^2} + \frac{y^2}{b^2} = 1\) avec \(a \geq\, b > 0\) ; ses foyers sont \((\pm c, 0)\) avec \(c^2 = a^2 – b^2\). Pour l’hyperbole, \(\frac{x^2}{a^2} – \frac{y^2}{b^2} = 1\) ; ses foyers sont \((\pm c, 0)\) avec \(c^2 = a^2 + b^2\), et ses asymptotes ont pour équations \(y = \pm \frac{b}{a} x\). Enfin, pour la parabole, \(y^2 = 2px\) avec \(p > 0\) ; son foyer est \((\frac{p}{2}, 0)\) et sa directrice la droite \(x = -\frac{p}{2}\). La figure ci-dessous rassemble ces trois courbes.
Le genre d’une conique est donné par le signe de \(\delta = \lambda_1 \lambda_2\).
- Si \(\delta > 0\) (signature \((2, 0)\) ou \((0, 2)\)) : ellipse, point ou ensemble vide.
- Si \(\delta < 0\) (signature \((1, 1)\)) : hyperbole ou deux droites sécantes.
- Si \(\delta = 0\) (rang \(1\)) : parabole, deux droites parallèles, une droite ou ensemble vide.
Après rotation, l’équation devient \(\lambda_1 X^2 + \lambda_2 Y^2 + 2d^{\prime} X + 2e^{\prime} Y + f = 0\). Si \(\lambda_1 \lambda_2 \neq 0\), on complète les deux carrés et l’on obtient \(\lambda_1 X_1^2 + \lambda_2 Y_1^2 = k\). Lorsque \(\lambda_1, \lambda_2\) sont de même signe, on trouve une ellipse, un point ou le vide selon le signe de \(k\). Sinon, on trouve une hyperbole si \(k \neq 0\), et deux droites sécantes si \(k = 0\). Si \(\lambda_1 = 0\), on complète le carré en \(Y\) : \(\lambda_2 Y_1^2 + 2d^{\prime} X + f^{\prime} = 0\). Pour \(d^{\prime} \neq 0\), c’est une parabole. Pour \(d^{\prime} = 0\), il reste \(Y_1^2 = -f^{\prime}/\lambda_2\), d’où deux droites, une droite ou le vide.
Considérons \(x^2 + 4xy + y^2 = 3\). Ici \(\delta = 1 – 4 = -3 < 0\) : la conique est du genre hyperbole. Les valeurs propres de \(\begin{pmatrix} 1 2 \\ 2 1 \end{pmatrix}\) sont \(3\) et \(-1\), de vecteurs propres \(\frac{1}{\sqrt{2}}(1, 1)\) et \(\frac{1}{\sqrt{2}}(-1, 1)\). L’équation devient \(3X^2 – Y^2 = 3\), soit \(X^2 – \frac{Y^2}{3} = 1\). C’est donc une hyperbole d’axe focal la droite \(y = x\).
VII. Quadriques de l’espace
La même démarche s’applique en dimension \(3\), dans un repère orthonormé de l’espace. Une quadrique est l’ensemble des points vérifiant \(X^{T} A X + 2 B^{T} X + c = 0\), où \(A\) est une matrice symétrique non nulle de taille \(3\), \(B\) une colonne et \(c\) un réel.
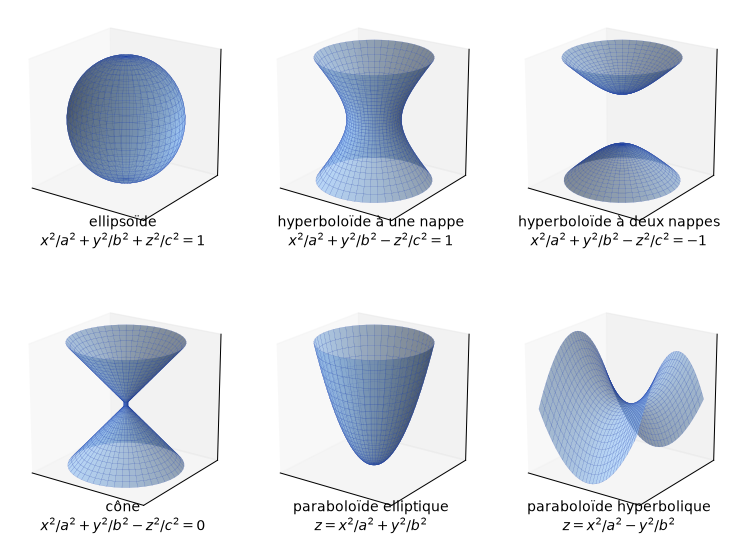
Dans un repère orthonormé bien choisi, toute quadrique non vide, non réduite à un point et non contenue dans un plan a pour équation réduite l’une des suivantes, avec \(a, b, c > 0\) :
- \(\frac{x^2}{a^2} + \frac{y^2}{b^2} + \frac{z^2}{c^2} = 1\) : ellipsoïde ;
- \(\frac{x^2}{a^2} + \frac{y^2}{b^2} – \frac{z^2}{c^2} = 1\) : hyperboloïde à une nappe ;
- \(\frac{x^2}{a^2} + \frac{y^2}{b^2} – \frac{z^2}{c^2} = -1\) : hyperboloïde à deux nappes ;
- \(\frac{x^2}{a^2} + \frac{y^2}{b^2} – \frac{z^2}{c^2} = 0\) : cône ;
- \(z = \frac{x^2}{a^2} + \frac{y^2}{b^2}\) ou \(z = \frac{x^2}{a^2} – \frac{y^2}{b^2}\) : paraboloïde elliptique ou hyperbolique ;
- une équation sans \(z\) : cylindre elliptique, hyperbolique ou parabolique.
Les six premières surfaces sont représentées ci-dessous. Leur forme se devine en coupant par les plans \(z = k\) : on obtient des ellipses, des hyperboles ou des paraboles.
Pour réduire l’équation d’une quadrique, on procède comme pour les coniques. D’abord, on diagonalise \(A\) en base orthonormée, ce qui donne \(\lambda_1 X^2 + \lambda_2 Y^2 + \lambda_3 Z^2\) plus des termes linéaires. Ensuite, on complète les carrés pour chaque \(\lambda_i \neq 0\). Enfin, on lit la nature sur les signes des \(\lambda_i\) et du second membre. Si \(A\) est de rang \(3\), il y a un centre et l’on trouve un ellipsoïde, un hyperboloïde ou un cône. Si \(A\) est de rang \(2\) avec un terme linéaire restant, on obtient un paraboloïde.
Soit la quadrique \(x^2 + y^2 – 2z^2 + 4x – 4z = 0\). On complète les carrés : \((x + 2)^2 – 4 + y^2 – 2(z + 1)^2 + 2 = 0\). Avec \(X = x + 2\), \(Y = y\) et \(Z = z + 1\), on obtient \(X^2 + Y^2 – 2Z^2 = 2\), soit \(\frac{X^2}{2} + \frac{Y^2}{2} – Z^2 = 1\). C’est donc un hyperboloïde à une nappe de centre \((-2, 0, -1)\), de révolution autour de l’axe parallèle à \(Oz\).
La signature de \(A\) donne le type : \((3, 0)\) pour l’ellipsoïde, \((2, 1)\) ou \((1, 2)\) pour les hyperboloïdes et le cône. Le signe du second membre départage ensuite une nappe, deux nappes ou le cône. Ainsi, l’algèbre de la réduction de Gauss et la géométrie des surfaces sont deux lectures du même invariant.
Ce qu’il faut retenir
- Une forme bilinéaire a pour matrice \(A = (b(e_i, e_j))\) et \(b(x, y) = X^{T} A Y\) ; un changement de base donne \(P^{T} A P\), matrice congruente.
- Une forme quadratique détermine sa forme polaire : \(b(x, y) = \frac{1}{2}(q(x + y) – q(x) – q(y))\).
- Dans la matrice de \(q\), les coefficients des termes croisés \(x_i x_j\) sont partagés en deux.
- Le noyau est \(\ker A\) ; le cône isotrope contient le noyau mais n’est pas un sous-espace en général.
- La méthode de Gauss écrit \(q = \sum \lambda_i \ell_i^2\) avec des formes \(\ell_i\) indépendantes ; les colonnes de \(L^{-1}\) donnent une base \(q\)-orthogonale.
- La loi d’inertie de Sylvester : le nombre de \(\lambda_i\) positifs et négatifs ne dépend pas de la réduction. C’est la signature \((s, t)\), et \(s + t\) est le rang.
- Deux matrices symétriques réelles sont congruentes si et seulement si elles ont la même signature.
- En base orthonormée, \(q = \sum \lambda_i x_i^{\prime 2}\) où les \(\lambda_i\) sont les valeurs propres de \(A\).
- Le genre d’une conique se lit sur le signe de \(ac – b^2\) : ellipse, hyperbole ou parabole.
- Une quadrique se réduit par diagonalisation orthonormée, puis complétion des carrés.
Questions fréquentes sur formes quadratiques
Quelle est la différence entre matrices congruentes et matrices semblables ?
Deux matrices sont semblables si \(A^{\prime} = P^{-1} A P\) et congruentes si \(A^{\prime} = P^{T} A P\). La similitude décrit un endomorphisme dans deux bases, la congruence une forme bilinéaire. Les deux notions coïncident lorsque \(P\) est orthogonale, ce qui explique le rôle du théorème spectral.
La réduction de Gauss est-elle unique ?
Non : les formes linéaires et les coefficients obtenus dépendent de l’ordre des variables et des choix faits. En revanche, le nombre de coefficients positifs et le nombre de coefficients négatifs sont toujours les mêmes. C’est la loi d’inertie de Sylvester, qui définit la signature.
Comment reconnaître rapidement la nature d'une conique ?
On calcule \(\delta = ac – b^2\) pour l’équation \(ax^2 + 2bxy + cy^2 + \ldots = 0\). Si \(\delta > 0\), c’est une ellipse ou un cas dégénéré ; si \(\delta < 0\), une hyperbole ou deux droites ; si \(\delta = 0\), une parabole ou un cas dégénéré. Il faut ensuite réduire l’équation pour trancher.
Les coefficients de Gauss sont-ils les valeurs propres de la matrice ?
Non, en général ils sont différents. Seuls leurs signes coïncident avec ceux des valeurs propres, par la loi d’inertie. Pour obtenir les longueurs des axes d’une conique, il faut donc diagonaliser la matrice dans une base orthonormée.
Pour aller plus loin en L2
- Les énoncés : exercices de maths en L2 sur formes quadratiques
- À maîtriser avant : Isométries, endomorphismes symétriques et théorème spectral
- Chapitre précédent : Séries de Fourier
- Chapitre suivant : Intégrales multiples et intégrales curvilignes
- Tester vos connaissances : QCM de maths en L2 par chapitre
- Le sommaire : tous les chapitres de maths de L2 et la licence de maths de L1 à L3