Ce cours d’espérance variance spé reprend les variables aléatoires discrètes du chapitre précédent et leur associe des nombres qui résument leur comportement. L’espérance y est définie comme la somme d’une famille sommable, ce qui donne un sens précis aux moyennes infinies. Vous y verrez la formule de transfert, la formule des queues \(E(X) = \sum P(X \geq\, n)\) et l’inégalité de Cauchy-Schwarz.
Ensuite, la variance et la covariance mesurent la dispersion et la dépendance. Les lois géométrique et de Poisson servent d’exemples constants. Enfin, les inégalités de Markov et de Bienaymé-Tchebychev conduisent à la loi faible des grands nombres, qui justifie l’approche fréquentiste des probabilités.
Ce chapitre clôt la partie probabilités du second semestre. Ses méthodes reviennent sans cesse aux écrits et aux oraux des concours.
Pour vous entraîner ensuite, travaillez les exercices de maths spé sur espérance et variance.
I. Espérance d’une variable aléatoire discrète
Dans tout le chapitre, \((\Omega, \mathcal{A}, P)\) est un espace probabilisé et les variables aléatoires sont discrètes : leur ensemble de valeurs \(X(\Omega)\) est fini ou dénombrable. L’idée directrice est simple. L’espérance est la moyenne des valeurs pondérées par leurs probabilités. Cependant, cette moyenne est une somme infinie en général. Il faut donc la définir comme la somme d’une famille, sans dépendre d’un ordre d’énumération.
1. Variables à valeurs dans [0, +∞]
Pour une variable positive, la famille des termes \(x P(X = x)\) est positive. Sa somme a donc toujours un sens dans \([0, +\infty]\). C’est pourquoi on commence par ce cas.
Soit \(X\) une variable aléatoire discrète à valeurs dans \([0, +\infty]\). Son espérance est la somme, dans \([0, +\infty]\), de la famille positive \((x P(X = x))_{x \in X(\Omega)}\) :
\[E(X) = \sum_{x \in X(\Omega)} x \, P(X = x),\]
avec la convention \(0 \times (+\infty) = 0\). Si \(P(X = +\infty) > 0\), alors \(E(X) = +\infty\).
Pour une variable à valeurs entières, une seconde écriture est très utile. En effet, elle remplace les probabilités ponctuelles par les probabilités de queue \(P(X \geq\, n)\), souvent plus faciles à obtenir.
Si \(X\) est à valeurs dans \(\mathbb{N} \cup \{+\infty\}\), alors, dans \([0, +\infty]\),
\[E(X) = \sum_{n=1}^{+\infty} P(X \geq\, n).\]
Traitons le cas où \(X\) est à valeurs dans \(\mathbb{N}\) (si \(P(X = +\infty) > 0\), les deux membres valent \(+\infty\)). Pour \(n \geq\, 1\), on a \(P(X \geq\, n) = \sum_{k \geq\, n} P(X = k)\). La famille \((P(X = k))_{1 \leq\, n \leq\, k}\) indexée par les couples \((n, k)\) est positive. Le théorème de Fubini pour les familles positives permet donc d’échanger les sommations :
\[\sum_{n=1}^{+\infty} P(X \geq\, n) = \sum_{k=1}^{+\infty} \sum_{n=1}^{k} P(X = k) = \sum_{k=1}^{+\infty} k \, P(X = k) = E(X).\]
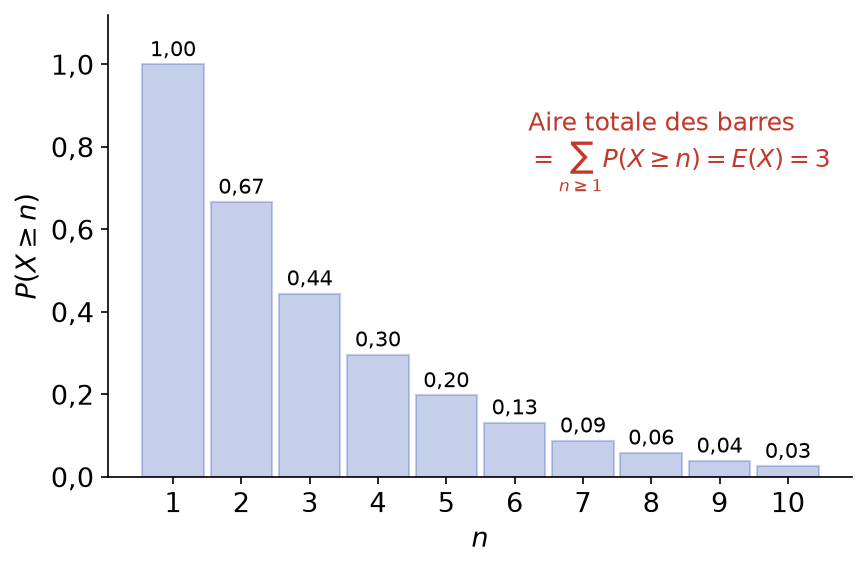
La figure ci-dessous illustre cette formule pour une loi géométrique de paramètre \(1/3\). Chaque barre a pour hauteur \(P(X \geq\, n) = (2/3)^{n-1}\). Ainsi, l’aire totale des barres vaut \(E(X)\).
Soit \(X\) à valeurs dans \(\mathbb{N}^*\) telle que \(P(X = n) = \frac{1}{n(n+1)}\). Par télescopage, \(P(X \geq\, n) = \frac{1}{n}\). La formule des queues donne \(E(X) = \sum 1/n = +\infty\). Autrement dit, \(X\) est finie presque sûrement mais son espérance est infinie.
2. Variables d’espérance finie
Pour une variable réelle ou complexe, les termes \(x P(X = x)\) changent de signe. On exige alors la sommabilité de la famille, ce qui revient à l’étude de \(|X|\).
Une variable aléatoire discrète \(X\) réelle ou complexe est dite d’espérance finie si la famille \((x P(X = x))_{x \in X(\Omega)}\) est sommable, c’est-à-dire si \(E(|X|) < +\infty\). Son espérance est alors la somme de cette famille :
\[E(X) = \sum_{x \in X(\Omega)} x \, P(X = x).\]
Pour \(X\) complexe, on a \(E(X) = E(\mathrm{Re}\, X) + i \, E(\mathrm{Im}\, X)\).
La sommabilité garantit que la somme ne dépend pas de l’ordre des termes. Par ailleurs, une variable bornée est toujours d’espérance finie. Une variable qui ne prend qu’un nombre fini de valeurs l’est donc aussi.
Pour justifier l’existence d’une espérance puis la calculer :
1. on étudie d’abord \(E(|X|)\), somme d’une famille positive, par comparaison, équivalent ou majoration ;
2. si cette somme est finie, on calcule \(E(X)\) en sommant dans l’ordre le plus commode ;
3. pour une variable à valeurs entières, on essaie aussi la formule \(E(X) = \sum_{n \geq\, 1} P(X \geq\, n)\).
II. Formule de transfert et propriétés de l’espérance
1. Formule de transfert
On veut souvent l’espérance de \(f(X)\) sans calculer la loi de \(f(X)\). La formule de transfert le permet directement à partir de la loi de \(X\).
Soit \(X\) une variable aléatoire discrète et \(f\) une fonction définie sur \(X(\Omega)\), à valeurs réelles ou complexes. Alors \(f(X)\) est d’espérance finie si et seulement si la famille \((f(x) P(X = x))_{x \in X(\Omega)}\) est sommable. Dans ce cas :
\[E(f(X)) = \sum_{x \in X(\Omega)} f(x) \, P(X = x).\]
Si \(f\) est à valeurs dans \([0, +\infty]\), l’égalité vaut toujours dans \([0, +\infty]\).
Posons \(Y = f(X)\). Les événements \((X = x)\), pour \(x \in f^{-1}(\{y\})\), partitionnent \((Y = y)\). Donc \(P(Y = y) = \sum_{f(x) = y} P(X = x)\). Le théorème de sommation par paquets, appliqué à la famille \((|f(x)| P(X = x))\) regroupée selon les valeurs de \(f\), donne l’équivalence des sommabilités. Ensuite, le même regroupement sur la famille sommable fournit l’égalité des sommes.
Si \(X\) suit la loi de Poisson \(\mathcal{P}(\lambda)\), alors \(\frac{1}{1+X}\) est bornée, donc d’espérance finie. Par transfert :
\[E(\frac{1}{1+X}) = \sum_{k=0}^{+\infty} \frac{e^{-\lambda} \lambda^k}{(k+1)!} = \frac{e^{-\lambda}}{\lambda} (e^{\lambda} – 1) = \frac{1 – e^{-\lambda}}{\lambda}.\]
2. Linéarité, positivité, croissance
Soient \(X\) et \(Y\) d’espérance finie et \(\lambda, \mu\) des scalaires.
1. Linéarité : \(\lambda X + \mu Y\) est d’espérance finie et \(E(\lambda X + \mu Y) = \lambda E(X) + \mu E(Y)\).
2. Positivité : si \(X \geq\, 0\) presque sûrement, alors \(E(X) \geq\, 0\) ; de plus, \(E(X) = 0\) si et seulement si \(X = 0\) presque sûrement.
3. Croissance : si \(X \leq\, Y\) presque sûrement (variables réelles), alors \(E(X) \leq\, E(Y)\).
4. Inégalité triangulaire : \(|E(X)| \leq\, E(|X|)\).
5. Domination : si \(|X| \leq\, Y\) et si \(Y\) est d’espérance finie, alors \(X\) est d’espérance finie.
La linéarité se démontre avec la formule de transfert appliquée au couple \((X, Y)\) et à \(f(x, y) = \lambda x + \mu y\). Elle ne demande aucune indépendance. En revanche, la formule du produit ci-dessous exige l’indépendance.
3. Espérance d’un produit de variables indépendantes
Si \(X\) et \(Y\) sont indépendantes et d’espérance finie, alors \(XY\) est d’espérance finie et
\[E(XY) = E(X) \, E(Y).\]
Par indépendance, \(P(X = x, Y = y) = P(X = x) P(Y = y)\). La famille \((|xy| P(X = x) P(Y = y))\) a pour somme \(E(|X|) E(|Y|) < +\infty\), d’après le produit de deux familles sommables. Elle est donc sommable. Ensuite, la formule de transfert pour le couple \((X, Y)\) et le même calcul sans valeurs absolues donnent \(E(XY) = E(X) E(Y)\).
Si \(X \sim \mathcal{P}(\lambda)\) et \(Y \sim \mathcal{P}(\mu)\) sont indépendantes, alors \(E(XY) = \lambda \mu\). Le calcul direct par une double somme serait bien plus long.
Le théorème s’étend à \(n\) variables mutuellement indépendantes : \(E(X_1 \cdots X_n) = E(X_1) \cdots E(X_n)\). De plus, si \(X\) et \(Y\) sont indépendantes, alors \(f(X)\) et \(g(Y)\) le sont aussi. Par conséquent, \(E(f(X) g(Y)) = E(f(X)) E(g(Y))\) dès que ces deux variables sont d’espérance finie. Ce lemme des coalitions sert constamment, par exemple pour calculer \(E(t^{X+Y}) = E(t^X) E(t^Y)\).
III. Moments d’ordre 2 et inégalité de Cauchy-Schwarz
1. Variables admettant un moment d’ordre 2
On dit que \(X\) admet un moment d’ordre 2 si \(X^2\) est d’espérance finie. Cette hypothèse est plus forte que l’existence de l’espérance.
Si \(X^2\) est d’espérance finie, alors \(X\) est d’espérance finie. De plus, si \(X^2\) et \(Y^2\) sont d’espérance finie, alors \(XY\) est d’espérance finie.
Pour tous réels \(a\) et \(b\), on a \(|ab| \leq\, \frac{1}{2}(a^2 + b^2)\), car \((|a| – |b|)^2 \geq\, 0\). Ainsi \(|XY| \leq\, \frac{1}{2}(X^2 + Y^2)\), et la domination conclut. Enfin, avec \(Y = 1\), on obtient \(|X| \leq\, \frac{1}{2}(1 + X^2)\).
2. Inégalité de Cauchy-Schwarz
Si \(X^2\) et \(Y^2\) sont d’espérance finie, alors
\[E(XY)^2 \leq\, E(X^2) \, E(Y^2).\]
Pour tout réel \(t\), la variable \((X + tY)^2\) est positive et d’espérance finie. Par linéarité :
\[0 \leq\, E((X + tY)^2) = E(X^2) + 2t \, E(XY) + t^2 E(Y^2).\]
Si \(E(Y^2) > 0\), ce trinôme en \(t\) garde un signe constant. Son discriminant est donc négatif ou nul, ce qui donne l’inégalité. Si \(E(Y^2) = 0\), alors \(Y = 0\) presque sûrement, donc \(E(XY) = 0\) et l’inégalité est vraie.
Avec \(Y = 1\), on obtient \(E(X)^2 \leq\, E(X^2)\). Par exemple, si \(X\) suit la loi uniforme sur \(\{1, 2, 3\}\), alors \(E(X)^2 = 4\) et \(E(X^2) = \frac{14}{3}\) : l’inégalité est bien stricte.
IV. Variance, écart type et lois usuelles
1. Variance et écart type
Soit \(X\) une variable réelle admettant un moment d’ordre 2. Sa variance et son écart type sont :
\[V(X) = E((X – E(X))^2), \qquad \sigma(X) = \sqrt{V(X)}.\]
1. Formule de König-Huygens : \(V(X) = E(X^2) – E(X)^2\).
2. Pour tous réels \(a\) et \(b\) : \(V(aX + b) = a^2 V(X)\) et \(\sigma(aX + b) = |a| \, \sigma(X)\).
3. \(V(X) = 0\) si et seulement si \(X\) est presque sûrement constante.
Le point 3 découle de la positivité stricte : une variable positive d’espérance nulle est nulle presque sûrement. Ensuite, on normalise une variable en la centrant puis en la réduisant.
Si \(\sigma(X) > 0\), la variable \(X^* = \dfrac{X – E(X)}{\sigma(X)}\) est la variable centrée réduite associée à \(X\). Elle vérifie \(E(X^*) = 0\) et \(V(X^*) = 1\).
2. Loi géométrique
Si \(X \sim \mathcal{G}(p)\), avec \(p \in \,]0, 1[\) et \(q = 1 – p\), alors
\[E(X) = \frac{1}{p}, \qquad V(X) = \frac{q}{p^2}.\]
D’abord, \(P(X \geq\, n) = q^{n-1}\) pour \(n \geq\, 1\). La formule des queues donne \(E(X) = \sum_{n \geq\, 1} q^{n-1} = \frac{1}{p}\). Ensuite, la série entière \(\sum n(n-1) x^{n-2}\) vaut \(\frac{2}{(1-x)^3}\) sur \(]-1, 1[\). Par transfert :
\[E(X(X-1)) = \sum_{n=1}^{+\infty} n(n-1) p q^{n-1} = pq \cdot \frac{2}{p^3} = \frac{2q}{p^2}.\]
Enfin, \(V(X) = E(X(X-1)) + E(X) – E(X)^2 = \frac{2q + p – 1}{p^2} = \frac{q}{p^2}\).
3. Loi de Poisson
Si \(X \sim \mathcal{P}(\lambda)\), avec \(\lambda > 0\), alors \(E(X) = V(X) = \lambda\).
Par transfert, les séries étant à termes positifs :
\[E(X) = \sum_{k=1}^{+\infty} k e^{-\lambda} \frac{\lambda^k}{k!} = \lambda e^{-\lambda} \sum_{k=1}^{+\infty} \frac{\lambda^{k-1}}{(k-1)!} = \lambda.\]
De même, \(E(X(X-1)) = \lambda^2 e^{-\lambda} \sum_{k \geq\, 2} \frac{\lambda^{k-2}}{(k-2)!} = \lambda^2\). Par conséquent, \(V(X) = \lambda^2 + \lambda – \lambda^2 = \lambda\).
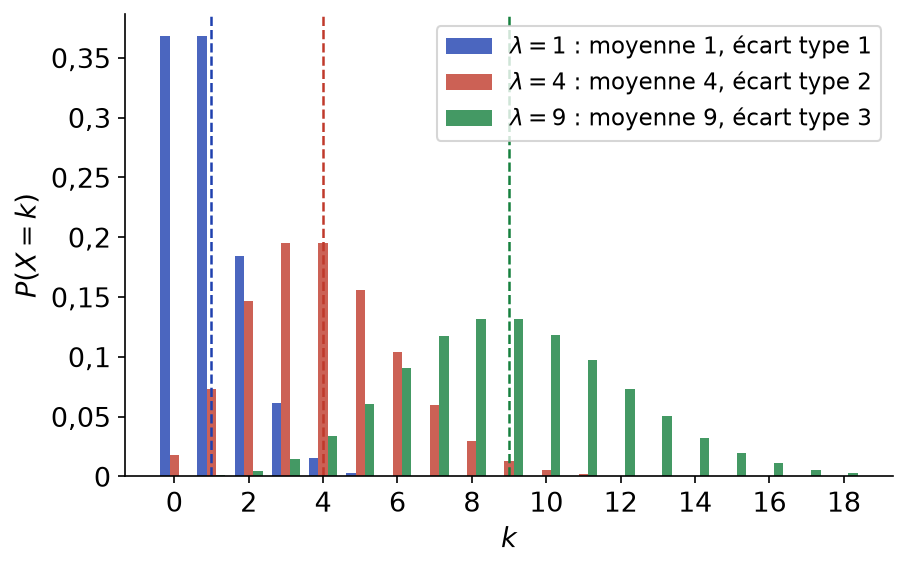
La figure ci-dessous montre trois lois de Poisson. On y voit la moyenne \(\lambda\) se déplacer vers la droite. De plus, l’étalement autour de la moyenne croît comme \(\sqrt{\lambda}\).
On rappelle aussi les résultats de première année : une variable de Bernoulli \(\mathcal{B}(p)\) a pour espérance \(p\) et pour variance \(p(1-p)\) ; une variable binomiale \(\mathcal{B}(n, p)\) a pour espérance \(np\) et pour variance \(np(1-p)\).
Pour une variable à valeurs entières, calculez plutôt le moment factoriel \(E(X(X-1))\) que \(E(X^2)\). En effet, le facteur \(k(k-1)\) se simplifie avec \(k!\) ou provient d’une dérivée seconde de série entière. Ensuite, \(V(X) = E(X(X-1)) + E(X) – E(X)^2\).
V. Covariance et variance d’une somme
1. Covariance
Si \(X\) et \(Y\) admettent un moment d’ordre 2, leur covariance est
\[\mathrm{Cov}(X, Y) = E\big((X – E(X))(Y – E(Y))\big) = E(XY) – E(X) E(Y).\]
1. La covariance est bilinéaire, symétrique et \(\mathrm{Cov}(X, X) = V(X)\).
2. Si \(X\) et \(Y\) sont indépendantes, alors \(\mathrm{Cov}(X, Y) = 0\).
3. Par Cauchy-Schwarz appliquée aux variables centrées : \(|\mathrm{Cov}(X, Y)| \leq\, \sigma(X) \, \sigma(Y)\).
Le signe de la covariance indique une tendance. Ainsi, une covariance positive signale que \(X\) et \(Y\) ont tendance à dépasser leurs moyennes en même temps. La figure ci-dessous représente trois lois de couples : la taille d’un disque est proportionnelle à la probabilité du point.
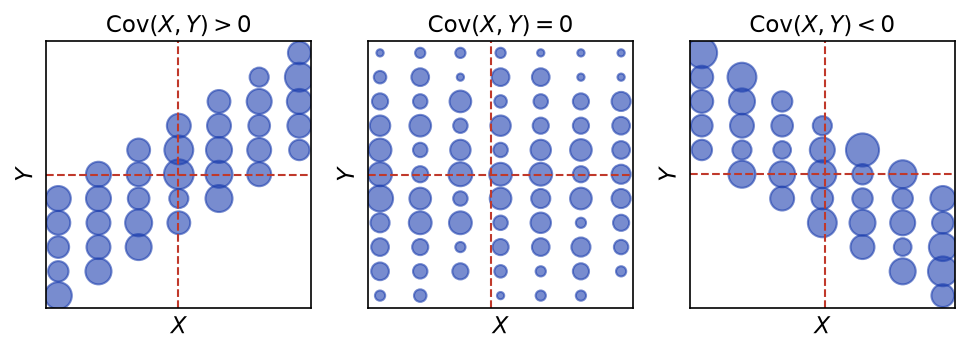
La réciproque du point 2 est fausse. Par exemple, si \(X\) suit la loi uniforme sur \(\{-1, 0, 1\}\) et \(Y = X^2\), alors \(\mathrm{Cov}(X, Y) = E(X^3) – E(X)E(X^2) = 0\). Pourtant, \(P(X = 0, Y = 1) = 0\) alors que \(P(X = 0) P(Y = 1) = \frac{2}{9}\).
2. Variance d’une somme
Si \(X_1, \ldots, X_n\) admettent un moment d’ordre 2, alors
\[V(\sum_{i=1}^{n} X_i) = \sum_{i=1}^{n} V(X_i) + 2 \sum_{1 \leq\, i < j \leq\, n} \mathrm{Cov}(X_i, X_j).\]
En particulier, si les \(X_i\) sont deux à deux indépendantes, la variance de la somme est la somme des variances.
Par bilinéarité, \(V(S) = \mathrm{Cov}(S, S) = \sum_{i, j} \mathrm{Cov}(X_i, X_j)\). On sépare ensuite les termes diagonaux \(i = j\), qui donnent les variances, des termes \(i \neq j\), regroupés par symétrie.
Pour la variance d’une variable de comptage \(N\) :
1. écrivez \(N = \sum_{i} \mathbf{1}_{A_i}\) comme somme d’indicatrices ;
2. utilisez \(V(\mathbf{1}_{A_i}) = P(A_i)(1 – P(A_i))\) ;
3. calculez \(\mathrm{Cov}(\mathbf{1}_{A_i}, \mathbf{1}_{A_j}) = P(A_i \cap A_j) – P(A_i) P(A_j)\) ;
4. assemblez avec la formule de la variance d’une somme.
Lançons \(n\) fois un dé équilibré. Soit \(N\) le nombre de six. On a \(N = \sum \mathbf{1}_{A_i}\), où \(A_i\) est l’événement « le \(i\)-ème lancer donne six ». Les lancers sont indépendants, donc les covariances sont nulles. Ainsi, \(V(N) = n \cdot \frac{1}{6} \cdot \frac{5}{6} = \frac{5n}{36}\).
VI. Inégalités de Markov et de Bienaymé-Tchebychev
Les inégalités de concentration majorent la probabilité qu’une variable s’éloigne de sa moyenne. Elles ne demandent que des moments et non la loi entière.
Inégalité de Markov. Si \(X\) est une variable positive d’espérance finie, alors pour tout \(a > 0\) :
\[P(X \geq\, a) \leq\, \frac{E(X)}{a}.\]
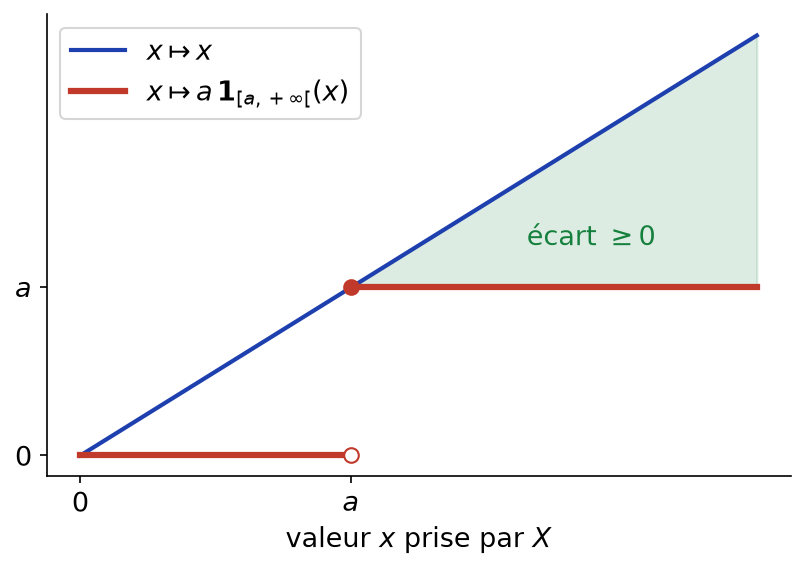
On a l’inégalité ponctuelle \(a \mathbf{1}_{(X \geq\, a)} \leq\, X\). En effet, elle est évidente si \(X < a\), puisque le membre de gauche est nul, et elle se lit \(a \leq\, X\) sinon. Par croissance de l’espérance, \(a P(X \geq\, a) \leq\, E(X)\).
La figure ci-dessous visualise cette inégalité ponctuelle. La fonction en escalier \(a \mathbf{1}_{[a, +\infty[}\) reste sous la première bissectrice sur \([0, +\infty[\).
Inégalité de Bienaymé-Tchebychev. Si \(X\) admet un moment d’ordre 2, alors pour tout \(\varepsilon > 0\) :
\[P\big(|X – E(X)| \geq\, \varepsilon\big) \leq\, \frac{V(X)}{\varepsilon^2}.\]
Les événements \((|X – E(X)| \geq\, \varepsilon)\) et \(((X – E(X))^2 \geq\, \varepsilon^2)\) sont égaux. On applique donc Markov à la variable positive \((X – E(X))^2\), d’espérance \(V(X)\).
Si \(X \sim \mathcal{P}(100)\), alors \(P(|X – 100| \geq\, 30) \leq\, \frac{100}{900} = \frac{1}{9}\). Autrement dit, \(X\) tombe dans \(]70, 130[\) avec une probabilité au moins \(\frac{8}{9}\).
On peut appliquer Markov à \(\varphi(X)\) pour toute fonction \(\varphi\) positive et croissante. Par exemple, avec \(\varphi(x) = e^{tx}\) et \(t > 0\), on obtient \(P(X \geq\, a) \leq\, e^{-ta} E(e^{tX})\). Cette borne exponentielle est souvent bien plus fine.
Pour établir une inégalité de concentration :
1. repérez l’événement à majorer et incluez-le dans un événement de la forme \((|X – E(X)| \geq\, \varepsilon)\) ou \((\varphi(X) \geq\, \varphi(a))\) ;
2. calculez le moment nécessaire : \(E(X)\) pour Markov, \(V(X)\) pour Bienaymé-Tchebychev, \(E(e^{tX})\) pour une borne exponentielle ;
3. appliquez l’inégalité, puis optimisez les paramètres libres, comme \(t\) dans la borne exponentielle.
VII. Loi faible des grands nombres
Répétons une même expérience de façon indépendante. L’intuition dit que la moyenne des résultats se stabilise autour de l’espérance. La loi faible des grands nombres en donne une version précise.
Soit \((X_n)_{n \geq\, 1}\) une suite de variables aléatoires deux à deux indépendantes, de même loi, admettant un moment d’ordre 2. On note \(m = E(X_1)\), \(\sigma = \sigma(X_1)\) et \(S_n = X_1 + \cdots + X_n\). Alors, pour tout \(\varepsilon > 0\) :
\[P(|\frac{S_n}{n} – m| \geq\, \varepsilon) \leq\, \frac{\sigma^2}{n \varepsilon^2} \xrightarrow[n \to +\infty]{ 0.\]
Par linéarité, \(E(S_n / n) = m\). Ensuite, les covariances sont nulles, donc \(V(S_n) = n \sigma^2\) et \(V(S_n / n) = \frac{\sigma^2}{n}\). Il reste à appliquer Bienaymé-Tchebychev à \(S_n / n\).
La figure ci-dessous montre cinq trajectoires de la moyenne des lancers d’un dé équilibré. Toutes finissent dans la bande \(3{,}5 \pm 0{,}25\), comme l’annonce le théorème.
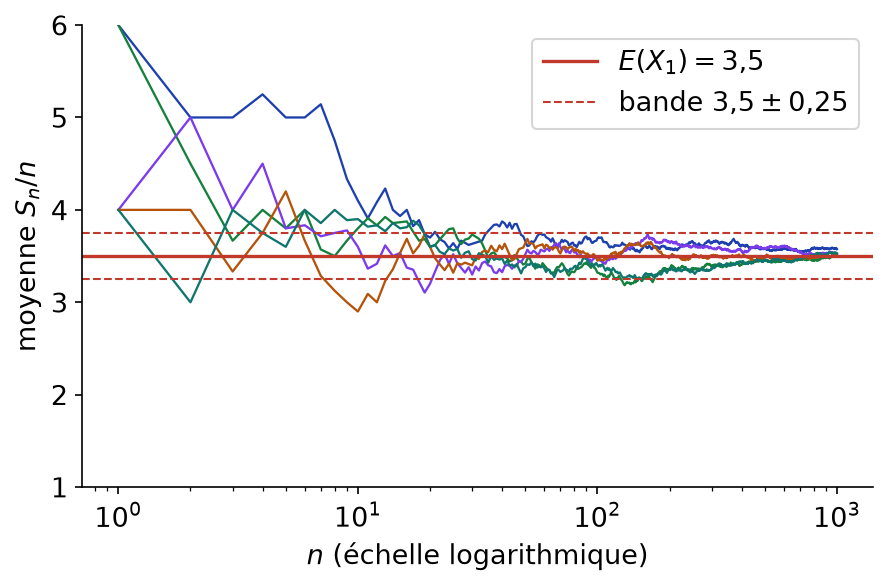
Soit \(A\) un événement de probabilité \(p\). On répète l’expérience et on note \(F_n\) la fréquence d’apparition de \(A\) sur \(n\) essais. Avec \(X_i = \mathbf{1}_{A_i}\), on a \(\sigma^2 = p(1-p) \leq\, \frac{1}{4}\). Donc \(P(|F_n – p| \geq\, \varepsilon) \leq\, \frac{1}{4 n \varepsilon^2}\). C’est la justification de l’approche fréquentiste : la fréquence observée estime la probabilité.
La preuve n’utilise que la nullité des covariances. Par conséquent, le théorème reste vrai pour des variables deux à deux non corrélées, de même espérance et de variances bornées. En revanche, sans moment d’ordre 2, cette démonstration ne s’applique plus.
Enfin, retenons l’ordre de grandeur. L’écart typique entre \(S_n / n\) et \(m\) est de l’ordre de \(\sigma / \sqrt{n}\). Ainsi, pour diviser l’incertitude par 10, il faut multiplier le nombre d’essais par 100. C’est une contrainte forte dans toutes les méthodes de simulation.
Ce qu’il faut retenir
- Pour \(X \geq\, 0\), l’espérance existe toujours dans \([0, +\infty]\) ; une variable réelle ou complexe est d’espérance finie si et seulement si \(E(|X|) < +\infty\).
- Pour \(X\) à valeurs entières : \(E(X) = \sum_{n \geq\, 1} P(X \geq\, n)\).
- Formule de transfert : \(E(f(X)) = \sum f(x) P(X = x)\), sous réserve de sommabilité.
- L’espérance est linéaire, positive et croissante ; \(E(XY) = E(X)E(Y)\) exige l’indépendance.
- Cauchy-Schwarz : \(E(XY)^2 \leq\, E(X^2) E(Y^2)\), et un moment d’ordre 2 entraîne l’espérance finie.
- \(V(X) = E(X^2) – E(X)^2\), \(V(aX + b) = a^2 V(X)\) ; \(X^* = (X – E(X))/\sigma(X)\) est centrée réduite.
- Loi géométrique : \(E = 1/p\), \(V = q/p^2\) ; loi de Poisson : \(E = V = \lambda\).
- \(V(\sum X_i) = \sum V(X_i) + 2 \sum_{i < j} \mathrm{Cov}(X_i, X_j)\) ; covariance nulle n’implique pas indépendance.
- Markov : \(P(X \geq\, a) \leq\, E(X)/a\) ; Bienaymé-Tchebychev : \(P(|X – E(X)| \geq\, \varepsilon) \leq\, V(X)/\varepsilon^2\).
- Loi faible des grands nombres : \(P(|S_n / n – m| \geq\, \varepsilon) \leq\, \sigma^2 / (n \varepsilon^2) \to 0\).
Questions fréquentes sur espérance et variance
Quelle différence entre une espérance infinie et une espérance qui n'existe pas ?
Pour une variable positive, l’espérance existe toujours dans \([0, +\infty]\) et peut valoir \(+\infty\). Pour une variable réelle quelconque, on exige \(E(|X|) < +\infty\) : sinon, la famille \((x P(X = x))\) n’est pas sommable et l’on ne définit pas \(E(X)\). Dire « \(X\) est d’espérance finie » signifie donc exactement \(E(|X|) < +\infty\).
Quand utiliser la formule E(X) = Σ P(X ≥ n) ?
Elle s’applique aux variables à valeurs dans \(\mathbb{N}\). Elle est efficace quand les probabilités \(P(X \geq\, n)\) se calculent mieux que les \(P(X = n)\), par exemple pour un minimum de variables indépendantes ou un temps d’attente. Elle se démontre par interversion de sommes dans une famille positive.
Une covariance nulle entraîne-t-elle l'indépendance ?
Non. L’indépendance entraîne une covariance nulle, mais la réciproque est fausse. Par exemple, si \(X\) est uniforme sur \(\{-1, 0, 1\}\) et \(Y = X^2\), alors \(\mathrm{Cov}(X, Y) = 0\) alors que \(Y\) est une fonction de \(X\).
Faut-il l'indépendance mutuelle pour la loi faible des grands nombres ?
Non. La démonstration par Bienaymé-Tchebychev n’utilise que \(V(S_n) = n\sigma^2\), donc la nullité des covariances. Des variables deux à deux indépendantes, ou même seulement non corrélées, de même loi et de variance finie, suffisent.
Pour aller plus loin en maths spé
- Les énoncés : exercices de maths spé sur espérance et variance
- À maîtriser avant : Variables aléatoires discrètes et lois usuelles
- Chapitre précédent : Variables aléatoires discrètes et lois usuelles
- Chapitre suivant : Fonctions génératrices
- Le même thème en maths sup : espérance et variance, cours de maths sup
- Tester vos connaissances : QCM de maths spé par chapitre
- Le sommaire : tous les chapitres de maths spé et les chapitres de maths sup