Ce corrigé espérance sup rédige chaque solution comme en devoir surveillé. Les calculs d’espérance citent la propriété utilisée : linéarité, formule de transfert ou indépendance. Pour une variable de comptage, la variable est d’abord écrite comme une somme d’indicatrices, puis la variance est obtenue par les covariances.
Plusieurs points demandent de la vigilance. D’abord, \(E(XY) = E(X)E(Y)\) exige l’indépendance, contrairement à la linéarité. Ensuite, une covariance nulle ne prouve jamais l’indépendance. De plus, les inégalités de Bienaymé-Tchebychev donnent des tailles d’échantillon suffisantes, mais pas nécessaires. Enfin, les résultats sont contrôlés par un second calcul chaque fois que c’est possible, et des figures illustrent les lois obtenues et la régression linéaire.
Les énoncés se trouvent sur la page exercices de maths sup sur espérance et variance.
Corrigé de l’exercice 1 : Espérance et variance à partir d’une loi
- Par définition de l’espérance :
\[E(X) = -2 \times 0{,}1 + 0 \times 0{,}3 + 1 \times 0{,}4 + 3 \times 0{,}2 = -0{,}2 + 0{,}4 + 0{,}6.\]
Donc \(E(X) = 0{,}8\). - Les valeurs de \(X^2\) sont \(4\), \(0\), \(1\) et \(9\). Elles sont deux à deux distinctes, donc \(Y\) prend la valeur \(0\) avec probabilité \(0{,}3\), \(1\) avec probabilité \(0{,}4\), \(4\) avec probabilité \(0{,}1\) et \(9\) avec probabilité \(0{,}2\). Avec cette loi, \(E(Y) = 0 + 0{,}4 + 0{,}4 + 1{,}8 = 2{,}6\). Ensuite, la formule de transfert donne \(E(X^2) = 4 \times 0{,}1 + 0 \times 0{,}3 + 1 \times 0{,}4 + 9 \times 0{,}2 = 2{,}6\). Les deux méthodes donnent \(E(Y) = 2{,}6\).
- Par la formule de König-Huygens, \(V(X) = E(X^2) – E(X)^2 = 2{,}6 – 0{,}64 = 1{,}96\). Ainsi \(V(X) = 1{,}96\) et \(\sigma(X) = 1{,}4\).
- On applique la formule de transfert avec \(f(x) = |x – 1|\) :
\[E(|X – 1|) = 3 \times 0{,}1 + 1 \times 0{,}3 + 0 \times 0{,}4 + 2 \times 0{,}2 = 0{,}3 + 0{,}3 + 0{,}4.\]
Donc \(E(|X – 1|) = 1\).
Point de méthode : la formule de transfert évite de chercher la loi de \(f(X)\). Elle est surtout utile quand \(f\) n’est pas injective.
Corrigé de l’exercice 2 : Loi à paramètre et formule de transfert
- La somme des probabilités vaut \(1\) : \(c(1 + 2 + 3 + 4) = 10c = 1\). De plus, avec \(c = \frac{1}{10}\), toutes les probabilités sont positives. Donc \(c = \frac{1}{10}\).
- On calcule \(E(X) = \frac{1}{10}\sum_{k=1}^{4} k^2 = \frac{30}{10} = 3\). Ensuite, par transfert, \(E(X^2) = \frac{1}{10}\sum_{k=1}^{4} k^3 = \frac{1 + 8 + 27 + 64}{10} = 10\). Par conséquent, \(V(X) = 10 – 9\). On obtient \(E(X) = 3\), \(E(X^2) = 10\) et \(V(X) = 1\).
- Par la formule de transfert, \(E\big(\frac{1}{X}\big) = \sum_{k=1}^{4} \frac{1}{k} \cdot \frac{k}{10} = \frac{4}{10}\). De même,
\[E(2^X) = \frac{2 \times 1 + 4 \times 2 + 8 \times 3 + 16 \times 4}{10} = \frac{98}{10}.\]
Donc \(E\big(\frac{1}{X}\big) = \frac{2}{5}\) et \(E(2^X) = \frac{49}{5}\). Enfin, \(\frac{1}{E(X)} = \frac{1}{3} < \frac{2}{5}\) : l’espérance de l’inverse n’est pas l’inverse de l’espérance.
Corrigé de l’exercice 3 : Transformation affine et variable centrée réduite
- Par linéarité, \(E(Y) = \frac{E(X) – m}{\sigma} = 0\). Ensuite, d’après \(V(aX + b) = a^2V(X)\), on a \(V(Y) = \frac{V(X)}{\sigma^2} = 1\). La variable \(Y\) est centrée réduite.
- Soit \(Z = aX + b\) avec \(a > 0\). D’une part, \(E(Z) = am + b\), donc \(Z\) est centrée si et seulement si \(b = -am\). D’autre part, \(V(Z) = a^2\sigma^2\) vaut \(1\) si et seulement si \(a = \frac{1}{\sigma}\), car \(a > 0\). Ainsi \(a = \frac{1}{\sigma}\), \(b = -\frac{m}{\sigma}\) et \(Z = Y\).
- D’abord, \(E(D) = \frac{7}{2}\). Ensuite, \(E(D^2) = \frac{1 + 4 + 9 + 16 + 25 + 36}{6} = \frac{91}{6}\). Donc \(V(D) = \frac{91}{6} – \frac{49}{4} = \frac{182 – 147}{12} = \frac{35}{12}\). Par linéarité, \(E(3 – 2D) = 3 – 7 = -4\). Enfin, \(V(3 – 2D) = (-2)^2 V(D) = \frac{140}{12}\). On trouve \(V(D) = \frac{35}{12}\), \(E(3 – 2D) = -4\) et \(V(3 – 2D) = \frac{35}{3}\).
Corrigé de l’exercice 4 : Loi uniforme sur un intervalle d’entiers
- On a \(E(X) = \frac{1}{n}\sum_{k=1}^{n} k = \frac{n+1}{2}\). Ensuite, par transfert, \(E(X^2) = \frac{1}{n}\sum_{k=1}^{n} k^2 = \frac{(n+1)(2n+1)}{6}\). Par König-Huygens :
\[V(X) = \frac{(n+1)(2n+1)}{6} – \frac{(n+1)^2}{4} = \frac{(n+1)\big(2(2n+1) – 3(n+1)\big)}{12} = \frac{(n+1)(n-1)}{12}.\]
Donc \(E(X) = \frac{n+1}{2}\) et \(V(X) = \frac{n^2 – 1}{12}\). - On pose \(n = b – a + 1\) et \(X\) uniforme sur \(\{1, \ldots, n\}\). La variable \(X + a – 1\) prend chaque valeur \(u \in \{a, \ldots, b\}\) avec probabilité \(P(X = u – a + 1) = \frac{1}{n}\). Elle a donc la loi de \(U\). Par conséquent, \(E(U) = \frac{n+1}{2} + a – 1 = \frac{b – a + 2}{2} + a – 1\). Enfin, une translation ne change pas la variance. Donc \(E(U) = \frac{a+b}{2}\) et \(V(U) = \frac{(b – a + 1)^2 – 1}{12}\).
- Ici \(a = 0\) et \(b = 10\), donc \(n = 11\). L’espérance vaut \(5\) et la variance \(\frac{121 – 1}{12} = 10\).
Corrigé de l’exercice 5 : Moments de la loi binomiale par le calcul direct
- Pour \(1 \leq\, k \leq\, n\) :
\[k\binom\,{n}{k} = \frac{n!}{(k-1)!\,(n-k)!} = n \cdot \frac{(n-1)!}{(k-1)!\,\big((n-1) – (k-1)\big)!} = n\binom\,{n-1}{k-1}.\]
Ensuite, pour \(2 \leq\, k \leq\, n\), on applique cette formule deux fois, la seconde avec \(n – 1\) et \(k – 1\) : \(k(k-1)\binom\,{n}{k} = n(k-1)\binom\,{n-1}{k-1} = n(n-1)\binom\,{n-2}{k-2}\). Les deux identités sont établies. - Le terme \(k = 0\) est nul. Puis on pose \(j = k – 1\) :
\[E(X) = \sum_{k=1}^{n} n\binom\,{n-1}{k-1} p^k q^{n-k} = np\sum_{j=0}^{n-1}\binom\,{n-1}{j} p^j q^{n-1-j} = np(p + q)^{n-1}.\]
Comme \(p + q = 1\), on obtient \(E(X) = np\). - Par transfert, les termes \(k = 0\) et \(k = 1\) sont nuls. On pose ensuite \(j = k – 2\) :
\[E\big(X(X-1)\big) = n(n-1)p^2\sum_{j=0}^{n-2}\binom\,{n-2}{j}p^j q^{n-2-j} = n(n-1)p^2.\]
Donc \(E(X(X-1)) = n(n-1)p^2\). - Par linéarité, \(E(X^2) = E(X(X-1)) + E(X) = n(n-1)p^2 + np\). Ainsi, \(V(X) = n(n-1)p^2 + np – n^2p^2 = np – np^2\). On retrouve \(V(X) = np(1-p)\).
Point de méthode : le moment \(E(X(X-1))\), dit factoriel, se calcule mieux que \(E(X^2)\), car \(k(k-1)\) se simplifie avec \(k!\).
Corrigé de l’exercice 6 : Espérance d’une variable à valeurs complexes
- Par la formule de transfert, puis par la formule du binôme :
\[E\big(e^{i\theta X}\big) = \sum_{k=0}^{n}\binom\,{n}{k}\big(pe^{i\theta}\big)^k q^{n-k} = \big(q + pe^{i\theta}\big)^n.\]
Donc \(E(e^{i\theta X}) = (q + pe^{i\theta})^n\). - Pour \(p = \frac{1}{2}\), on factorise par l’angle moitié : \(\frac{1 + e^{i\theta}}{2} = e^{i\theta/2}\,\frac{e^{-i\theta/2} + e^{i\theta/2}}{2} = e^{i\theta/2}\cos(\theta/2)\). Par conséquent, \(E(e^{i\theta X}) = e^{in\theta/2}\cos^n(\theta/2)\). Son module vaut \(|\cos(\theta/2)|^n\). Pour \(\theta = \pi\), on obtient \(E(e^{i\pi X}) = 0\), car \(\cos(\pi/2) = 0\) et \(n \geq\, 1\). Or \(\cos(\pi X)\) est la partie réelle de \(e^{i\pi X}\), donc \(E(\cos(\pi X)) = \mathrm{Re}\big(E(e^{i\pi X})\big) = 0\). Ainsi \(E(\cos(\pi X)) = 0\). De plus, \(\cos(\pi X) = (-1)^X\) vaut \(1\) si \(X\) est pair et \(-1\) sinon. Donc \(P(X \text{ pair}) – P(X \text{ impair}) = 0\). Autrement dit, \(P(X \text{ pair}) = \frac{1}{2}\).
- On note \(\omega = e^{2i\pi k/n}\). Par transfert, \(E(Z^k) = \frac{1}{n}\sum_{u=0}^{n-1}\omega^u\). Si \(n\) divise \(k\), alors \(\omega = 1\) et la somme vaut \(n\). Sinon, \(\omega \neq 1\) et la somme géométrique vaut \(\frac{1 – \omega^n}{1 – \omega} = 0\), car \(\omega^n = e^{2i\pi k} = 1\). Donc \(E(Z^k) = 1\) si \(n \mid k\) et \(E(Z^k) = 0\) sinon. En particulier, comme \(n \geq\, 2\), \(E(Z) = 0\). Or \(|Z| = 1\), donc \(E(|Z|) = 1\). L’inégalité \(|E(Z)| \leq\, E(|Z|)\) est ici stricte : \(0 < 1\).
Corrigé de l’exercice 7 : Formule de transfert et inverse d’une binomiale
- Pour \(0 \leq\, k \leq\, n\), on a \((n+1) – (k+1) = n – k\). Donc
\[\frac{1}{k+1}\binom\,{n}{k} = \frac{n!}{(k+1)!\,(n-k)!} = \frac{1}{n+1}\cdot\frac{(n+1)!}{(k+1)!\,(n-k)!} = \frac{1}{n+1}\binom\,{n+1}{k+1}.\]
L’identité est démontrée. - Par la formule de transfert, puis la question 1, et enfin avec \(j = k + 1\) :
\[E\Big(\frac{1}{X+1}\Big) = \frac{1}{(n+1)p}\sum_{k=0}^{n}\binom\,{n+1}{k+1}p^{k+1}q^{n-k} = \frac{1}{(n+1)p}\sum_{j=1}^{n+1}\binom\,{n+1}{j}p^j q^{n+1-j}.\]
La dernière somme est le binôme \((p + q)^{n+1} = 1\) privé de son terme \(j = 0\), qui vaut \(q^{n+1}\). Donc \(E\big(\frac{1}{X+1}\big) = \frac{1 – q^{n+1}}{(n+1)p}\). - Pour \(n = 1\), \(X\) vaut \(0\) avec probabilité \(q\) et \(1\) avec probabilité \(p\). Directement, \(E\big(\frac{1}{X+1}\big) = q + \frac{p}{2}\). Par ailleurs, la formule donne \(\frac{1 – q^2}{2p} = \frac{(1 – q)(1 + q)}{2p} = \frac{1 + q}{2} = \frac{2 – p}{2}\). Les deux valent \(1 – \frac{p}{2}\).
- Pour \(n = 2\) et \(p = \frac{1}{2}\), la formule donne \(\frac{1 – 1/8}{3/2} = \frac{7}{8}\cdot\frac{2}{3} = \frac{7}{12}\). On le vérifie : \(\frac{1}{4}\cdot 1 + \frac{1}{2}\cdot\frac{1}{2} + \frac{1}{4}\cdot\frac{1}{3} = \frac{7}{12}\). En revanche, \(E(X) = 1\), donc \(\frac{1}{E(X) + 1} = \frac{1}{2}\). On a \(E\big(\frac{1}{X+1}\big) = \frac{7}{12} > \frac{1}{2} = \frac{1}{E(X)+1}\).
Corrigé de l’exercice 8 : Espérance à l’aide des probabilités P(X ≥ k)
- Pour \(1 \leq\, k \leq\, n\), on a \(P(X \geq\, k) = \sum_{j=k}^{n}P(X = j)\). On échange ensuite les deux sommes finies :
\[\sum_{k=1}^{n}P(X \geq\, k) = \sum_{j=1}^{n}\sum_{k=1}^{j}P(X = j) = \sum_{j=1}^{n}j\,P(X = j).\]
Le terme \(j = 0\) de l’espérance est nul. Donc \(E(X) = \sum_{k=1}^{n}P(X \geq\, k)\). - Notons \(D_1\) et \(D_2\) les deux dés. L’événement \(\{M \leq\, k\}\) est \(\{D_1 \leq\, k\} \cap \{D_2 \leq\, k\}\). Par indépendance, \(P(M \leq\, k) = \frac{k^2}{36}\). Ensuite, \(P(M \geq\, k) = 1 – P(M \leq\, k – 1) = 1 – \frac{(k-1)^2}{36}\). Donc
\[E(M) = \sum_{k=1}^{6}\Big(1 – \frac{(k-1)^2}{36}\Big) = 6 – \frac{0 + 1 + 4 + 9 + 16 + 25}{36} = 6 – \frac{55}{36}.\]
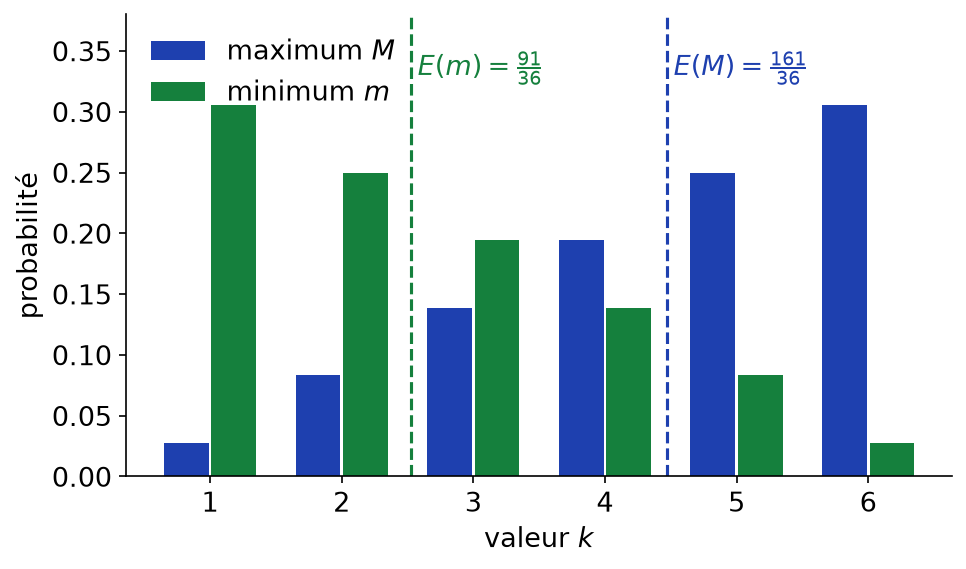
Ainsi \(E(M) = \frac{161}{36} \approx 4{,}47\). - Pour \(1 \leq\, k \leq\, 6\), on a \(P(M = k) = P(M \leq\, k) – P(M \leq\, k-1) = \frac{k^2 – (k-1)^2}{36}\). Donc \(P(M = k) = \frac{2k – 1}{36}\). On vérifie : \(\sum_{k=1}^{6}k(2k – 1) = 2 \times 91 – 21 = 161\). On retrouve bien \(E(M) = \frac{161}{36}\).
- De même, \(\{m \geq\, k\} = \{D_1 \geq\, k\} \cap \{D_2 \geq\, k\}\), donc \(P(m \geq\, k) = \frac{(7 – k)^2}{36}\). Par la question 1 :
\[E(m) = \frac{36 + 25 + 16 + 9 + 4 + 1}{36} = \frac{91}{36}.\]
Donc \(E(m) = \frac{91}{36} \approx 2{,}53\). Contrôle : \(M + m = D_1 + D_2\), donc \(E(M) + E(m) = 7\). Or \(\frac{161 + 91}{36} = \frac{252}{36} = 7\). La figure ci-dessous montre les deux lois : elles sont symétriques l’une de l’autre par rapport à \(\frac{7}{2}\).
Corrigé de l’exercice 9 : Covariance nulle sans indépendance
- Par symétrie, \(E(X) = \frac{-1 + 0 + 1}{3} = 0\). Ensuite, \(Y\) suit la loi de Bernoulli de paramètre \(P(X \neq 0) = \frac{2}{3}\), donc \(E(Y) = \frac{2}{3}\). De plus, \(XY = X^3 = X\), car \(X \in \{-1, 0, 1\}\). Donc \(E(XY) = 0\). Ainsi \(\mathrm{Cov}(X, Y) = 0 – 0 \times \frac{2}{3} = 0\).
- On a \(P(X = 0, Y = 1) = 0\), car \(X = 0\) impose \(Y = 0\). Cependant, \(P(X = 0)P(Y = 1) = \frac{1}{3}\cdot\frac{2}{3} = \frac{2}{9} \neq 0\). Les variables \(X\) et \(Y\) ne sont pas indépendantes, bien que décorrélées.
- D’abord, \(V(X) = E(X^2) = \frac{2}{3}\) et \(V(Y) = \frac{2}{3}\cdot\frac{1}{3} = \frac{2}{9}\). Comme la covariance est nulle, \(V(X + Y) = \frac{2}{3} + \frac{2}{9} = \frac{8}{9}\). Vérifions avec la loi. Si \(X = -1\) ou \(X = 0\), alors \(X + Y = 0\) ; si \(X = 1\), alors \(X + Y = 2\). Donc \(X + Y = 2B\), avec \(B \sim \mathcal{B}(\frac{1}{3})\). Ainsi \(V(X + Y) = 4 \cdot \frac{1}{3}\cdot\frac{2}{3}\). Les deux méthodes donnent \(V(X + Y) = \frac{8}{9}\).
Corrigé de l’exercice 10 : Couple défini par un tableau
- On somme les lignes, puis les colonnes. On obtient \(P(X = 0) = 0{,}3\), \(P(X = 1) = 0{,}3\), \(P(X = 2) = 0{,}4\), puis \(P(Y = 0) = 0{,}6\) et \(P(Y = 1) = 0{,}4\).
- On calcule \(E(X) = 0{,}3 + 0{,}8 = 1{,}1\) et \(E(X^2) = 0{,}3 + 1{,}6 = 1{,}9\). Donc \(V(X) = 1{,}9 – 1{,}21\). Ensuite, \(Y \sim \mathcal{B}(0{,}4)\). Ainsi \(E(X) = 1{,}1\), \(V(X) = 0{,}69\), \(E(Y) = 0{,}4\) et \(V(Y) = 0{,}24\).
- Par transfert, seuls les termes où \(xy \neq 0\) comptent : \(E(XY) = 1 \times 1 \times 0{,}1 + 2 \times 1 \times 0{,}1 = 0{,}3\). Donc \(\mathrm{Cov}(X, Y) = 0{,}3 – 1{,}1 \times 0{,}4 = -0{,}14\). La covariance vaut \(-0{,}14\). Elle est non nulle, donc \(X\) et \(Y\) ne sont pas indépendantes.
- Par bilinéarité de la covariance :
\[\begin{aligned} V(X + Y) = 0{,}69 + 0{,}24 – 0{,}28 = 0{,}65, \\ V(X – Y) = 0{,}69 + 0{,}24 + 0{,}28 = 1{,}21, \\ V(2X – 3Y) = 4 \times 0{,}69 + 9 \times 0{,}24 – 12 \times (-0{,}14) = 6{,}6. \end{aligned}\]
Vérifions la première valeur. La variable \(S = X + Y\) vaut \(0\) avec probabilité \(0{,}1\), \(1\) avec probabilité \(0{,}2 + 0{,}2 = 0{,}4\), \(2\) avec probabilité \(0{,}1 + 0{,}3 = 0{,}4\) et \(3\) avec probabilité \(0{,}1\). Ainsi \(E(S) = 1{,}5\) et \(E(S^2) = 0{,}4 + 1{,}6 + 0{,}9 = 2{,}9\). On retrouve \(V(X + Y) = 2{,}9 – 2{,}25 = 0{,}65\) ; de plus \(V(X – Y) = 1{,}21\) et \(V(2X – 3Y) = 6{,}6\).
Corrigé de l’exercice 11 : Espérance et variance d’un produit indépendant
- Les variables \(X\) et \(Y\) sont indépendantes. D’après le lemme des coalitions, \(X^2\) et \(Y^2\) le sont aussi. Donc \(E(X^2Y^2) = E(X^2)E(Y^2)\) et \(E(XY) = E(X)E(Y)\). On écrit \(E(X^2) = V(X) + E(X)^2\), et de même pour \(Y\). En développant :
\[V(XY) = \big(V(X) + E(X)^2\big)\big(V(Y) + E(Y)^2\big) – E(X)^2E(Y)^2.\]
Après simplification, \(V(XY) = V(X)V(Y) + V(X)E(Y)^2 + V(Y)E(X)^2\). - Le produit \(XY\) prend ses valeurs dans \(\{0, 1\}\). Par indépendance, \(P(XY = 1) = P(X = 1)P(Y = 1) = pp^{\prime}\). Donc \(XY \sim \mathcal{B}(pp^{\prime})\) et \(V(XY) = pp^{\prime}(1 – pp^{\prime})\). Avec \(q = 1 – p\) et \(q^{\prime} = 1 – p^{\prime}\), la formule donne \(pqp^{\prime}q^{\prime} + pqp^{\prime 2} + p^{\prime}q^{\prime}p^2 = pp^{\prime}\big(q(q^{\prime} + p^{\prime}) + q^{\prime}p\big)\). Cette quantité vaut \(pp^{\prime}(q + q^{\prime}p) = pp^{\prime}(1 – pp^{\prime})\). On retrouve bien le résultat.
- Par indépendance, \(E(XY) = \big(\frac{7}{2}\big)^2 = \frac{49}{4}\). Ensuite, avec \(V(X) = V(Y) = \frac{35}{12}\) :
\[V(XY) = \frac{1225}{144} + 2 \cdot \frac{35}{12}\cdot\frac{49}{4} = \frac{1225 + 10290}{144}.\]
Donc \(E(XY) = \frac{49}{4}\) et \(V(XY) = \frac{11515}{144} \approx 79{,}97\). Contrôle : \(E(X^2)^2 – E(XY)^2 = \frac{8281}{36} – \frac{2401}{16} = \frac{33124 – 21609}{144}\), ce qui redonne \(\frac{11515}{144}\). - Prenons \(Y = X\) avec \(X \sim \mathcal{B}(\frac{1}{2})\). Alors \(XY = X^2 = X\), donc \(V(XY) = \frac{1}{4}\). La formule donnerait \(\frac{1}{16} + 2 \cdot \frac{1}{4}\cdot\frac{1}{4} = \frac{3}{16}\). La formule est fausse sans indépendance.
Corrigé de l’exercice 12 : Points fixes d’une permutation aléatoire
- On note \(A_i = \{\sigma(i) = i\}\). Alors \(N = \sum_{i=1}^{n}\mathbf{1}_{A_i}\). Les permutations qui fixent \(i\) correspondent aux permutations des \(n – 1\) autres éléments. Elles sont \((n-1)!\) parmi \(n!\), donc \(P(A_i) = \frac{1}{n}\). Par linéarité, \(E(N) = n \cdot \frac{1}{n}\). Donc \(E(N) = 1\).
- De même, les permutations qui fixent \(i\) et \(j\) sont au nombre de \((n-2)!\). Ainsi, \(P(A_i \cap A_j) = \frac{1}{n(n-1)}\). Comme \(\mathbf{1}_{A_i}\mathbf{1}_{A_j} = \mathbf{1}_{A_i \cap A_j}\) :
\[\mathrm{Cov}(\mathbf{1}_{A_i}, \mathbf{1}_{A_j}) = \frac{1}{n(n-1)} – \frac{1}{n^2} = \frac{n – (n-1)}{n^2(n-1)}.\]
Cette covariance vaut \(\frac{1}{n^2(n-1)}\). - Par la formule de la variance d’une somme, avec \(n(n-1)\) couples ordonnés \((i, j)\), \(i \neq j\) :
\[V(N) = n\cdot\frac{1}{n}\Big(1 – \frac{1}{n}\Big) + n(n-1)\cdot\frac{1}{n^2(n-1)} = 1 – \frac{1}{n} + \frac{1}{n}.\]
Donc \(V(N) = 1\), quel que soit \(n \geq\, 2\). - La variable \(N\) est positive. Par l’inégalité de Markov, \(P(N \geq\, 3) \leq\, \frac{E(N)}{3} = \frac{1}{3}\). Ensuite, \(N \geq\, 3\) implique \(N – 1 \geq\, 2\), donc \(\{N \geq\, 3\} \subset \{|N – 1| \geq\, 2\}\). Par Bienaymé-Tchebychev, \(P(N \geq\, 3) \leq\, \frac{V(N)}{4} = \frac{1}{4}\). La borne de Bienaymé-Tchebychev, \(\frac{1}{4}\), est meilleure que celle de Markov, \(\frac{1}{3}\).
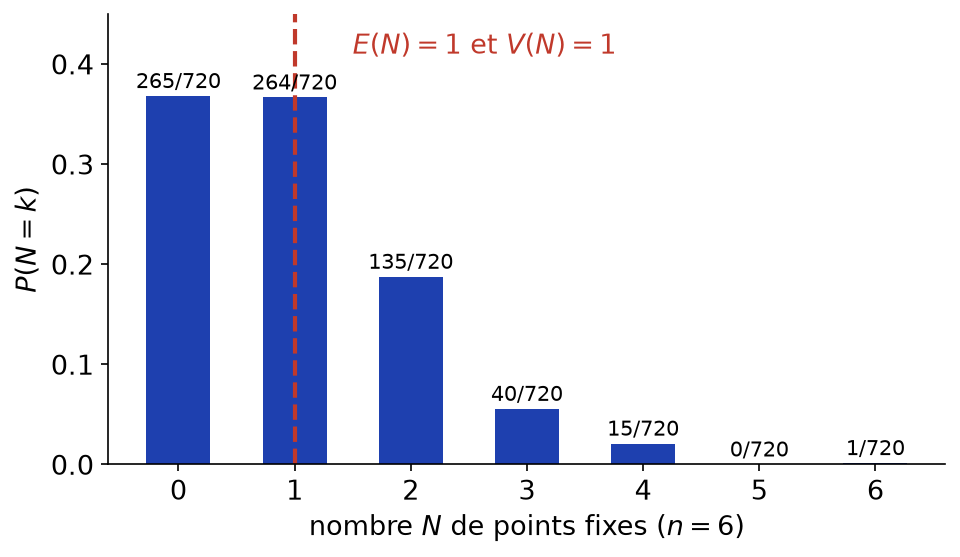
La figure ci-dessous donne la loi exacte de \(N\) pour \(n = 6\), obtenue en énumérant les \(720\) permutations. On y lit \(P(N \geq\, 3) = \frac{56}{720} \approx 0{,}078\), bien sous les deux bornes. On note aussi que \(P(N = 5) = 0\) : une permutation qui fixe \(5\) éléments fixe forcément le sixième.
Corrigé de l’exercice 13 : Tirages sans remise et loi hypergéométrique
- L’univers \(\Omega\) est l’ensemble des \(n\)-uplets de boules distinctes, muni de la probabilité uniforme. Son cardinal est \(A_N^n = \frac{N!}{(N-n)!}\). Pour réaliser \(B_k\), on choisit la \(k\)-ième boule parmi les \(b\) blanches, puis les \(n – 1\) autres parmi les \(N – 1\) restantes, dans l’ordre. D’où \(|B_k| = b\,A_{N-1}^{n-1}\). Or \(A_N^n = N\,A_{N-1}^{n-1}\). Donc \(P(B_k) = \frac{b}{N}\), quel que soit le rang \(k\).
- On a \(X = \sum_{k=1}^{n}\mathbf{1}_{B_k}\). Par linéarité, \(E(X) = \frac{nb}{N}\).
- Pour \(k \neq l\), on choisit de même les boules des rangs \(k\) et \(l\) parmi les blanches, puis les autres. Ainsi \(|B_k \cap B_l| = b(b-1)A_{N-2}^{n-2}\) et \(A_N^n = N(N-1)A_{N-2}^{n-2}\). Donc \(P(B_k \cap B_l) = \frac{b(b-1)}{N(N-1)}\). Ensuite :
\[\mathrm{Cov}(\mathbf{1}_{B_k}, \mathbf{1}_{B_l}) = \frac{b(b-1)}{N(N-1)} – \frac{b^2}{N^2} = \frac{b\big(N(b-1) – b(N-1)\big)}{N^2(N-1)} = \frac{b(b – N)}{N^2(N-1)}.\]
La covariance vaut \(-\frac{b(N-b)}{N^2(N-1)}\) : elle est négative. - Chaque \(\mathbf{1}_{B_k}\) a pour variance \(\frac{b}{N}\big(1 – \frac{b}{N}\big) = \frac{b(N-b)}{N^2}\). Avec \(n(n-1)\) couples ordonnés :
\[V(X) = \frac{nb(N-b)}{N^2} – \frac{n(n-1)b(N-b)}{N^2(N-1)} = \frac{nb(N-b)}{N^2}\Big(1 – \frac{n-1}{N-1}\Big).\]
Or \(1 – \frac{n-1}{N-1} = \frac{N-n}{N-1}\). On obtient \(V(X) = n\frac{b}{N}\big(1 – \frac{b}{N}\big)\frac{N-n}{N-1}\). - Avec \(N = 10\), \(b = 4\) et \(n = 5\), on trouve \(E(X) = 2\) et \(V(X) = 5 \cdot \frac{2}{5}\cdot\frac{3}{5}\cdot\frac{5}{9} = \frac{2}{3}\). Avec remise, le nombre de blanches suivrait la loi \(\mathcal{B}(5; 0{,}4)\), d’espérance \(2\) et de variance \(1{,}2\). Les espérances sont égales ; sans remise, la variance \(\frac{2}{3}\) est plus petite que \(\frac{6}{5}\). En effet, le facteur \(\frac{N-n}{N-1} = \frac{5}{9}\) traduit la corrélation négative des tirages.
Corrigé de l’exercice 14 : Urnes vides
- Soit \(E_j\) l’événement « l’urne \(j\) est vide ». Chaque boule évite l’urne \(j\) avec probabilité \(1 – \frac{1}{r}\), et les boules sont placées indépendamment. Donc \(P(E_j) = \big(1 – \frac{1}{r}\big)^n = a\). Comme \(V = \sum_{j=1}^{r}\mathbf{1}_{E_j}\), la linéarité donne \(E(V) = ra\). Donc \(E(V) = r\big(1 – \frac{1}{r}\big)^n\), et le nombre d’urnes occupées a pour espérance \(r – r\big(1 – \frac{1}{r}\big)^n\).
- Pour \(j \neq k\), chaque boule évite les deux urnes avec probabilité \(1 – \frac{2}{r}\). Donc \(P(E_j \cap E_k) = b\) et \(\mathrm{Cov}(\mathbf{1}_{E_j}, \mathbf{1}_{E_k}) = b – a^2\). Par ailleurs, \(V(\mathbf{1}_{E_j}) = a(1-a)\). Il y a \(r(r-1)\) couples ordonnés \((j, k)\) avec \(j \neq k\). Donc \(V(V) = ra(1-a) + r(r-1)(b – a^2)\).
- Pour \(n = r = 4\) : \(a = \frac{81}{256}\) et \(b = \frac{1}{16} = \frac{16}{256}\). D’abord, \(E(V) = 4 \cdot \frac{81}{256} = \frac{81}{64}\). Ensuite :
\[V(V) = 4\cdot\frac{81}{256}\cdot\frac{175}{256} + 12\Big(\frac{4096 – 6561}{65536}\Big) = \frac{56700 – 29580}{65536} = \frac{27120}{65536}.\]
Donc \(E(V) = \frac{81}{64} \approx 1{,}27\) et \(V(V) = \frac{1695}{4096} \approx 0{,}41\). - Il y a \(4^4 = 256\) répartitions équiprobables. On compte les cas :
- \(V = 3\) : toutes les boules dans une même urne, soit \(4\) cas ;
- \(V = 2\) : on choisit \(2\) urnes, puis une répartition qui les remplit toutes deux, soit \(6 \times (2^4 – 2) = 84\) cas ;
- \(V = 0\) : une boule par urne, soit \(4! = 24\) cas ;
- \(V = 1\) : le reste, soit \(256 – 4 – 84 – 24 = 144\) cas.
Ainsi \(E(V) = \frac{144 + 168 + 12}{256} = \frac{324}{256} = \frac{81}{64}\). Ensuite, \(E(V^2) = \frac{144 + 336 + 36}{256} = \frac{8256}{4096}\). Donc \(V(V) = \frac{8256 – 6561}{4096}\). La loi \(\big(\frac{24}{256}, \frac{144}{256}, \frac{84}{256}, \frac{4}{256}\big)\) confirme \(E(V) = \frac{81}{64}\) et \(V(V) = \frac{1695}{4096}\).
Corrigé de l’exercice 15 : Nombre de changements dans une suite de lancers
- L’événement \(\{C_i = 1\}\) est la réunion disjointe de \(\{X_i = 1, X_{i+1} = 0\}\) et de \(\{X_i = 0, X_{i+1} = 1\}\). Par indépendance, \(P(C_i = 1) = pq + qp = 2pq\). Comme \(C = \sum_{i=1}^{n-1}C_i\), on obtient \(E(C) = 2(n-1)pq\).
- La variable \(C_i\) est une fonction de \((X_i, X_{i+1})\), et \(C_j\) une fonction de \((X_j, X_{j+1})\). Si \(|i – j| \geq\, 2\), les ensembles d’indices \(\{i, i+1\}\) et \(\{j, j+1\}\) sont disjoints. Par le lemme des coalitions, \(C_i\) et \(C_j\) sont indépendantes, donc décorrélées.
- On a \(C_iC_{i+1} = 1\) si et seulement si \(X_i \neq X_{i+1}\) et \(X_{i+1} \neq X_{i+2}\). Les triplets possibles sont \((1, 0, 1)\) et \((0, 1, 0)\). Donc \(E(C_iC_{i+1}) = p^2q + q^2p = pq(p + q) = pq\). Ainsi \(\mathrm{Cov}(C_i, C_{i+1}) = pq – 4p^2q^2 = pq(1 – 4pq)\).
- Chaque \(C_i\) suit la loi \(\mathcal{B}(2pq)\), donc \(V(C_i) = 2pq(1 – 2pq)\). Dans la somme des covariances, seuls les couples \(i < j\) avec \(j = i + 1\) comptent, d’après la question 2. Il y en a \(n – 2\). Par conséquent \(V(C) = 2(n-1)pq(1 – 2pq) + 2(n-2)pq(1 – 4pq)\).
- Pour \(p = \frac{1}{2}\), \(pq = \frac{1}{4}\) : la covariance est nulle et \(V(C_i) = \frac{1}{4}\). Avec \(n – 1 = 100\), on trouve \(E(C) = 50\) et \(V(C) = 25\). Par Bienaymé-Tchebychev, \(P(|C – 50| \geq\, 10) \leq\, \frac{25}{100} = \frac{1}{4}\).
Corrigé de l’exercice 16 : Inégalité de Markov et somme de dés
- On a \(S = D_1 + D_2\) avec \(D_1\), \(D_2\) indépendants de loi uniforme sur \(\{1, \ldots, 6\}\). Par linéarité, \(E(S) = 7\). Par indépendance, \(V(S) = 2 \times \frac{35}{12}\). Donc \(E(S) = 7\) et \(V(S) = \frac{35}{6}\).
- La variable \(S\) est positive. Par Markov, \(P(S \geq\, 10) \leq\, \frac{7}{10}\). Ensuite, \(S \geq\, 10\) implique \(|S – 7| \geq\, 3\). Par Bienaymé-Tchebychev, \(P(S \geq\, 10) \leq\, \frac{35/6}{9} = \frac{35}{54} \approx 0{,}65\). Enfin, les couples qui donnent \(S \geq\, 10\) sont \((4, 6)\), \((5, 5)\), \((6, 4)\), \((5, 6)\), \((6, 5)\) et \((6, 6)\). La valeur exacte vaut \(\frac{6}{36} = \frac{1}{6} \approx 0{,}17\), loin des bornes \(0{,}7\) et \(0{,}65\). On peut d’ailleurs améliorer la seconde borne. En effet, la loi de \(S\) est symétrique par rapport à \(7\), donc \(P(S \geq\, 10) = \frac{1}{2}P(|S – 7| \geq\, 3) \leq\, \frac{35}{108} \approx 0{,}32\).
- Comme \(0 < m \leq\, a\), le nombre \(\frac{m}{a}\) est dans \(]0, 1]\). On définit \(X\) par \(P(X = a) = \frac{m}{a}\) et \(P(X = 0) = 1 – \frac{m}{a}\). Alors \(X \geq\, 0\) et \(E(X) = a \cdot \frac{m}{a} = m\). De plus, \(P(X \geq\, a) = \frac{m}{a} = \frac{E(X)}{a}\). L’inégalité de Markov est une égalité pour cette variable : on ne peut pas l’améliorer sans autre information sur la loi.
Corrigé de l’exercice 17 : Inégalité de Bienaymé-Tchebychev pour une binomiale
- Les lancers sont indépendants et chacun donne pile avec probabilité \(\frac{1}{2}\). Donc \(X \sim \mathcal{B}(100, \frac{1}{2})\), avec \(E(X) = 50\) et \(V(X) = 25\).
- Par Bienaymé-Tchebychev, \(P(|X – 50| \geq\, 10) \leq\, \frac{25}{10^2} = \frac{1}{4}\). Or \(\{40 < X < 60\} = \{|X – 50| < 10\}\) est l’événement contraire. Donc \(P(|X – 50| \geq\, 10) \leq\, \frac{1}{4}\) et \(P(40 < X < 60) \geq\, \frac{3}{4}\).
- On veut \(\frac{25}{t^2} \leq\, 0{,}05\), c’est-à-dire \(t^2 \geq\, 500\). Or \(22^2 = 484\) et \(23^2 = 529\). Le plus petit entier convenable est \(t = 23\).
- Par Markov, \(P(X \geq\, 60) \leq\, \frac{50}{60} = \frac{5}{6}\). Ensuite, \(100 – X\) compte les faces et suit la même loi que \(X\). Donc \(P(X \geq\, 60) = P(100 – X \geq\, 60) = P(X \leq\, 40)\). Ces deux événements disjoints ont pour réunion \(\{|X – 50| \geq\, 10\}\). Ainsi \(2P(X \geq\, 60) \leq\, \frac{1}{4}\). On obtient \(P(X \geq\, 60) \leq\, \frac{1}{8}\), bien meilleur que \(\frac{5}{6}\).
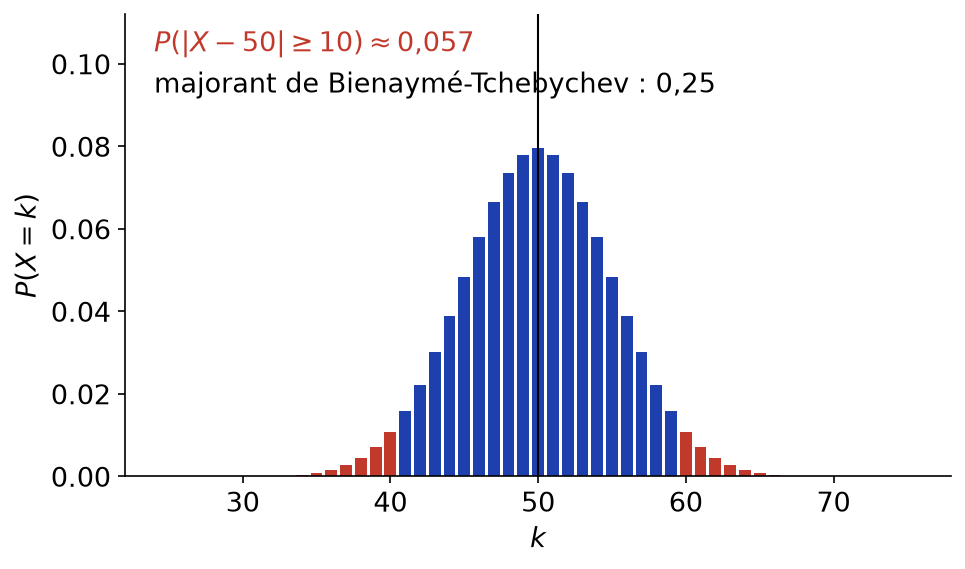
La figure ci-dessous montre la loi de \(X\). Les valeurs en rouge forment l’événement \(\{|X – 50| \geq\, 10\}\). Sa probabilité exacte, environ \(0{,}057\), reste loin du majorant \(0{,}25\). De même, \(P(X \geq\, 60) \approx 0{,}028\).
Corrigé de l’exercice 18 : Taille d’un sondage
- Par linéarité, \(E(F_n) = p\). Les \(X_i\) sont indépendantes, donc \(V(F_n) = \frac{1}{n^2} \cdot np(1-p) = \frac{p(1-p)}{n}\). Or \(p(1-p) = \frac{1}{4} – \big(p – \frac{1}{2}\big)^2 \leq\, \frac{1}{4}\). Donc \(E(F_n) = p\) et \(V(F_n) \leq\, \frac{1}{4n}\).
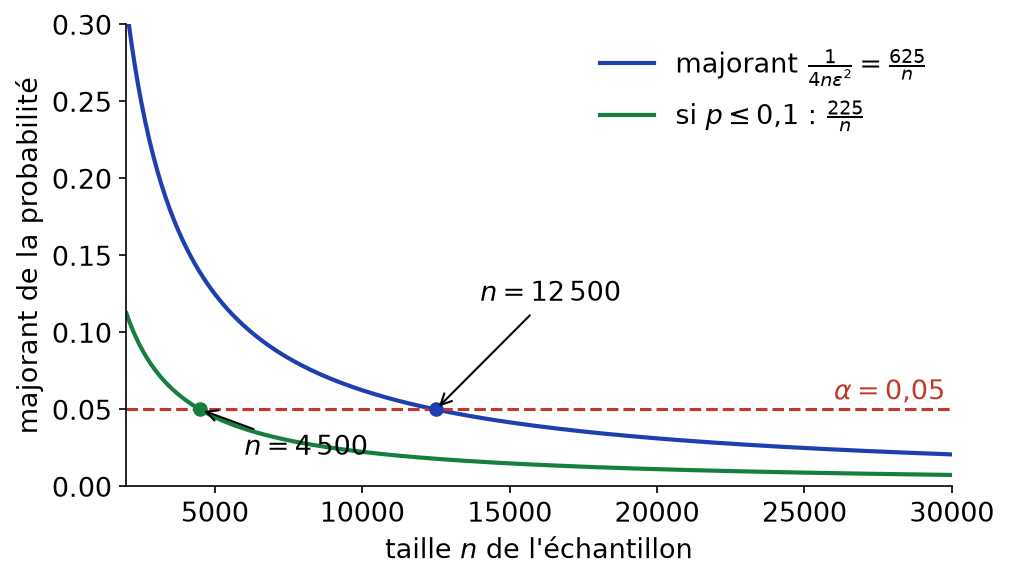
- Par Bienaymé-Tchebychev et la question 1, \(P(|F_n – p| \geq\, 0{,}02) \leq\, \frac{1}{4n \times 0{,}0004} = \frac{625}{n}\). Cette borne est au plus \(0{,}05\) si et seulement si \(n \geq\, 12\,500\). Interroger \(12\,500\) personnes suffit.
- Avec \(\varepsilon = 0{,}01\), la borne devient \(\frac{2500}{n}\), et il faut \(n \geq\, 50\,000\). Diviser la précision par \(2\) multiplie la taille suffisante par \(4\). En effet, cette taille est proportionnelle à \(\frac{1}{\varepsilon^2}\).
- La fonction \(p \mapsto p(1-p)\) est croissante sur \([0, \frac{1}{2}]\). Donc, si \(p \leq\, 0{,}1\), \(p(1-p) \leq\, 0{,}09\). La borne devient \(\frac{0{,}09}{n \times 0{,}0004} = \frac{225}{n}\). Il suffit alors de \(n \geq\, 4\,500\). La figure ci-dessous compare les deux majorants et leur seuil commun \(0{,}05\).
Corrigé de l’exercice 19 : Moyenne de lancers de dés
- Les résultats \(D_1, \ldots, D_n\) sont indépendants, d’espérance \(\frac{7}{2}\) et de variance \(\frac{35}{12}\). Par linéarité, \(E(M_n) = \frac{7}{2}\). Par indépendance, \(V(M_n) = \frac{1}{n^2} \cdot n \cdot \frac{35}{12}\). Donc \(E(M_n) = \frac{7}{2}\) et \(V(M_n) = \frac{35}{12n}\).
- Par Bienaymé-Tchebychev, \(P(|M_n – 3{,}5| \geq\, 0{,}1) \leq\, \frac{35}{12n \times 0{,}01}\). On impose que cette borne soit au plus \(0{,}05\), soit \(n \geq\, \frac{35}{0{,}006} \approx 5833{,}3\). Il suffit de \(5\,834\) lancers.
- La fréquence \(F_n\) est la moyenne de \(n\) Bernoulli indépendantes de paramètre \(\frac{1}{6}\). Donc \(V(F_n) = \frac{1}{n} \cdot \frac{1}{6}\cdot\frac{5}{6} = \frac{5}{36n}\). On impose \(\frac{5}{36n \times 10^{-4}} \leq\, 0{,}1\), soit \(n \geq\, \frac{5}{36 \times 10^{-5}} \approx 13\,888{,}9\). Il suffit de \(13\,889\) lancers.
- Pour tout \(\varepsilon > 0\), \(0 \leq\, P(|M_n – 3{,}5| \geq\, \varepsilon) \leq\, \frac{35}{12n\varepsilon^2}\). Le majorant tend vers \(0\). Par encadrement, la probabilité tend vers \(0\) : c’est la loi faible des grands nombres pour les dés.
Corrigé de l’exercice 20 : Variance nulle et meilleure approximation par une constante
- Par transfert, \(V(X) = \sum_{x \in X(\Omega)}(x – m)^2P(X = x)\). C’est une somme de termes positifs. Elle est nulle si et seulement si chaque terme est nul, c’est-à-dire \(P(X = x) = 0\) pour tout \(x \neq m\). Cela équivaut à \(P(X = m) = 1\). Donc \(V(X) = 0\) si et seulement si \(X\) est presque sûrement égale à \(m\).
- De même, \(E(X) = \sum_x xP(X = x)\) est une somme de termes positifs, car \(X \geq\, 0\). Si elle est nulle, alors \(P(X = x) = 0\) pour tout \(x > 0\). Donc \(P(X = 0) = 1\).
- On écrit \(X – a = (X – m) + (m – a)\). En développant, puis par linéarité :
\[g(a) = V(X) + 2(m – a)E(X – m) + (m – a)^2 = V(X) + (m – a)^2,\]
car \(E(X – m) = 0\). Ainsi \(g\) atteint son minimum \(V(X)\) en \(a = m\), et seulement en ce point. - On pose \(c = \frac{\alpha + \beta}{2}\). Comme \(\alpha \leq\, X \leq\, \beta\), on a \(|X – c| \leq\, \frac{\beta – \alpha}{2}\). Par la question 3 et la croissance de l’espérance, \(V(X) = g(m) \leq\, g(c) \leq\, \frac{(\beta – \alpha)^2}{4}\). Donc \(V(X) \leq\, \frac{(\beta – \alpha)^2}{4}\). Il y a égalité si \(X\) vaut \(\alpha\) et \(\beta\) avec probabilité \(\frac{1}{2}\) chacune. En effet, dans ce cas \(m = c\) et \((X – c)^2 = \frac{(\beta – \alpha)^2}{4}\). Par exemple, une Bernoulli de paramètre \(\frac{1}{2}\) a pour variance \(\frac{1}{4}\).
Corrigé de l’exercice 21 : Coefficient de corrélation et régression linéaire
- Par bilinéarité, \(h(\lambda) = V(Y – \lambda X) = V(Y) – 2\lambda\,\mathrm{Cov}(X, Y) + \lambda^2V(X)\). C’est un trinôme du second degré, car \(V(X) > 0\). Il est positif pour tout réel \(\lambda\), donc son discriminant est négatif ou nul : \(4\,\mathrm{Cov}(X, Y)^2 – 4V(X)V(Y) \leq\, 0\). Donc \(\mathrm{Cov}(X, Y)^2 \leq\, V(X)V(Y)\).
- En prenant la racine carrée, \(|\mathrm{Cov}(X, Y)| \leq\, \sigma(X)\sigma(Y)\), donc \(|\rho| \leq\, 1\). Supposons \(|\rho| = 1\). Le discriminant est nul, donc \(h\) s’annule en \(\lambda_0 = \frac{\mathrm{Cov}(X, Y)}{V(X)}\). D’après l’exercice 20, \(Y – \lambda_0X\) est presque sûrement égale à sa moyenne \(b\). Donc \(P(Y = \lambda_0X + b) = 1\). Réciproquement, supposons \(P(Y = aX + b) = 1\). Alors \(Y\) et \(aX + b\) ont les mêmes moments, car les formules de transfert ne diffèrent que sur un événement de probabilité nulle. Ainsi \(\mathrm{Cov}(X, Y) = aV(X)\) et \(V(Y) = a^2V(X)\), avec \(a \neq 0\) car \(V(Y) > 0\). Donc \(\rho = \frac{aV(X)}{|a|V(X)} = \pm 1\). On a \(|\rho| \leq\, 1\), avec égalité si et seulement si \(Y = aX + b\) presque sûrement.
- Fixons \(a\) et posons \(W = Y – aX\). D’après l’exercice 20, \(\varphi(a, b) = E\big((W – b)^2\big) = V(W) + \big(E(W) – b\big)^2\). Donc \(\varphi(a, b) \geq\, h(a)\), avec égalité si et seulement si \(b = E(Y) – aE(X)\). Ensuite, le trinôme \(h\) atteint son minimum en un unique point \(a_0 = \frac{\mathrm{Cov}(X, Y)}{V(X)}\). Ce minimum vaut
\[h(a_0) = V(Y) – \frac{\mathrm{Cov}(X, Y)^2}{V(X)} = V(Y)\big(1 – \rho^2\big).\]
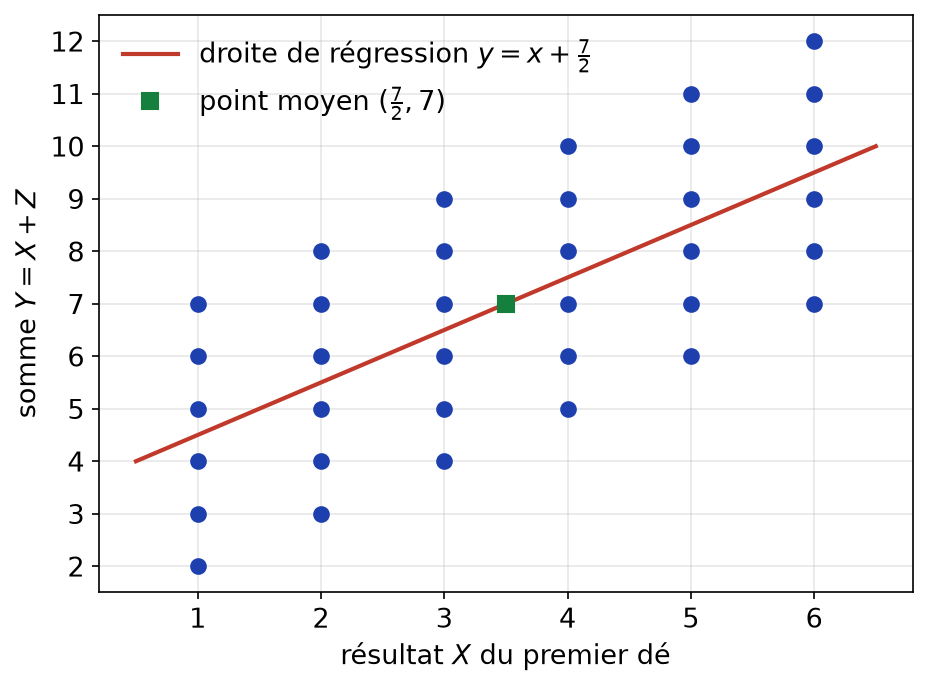
Le minimum de \(\varphi\) est atteint au seul couple \(a_0 = \frac{\mathrm{Cov}(X, Y)}{V(X)}\), \(b_0 = E(Y) – a_0E(X)\), et il vaut \(V(Y)(1 – \rho^2)\). - Par bilinéarité et indépendance, \(\mathrm{Cov}(X, Y) = V(X) + \mathrm{Cov}(X, Z) = \frac{35}{12}\). De plus, \(V(Y) = \frac{35}{6}\). Donc \(\rho = \frac{35/12}{\sqrt{(35/12)(35/6)}} = \frac{1}{\sqrt{2}}\). Ensuite, \(a_0 = 1\) et \(b_0 = 7 – \frac{7}{2}\). Enfin, le minimum vaut \(\frac{35}{6}\big(1 – \frac{1}{2}\big)\). On obtient \(\rho = \frac{\sqrt{2}}{2}\), \(a_0 = 1\), \(b_0 = \frac{7}{2}\) et un minimum égal à \(\frac{35}{12}\). Ce minimum est \(V(Z)\) : la meilleure prévision affine de la somme remplace le second dé par sa moyenne. La figure ci-dessous montre les \(36\) couples équiprobables et la droite \(y = x + \frac{7}{2}\).
Corrigé de l’exercice 22 : Problème : polynômes de Bernstein et théorème de Weierstrass
- La variable \(S_n\) prend la valeur \(k \in \{0, \ldots, n\}\) avec probabilité \(\binom\,{n}{k}x^k(1-x)^{n-k}\), avec la convention \(0^0 = 1\) pour \(x \in \{0, 1\}\). La formule de transfert donne alors l’expression demandée. Chaque terme est un polynôme en \(x\) de degré au plus \(n\), donc \(B_n(f)\) est une fonction polynomiale.
- Pour \(f = 1\), \(B_n(f)(x) = E(1) = 1\). Pour \(f(t) = t\), \(B_n(f)(x) = \frac{E(S_n)}{n} = x\). Pour \(f(t) = t^2\), on utilise König-Huygens : \(E(S_n^2) = V(S_n) + E(S_n)^2 = nx(1-x) + n^2x^2\). Donc \(B_n(1) = 1\), \(B_n(t) = x\) et \(B_n(t^2) = x^2 + \frac{x(1-x)}{n}\).
- La variance de \(|Y|\) est positive, et \(|Y|^2 = Y^2\). Donc \(0 \leq\, V(|Y|) = E(Y^2) – E(|Y|)^2\). Comme \(E(|Y|) \geq\, 0\), on obtient \(E(|Y|) \leq\, \sqrt{E(Y^2)}\).
- Par linéarité, \(B_n(f)(x) – f(x) = E\big(f(\frac{S_n}{n}) – f(x)\big)\). Ensuite, on utilise successivement l’inégalité triangulaire, le caractère lipschitzien de \(f\) et la question 3 :
\[|B_n(f)(x) – f(x)| \leq\, K\,E\Big(\Big|\frac{S_n}{n} – x\Big|\Big) \leq\, K\sqrt{V\Big(\frac{S_n}{n}\Big)} = K\sqrt{\frac{x(1-x)}{n}}.\]
En effet, \(E(\frac{S_n}{n}) = x\). Enfin, \(x(1-x) \leq\, \frac{1}{4}\). Donc \(|B_n(f)(x) – f(x)| \leq\, \frac{K}{2\sqrt{n}}\) pour tout \(x \in [0, 1]\). - La fonction \(f\) est continue sur le segment \([0, 1]\). Par le théorème de Heine, elle y est uniformément continue. Il existe donc \(\delta > 0\) tel que \(|s – t| < \delta\) implique \(|f(s) – f(t)| \leq\, \varepsilon\). Notons \(A = \{|\frac{S_n}{n} – x| \geq\, \delta\}\). En tout point de \(\Omega\), on a
\[\Big|f\Big(\frac{S_n}{n}\Big) – f(x)\Big| \leq\, \varepsilon + 2\|f\|_\infty\mathbf{1}_A.\]
En effet, hors de \(A\), le membre de gauche est au plus \(\varepsilon\) ; sur \(A\), il est au plus \(2\|f\|_\infty\). Par croissance de l’espérance, \(|B_n(f)(x) – f(x)| \leq\, \varepsilon + 2\|f\|_\infty P(A)\). Or Bienaymé-Tchebychev donne \(P(A) \leq\, \frac{x(1-x)}{n\delta^2} \leq\, \frac{1}{4n\delta^2}\). Ainsi \(|B_n(f)(x) – f(x)| \leq\, \varepsilon + \frac{\|f\|_\infty}{2n\delta^2}\). Ce majorant ne dépend pas de \(x\), car \(\delta\) n’en dépend pas. Pour \(n \geq\, \frac{\|f\|_\infty}{2\varepsilon\delta^2}\), on a donc \(\sup_{[0, 1]}|B_n(f) – f| \leq\, 2\varepsilon\). Par conséquent, \(\sup_{x \in [0, 1]}|B_n(f)(x) – f(x)| \to 0\). - Avec \(f(0) = f(1) = \frac{1}{2}\) et \(f(\frac{1}{2}) = 0\) :
\[B_2(f)(x) = \frac{1}{2}(1-x)^2 + 2x(1-x) \times 0 + \frac{1}{2}x^2 = x^2 – x + \frac{1}{2}.\]
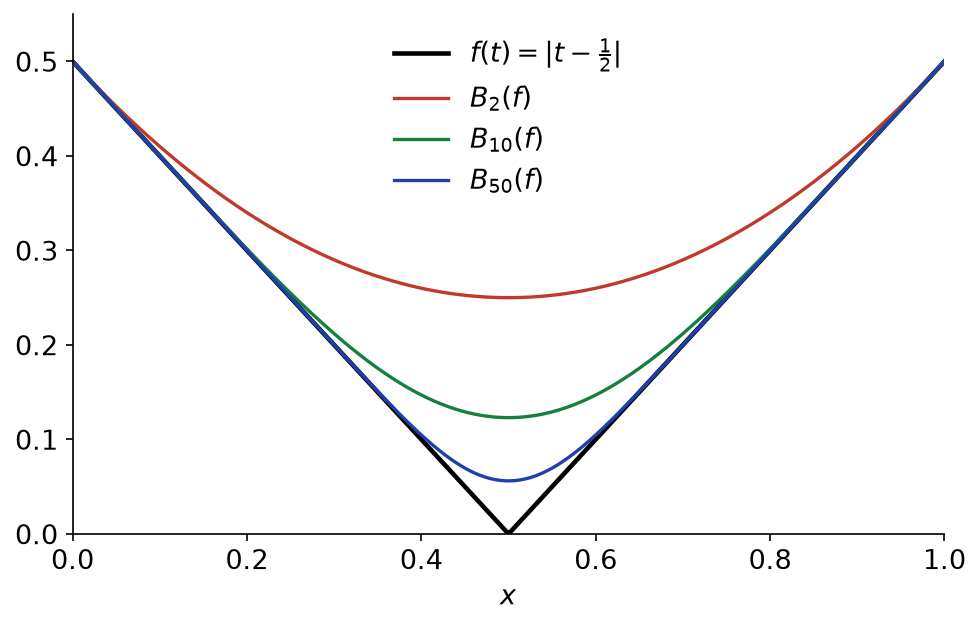
Donc \(B_2(f)(x) = x^2 – x + \frac{1}{2}\). En \(x = \frac{1}{2}\), \(B_2(f)(\frac{1}{2}) = \frac{1}{4}\), donc l’écart avec \(f(\frac{1}{2}) = 0\) vaut \(\frac{1}{4}\). Or \(f\) est \(1\)-lipschitzienne, par l’inégalité triangulaire renversée. La question 4 donne donc la borne \(\frac{1}{2\sqrt{2}} \approx 0{,}354\). On vérifie bien \(\frac{1}{4} \leq\, \frac{1}{2\sqrt{2}}\). La figure ci-dessous montre \(B_2(f)\), \(B_{10}(f)\) et \(B_{50}(f)\) : l’écart maximal, atteint en \(\frac{1}{2}\), diminue lentement.
Point de méthode : on vient de démontrer le théorème de Weierstrass sur \([0, 1]\), étudié plus en détail en seconde année. L’idée clé consiste à couper selon que \(\frac{S_n}{n}\) est proche de \(x\) ou non, puis à contrôler le second cas par Bienaymé-Tchebychev.
Revenir aux énoncés des exercices
Pour aller plus loin en maths sup
- Le cours : espérance et variance, cours de maths sup
- Les énoncés : exercices de maths sup sur espérance et variance
- À maîtriser avant : Probabilités sur un univers fini et variables aléatoires
- Chapitre précédent : Probabilités sur un univers fini et variables aléatoires
- Chapitre suivant : Espaces préhilbertiens réels
- Le même thème en maths spé : espérance et variance, exercices de maths spé
- Tester vos connaissances : QCM de maths sup par chapitre
- Le sommaire : tous les chapitres de maths sup et les chapitres de maths spé