Ce corrigé diagonalisation L2 rédige les solutions des vingt-quatre exercices comme on l’attend en partiel. Chaque calcul de polynôme caractéristique est mené en factorisant le plus tôt possible, puis contrôlé par la trace et le déterminant.
Pour les sous-espaces propres, la dimension est obtenue par le théorème du rang, puis comparée à la multiplicité algébrique. Ainsi, le critère de diagonalisabilité est toujours cité précisément. Pour les suites et les systèmes différentiels, la condition initiale est décomposée dans la base propre, ce qui évite de calculer inutilement l’inverse de la matrice de passage.
Soyez vigilant sur trois points : un vecteur propre est non nul, le spectre dépend du corps, et une valeur propre multiple doit toujours être examinée. Enfin, chaque résultat est vérifié par un calcul direct sur un cas particulier.
Les énoncés se trouvent sur la page exercices de maths en L2 sur diagonalisation.
Corrigé de l’exercice 1 : Éléments propres d’une matrice d’ordre 2
- Pour une matrice d’ordre 2, \(\chi_A(X) = X^2 – \operatorname{tr}(A)X + \det A\). Ici, \(\operatorname{tr}(A) = 7\) et \(\det A = 12 – 2 = 10\). Donc \(\chi_A(X) = X^2 – 7X + 10\). Le discriminant vaut \(49 – 40 = 9\), d’où les racines \(\frac{7 \pm 3}{2}\). On obtient \(\chi_A = (X – 2)(X – 5)\) et \(\mathrm{Sp}(A) = \{2, 5\}\).
- Pour \(\lambda = 5\), on résout \((A – 5I_2)X = 0\), soit \(-x + y = 0\) et \(2x – 2y = 0\). Ainsi \(y = x\). Pour \(\lambda = 2\), on résout \((A – 2I_2)X = 0\), soit \(2x + y = 0\) (les deux lignes sont identiques). Ainsi \(y = -2x\). Donc \(E_5(A) = \mathrm{Vect}\big((1,1)\big)\) et \(E_2(A) = \mathrm{Vect}\big((1,-2)\big)\).
- La matrice \(A\) est d’ordre 2 et possède deux valeurs propres distinctes. D’après le corollaire du critère de diagonalisabilité, elle est donc diagonalisable. On range les vecteurs propres en colonnes, dans l’ordre des valeurs propres choisies. On peut prendre \(P = \begin{pmatrix} 1 1 \\ 1 -2 \end{pmatrix}\) et \(D = \begin{pmatrix} 5 0 \\ 0 2 \end{pmatrix}\), avec \(A = PDP^{-1}\).
La figure ci-dessous montre les deux droites propres. De plus, l’image du cercle unité par \(A\) est une ellipse ; les vecteurs \(u\) et \(v\), unitaires et dirigés selon les droites propres, sont simplement multipliés par 5 et par 2.
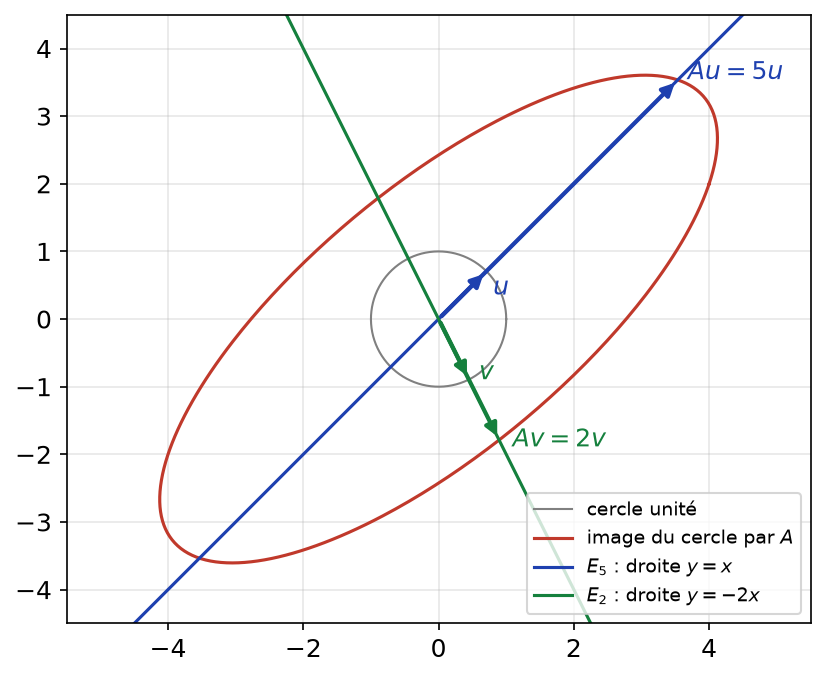
Point de méthode : vérifiez toujours un vecteur propre en calculant \(AX\). Ici, \(A(1,1) = (5,5)\) et \(A(1,-2) = (2,-4)\).
Corrigé de l’exercice 2 : Reconnaître des vecteurs propres
- On calcule chaque produit. D’abord, \(Mv_1 = (3,3,0) = 3v_1\), donc \(v_1\) est propre pour 3. Ensuite, \(Mv_2 = (1 – 2, 2 – 1, 0) = (-1,1,0) = -v_2\), donc \(v_2\) est propre pour \(-1\). De plus, \(Mv_3 = (0,0,3) = 3v_3\), donc \(v_3\) est propre pour 3. En revanche, \(Mv_4 = (1,2,0)\) n’est pas colinéaire à \(v_4\) : ce n’est pas un vecteur propre. Enfin, \(Mv_5 = (3,3,3) = 3v_5\). Les vecteurs \(v_1, v_3, v_5\) sont propres pour 3, \(v_2\) est propre pour \(-1\), et \(v_4\) n’est pas propre.
- La famille \((v_1, v_2, v_3)\) est libre. En effet, \(v_3\) n’a pas de composante dans le plan \(z = 0\), où \(v_1\) et \(v_2\) sont non colinéaires. On dispose donc d’une base de \(\mathbb{R}^3\) formée de vecteurs propres. Par définition, \(M\) est diagonalisable, et \(M = PDP^{-1}\) avec \(P = (v_1 \mid v_2 \mid v_3)\) et \(D = \mathrm{diag}(3, -1, 3)\). Le spectre est l’ensemble des coefficients de \(D\). Ainsi \(\mathrm{Sp}(M) = \{-1, 3\}\).
- Deux matrices semblables ont le même polynôme caractéristique. Donc \(\chi_M = \chi_D = (X – 3)^2(X + 1)\). On en tire \(\operatorname{tr}(M) = 3 + 3 – 1 = 5\), ce qui est bien \(1 + 1 + 3\). De même, \(\det M = 3 \cdot 3 \cdot (-1) = -9\). Par un calcul direct, \(\det M = 3 \times (1 – 4) = -9\). On retrouve \(\chi_M = (X-3)^2(X+1)\), \(\operatorname{tr}(M) = 5\) et \(\det M = -9\).
Point de méthode : le vecteur \(v_5 = v_1 + v_3\) est propre car \(v_1\) et \(v_3\) sont dans le même sous-espace propre \(E_3(M)\), qui est un plan.
Corrigé de l’exercice 3 : Sous-espaces stables
- Soit \(x \in \ker v\). Alors \(v(u(x)) = u(v(x)) = u(0) = 0\), donc \(u(x) \in \ker v\). Soit ensuite \(y \in \operatorname{Im} v\), de la forme \(y = v(z)\). Alors \(u(y) = u(v(z)) = v(u(z))\), qui appartient à \(\operatorname{Im} v\). Les sous-espaces \(\ker v\) et \(\operatorname{Im} v\) sont stables par \(u\).
- Soit \(P \in \mathbb{R}_k[X]\). Si \(P\) est constant, \(P^{\prime} = 0 \in \mathbb{R}_k[X]\). Sinon, \(\deg P^{\prime} = \deg P – 1 \leq\, k – 1\). Dans les deux cas, \(D(P) \in \mathbb{R}_k[X]\). Chaque \(\mathbb{R}_k[X]\) est stable par \(D\). On aurait aussi pu remarquer que \(\mathbb{R}_k[X] = \ker D^{k+1}\), et que \(D\) commute avec \(D^{k+1}\).
- Une droite \(\mathrm{Vect}(x)\), avec \(x \neq 0\), est stable si et seulement si \(x\) est vecteur propre. Or \(\chi_R(X) = X^2 – 0 \cdot X + 1 = X^2 + 1\) n’a pas de racine réelle. Donc \(R\) n’a pas de valeur propre réelle. Aucune droite de \(\mathbb{R}^2\) n’est stable par \(R\). Géométriquement, \(R\) est la rotation d’angle \(\frac{\pi}{2}\) : elle change la direction de tout vecteur non nul.
- Les colonnes de la matrice donnent \(f(e_1) = e_1\) et \(f(e_2) = e_1 + 2e_2\). Ces deux vecteurs appartiennent à \(F = \mathrm{Vect}(e_1, e_2)\). Par linéarité, \(f(F) \subset F\). Le plan \(F\) est stable, et la matrice de l’endomorphisme induit dans \((e_1, e_2)\) est \(\begin{pmatrix} 1 1 \\ 0 2 \end{pmatrix}\). On reconnaît le bloc supérieur gauche de la matrice de \(f\).
Corrigé de l’exercice 4 : Spectre d’une matrice triangulaire et multiplicités
- La matrice \(XI_3 – T\) est triangulaire supérieure. Son déterminant est donc le produit de ses coefficients diagonaux. Ainsi \(\chi_T = (X – 2)^2(X – 3)\) et \(\mathrm{Sp}(T) = \{2, 3\}\).
- La valeur propre 3 est simple, donc \(m(3) = 1\) et \(\dim E_3(T) = 1\). Pour 2, on a \(m(2) = 2\). Ensuite, \(T – 2I_3 = \begin{pmatrix} 0 1 -1 \\ 0 1 1 \\ 0 0 0 \end{pmatrix}\). Les deux premières lignes ne sont pas proportionnelles, donc ce rang vaut 2. Par le théorème du rang, \(\dim E_2(T) = 3 – 2 = 1\). Plus précisément, le système donne \(y – z = 0\) et \(y + z = 0\), soit \(y = z = 0\). De même, \(T – 3I_3\) conduit à \(z = 0\) et \(x = y\). On obtient \(E_2(T) = \mathrm{Vect}\big((1,0,0)\big)\) avec \(m(2) = 2\), et \(E_3(T) = \mathrm{Vect}\big((1,1,0)\big)\) avec \(m(3) = 1\).
- On a \(\dim E_2(T) = 1 < 2 = m(2)\). D’après le critère de diagonalisabilité, \(T\) n’est pas diagonalisable. Autrement dit, \(\dim E_2 + \dim E_3 = 2 < 3\).
Corrigé de l’exercice 5 : Polynôme caractéristique et invariants
- On calcule directement :
\[\chi_A(X) = \begin{vmatrix} X – a -b \\ -c X – d \end{vmatrix} = (X – a)(X – d) – bc = X^2 – (a + d)X + (ad – bc).\]
Comme \(a + d = \operatorname{tr}(A)\) et \(ad – bc = \det A\), on a bien \(\chi_A(X) = X^2 – \operatorname{tr}(A)X + \det A\). - Une matrice et sa transposée ont le même déterminant. Or \((XI_n – A)^{T} = XI_n – A^{T}\). Donc \(\chi_{A^{T}} = \chi_A\), et \(A\) et \(A^{T}\) ont le même spectre. En revanche, les sous-espaces propres diffèrent en général. Par exemple, pour \(N = \begin{pmatrix} 1 1 \\ 0 1 \end{pmatrix}\), on trouve \(E_1(N) = \mathrm{Vect}\big((1,0)\big)\), alors que \(E_1(N^{T}) = \mathrm{Vect}\big((0,1)\big)\). Les sous-espaces propres ne sont donc pas les mêmes en général, mais ils ont la même dimension, car \(\operatorname{rg}(A – \lambda I_n) = \operatorname{rg}(A^{T} – \lambda I_n)\).
- On a \(0 \in \mathrm{Sp}(A)\) si et seulement si \(\chi_A(0) = 0\). Or \(\chi_A(0) = \det(-A) = (-1)^n \det A\). Donc \(A\) est inversible si et seulement si \(\det A \neq 0\), c’est-à-dire si et seulement si \(0 \notin \mathrm{Sp}(A)\).
- Le polynôme \(\chi_A\) est réel, unitaire, de degré 3, et admet les racines 1 et 2. Il s’écrit donc \((X – 1)(X – 2)(X – c)\) avec \(c\) réel. Le coefficient de \(X^2\) vaut \(-\operatorname{tr}(A)\), d’où \(1 + 2 + c = 6\), soit \(c = 3\). Ensuite, \(\det A\) est le produit des racines, soit \(1 \times 2 \times 3 = 6\). Enfin, \(A\) possède trois valeurs propres distinctes en dimension 3. La troisième valeur propre est 3, \(\det A = 6\), et \(A\) est diagonalisable.
Corrigé de l’exercice 6 : Puissances d’une matrice d’ordre 2
- On a \(P = \begin{pmatrix} 1 1 \\ 1 -2 \end{pmatrix}\), de déterminant \(-2 – 1 = -3\). Par la formule de l’inverse d’une matrice d’ordre 2 :
\[P^{-1} = \frac{1}{-3}\begin{pmatrix} -2 -1 \\ -1 1 \end{pmatrix} = \frac{1}{3}\begin{pmatrix} 2 1 \\ 1 -1 \end{pmatrix}.\]
On vérifie que \(PP^{-1} = I_2\). - Comme \(A = PDP^{-1}\), on a \(A^n = PD^nP^{-1}\) avec \(D^n = \mathrm{diag}(5^n, 2^n)\). D’abord, \(D^n P^{-1} = \frac{1}{3}\begin{pmatrix} 2 \cdot 5^n 5^n \\ 2^n -2^n \end{pmatrix}\). Ensuite, on multiplie à gauche par \(P\) :
\[A^n = \frac{1}{3}\begin{pmatrix} 2 \cdot 5^n + 2^n 5^n – 2^n \\ 2 \cdot 5^n – 2^{n+1} 5^n + 2^{n+1} \end{pmatrix}.\]
Cette formule vaut pour tout \(n \in \mathbb{N}\). - Pour \(n = 0\), on trouve \(\frac{1}{3}\begin{pmatrix} 3 0 \\ 0 3 \end{pmatrix} = I_2\). Pour \(n = 1\), on trouve \(\frac{1}{3}\begin{pmatrix} 12 3 \\ 6 9 \end{pmatrix} = A\). Pour \(n = 3\), avec \(5^3 = 125\) et \(2^3 = 8\), on obtient \(\frac{1}{3}\begin{pmatrix} 258 117 \\ 234 141 \end{pmatrix}\). Ainsi \(A^3 = \begin{pmatrix} 86 39 \\ 78 47 \end{pmatrix}\). Un calcul direct confirme ce résultat : \(A^2 = \begin{pmatrix} 18 7 \\ 14 11 \end{pmatrix}\), puis \(A^2 A = \begin{pmatrix} 86 39 \\ 78 47 \end{pmatrix}\).
Corrigé de l’exercice 7 : Diagonalisation d’une matrice d’ordre 3
- On écrit \(\chi_A(X) = \begin{vmatrix} X -1 -1 \\ 1 X – 2 -1 \\ 1 -1 X – 2 \end{vmatrix}\). On remplace \(C_1\) par \(C_1 + C_2 + C_3\) : chaque coefficient de la première colonne devient \(X – 2\). On factorise :
\[\chi_A(X) = (X – 2)\begin{vmatrix} 1 -1 -1 \\ 1 X – 2 -1 \\ 1 -1 X – 2 \end{vmatrix} = (X – 2)\begin{vmatrix} 1 -1 -1 \\ 0 X – 1 0 \\ 0 0 X – 1 \end{vmatrix},\]
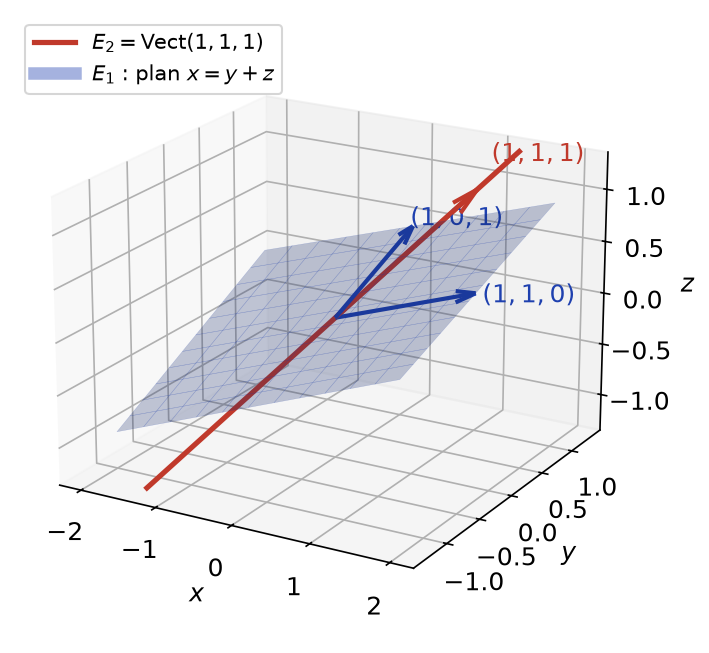
après \(L_2 arrow L_2 – L_1\) et \(L_3 arrow L_3 – L_1\). Donc \(\chi_A = (X – 1)^2(X – 2)\). Contrôle : \(\operatorname{tr}(A) = 4 = 1 + 1 + 2\). - La matrice \(A – I_3\) a ses trois lignes égales à \((-1, 1, 1)\). Elle est de rang 1, donc \(\dim E_1(A) = 2\). Le sous-espace \(E_1(A)\) est le plan d’équation \(x = y + z\). Ensuite, \(A – 2I_3 = \begin{pmatrix} -2 1 1 \\ -1 0 1 \\ -1 1 0 \end{pmatrix}\). La deuxième ligne donne \(z = x\) et la troisième \(y = x\) ; la première est alors vérifiée. On obtient \(E_1(A) = \mathrm{Vect}\big((1,1,0), (1,0,1)\big)\), de dimension 2, et \(E_2(A) = \mathrm{Vect}\big((1,1,1)\big)\), de dimension 1.
- On a \(\dim E_1(A) + \dim E_2(A) = 3\). D’après le critère, \(A\) est diagonalisable. On prend \(P = \begin{pmatrix} 1 1 1 \\ 1 0 1 \\ 0 1 1 \end{pmatrix}\) et \(D = \mathrm{diag}(1, 1, 2)\). Un calcul donne \(P^{-1} = \begin{pmatrix} 1 0 -1 \\ 1 -1 0 \\ -1 1 1 \end{pmatrix}\), qui servira à l’exercice 19.
- Posons \(Q = A – I_3\). Chaque colonne de \(Q\) est de la forme \((q, q, q)\), avec \(q \in \{-1, 1\}\). Le produit d’une ligne \((-1, 1, 1)\) par une telle colonne vaut \(q(-1 + 1 + 1) = q\). Donc \(Q^2 = Q\). Comme \(I_3\) et \(Q\) commutent, la formule du binôme de Newton s’applique :
\[A^n = (I_3 + Q)^n = I_3 + \sum_{k=1}^{n} \binom\,{n}{k} Q^k = I_3 + (\sum_{k=1}^{n} \binom\,{n}{k}) Q = I_3 + (2^n – 1) Q.\]
Donc \(A^n = I_3 + (2^n – 1)(A – I_3)\) pour tout \(n \in \mathbb{N}\). Ce résultat est cohérent avec la diagonalisation : \(Q\) est le projecteur sur \(E_2(A)\) parallèlement à \(E_1(A)\).
La figure ci-dessous représente les deux sous-espaces propres trouvés : le plan \(E_1(A)\) et la droite \(E_2(A)\), qui lui est supplémentaire.
Corrigé de l’exercice 8 : Une matrice non diagonalisable
- La deuxième colonne de \(XI_3 – B\) est \((0, X – 2, 0)\). On développe selon cette colonne :
\[\chi_B(X) = (X – 2)\begin{vmatrix} X – 3 1 \\ -2 X \end{vmatrix} = (X – 2)(X^2 – 3X + 2).\]
Or \(X^2 – 3X + 2 = (X – 1)(X – 2)\). Donc \(\chi_B = (X – 1)(X – 2)^2\). - Pour \(\lambda = 2\), on a \(B – 2I_3 = \begin{pmatrix} 1 0 -1 \\ 2 0 -1 \\ 2 0 -2 \end{pmatrix}\). Les équations \(x – z = 0\) et \(2x – z = 0\) donnent \(x = z = 0\), et \(y\) est libre. Pour \(\lambda = 1\), on a \(B – I_3 = \begin{pmatrix} 2 0 -1 \\ 2 1 -1 \\ 2 0 -1 \end{pmatrix}\). Ainsi \(z = 2x\), puis \(2x + y – 2x = 0\), soit \(y = 0\). On obtient \(E_2(B) = \mathrm{Vect}\big((0,1,0)\big)\) et \(E_1(B) = \mathrm{Vect}\big((1,0,2)\big)\).
- Le polynôme \(\chi_B\) est scindé sur \(\mathbb{R}\). Cependant, \(\dim E_2(B) = 1 < 2 = m(2)\). Donc \(B\) n’est pas diagonalisable dans \(\mathcal{M}_3(\mathbb{R})\). Sur \(\mathbb{C}\), les valeurs propres et le rang de \(B – 2I_3\) sont les mêmes. Par conséquent, \(B\) n’est pas non plus diagonalisable dans \(\mathcal{M}_3(\mathbb{C})\).
Point de méthode : changer de corps ne sert que si \(\chi\) n’est pas scindé. Un défaut de dimension d’un sous-espace propre persiste sur \(\mathbb{C}\).
Corrigé de l’exercice 9 : Diagonalisabilité selon un paramètre
- La matrice \(A_a\) est triangulaire supérieure. Donc \(\chi_{A_a} = (X – 1)^2(X – 2)\), \(\mathrm{Sp}(A_a) = \{1, 2\}\), avec \(m(1) = 2\) et \(m(2) = 1\), quel que soit \(a\).
- On a \(A_a – I_3 = \begin{pmatrix} 0 a 1 \\ 0 0 1 \\ 0 0 1 \end{pmatrix}\). Si \(a \neq 0\), les deux premières lignes sont indépendantes, donc le rang vaut 2. Si \(a = 0\), les trois lignes valent \((0, 0, 1)\), donc le rang vaut 1. Ainsi \(\operatorname{rg}(A_a – I_3) = 2\) si \(a \neq 0\), et \(1\) si \(a = 0\).
- La valeur propre simple 2 ne pose aucun problème. Pour 1, le théorème du rang donne \(\dim E_1(A_a) = 3 – \operatorname{rg}(A_a – I_3)\). Si \(a \neq 0\), cette dimension vaut \(1 < m(1)\). Si \(a = 0\), elle vaut \(2 = m(1)\). Donc \(A_a\) est diagonalisable si et seulement si \(a = 0\).
- Pour \(a = 0\), \(E_1\) est défini par \(z = 0\), donc \(E_1 = \mathrm{Vect}(e_1, e_2)\). Ensuite, \(A_0 – 2I_3 = \begin{pmatrix} -1 0 1 \\ 0 -1 1 \\ 0 0 0 \end{pmatrix}\) donne \(x = z\) et \(y = z\). On prend \(P = \begin{pmatrix} 1 0 1 \\ 0 1 1 \\ 0 0 1 \end{pmatrix}\) et \(D = \mathrm{diag}(1, 1, 2)\), avec \(A_0 = PDP^{-1}\). Vérification : \(A_0(1,1,1) = (2,2,2)\).
Corrigé de l’exercice 10 : Diagonalisation sur R et sur C
- On a \(\operatorname{tr}(B) = 0\) et \(\det B = -1 + 2 = 1\). Donc \(\chi_B = X^2 + 1\). Ce polynôme n’a pas de racine réelle. Par conséquent, \(B\) n’a pas de valeur propre réelle et n’est pas diagonalisable dans \(\mathcal{M}_2(\mathbb{R})\).
- Sur \(\mathbb{C}\), \(\chi_B = (X – i)(X + i)\) a deux racines distinctes. Donc \(B\) est diagonalisable dans \(\mathcal{M}_2(\mathbb{C})\). Pour \(\lambda = i\), la seconde ligne de \(B – iI_2\) donne \(x – (1 + i)y = 0\). On prend \(y = 1\) et \(x = 1 + i\). On vérifie la première ligne : \((1 – i)(1 + i) – 2 = 2 – 2 = 0\). Pour \(\lambda = -i\), \(B\) étant réelle, on prend le vecteur conjugué. Une base de vecteurs propres est \(\big((1+i, 1), (1-i, 1)\big)\), associés respectivement à \(i\) et à \(-i\).
- Le calcul donne \(B^2 = \begin{pmatrix} 1 – 2 -2 + 2 \\ 1 – 1 -2 + 1 \end{pmatrix} = -I_2\). On peut aussi le voir sur la diagonalisation, puisque \(i^2 = (-i)^2 = -1\). Par récurrence, \(B^{2k} = (-1)^k I_2\) et \(B^{2k+1} = (-1)^k B\). La suite des puissances est périodique de période 4 : \(I_2, B, -I_2, -B, I_2, \ldots\)
Corrigé de l’exercice 11 : Matrices de rang 1
- La \(j\)-ième colonne de \(A = UV^{T}\) vaut \(v_j U\). Toutes les colonnes sont donc colinéaires à \(U\), et l’une d’elles est non nulle puisque \(V \neq 0\). Donc \(\operatorname{rg}(A) = 1\). De plus, le coefficient diagonal \((i,i)\) vaut \(u_i v_i\). Ainsi \(\operatorname{tr}(A) = \sum_i u_i v_i = V^{T}U\).
- Par associativité, \(A^2 = U(V^{T}U)V^{T}\). Or \(V^{T}U\) est un scalaire, égal à \(\operatorname{tr}(A)\). Donc \(A^2 = \operatorname{tr}(A)\,A\).
- Par le théorème du rang, \(\dim \ker A = n – 1\), donc \(\dim E_0(A) = n – 1 \geq\, 1\) : 0 est valeur propre. Ensuite, \(AU = U(V^{T}U) = \operatorname{tr}(A)\,U\), avec \(U \neq 0\). Si \(\operatorname{tr}(A) \neq 0\), alors \(\operatorname{tr}(A)\) est une valeur propre non nulle, et \(U\) est un vecteur propre associé.
- Supposons \(\operatorname{tr}(A) \neq 0\). Alors \(\dim E_0(A) + \dim E_{\operatorname{tr}(A)}(A) \geq\, (n-1) + 1 = n\), donc \(A\) est diagonalisable. Supposons maintenant \(\operatorname{tr}(A) = 0\). Alors \(A^2 = 0\). Si \(AX = \lambda X\) avec \(X \neq 0\), alors \(0 = A^2X = \lambda^2 X\), donc \(\lambda = 0\). Le spectre est \(\{0\}\), et \(\dim E_0(A) = n – 1 < n\). Donc \(A\) est diagonalisable si et seulement si \(\operatorname{tr}(A) \neq 0\).
- On a \(J_n = UU^{T}\) avec \(U = (1, \ldots, 1)^{T}\), et \(\operatorname{tr}(J_n) = n \neq 0\). Le sous-espace \(E_0(J_n)\) est l’hyperplan \(x_1 + \cdots + x_n = 0\), de base \((e_1 – e_k)_{2 \leq\, k \leq\, n}\). Le sous-espace \(E_n(J_n)\) est la droite engendrée par \(U\). Ainsi \(J_n = PDP^{-1}\) avec \(D = \mathrm{diag}(n, 0, \ldots, 0)\) et \(P = (U \mid e_1 – e_2 \mid \cdots \mid e_1 – e_n)\). Enfin, \(\begin{pmatrix} 1 -1 \\ 1 -1 \end{pmatrix} = \begin{pmatrix} 1 \\ 1 \end{pmatrix}\begin{pmatrix} 1 -1 \end{pmatrix}\) est de rang 1 et de trace nulle. Elle n’est donc pas diagonalisable.
Corrigé de l’exercice 12 : Éléments propres d’endomorphismes de polynômes
- La linéarité découle de celle de la dérivation. De plus, si \(\deg P \leq\, n\), alors \(\deg P^{\prime} \leq\, n – 1\), donc \(\deg\big((X+1)P^{\prime}\big) \leq\, n\). Ainsi \(u\) est un endomorphisme de \(\mathbb{R}_n[X]\).
- Pour \(k \geq\, 1\), \(u(X^k) = (X + 1)kX^{k-1} = kX^k + kX^{k-1}\), et \(u(1) = 0\). La matrice est donc triangulaire supérieure, avec les coefficients \(0, 1, \ldots, n\) sur la diagonale et \(1, 2, \ldots, n\) juste au-dessus. Le spectre de \(u\) est \(\{0, 1, \ldots, n\}\). Il comporte \(n + 1\) valeurs propres distinctes en dimension \(n + 1\). Donc \(u\) est diagonalisable.
- Pour \(k \geq\, 1\), on a \(u\big((X+1)^k\big) = (X + 1) \cdot k(X+1)^{k-1} = k(X+1)^k\), et c’est aussi vrai pour \(k = 0\). Chaque \((X+1)^k\) est donc un vecteur propre pour la valeur propre \(k\). Ces polynômes sont échelonnés en degré, donc forment une famille libre de \(n + 1\) vecteurs. La famille \(\big(1, X+1, (X+1)^2, \ldots, (X+1)^n\big)\) est une base de vecteurs propres de \(u\).
- La matrice de \(D\) dans la base canonique est triangulaire supérieure stricte. Donc \(\chi_D = X^{n+1}\) et \(\mathrm{Sp}(D) = \{0\}\). Si \(D\) était diagonalisable, sa matrice dans une base propre serait nulle, donc \(D = 0\). Or \(D(X) = 1 \neq 0\) (on a \(n \geq\, 1\)). La dérivation \(D\) n’est donc pas diagonalisable.
Corrigé de l’exercice 13 : La transposition dans les matrices carrées
- Pour tous \(M, N\) et tout \(\alpha\) réel, \((\alpha M + N)^{T} = \alpha M^{T} + N^{T}\). Donc \(\tau\) est linéaire. De plus, \((M^{T})^{T} = M\). Ainsi \(\tau \circ \tau = \mathrm{id}\).
- Si \(\tau(M) = \lambda M\) avec \(M \neq 0\), alors \(M = \tau(\tau(M)) = \lambda^2 M\), donc \(\lambda^2 = 1\). Ensuite, \(\tau(M) = M\) signifie que \(M\) est symétrique, et \(\tau(M) = -M\) qu’elle est antisymétrique. Ces deux ensembles sont non nuls car \(n \geq\, 2\). Donc \(\mathrm{Sp}(\tau) = \{-1, 1\}\), \(E_1(\tau) = \mathcal{S}_n(\mathbb{R})\) et \(E_{-1}(\tau) = \mathcal{A}_n(\mathbb{R})\).
- Toute matrice s’écrit \(M = \frac{M + M^{T}}{2} + \frac{M – M^{T}}{2}\), somme d’une symétrique et d’une antisymétrique. Donc \(\mathcal{M}_n(\mathbb{R}) = E_1(\tau) + E_{-1}(\tau)\), et cette somme est directe. D’après le critère, \(\tau\) est diagonalisable. Une matrice symétrique est déterminée par ses coefficients sur et au-dessus de la diagonale. Ainsi \(\dim E_1(\tau) = \frac{n(n+1)}{2}\) et \(\dim E_{-1}(\tau) = \frac{n(n-1)}{2}\). On vérifie que leur somme vaut \(n^2\).
- Dans une base propre, la matrice de \(\tau\) est diagonale, avec \(\frac{n(n+1)}{2}\) coefficients égaux à 1 et \(\frac{n(n-1)}{2}\) égaux à \(-1\). D’une part, \(\operatorname{tr}(\tau) = \frac{n(n+1)}{2} – \frac{n(n-1)}{2} = n\). D’autre part, le déterminant est le produit des coefficients diagonaux. Donc \(\operatorname{tr}(\tau) = n\) et \(\det(\tau) = (-1)^{n(n-1)/2}\).
Corrigé de l’exercice 14 : Projecteurs et symétries
- Si \(p(x) = \lambda x\) avec \(x \neq 0\), alors \(p(p(x)) = \lambda^2 x\) et aussi \(p(x) = \lambda x\). Donc \(\lambda^2 = \lambda\), soit \(\lambda \in \{0, 1\}\). Ensuite, tout \(x\) s’écrit \(x = p(x) + \big(x – p(x)\big)\). Or \(p\big(p(x)\big) = p(x)\), donc \(p(x) \in \ker(p – \mathrm{id}_E)\). De même, \(p\big(x – p(x)\big) = p(x) – p(x) = 0\), donc \(x – p(x) \in \ker p\). Ainsi \(E = \ker p + \ker(p – \mathrm{id}_E)\). La somme est directe, car ce sont deux sous-espaces propres pour des valeurs distinctes (ou l’un d’eux est nul). Donc \(E = E_0(p) \oplus E_1(p)\), et \(p\) est diagonalisable.
- De même, \(s(x) = \lambda x\) avec \(x \neq 0\) entraîne \(\lambda^2 = 1\). On écrit \(x = \frac{x + s(x)}{2} + \frac{x – s(x)}{2}\). Or \(s\big(x + s(x)\big) = s(x) + x\) et \(s\big(x – s(x)\big) = -(x – s(x))\). Le premier terme est dans \(E_1(s)\), le second dans \(E_{-1}(s)\). Donc \(E = E_1(s) \oplus E_{-1}(s)\), et \(s\) est diagonalisable.
- On calcule \(\begin{pmatrix} 4 2 \\ 2 1 \end{pmatrix}^2 = \begin{pmatrix} 20 10 \\ 10 5 \end{pmatrix} = 5\begin{pmatrix} 4 2 \\ 2 1 \end{pmatrix}\). En divisant par 25, on obtient \(P^2 = P\). Ensuite, \(P(2,1) = \frac{1}{5}(10, 5) = (2,1)\) et \(P(1,-2) = \frac{1}{5}(0, 0) = 0\). Donc \(E_1(P) = \mathrm{Vect}\big((2,1)\big)\) et \(E_0(P) = \mathrm{Vect}\big((1,-2)\big)\) : \(P\) est la projection sur \(D\) parallèlement à \(D^{\prime}\).
- On a \(S = \frac{1}{5}\begin{pmatrix} 3 4 \\ 4 -3 \end{pmatrix}\). Comme \(P^2 = P\), il vient \(S^2 = 4P^2 – 4P + I_2 = I_2\). De plus, \(S\) vaut \(2 – 1 = 1\) sur \(E_1(P)\) et \(0 – 1 = -1\) sur \(E_0(P)\). Donc \(E_1(S) = \mathrm{Vect}\big((2,1)\big)\) et \(E_{-1}(S) = \mathrm{Vect}\big((1,-2)\big)\) : \(S\) est la symétrie par rapport à \(D\) parallèlement à \(D^{\prime}\). Enfin, \(Px = \frac{1}{5}(4 + 6, 2 + 3) = (2, 1)\) et \(Sx = 2Px – x = (3, -1)\). On obtient \(Px = (2,1)\) et \(Sx = (3,-1)\), conformément à la figure de l’énoncé : \(x = (2,1) + (-1, 2)\) se décompose sur \(D \oplus D^{\prime}\).
Corrigé de l’exercice 15 : Une famille d’exponentielles
- La fonction \(f_\lambda\) est non nulle et vérifie \(f_\lambda^{\prime} = \lambda f_\lambda\). Donc \(\lambda\) est valeur propre de \(D\). Réciproquement, soit \(f\) telle que \(f^{\prime} = \lambda f\). On pose \(g(x) = f(x)e^{-\lambda x}\). Alors \(g^{\prime}(x) = \big(f^{\prime}(x) – \lambda f(x)\big)e^{-\lambda x} = 0\). Comme \(\mathbb{R}\) est un intervalle, \(g\) est constante, égale à \(c\). Donc \(f = c f_\lambda\), et \(E_\lambda(D) = \mathrm{Vect}(f_\lambda)\) pour tout réel \(\lambda\).
- Les fonctions \(f_{\lambda_1}, \ldots, f_{\lambda_p}\) sont des vecteurs propres de \(D\) associés à des valeurs propres deux à deux distinctes. Or les sous-espaces propres associés sont en somme directe, et ce théorème vaut aussi en dimension infinie (sa preuve n’utilise pas la dimension). La famille \((f_{\lambda_1}, \ldots, f_{\lambda_p})\) est donc libre.
- On a \(c_k^{\prime\prime}(x) = -k^2\cos(kx)\), donc \(D^2(c_k) = -k^2 c_k\). Chaque \(c_k\) est non nulle (\(c_k(0) = 1\)). C’est donc un vecteur propre de \(D^2\) pour la valeur propre \(-k^2\). Ces valeurs propres \(0, -1, -4, \ldots, -n^2\) sont deux à deux distinctes. Par le même théorème appliqué à \(D^2\), la famille \((c_0, \ldots, c_n)\) est libre.
Corrigé de l’exercice 16 : Suite récurrente linéaire d’ordre 2
- La première coordonnée de \(X_{n+1}\) est \(u_{n+1}\), la seconde est \(u_{n+2} = 2u_n + u_{n+1}\). Donc \(C = \begin{pmatrix} 0 1 \\ 2 1 \end{pmatrix}\).
- On a \(\chi_C = X^2 – X – 2 = (X – 2)(X + 1)\). Pour une valeur propre \(\lambda\), le vecteur \((1, \lambda)\) vérifie \(C(1, \lambda) = (\lambda, 2 + \lambda) = (\lambda, \lambda^2) = \lambda(1, \lambda)\), puisque \(\lambda^2 = \lambda + 2\). Donc \(C = PDP^{-1}\) avec \(P = \begin{pmatrix} 1 1 \\ 2 -1 \end{pmatrix}\) et \(D = \mathrm{diag}(2, -1)\).
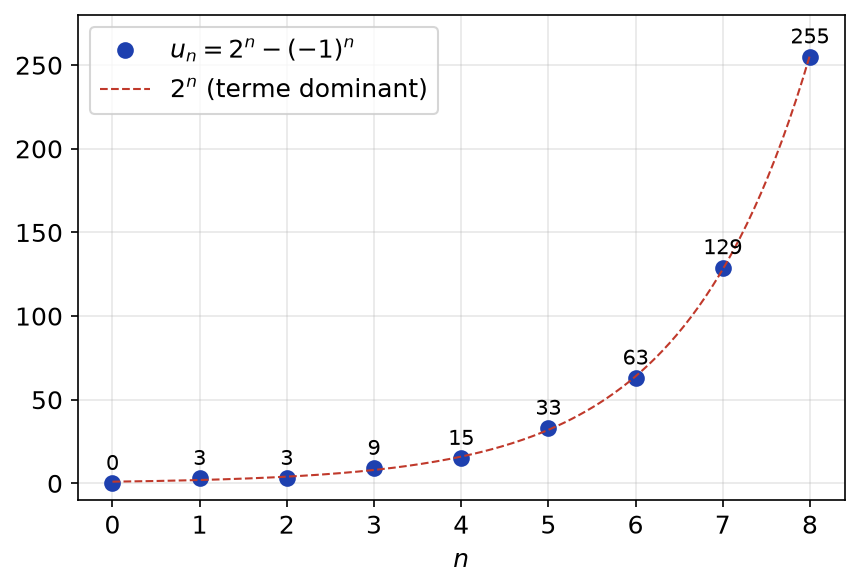
- On décompose \(X_0 = (0, 3)\) sur la base propre : \(a(1,2) + b(1,-1) = (0,3)\) donne \(a + b = 0\) et \(2a – b = 3\), d’où \(a = 1\) et \(b = -1\). Donc \(X_n = C^nX_0 = 2^n(1,2) – (-1)^n(1,-1)\). En lisant la première coordonnée, on obtient \(u_n = 2^n – (-1)^n\). Vérification : \(u_0 = 0\), \(u_1 = 3\), \(u_2 = 3 = u_1 + 2u_0\), \(u_3 = 9 = u_2 + 2u_1\).
- Comme \(\frac{(-1)^n}{2^n} \to 0\), on a \(u_n = 2^n\big(1 – (-\frac{1}{2})^n\big)\). Donc \(u_n \sim 2^n\) quand \(n \to +\infty\). La valeur propre de plus grand module impose la croissance.
La figure ci-dessous montre les premiers termes : ils suivent de très près la courbe de \(2^n\), à \(\pm 1\) près.
Corrigé de l’exercice 17 : Système de suites récurrentes
- En A restent 80 % des habitants de A, et arrivent 30 % de ceux de B. De même pour B. Ainsi \(x_{n+1} = \frac{4}{5}x_n + \frac{3}{10}y_n\), \(y_{n+1} = \frac{1}{5}x_n + \frac{7}{10}y_n\), et \(M = \begin{pmatrix} 4/5 3/10 \\ 1/5 7/10 \end{pmatrix}\).
- On a \(\operatorname{tr}(M) = \frac{3}{2}\) et \(\det M = \frac{28}{50} – \frac{3}{50} = \frac{1}{2}\). Donc \(\chi_M = X^2 – \frac{3}{2}X + \frac{1}{2} = (X – 1)(X – \frac{1}{2})\). Pour 1, l’équation \(-\frac{1}{5}x + \frac{3}{10}y = 0\) donne \(2x = 3y\). Pour \(\frac{1}{2}\), l’équation \(\frac{3}{10}x + \frac{3}{10}y = 0\) donne \(y = -x\). Donc \(\mathrm{Sp}(M) = \{1, \frac{1}{2}\}\), avec \(V_1 = (3, 2)\) propre pour 1 et \(V_2 = (1, -1)\) propre pour \(\frac{1}{2}\).
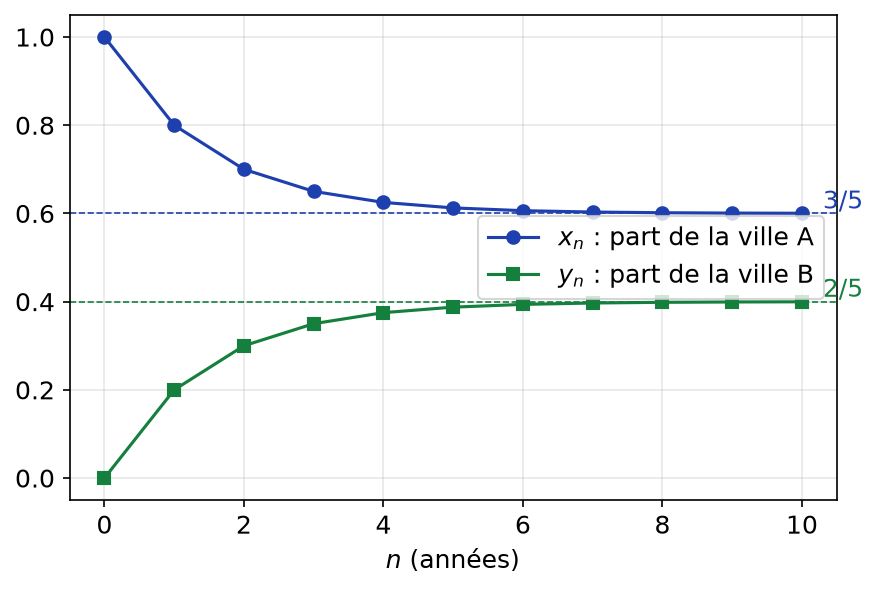
- On résout \(aV_1 + bV_2 = (1, 0)\) : \(3a + b = 1\) et \(2a – b = 0\), d’où \(a = \frac{1}{5}\) et \(b = \frac{2}{5}\). Donc \(X_n = \frac{1}{5}V_1 + \frac{2}{5}(\frac{1}{2})^n V_2\). On obtient \(x_n = \frac{3}{5} + \frac{2}{5}(\frac{1}{2})^n\) et \(y_n = \frac{2}{5} – \frac{2}{5}(\frac{1}{2})^n\), qui tendent vers \(\frac{3}{5}\) et \(\frac{2}{5}\). Vérification : \(x_1 = \frac{3}{5} + \frac{1}{5} = \frac{4}{5}\).
- Avec \(P = \begin{pmatrix} 3 1 \\ 2 -1 \end{pmatrix}\), de déterminant \(-5\), on a \(P^{-1} = \frac{1}{5}\begin{pmatrix} 1 1 \\ 2 -3 \end{pmatrix}\). Ensuite, \(M^n = P\,\mathrm{diag}\big(1, 2^{-n}\big)P^{-1}\), ce qui donne :
\[M^n = \frac{1}{5}\begin{pmatrix} 3 + 2 \cdot 2^{-n} 3 – 3 \cdot 2^{-n} \\ 2 – 2 \cdot 2^{-n} 2 + 3 \cdot 2^{-n} \end{pmatrix} \xrightarrow[n \to +\infty]{ \frac{1}{5}\begin{pmatrix} 3 3 \\ 2 2 \end{pmatrix}.\]
Les deux colonnes de la limite valent \((\frac{3}{5}, \frac{2}{5})\) : quelle que soit la répartition initiale, la population se stabilise à 60 % en A et 40 % en B.
La figure ci-dessous illustre la convergence géométrique de raison \(\frac{1}{2}\) vers cette répartition d’équilibre.
Corrigé de l’exercice 18 : Système différentiel d’ordre 2
- Le système s’écrit \(X^{\prime} = AX\) avec \(A = \begin{pmatrix} 1 2 \\ 2 1 \end{pmatrix}\). On a \(\chi_A = X^2 – 2X – 3 = (X – 3)(X + 1)\). Ensuite, \(A(1,1) = (3,3)\) et \(A(1,-1) = (-1,1)\). Donc \(A = PDP^{-1}\) avec \(P = \begin{pmatrix} 1 1 \\ 1 -1 \end{pmatrix}\) et \(D = \mathrm{diag}(3, -1)\).
- D’après le théorème du cours sur les systèmes différentiels diagonalisables, les solutions sont \(x(t) = c_1e^{3t} + c_2e^{-t}\) et \(y(t) = c_1e^{3t} – c_2e^{-t}\), avec \((c_1, c_2) \in \mathbb{R}^2\).
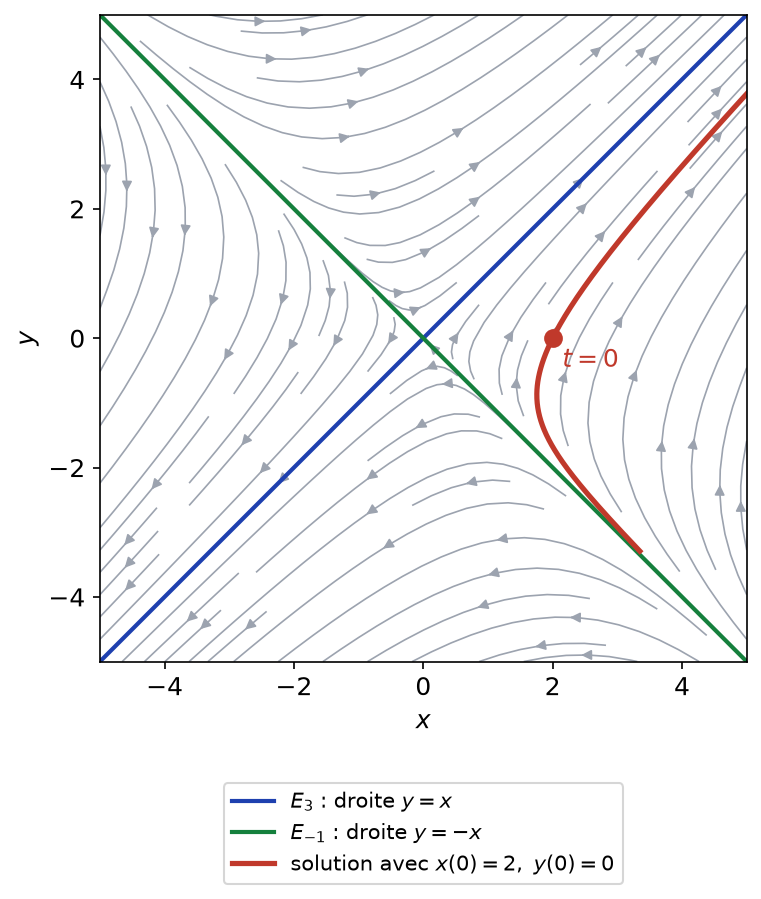
- En \(t = 0\), on obtient \(c_1 + c_2 = 2\) et \(c_1 – c_2 = 0\), soit \(c_1 = c_2 = 1\). Donc \(x(t) = e^{3t} + e^{-t}\) et \(y(t) = e^{3t} – e^{-t}\). Vérification : \(x^{\prime}(t) = 3e^{3t} – e^{-t}\), et \(x + 2y = 3e^{3t} – e^{-t}\).
- Sur \([0, +\infty[\), \(e^{-t}\) est bornée alors que \(e^{3t}\) tend vers \(+\infty\). La solution est bornée si et seulement si \(c_1 = 0\). Or \(c_1 = \frac{x(0) + y(0)}{2}\). La solution est bornée sur \([0, +\infty[\) si et seulement si \(x(0) + y(0) = 0\), c’est-à-dire si la condition initiale est sur la droite propre \(E_{-1}\).
Le portrait de phase ci-dessous représente la solution de la question 3. Partie du point \((2, 0)\), elle s’approche d’abord de \(E_{-1}\) quand \(t\) décroît, puis s’aligne sur la direction de \(E_3\) quand \(t\) croît.
Corrigé de l’exercice 19 : Système différentiel d’ordre 3
- Les lignes de \(A\) sont \((0, 1, 1)\), \((-1, 2, 1)\) et \((-1, 1, 2)\). Le produit \(AX\) redonne exactement les seconds membres. Le système s’écrit donc \(X^{\prime} = AX\).
- D’après l’exercice 7, \(A\) est diagonalisable avec \(E_1 = \mathrm{Vect}\big((1,1,0), (1,0,1)\big)\) et \(E_2 = \mathrm{Vect}\big((1,1,1)\big)\). Les solutions sont les fonctions \(X(t) = ae^{t}(1,1,0) + be^{t}(1,0,1) + ce^{2t}(1,1,1)\), avec \(a, b, c\) réels.
- On décompose \(X(0) = (1,0,0)\) : ses coordonnées dans la base propre sont données par la première colonne de \(P^{-1}\), soit \((a, b, c) = (1, 1, -1)\). On le vérifie : \((1,1,0) + (1,0,1) – (1,1,1) = (1,0,0)\). Donc \(x(t) = 2e^{t} – e^{2t}\) et \(y(t) = z(t) = e^{t} – e^{2t}\). Vérification dans la première équation : \(x^{\prime}(t) = 2e^{t} – 2e^{2t}\), et \(y + z = 2e^{t} – 2e^{2t}\).
Corrigé de l’exercice 20 : Chemins dans un graphe
- On développe selon la première ligne :
\[\chi_A(X) = \begin{vmatrix} X -1 0 \\ -1 X -1 \\ 0 -1 X \end{vmatrix} = X(X^2 – 1) + (-X) = X^3 – 2X.\]
Donc \(\chi_A = X(X – \sqrt{2})(X + \sqrt{2})\). Ensuite, \(A(1,0,-1) = (0,0,0)\), \(A(1,\sqrt{2},1) = (\sqrt{2}, 2, \sqrt{2})\) et \(A(1,-\sqrt{2},1) = (-\sqrt{2}, 2, -\sqrt{2})\). Les valeurs propres sont \(0, \sqrt{2}, -\sqrt{2}\), de vecteurs propres \((1,0,-1)\), \((1,\sqrt{2},1)\), \((1,-\sqrt{2},1)\). - La matrice possède trois valeurs propres distinctes en dimension 3. Elle est donc diagonalisable : \(A = PDP^{-1}\) avec \(D = \mathrm{diag}(0, \sqrt{2}, -\sqrt{2})\). Or \(D^3 = \mathrm{diag}(0, 2\sqrt{2}, -2\sqrt{2}) = 2D\). Par conséquent, \(A^3 = PD^3P^{-1} = 2PDP^{-1} = 2A\).
- Par récurrence sur \(k\), on obtient \(A^{2k+1} = 2^kA\) : c’est vrai pour \(k = 0\), et \(A^{2k+3} = A^{2k+1}A^2 = 2^k A^3 = 2^{k+1}A\). Ensuite, pour \(k \geq\, 1\), \(A^{2k} = A^{2k-1}A = 2^{k-1}A^2\). Donc \(A^{2k+1} = 2^kA\) et \(A^{2k} = 2^{k-1}A^2\), avec \(A^2 = \begin{pmatrix} 1 0 1 \\ 0 2 0 \\ 1 0 1 \end{pmatrix}\).
- On a \(A^{10} = 2^4 A^2\). Le coefficient \((1,3)\) de \(A^2\) vaut 1 et le coefficient \((2,2)\) vaut 2. De plus, \(A^7 = 2^3A\), dont le coefficient \((1,2)\) vaut 8. Il y a 16 chemins de longueur 10 de 1 à 3, 32 chemins de longueur 10 de 2 à 2, et 8 chemins de longueur 7 de 1 à 2. Contrôle direct pour le dernier cas : partant de 1, on passe par 2 aux étapes 1, 3, 5 et 7 ; aux étapes 2, 4 et 6, on choisit librement 1 ou 3, soit \(2^3 = 8\) chemins.
Corrigé de l’exercice 21 : Démonstration du critère de diagonalisabilité
- Pour \(p = 1\), il n’y a rien à démontrer. Supposons la propriété vraie pour \(p – 1\) valeurs propres distinctes. Soient \(x_i \in E_{\lambda_i}(u)\) tels que \(x_1 + \cdots + x_p = 0\). En appliquant \(u – \lambda_p\,\mathrm{id}_E\), on obtient \(\sum_{i=1}^{p-1}(\lambda_i – \lambda_p)x_i = 0\). Chaque terme appartient à \(E_{\lambda_i}(u)\). Par hypothèse de récurrence, \((\lambda_i – \lambda_p)x_i = 0\), donc \(x_i = 0\) puisque \(\lambda_i \neq \lambda_p\). Il reste \(x_p = 0\). La somme des sous-espaces propres est donc directe.
- Soit \((e_1, \ldots, e_d)\) une base de \(E_{\lambda_1}(u)\), complétée en une base \(\mathcal{B}\) de \(E\). La matrice de \(u\) dans \(\mathcal{B}\) s’écrit \(\begin{pmatrix} \lambda_1 I_d B \\ 0 C \end{pmatrix}\). Le déterminant d’une matrice triangulaire par blocs est le produit des déterminants des blocs diagonaux. Donc \(\chi_u = (X – \lambda_1)^d\chi_C\). Par conséquent, \((X – \lambda_1)^d\) divise \(\chi_u\), d’où \(d \leq\, m(\lambda_1)\) ; et \(d \geq\, 1\) car \(\lambda_1\) est valeur propre.
- Si \(u\) est diagonalisable, une base propre se répartit entre les \(E_{\lambda_i}(u)\), donc \(E = \sum E_{\lambda_i}(u)\). Comme la somme est directe, \(n = \sum \dim E_{\lambda_i}(u)\). Réciproquement, si \(\sum \dim E_{\lambda_i}(u) = n\), la somme directe \(\bigoplus E_{\lambda_i}(u)\) est de dimension \(n\), donc égale à \(E\). En concaténant des bases des \(E_{\lambda_i}(u)\), on obtient une base de vecteurs propres. Donc \(u\) est diagonalisable si et seulement si \(\sum \dim E_{\lambda_i}(u) = n\).
- D’après la question 2, \(\sum_i \dim E_{\lambda_i}(u) \leq\, \sum_i m(\lambda_i) \leq\, n\). La seconde inégalité est une égalité si et seulement si \(\chi_u\) est scindé. La première est une égalité si et seulement si \(\dim E_{\lambda_i}(u) = m(\lambda_i)\) pour tout \(i\), puisque chaque terme vérifie déjà \(\dim E_{\lambda_i}(u) \leq\, m(\lambda_i)\). Avec la question 3, \(u\) est diagonalisable si et seulement si \(\chi_u\) est scindé et \(\dim E_{\lambda_i}(u) = m(\lambda_i)\) pour tout \(i\).
Corrigé de l’exercice 22 : Endomorphismes qui commutent
- Soit \(x \in E_{\lambda_i}(u)\). Alors \(u\big(v(x)\big) = v\big(u(x)\big) = v(\lambda_i x) = \lambda_i v(x)\). Donc \(v(x) \in E_{\lambda_i}(u)\) : chaque sous-espace propre de \(u\) est stable par \(v\).
- Comme \(u\) a \(n\) valeurs propres distinctes, chaque \(E_{\lambda_i}(u)\) est la droite \(\mathrm{Vect}(e_i)\). Cette droite est stable par \(v\), donc \(v(e_i) = \mu_i e_i\) pour un scalaire \(\mu_i\). Ainsi la matrice de \(v\) dans \((e_1, \ldots, e_n)\) est diagonale. Réciproquement, si \(u\) et \(v\) sont diagonales dans la même base, leurs matrices commutent, donc \(u \circ v = v \circ u\). Les éléments de \(\mathcal{C}(u)\) sont exactement les endomorphismes diagonaux dans la base \((e_1, \ldots, e_n)\).
- Les \(\lambda_i\) étant distincts, l’interpolation de Lagrange fournit un unique polynôme \(Q\) de degré au plus \(n – 1\) tel que \(Q(\lambda_i) = \mu_i\) pour tout \(i\). Pour chaque \(i\), on a \(u^k(e_i) = \lambda_i^k e_i\), donc \(Q(u)(e_i) = Q(\lambda_i)e_i = \mu_i e_i = v(e_i)\). Deux applications linéaires égales sur une base sont égales. Donc \(v = Q(u)\).
- L’application \(\Phi : \mathbb{K}_{n-1}[X] \to \mathcal{L}(E)\), \(Q \mapsto Q(u)\), est linéaire. Son image est contenue dans \(\mathcal{C}(u)\), car tout polynôme en \(u\) commute avec \(u\), et elle contient \(\mathcal{C}(u)\) d’après la question 3. Ainsi \(\mathcal{C}(u) = \operatorname{Im}\Phi\) est un sous-espace vectoriel. De plus, si \(Q(u) = 0\), alors \(Q(\lambda_i) = 0\) pour les \(n\) valeurs \(\lambda_i\) distinctes. Un polynôme de degré au plus \(n – 1\) ayant \(n\) racines est nul, donc \(\Phi\) est injective. Par conséquent, \(\dim \mathcal{C}(u) = n\), et \((\mathrm{id}_E, u, \ldots, u^{n-1})\), image de la base canonique, en est une base.
Corrigé de l’exercice 23 : Racines carrées d’une matrice
- On a \(\chi_A = X^2 – 10X + 9 = (X – 1)(X – 9)\). Ensuite, \(A(1,1) = (9,9)\) et \(A(1,-1) = (1,-1)\). Donc \(A = PDP^{-1}\) avec \(P = \begin{pmatrix} 1 1 \\ 1 -1 \end{pmatrix}\), \(D = \mathrm{diag}(9, 1)\) et \(P^{-1} = \frac{1}{2}\begin{pmatrix} 1 1 \\ 1 -1 \end{pmatrix}\).
- Si \(B^2 = A\), alors \(AB = B^2B = B^3 = BB^2 = BA\). Donc \(A\) et \(B\) commutent.
- Soit \(X \in E_9(A)\). Alors \(A(BX) = B(AX) = 9BX\), donc \(BX \in E_9(A)\). De même pour \(E_1(A)\). Ces deux sous-espaces sont des droites, donc \((1,1)\) et \((1,-1)\) sont des vecteurs propres de \(B\). Par conséquent, \(P^{-1}BP = \mathrm{diag}(\beta_1, \beta_2)\) est diagonale.
- En élevant au carré, \(\mathrm{diag}(\beta_1^2, \beta_2^2) = P^{-1}AP = \mathrm{diag}(9, 1)\). Donc \(\beta_1 = \pm 3\) et \(\beta_2 = \pm 1\). Réciproquement, ces quatre choix donnent bien \(B^2 = A\). Le calcul général donne :
\[P\,\mathrm{diag}(\beta_1, \beta_2)\,P^{-1} = \frac{1}{2}\begin{pmatrix} \beta_1 + \beta_2 \beta_1 – \beta_2 \\ \beta_1 – \beta_2 \beta_1 + \beta_2 \end{pmatrix}.\]
Les solutions sont exactement \(\pm\begin{pmatrix} 2 1 \\ 1 2 \end{pmatrix}\) et \(\pm\begin{pmatrix} 1 2 \\ 2 1 \end{pmatrix}\). Vérification : \(\begin{pmatrix} 1 2 \\ 2 1 \end{pmatrix}^2 = \begin{pmatrix} 5 4 \\ 4 5 \end{pmatrix}\).
Point de méthode : le fait que les valeurs propres de \(A\) soient simples est essentiel. Par exemple, \(I_2\) admet une infinité de racines carrées, dont toutes les symétries.
Corrigé de l’exercice 24 : Problème : matrices compagnons et récurrences d’ordre 3
Partie A.
- On développe \(\chi_C(X) = \begin{vmatrix} X -1 0 \\ 0 X -1 \\ -c_0 -c_1 X – c_2 \end{vmatrix}\) selon la première colonne :
\[\chi_C(X) = X\begin{vmatrix} X -1 \\ -c_1 X – c_2 \end{vmatrix} – c_0\begin{vmatrix} -1 0 \\ X -1 \end{vmatrix} = X\big(X^2 – c_2X – c_1\big) – c_0.\]
Donc \(\chi_C(X) = X^3 – c_2X^2 – c_1X – c_0\). - Soit \(v = (x, y, z)\) tel que \(Cv = \lambda v\). Les deux premières lignes donnent \(y = \lambda x\) et \(z = \lambda y = \lambda^2 x\). Donc \(v = x(1, \lambda, \lambda^2)\), et \(\dim E_\lambda(C) \leq\, 1\). Comme \(\lambda\) est valeur propre, cette dimension vaut 1. On vérifie la troisième ligne : \(c_0 + c_1\lambda + c_2\lambda^2 = \lambda^3\), puisque \(\chi_C(\lambda) = 0\). Donc \(E_\lambda(C) = \mathrm{Vect}\big((1, \lambda, \lambda^2)\big)\).
- Si \(\chi_C\) a trois racines réelles distinctes, \(C\) est diagonalisable d’après le corollaire du cours. Réciproquement, si \(C\) est diagonalisable sur \(\mathbb{R}\), la somme des dimensions des sous-espaces propres vaut 3. Or chacune vaut 1 d’après la question 2. Il y a donc trois valeurs propres réelles distinctes. Ainsi \(C\) est diagonalisable dans \(\mathcal{M}_3(\mathbb{R})\) si et seulement si \(\chi_C\) a trois racines réelles distinctes.
Partie B.
- La relation \(u_{n+3} = -2u_n + u_{n+1} + 2u_{n+2}\) donne la troisième ligne de \(C\). Donc \(X_{n+1} = CX_n\) avec \(c_0 = -2\), \(c_1 = 1\) et \(c_2 = 2\).
- On a \(\chi_C = X^3 – 2X^2 – X + 2 = X^2(X – 2) – (X – 2) = (X – 2)(X – 1)(X + 1)\). Les trois racines sont réelles et distinctes. D’après la partie A, \(C = PDP^{-1}\) avec \(D = \mathrm{diag}(1, -1, 2)\) et \(P = \begin{pmatrix} 1 1 1 \\ 1 -1 2 \\ 1 1 4 \end{pmatrix}\).
- On décompose \(X_0 = (3, 2, 6)\) sur les colonnes de \(P\) : \(a + b + c = 3\), \(a – b + 2c = 2\), \(a + b + 4c = 6\). La différence des équations 3 et 1 donne \(3c = 3\), donc \(c = 1\). Il reste \(a + b = 2\) et \(a – b = 0\), donc \(a = b = 1\). Ainsi \(X_n = V_1 + (-1)^nV_2 + 2^nV_3\), et la première coordonnée donne le résultat. Donc \(u_n = 1 + (-1)^n + 2^n\) pour tout \(n \in \mathbb{N}\). Vérification : \(u_3 = 2 \times 6 + 2 – 2 \times 3 = 8\), et \(1 – 1 + 8 = 8\).
- Ici \(c_0 = 1\), \(c_1 = -3\), \(c_2 = 3\). Donc \(\chi_C = X^3 – 3X^2 + 3X – 1 = (X – 1)^3\). La seule valeur propre est 1, de multiplicité 3, mais \(\dim E_1 = 1\) d’après la partie A. Cette matrice compagnon n’est donc pas diagonalisable.
Point de méthode : pour une récurrence linéaire d’ordre \(p\) dont le polynôme caractéristique a \(p\) racines simples \(r_j\), on peut écrire directement \(u_n = \sum_j a_j r_j^n\) et identifier les \(a_j\) grâce aux conditions initiales.
Revenir aux énoncés des exercices
Pour aller plus loin en L2
- Le cours : diagonalisation, cours de maths en L2
- Les énoncés : exercices de maths en L2 sur diagonalisation
- Chapitre précédent : Intégrales généralisées
- Chapitre suivant : Polynômes d'endomorphismes et trigonalisation
- Tester vos connaissances : QCM de maths en L2 par chapitre
- Le sommaire : tous les chapitres de maths de L2 et la licence de maths de L1 à L3