Ce cours de probabilités L1 pose le cadre axiomatique d’un espace probabilisé fini. Vous y apprenez d’abord à modéliser une expérience aléatoire par un univers fini et une probabilité, puis à calculer par dénombrement lorsque les issues sont équiprobables. Le chapitre se place au second semestre, après le dénombrement, dont il réutilise les listes, les arrangements et les combinaisons.
Ensuite, le cours développe la probabilité conditionnelle, les formules des probabilités composées et des probabilités totales, la formule de Bayes et l’indépendance d’événements. Enfin, il introduit les variables aléatoires finies, leur loi, leur espérance et leur variance, ainsi que les lois uniforme, de Bernoulli et binomiale. Chaque résultat important est démontré.
Ce chapitre prépare directement les probabilités de deuxième et troisième année. En effet, les variables discrètes infinies, les lois continues et les théorèmes limites reposent tous sur les notions introduites ici.
Pour vous entraîner ensuite, travaillez les exercices de maths en L1 sur probabilités finies.
I. Expérience aléatoire, univers fini et événements
Une expérience est dite aléatoire lorsque son résultat ne peut pas être prévu avec certitude, même si l’on connaît toutes ses conditions. Lancer un dé, tirer une carte ou choisir une personne au hasard en sont des exemples. La théorie des probabilités commence par un travail de modélisation : on décrit d’abord l’ensemble des résultats possibles, puis on leur attribue des poids.
1. Univers et issues
L’univers d’une expérience aléatoire est l’ensemble \(\Omega\) de tous ses résultats possibles, appelés issues. Dans tout ce chapitre, \(\Omega\) est un ensemble fini et non vide.
Le choix de \(\Omega\) n’est pas imposé par l’expérience. En effet, plusieurs univers peuvent convenir, et l’on choisit celui qui rend les calculs les plus simples. Par exemple, pour deux lancers de dé, on préfère souvent les couples ordonnés aux sommes obtenues.
On lance un dé rouge et un dé bleu. On prend \(\Omega = \{1, \ldots, 6\}^2\) : l’issue \((i, j)\) signifie que le dé rouge donne \(i\) et le dé bleu donne \(j\). Ainsi \(\mathrm{card}(\Omega) = 36\). Si l’on tire simultanément 5 cartes d’un jeu de 32, on prend pour \(\Omega\) l’ensemble des parties à 5 éléments du jeu. Son cardinal vaut alors \(\binom\,{32}{5} = 201\,376\).
2. Événements et opérations
Un événement est une partie \(A\) de \(\Omega\). On dit que \(A\) est réalisé lorsque l’issue observée appartient à \(A\). Un singleton \(\{\omega\}\) est un événement élémentaire. L’ensemble vide est l’événement impossible, et \(\Omega\) est l’événement certain.
Les opérations sur les ensembles se traduisent directement dans le langage des événements. Le tableau mental à retenir est le suivant :
- \(A \cup B\) (« \(A\) ou \(B\) ») est réalisé si au moins l’un des deux l’est ;
- \(A \cap B\) (« \(A\) et \(B\) ») est réalisé si les deux le sont ;
- \(\overline{A} = \Omega \setminus A\) est l’événement contraire de \(A\) ;
- \(A\) et \(B\) sont incompatibles lorsque \(A \cap B = \emptyset\) ;
- \(A \subset B\) signifie que \(A\) implique \(B\).
Les lois de De Morgan restent valables : \(\overline{A \cup B} = \overline{A} \cap \overline{B}\) et \(\overline{A \cap B} = \overline{A} \cup \overline{B}\). Le diagramme ci-dessous montre comment \(A\) et \(B\) découpent l’univers en quatre morceaux deux à deux disjoints.
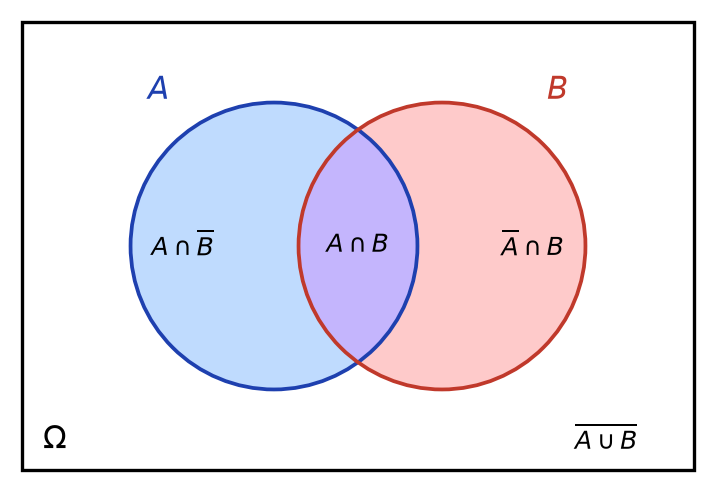
Une famille \((A_1, \ldots, A_n)\) d’événements est un système complet d’événements si les \(A_i\) sont deux à deux incompatibles et si leur réunion vaut \(\Omega\). Autrement dit, chaque issue appartient à un et un seul des \(A_i\).
Par exemple, pour tout événement \(A\), la famille \((A, \overline{A})\) est un système complet. De même, la famille des quatre morceaux de la figure en est un.
II. Probabilités sur un univers fini
1. Définition axiomatique
Une probabilité sur \(\Omega\) est une application \(P : \mathcal{P}(\Omega) \to [0, 1]\) telle que :
- \(P(\Omega) = 1\) ;
- pour tous événements incompatibles \(A\) et \(B\), \(P(A \cup B) = P(A) + P(B)\) (additivité).
Le couple \((\Omega, P)\) est alors un espace probabilisé fini.
Ces deux axiomes suffisent. En effet, toutes les règles de calcul habituelles en découlent, comme le montre la proposition suivante.
Soit \((\Omega, P)\) un espace probabilisé fini et \(A\), \(B\) deux événements. Alors :
- \(P(\emptyset) = 0\) et \(P(\overline{A}) = 1 – P(A)\) ;
- si \(A \subset B\), alors \(P(B \setminus A) = P(B) – P(A)\) et \(P(A) \leq\, P(B)\) ;
- \(P(A \cup B) = P(A) + P(B) – P(A \cap B)\) ;
- si \(A_1, \ldots, A_n\) sont deux à deux incompatibles, \(P(A_1 \cup \cdots \cup A_n) = P(A_1) + \cdots + P(A_n)\).
D’abord, \(\Omega\) et \(\emptyset\) sont incompatibles, donc \(P(\Omega) = P(\Omega) + P(\emptyset)\), d’où \(P(\emptyset) = 0\). Ensuite, \(A\) et \(\overline{A}\) sont incompatibles de réunion \(\Omega\), donc \(P(A) + P(\overline{A}) = 1\). Si \(A \subset B\), on écrit \(B = A \cup (B \setminus A)\), réunion disjointe. Ainsi \(P(B) = P(A) + P(B \setminus A)\), et ce dernier terme est positif. Pour la réunion, on écrit \(A \cup B = A \cup (B \setminus (A \cap B))\), réunion disjointe, puis on applique le point précédent avec \(A \cap B \subset B\). Enfin, le dernier point se prouve par récurrence sur \(n\).
La formule de la réunion se lit sur la figure de la partie I : en ajoutant \(P(A)\) et \(P(B)\), on compte deux fois la zone centrale \(A \cap B\). C’est pourquoi on la retranche une fois.
Pour trois événements, la même idée donne la formule du crible : \(P(A \cup B \cup C) = P(A) + P(B) + P(C) – P(A \cap B) – P(A \cap C) – P(B \cap C) + P(A \cap B \cap C)\). Elle se généralise à \(n\) événements.
2. Une probabilité est déterminée par les issues
Soit \(\Omega = \{\omega_1, \ldots, \omega_n\}\). Si \(P\) est une probabilité sur \(\Omega\), les réels \(p_i = P(\{\omega_i\})\) sont positifs, de somme 1, et pour tout événement \(A\), \(P(A) = \sum_{\omega_i \in A} p_i\). Réciproquement, pour tous réels positifs \(p_1, \ldots, p_n\) de somme 1, il existe une unique probabilité \(P\) sur \(\Omega\) telle que \(P(\{\omega_i\}) = p_i\) pour tout \(i\).
Un événement \(A\) est la réunion disjointe des singletons de ses éléments. L’additivité donne donc \(P(A) = \sum_{\omega_i \in A} p_i\), et le cas \(A = \Omega\) donne \(\sum p_i = 1\). Réciproquement, on pose \(P(A) = \sum_{\omega_i \in A} p_i\). Cette quantité est dans \([0, 1]\) et vaut 1 pour \(A = \Omega\). De plus, si \(A\) et \(B\) sont disjoints, la somme sur \(A \cup B\) se coupe en deux sommes. L’unicité résulte du sens direct.
On truque un dé pour que la probabilité d’obtenir \(k\) soit proportionnelle à \(k\). On cherche \(c\) tel que \(p_k = ck\). La condition \(c(1 + 2 + \cdots + 6) = 1\) donne \(c = \frac{1}{21}\). Par conséquent, la probabilité d’obtenir un nombre pair vaut \(\frac{2 + 4 + 6}{21} = \frac{4}{7}\).
3. Équiprobabilité et dénombrement
La probabilité uniforme sur \(\Omega\) est celle qui donne le même poids à toutes les issues. On parle alors d’équiprobabilité, et pour tout événement \(A\) :
\[P(A) = \frac{\mathrm{card}(A)}{\mathrm{card}(\Omega)} = \frac{\text{nombre de cas favorables}}{\text{nombre de cas possibles}}.\]
Cette formule ne s’applique que si les issues sont réellement équiprobables. Par exemple, avec deux dés, les sommes de 2 à 12 ne le sont pas. En revanche, les 36 couples le sont, pour des dés équilibrés.
Pour calculer une probabilité par dénombrement :
- choisir un univers où les issues sont équiprobables (listes ordonnées pour des tirages successifs, parties pour des tirages simultanés) ;
- calculer \(\mathrm{card}(\Omega)\) avec les outils de dénombrement : \(n^p\) listes, \(\frac{n!}{(n-p)!}\) arrangements, \(\binom\,{n}{p}\) combinaisons ;
- compter les cas favorables avec le même type d’objets, en décomposant en choix successifs ;
- passer par l’événement contraire lorsqu’il s’agit d’un « au moins un ».
On tire 5 cartes parmi 32. La probabilité d’obtenir au moins un as vaut \(1 – \frac{\binom\,{28}{5}}{\binom\,{32}{5}}\). En effet, l’événement contraire consiste à choisir les 5 cartes parmi les 28 qui ne sont pas des as. Numériquement, on trouve \(1 – \frac{98\,280}{201\,376} = \frac{1841}{3596} \approx 0{,}512\).
III. Probabilités conditionnelles
Une information partielle sur le résultat modifie les chances des événements. Par exemple, savoir que la somme de deux dés vaut 10 rend impossible l’obtention d’un 1. La probabilité conditionnelle formalise cette mise à jour.
1. Définition
Soit \(B\) un événement tel que \(P(B) > 0\). La probabilité de \(A\) sachant \(B\) est le réel
\[P_B(A) = P(A \mid B) = \frac{P(A \cap B)}{P(B)}.\]
Si \(P(B) > 0\), l’application \(P_B : A \mapsto P_B(A)\) est une probabilité sur \(\Omega\). En particulier, \(P_B(\overline{A}) = 1 – P_B(A)\).
Comme \(A \cap B \subset B\), on a \(0 \leq\, P_B(A) \leq\, 1\). Ensuite, \(P_B(\Omega) = \frac{P(B)}{P(B)} = 1\). Enfin, si \(A\) et \(C\) sont incompatibles, alors \(A \cap B\) et \(C \cap B\) le sont aussi. Donc \(P((A \cup C) \cap B) = P(A \cap B) + P(C \cap B)\), et il suffit de diviser par \(P(B)\).
En situation d’équiprobabilité, \(P_B(A) = \frac{\mathrm{card}(A \cap B)}{\mathrm{card}(B)}\). Autrement dit, on restreint l’univers aux issues de \(B\).
2. Formule des probabilités composées
Soit \(A_1, \ldots, A_n\) des événements tels que \(P(A_1 \cap \cdots \cap A_{n-1}) > 0\). Alors
\[P(A_1 \cap \cdots \cap A_n) = P(A_1)\, P_{A_1}(A_2)\, P_{A_1 \cap A_2}(A_3) \cdots P_{A_1 \cap \cdots \cap A_{n-1}}(A_n).\]
Toutes les intersections \(A_1 \cap \cdots \cap A_k\), pour \(k \leq\, n-1\), contiennent \(A_1 \cap \cdots \cap A_{n-1}\). Elles sont donc de probabilité strictement positive, et les conditionnements ont un sens. Ensuite, en remplaçant chaque probabilité conditionnelle par sa définition, le produit devient télescopique. Il ne reste que \(P(A_1 \cap \cdots \cap A_n)\).
Une urne contient 3 boules blanches et 5 noires. On tire trois boules successivement sans remise. Notons \(N_k\) « la \(k\)-ième boule est noire ». La probabilité d’obtenir la première blanche au troisième tirage vaut
\[P(N_1 \cap N_2 \cap \overline{N_3}) = \frac{5}{8} \times \frac{4}{7} \times \frac{3}{6} = \frac{5}{28}.\]
3. Formule des probabilités totales
Soit \((A_1, \ldots, A_n)\) un système complet d’événements tous de probabilité non nulle. Pour tout événement \(B\) :
\[P(B) = \sum_{i=1}^{n} P(A_i \cap B) = \sum_{i=1}^{n} P(A_i)\, P_{A_i}(B).\]
Les événements \(A_i \cap B\) sont deux à deux incompatibles, car les \(A_i\) le sont. De plus, leur réunion vaut \(B \cap (A_1 \cup \cdots \cup A_n) = B \cap \Omega = B\). L’additivité donne la première égalité. Ensuite, la définition de \(P_{A_i}(B)\) donne \(P(A_i \cap B) = P(A_i) P_{A_i}(B)\).
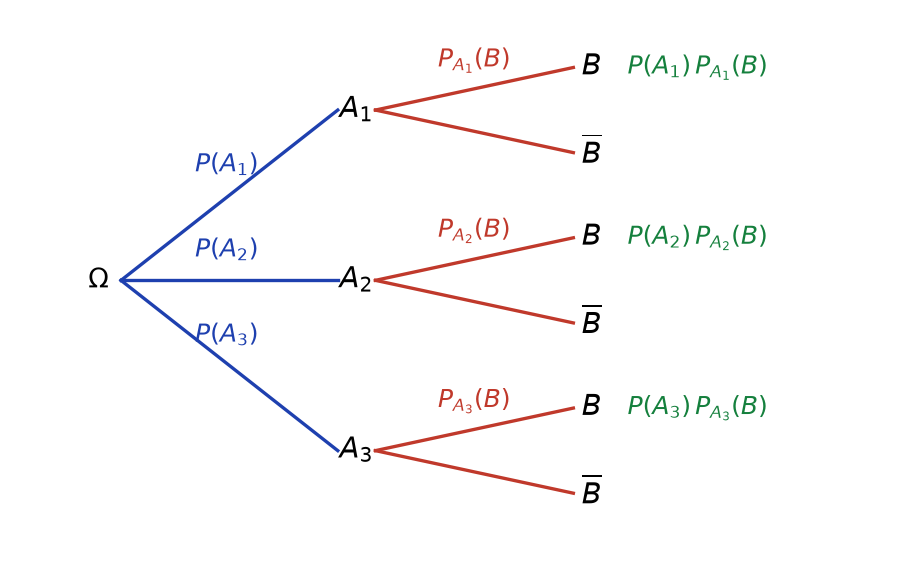
La formule se visualise sur un arbre pondéré, comme le montre la figure ci-dessous. Chaque chemin menant à \(B\) a pour probabilité le produit des poids de ses branches. Ensuite, on additionne les chemins.
4. Formule de Bayes
Souvent, on connaît \(P_A(B)\) mais on cherche \(P_B(A)\). Par exemple, on connaît la fiabilité d’un test sur les malades, mais on veut savoir si une personne testée positive est malade. La formule de Bayes « retourne » le conditionnement.
Soit \(A\) et \(B\) des événements de probabilité non nulle. Alors \(P_B(A) = \dfrac{P(A)\, P_A(B)}{P(B)}\). Si de plus \((A_1, \ldots, A_n)\) est un système complet d’événements de probabilités non nulles, alors pour tout \(j\) :
\[P_B(A_j) = \frac{P(A_j)\, P_{A_j}(B)}{\sum_{i=1}^{n} P(A_i)\, P_{A_i}(B)}.\]
On a \(P(A \cap B) = P(B) P_B(A) = P(A) P_A(B)\), d’où la première formule. Pour la seconde, on remplace \(P(B)\) par son expression donnée par la formule des probabilités totales.
Face à un énoncé qui mêle causes et conséquences :
- nommer les événements et repérer un système complet de « causes » \(A_i\) ;
- traduire chaque donnée : un pourcentage « parmi les \(A_i\) » est une probabilité conditionnelle \(P_{A_i}(B)\) ;
- dessiner l’arbre, puis calculer \(P(B)\) par les probabilités totales ;
- terminer par la formule de Bayes pour obtenir \(P_B(A_j)\).
Une maladie touche 1 % d’une population. Un test est positif chez 99 % des malades et chez 2 % des personnes saines. Si \(M\) désigne « être malade » et \(T\) « test positif », alors \(P(T) = 0{,}01 \times 0{,}99 + 0{,}99 \times 0{,}02 = 0{,}0297\). Ainsi \(P_T(M) = \frac{0{,}0099}{0{,}0297} = \frac{1}{3}\). Un test positif ne donne donc qu’une chance sur trois d’être malade.
IV. Indépendance d’événements
Deux événements \(A\) et \(B\) sont indépendants si \(P(A \cap B) = P(A)\, P(B)\). Lorsque \(P(B) > 0\), cela équivaut à \(P_B(A) = P(A)\) : savoir que \(B\) est réalisé ne change pas la probabilité de \(A\).
Il ne faut pas confondre indépendants et incompatibles. Si \(A\) et \(B\) sont incompatibles et de probabilités non nulles, alors \(P(A \cap B) = 0 \neq P(A) P(B)\). Ils ne sont donc pas indépendants : savoir que \(B\) est réalisé empêche \(A\).
Si \(A\) et \(B\) sont indépendants, alors \(A\) et \(\overline{B}\) le sont, ainsi que \(\overline{A}\) et \(\overline{B}\).
On a \(P(A \cap \overline{B}) = P(A) – P(A \cap B) = P(A) – P(A)P(B) = P(A)(1 – P(B)) = P(A) P(\overline{B})\). On applique ensuite ce résultat au couple \((\overline{B}, A)\), ce qui donne l’indépendance de \(\overline{B}\) et \(\overline{A}\).
Des événements \(A_1, \ldots, A_n\) sont mutuellement indépendants si, pour toute partie \(I\) non vide de \(\{1, \ldots, n\}\),
\[P\Big(\bigcap_{i \in I} A_i\Big) = \prod_{i \in I} P(A_i).\]
L’indépendance mutuelle est plus forte que l’indépendance deux à deux. En effet, avec deux dés, les événements « le premier est pair », « le second est pair » et « la somme est paire » sont indépendants deux à deux. Cependant, les deux premiers entraînent le troisième, si bien que la probabilité de l’intersection vaut \(\frac{1}{4}\) et non \(\frac{1}{8}\).
On répète \(n\) fois, de façon indépendante, une épreuve qui réussit avec probabilité \(p\). Les échecs sont alors mutuellement indépendants, de probabilité \(1 – p\). La probabilité d’au moins une réussite vaut donc \(1 – (1 – p)^n\). Par exemple, avec \(p = 0{,}3\), il faut \(n = 9\) essais pour dépasser \(0{,}95\), car \(0{,}7^8 \approx 0{,}058\) et \(0{,}7^9 \approx 0{,}040\).
En pratique, l’indépendance est le plus souvent une hypothèse de modélisation : des lancers successifs, des tirages avec remise ou des individus choisis séparément sont supposés indépendants. On la vérifie par le calcul seulement quand le modèle est déjà fixé.
V. Variables aléatoires finies et lois
On s’intéresse souvent à un nombre associé au résultat plutôt qu’au résultat lui-même : une somme, un gain, un nombre de succès. C’est le rôle des variables aléatoires.
Une variable aléatoire réelle sur \(\Omega\) est une application \(X : \Omega \to \mathbb{R}\). Comme \(\Omega\) est fini, l’ensemble \(X(\Omega)\) de ses valeurs est fini. Pour toute partie \(U\) de \(\mathbb{R}\), on note \((X \in U)\) l’événement \(\{\omega \in \Omega : X(\omega) \in U\}\), et \((X = x)\) lorsque \(U = \{x\}\).
La loi de \(X\) est la donnée des probabilités \(P(X = x)\) pour \(x\) parcourant \(X(\Omega)\). Les événements \((X = x)\), pour \(x \in X(\Omega)\), forment un système complet, donc \(\sum_{x \in X(\Omega)} P(X = x) = 1\).
Pour déterminer la loi d’une variable aléatoire finie :
- lister l’ensemble \(X(\Omega)\) des valeurs possibles ;
- pour chaque valeur \(x\), décrire l’événement \((X = x)\) et calculer sa probabilité ;
- quand \((X = x)\) est difficile à décrire, calculer d’abord \(P(X \leq\, x)\), puis \(P(X = x) = P(X \leq\, x) – P(X \leq\, x – 1)\) si les valeurs sont entières ;
- vérifier que la somme des probabilités vaut 1.
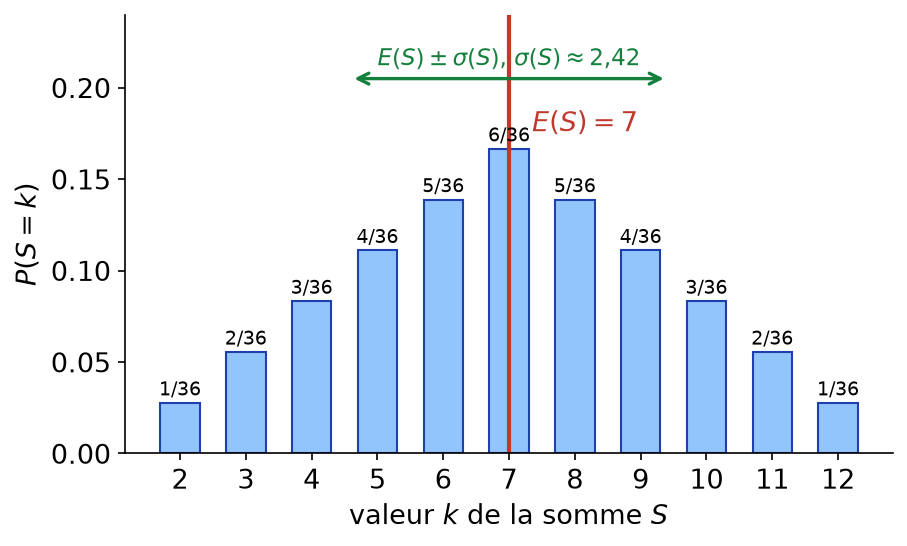
On lance deux dés équilibrés et l’on note \(S\) la somme. Alors \(S(\Omega) = \{2, \ldots, 12\}\). Pour \(2 \leq\, k \leq\, 12\), l’événement \((S = k)\) contient \(6 – |k – 7|\) couples. Par conséquent, \(P(S = k) = \frac{6 – |k – 7|}{36}\). La somme de ces nombres vaut bien \(\frac{36}{36} = 1\).
Si \(f\) est une fonction de \(X(\Omega)\) dans \(\mathbb{R}\), alors \(f(X) = f \circ X\) est encore une variable aléatoire. Sa loi se déduit de celle de \(X\), car \(P(f(X) = y) = \sum_{x : f(x) = y} P(X = x)\).
VI. Espérance et variance
1. Espérance
L’espérance de \(X\) est la moyenne de ses valeurs pondérées par leurs probabilités :
\[E(X) = \sum_{x \in X(\Omega)} x\, P(X = x) = \sum_{\omega \in \Omega} X(\omega)\, P(\{\omega\}).\]
Les deux expressions coïncident. En effet, il suffit de regrouper dans la seconde somme les issues qui donnent la même valeur de \(X\). La seconde forme rend évidentes les propriétés suivantes.
Soit \(X\) et \(Y\) deux variables aléatoires sur \(\Omega\), \(a\) et \(b\) deux réels.
- Linéarité : \(E(aX + bY) = a E(X) + b E(Y)\) et \(E(a) = a\).
- Positivité : si \(X \geq\, 0\), alors \(E(X) \geq\, 0\) ; si \(X \leq\, Y\), alors \(E(X) \leq\, E(Y)\).
- Transfert : pour toute fonction \(f\), \(E(f(X)) = \sum_{x \in X(\Omega)} f(x)\, P(X = x)\).
La linéarité et la positivité découlent de la forme \(\sum_{\omega} X(\omega) P(\{\omega\})\), car une somme finie est linéaire et croissante. Pour le transfert, on écrit \(E(f(X)) = \sum_{\omega} f(X(\omega)) P(\{\omega\})\). Ensuite, on regroupe les issues selon la valeur \(x = X(\omega)\) : le groupe associé à \(x\) a pour poids total \(P(X = x)\).
Le théorème de transfert est précieux : il calcule \(E(X^2)\) ou \(E(2^X)\) sans chercher la loi de \(X^2\) ou de \(2^X\). De même, la linéarité permet de calculer l’espérance d’une somme sans connaître sa loi.
2. Variance et écart type
La variance de \(X\) est \(V(X) = E\big((X – E(X))^2\big)\). C’est un réel positif. L’écart type est \(\sigma(X) = \sqrt{V(X)}\). Il mesure la dispersion de \(X\) autour de sa moyenne, dans la même unité que \(X\).
Formule de König-Huygens : \(V(X) = E(X^2) – E(X)^2\). De plus, pour tous réels \(a\) et \(b\), \(V(aX + b) = a^2 V(X)\). Enfin, \(V(X) = 0\) si et seulement si \(X\) est constante sur les issues de probabilité non nulle.
Posons \(m = E(X)\). On développe \((X – m)^2 = X^2 – 2mX + m^2\). La linéarité donne \(V(X) = E(X^2) – 2m^2 + m^2 = E(X^2) – m^2\). Ensuite, \(E(aX + b) = am + b\), donc \(aX + b – E(aX + b) = a(X – m)\), et \(V(aX + b) = a^2 V(X)\). Enfin, \(V(X) = \sum_{\omega} (X(\omega) – m)^2 P(\{\omega\})\) est une somme de termes positifs. Elle est nulle si et seulement si \(X(\omega) = m\) pour toute issue de poids non nul.
Pour calculer une variance, on calcule d’abord \(E(X)\), puis \(E(X^2) = \sum x^2 P(X = x)\) par transfert. Ensuite, on applique König-Huygens. Si \(Y = aX + b\), on n’effectue pas de nouveau calcul : \(E(Y) = aE(X) + b\) et \(V(Y) = a^2 V(X)\).
Pour la somme \(S\) de deux dés, la symétrie de la loi autour de 7 donne \(E(S) = 7\). Par transfert, \(E(S^2) = \frac{1974}{36}\). Par conséquent, \(V(S) = \frac{1974}{36} – 49 = \frac{210}{36} = \frac{35}{6}\), et \(\sigma(S) \approx 2{,}42\).
La figure ci-dessous représente la loi de \(S\). L’espérance se situe au centre de symétrie, et l’écart type donne l’ordre de grandeur des écarts à 7.
VII. Lois uniforme, de Bernoulli et binomiale
1. Loi uniforme
Soit \(E\) un ensemble fini non vide. Une variable \(X\) suit la loi uniforme sur \(E\) si \(X(\Omega) = E\) et \(P(X = x) = \frac{1}{\mathrm{card}(E)}\) pour tout \(x \in E\). On note \(X \sim \mathcal{U}(E)\).
Si \(X \sim \mathcal{U}(\{1, \ldots, n\})\), alors \(E(X) = \dfrac{n+1}{2}\) et \(V(X) = \dfrac{n^2 – 1}{12}\).
D’abord, \(E(X) = \frac{1}{n} \sum_{k=1}^{n} k = \frac{n+1}{2}\). Ensuite, par transfert, \(E(X^2) = \frac{1}{n} \sum_{k=1}^{n} k^2 = \frac{(n+1)(2n+1)}{6}\). Enfin, König-Huygens donne
\[V(X) = \frac{(n+1)(2n+1)}{6} – \frac{(n+1)^2}{4} = \frac{(n+1)(4n + 2 – 3n – 3)}{12} = \frac{(n+1)(n-1)}{12}.\]
2. Loi de Bernoulli
Soit \(p \in [0, 1]\). Une variable \(X\) suit la loi de Bernoulli de paramètre \(p\) si \(X(\Omega) \subset \{0, 1\}\), \(P(X = 1) = p\) et \(P(X = 0) = 1 – p\). On note \(X \sim \mathcal{B}(p)\). Alors \(E(X) = p\) et \(V(X) = p(1 – p)\).
En effet, \(X^2 = X\) puisque \(X\) ne prend que les valeurs 0 et 1. Donc \(E(X^2) = p\) et \(V(X) = p – p^2\). Par exemple, l’indicatrice \(\mathbf{1}_A\) d’un événement \(A\) suit la loi de Bernoulli de paramètre \(P(A)\). On l’utilise pour coder le succès d’une épreuve.
3. Loi binomiale
Soit \(n \in \mathbb{N}^*\) et \(p \in [0, 1]\). Une variable \(X\) suit la loi binomiale de paramètres \(n\) et \(p\), notée \(\mathcal{B}(n, p)\), si \(X(\Omega) \subset \{0, \ldots, n\}\) et, pour tout \(k \in \{0, \ldots, n\}\),
\[P(X = k) = \binom\,{n}{k} p^k (1 – p)^{n – k}.\]
La formule du binôme montre que ces nombres ont pour somme \((p + (1 – p))^n = 1\). Le théorème suivant explique d’où vient cette loi.
On répète \(n\) fois, de façon mutuellement indépendante, une épreuve de Bernoulli de probabilité de succès \(p\). Le nombre \(X\) de succès obtenus suit la loi \(\mathcal{B}(n, p)\). De plus, \(E(X) = np\) et \(V(X) = np(1 – p)\).
Notons \(S_i\) l’événement « succès à la \(i\)-ième épreuve ». Soit \(I\) une partie de \(\{1, \ldots, n\}\) à \(k\) éléments. L’événement « succès exactement aux rangs de \(I\) » est l’intersection des \(S_i\) pour \(i \in I\) et des \(\overline{S_i}\) pour \(i \notin I\). Par indépendance, sa probabilité vaut \(p^k (1-p)^{n-k}\). Or \((X = k)\) est la réunion disjointe de ces événements, et il y a \(\binom\,{n}{k}\) parties \(I\). D’où la loi. Ensuite, \(X = \mathbf{1}_{S_1} + \cdots + \mathbf{1}_{S_n}\), donc \(E(X) = np\) par linéarité. Pour la variance, on utilise \(k\binom\,{n}{k} = n\binom\,{n-1}{k-1}\) deux fois, ce qui donne \(E(X(X-1)) = n(n-1)p^2\). Ainsi \(V(X) = n(n-1)p^2 + np – n^2p^2 = np(1-p)\).
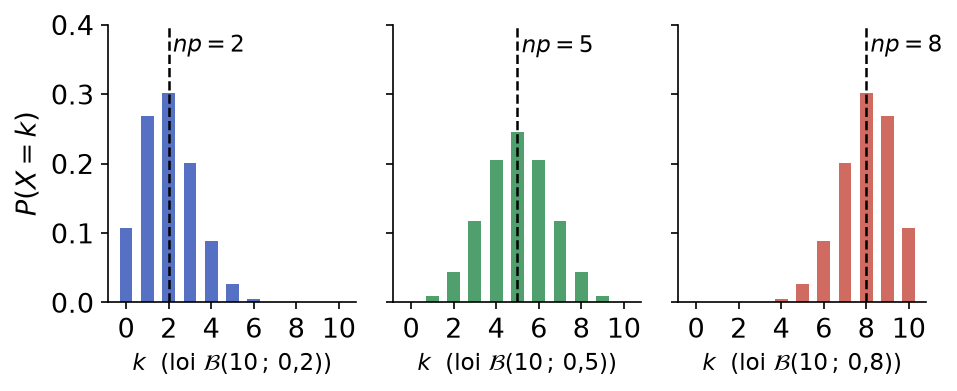
La figure suivante compare trois lois binomiales de paramètre \(n = 10\). On observe que la masse se concentre autour de l’espérance \(np\), et que la loi est symétrique lorsque \(p = \frac{1}{2}\).
Un étudiant répond au hasard aux 10 questions d’un QCM, chacune ayant 4 réponses dont une seule juste. Les réponses étant indépendantes, le nombre \(X\) de bonnes réponses suit \(\mathcal{B}(10, \frac{1}{4})\). Ainsi \(E(X) = 2{,}5\) et \(V(X) = \frac{15}{8}\). De plus, \(P(X = 0) = (\frac{3}{4})^{10} \approx 0{,}056\).
Un tirage simultané de \(n\) boules dans une urne ne donne pas une loi binomiale, car les tirages ne sont pas indépendants. La loi obtenue, dite hypergéométrique, se calcule par dénombrement. Elle se rapproche toutefois de la loi binomiale lorsque l’urne est très grande devant \(n\).
Ce qu’il faut retenir
- Modéliser, c’est choisir un univers fini \(\Omega\) et une probabilité \(P\) ; celle-ci est entièrement déterminée par les poids des issues.
- En situation d’équiprobabilité, \(P(A) = \frac{\mathrm{card}(A)}{\mathrm{card}(\Omega)}\) : on dénombre avec des objets du même type au numérateur et au dénominateur.
- \(P(A \cup B) = P(A) + P(B) – P(A \cap B)\) et \(P(\overline{A}) = 1 – P(A)\) ; pour un « au moins un », on passe au contraire.
- \(P_B(A) = \frac{P(A \cap B)}{P(B)}\) et \(P_B\) est une probabilité.
- Probabilités composées pour une succession d’épreuves, probabilités totales sur un système complet, formule de Bayes pour retourner le conditionnement.
- \(A\) et \(B\) sont indépendants si \(P(A \cap B) = P(A)P(B)\) ; l’indépendance mutuelle est plus forte que l’indépendance deux à deux.
- La loi d’une variable finie est la liste des \(P(X = x)\) ; leur somme vaut 1.
- L’espérance est linéaire ; la variance vérifie \(V(X) = E(X^2) – E(X)^2\) et \(V(aX + b) = a^2 V(X)\).
- \(\mathcal{U}(\{1, \ldots, n\})\) : \(E = \frac{n+1}{2}\), \(V = \frac{n^2-1}{12}\) ; \(\mathcal{B}(p)\) : \(E = p\), \(V = p(1-p)\) ; \(\mathcal{B}(n, p)\) : \(E = np\), \(V = np(1-p)\).
Questions fréquentes sur probabilités finies
Quelle est la différence entre événements indépendants et incompatibles ?
Deux événements sont incompatibles s’ils ne peuvent pas se produire ensemble, c’est-à-dire si \(A \cap B = \emptyset\). Ils sont indépendants si \(P(A \cap B) = P(A)P(B)\). Deux événements incompatibles de probabilités non nulles ne sont jamais indépendants, car la réalisation de l’un empêche l’autre.
Quand peut-on utiliser la formule cas favorables sur cas possibles ?
Uniquement lorsque la probabilité est uniforme sur l’univers choisi, c’est-à-dire lorsque toutes les issues ont la même probabilité. Il faut donc choisir un univers adapté, par exemple des couples ordonnés pour deux dés plutôt que les sommes. Le numérateur et le dénominateur doivent compter le même type d’objets.
À quoi sert la formule de Bayes ?
Elle permet de retourner un conditionnement : on connaît \(P_A(B)\) et l’on cherche \(P_B(A)\). Elle s’écrit \(P_B(A) = \frac{P(A)P_A(B)}{P(B)}\), où \(P(B)\) se calcule le plus souvent par la formule des probabilités totales. C’est l’outil des problèmes de diagnostic et de test de dépistage.
Comment calculer rapidement la variance d'une variable aléatoire ?
On utilise la formule de König-Huygens \(V(X) = E(X^2) – E(X)^2\), en calculant \(E(X^2)\) par le théorème de transfert. Pour une transformation affine, \(V(aX + b) = a^2 V(X)\). Pour les lois usuelles, on retient directement \(V(X) = np(1-p)\) pour une loi binomiale.
Pour aller plus loin en L1
- Les énoncés : exercices de maths en L1 sur probabilités finies
- À maîtriser avant : Entiers naturels, récurrence et dénombrement
- Chapitre précédent : Géométrie du plan et de l'espace
- Le même thème en maths sup : probabilités sur un univers fini, cours de maths sup
- Tester vos connaissances : QCM de maths en L1 par chapitre
- Le sommaire : tous les chapitres de maths de L1 et la licence de maths de L1 à L3