Ce corrigé applications linéaires rédige entièrement les 21 exercices, comme on l’attend en partiel. Chaque solution vérifie d’abord la linéarité, puis cite le résultat du cours utilisé : caractérisation de l’injectivité par le noyau, détermination par l’image d’une base, théorème du rang.
Soyez attentifs à trois points. D’abord, une inclusion et une égalité de dimensions suffisent pour prouver l’égalité de deux sous-espaces. Ensuite, l’équivalence entre injectivité et surjectivité exige la dimension finie et des dimensions égales. Enfin, pour un projecteur ou une symétrie, on résout toujours \(p(x) = x\), \(p(x) = 0\) ou \(s(x) = \pm x\). Les figures illustrent les noyaux, les images et les constructions obtenues.
Chaque résultat final est écrit en gras. De plus, les calculs sont contrôlés sur un exemple dès que c’est possible, afin que vous puissiez vérifier votre propre réponse.
Les énoncés se trouvent sur la page exercices de maths en L1 sur applications linéaires.
Corrigé de l’exercice 1 : Linéaire ou non linéaire
- Soient \(u = (x, y, z)\), \(v = (x^{\prime}, y^{\prime}, z^{\prime})\) et \(\lambda, \mu \in \mathbb{R}\). La première coordonnée de \(f_1(\lambda u + \mu v)\) vaut \((\lambda x + \mu x^{\prime}) – 2(\lambda y + \mu y^{\prime}) + (\lambda z + \mu z^{\prime})\), soit \(\lambda(x – 2y + z) + \mu(x^{\prime} – 2y^{\prime} + z^{\prime})\). De même, la seconde vaut \(3\lambda y + 3\mu y^{\prime}\). Donc \(f_1(\lambda u + \mu v) = \lambda f_1(u) + \mu f_1(v)\). L’application \(f_1\) est linéaire.
- On a \(f_2(0, 0) = (0, 1) \neq (0, 0)\). Or une application linéaire envoie le vecteur nul sur le vecteur nul. Donc \(f_2\) n’est pas linéaire.
- D’une part, \(f_3(2 \cdot (1, 1)) = f_3(2, 2) = 4\). D’autre part, \(2 f_3(1, 1) = 2\). L’homogénéité est donc en défaut. L’application \(f_3\) n’est pas linéaire.
- Soient \(P, Q \in \mathbb{R}_2[X]\) et \(\lambda, \mu \in \mathbb{R}\). La dérivation est linéaire, et l’évaluation en un point aussi. Ainsi, \(f_4(\lambda P + \mu Q) = \lambda P(2) + \mu Q(2) – \lambda P^{\prime}(0) – \mu Q^{\prime}(0) = \lambda f_4(P) + \mu f_4(Q)\). L’application \(f_4\) est une forme linéaire.
- D’abord, si \(g\) est continue, alors \(x \mapsto x g(x)\) est continue comme produit de fonctions continues. Donc \(f_5\) est bien à valeurs dans \(\mathcal{C}([0, 1], \mathbb{R})\). Ensuite, pour tout \(x\), on a \(x(\lambda g + \mu h)(x) = \lambda x g(x) + \mu x h(x)\). Donc \(f_5(\lambda g + \mu h) = \lambda f_5(g) + \mu f_5(h)\). L’application \(f_5\) est linéaire, de l’espace dans lui-même : c’est un endomorphisme.
- On a \(\det I_2 = 1\) et \(\det(2 I_2) = 4 \neq 2 \det I_2\). Le déterminant n’est pas une application linéaire sur \(\mathcal{M}_2(\mathbb{R})\).
Point de méthode : tester \(f(0)\) puis \(f(2x)\) élimine la plupart des applications non linéaires en une ligne.
Corrigé de l’exercice 2 : Différence finie sur les polynômes de degré 2
- Si \(\deg P \leq\, 2\), alors \(\deg P(X + 1) \leq\, 2\). Donc \(u(P) \in \mathbb{R}_2[X]\). Ensuite, pour \(P, Q\) et \(\lambda, \mu\) réels, la composition par \(X + 1\) est linéaire : \((\lambda P + \mu Q)(X + 1) = \lambda P(X + 1) + \mu Q(X + 1)\). Par différence, \(u(\lambda P + \mu Q) = \lambda u(P) + \mu u(Q)\). Ainsi, \(u\) est un endomorphisme de \(\mathbb{R}_2[X]\).
- On calcule \(u(1) = 1 – 1 = 0\), puis \(u(X) = (X + 1) – X = 1\). Enfin, \(u(X^2) = (X + 1)^2 – X^2 = 2X + 1\). On obtient \(u(1) = 0\), \(u(X) = 1\) et \(u(X^2) = 2X + 1\).
- Soit \(P = a + bX + cX^2\). Par linéarité, \(u(P) = b \cdot 1 + c(2X + 1) = (b + c) + 2cX\). Donc \(u(P) = 0\) équivaut à \(b + c = 0\) et \(2c = 0\), c’est-à-dire \(b = c = 0\). Par conséquent, \(\ker u = \mathbb{R}_0[X]\), de base \((1)\).
L’image est engendrée par les images de la base \((1, X, X^2)\). Donc \(\mathrm{Im}\, u = \mathrm{Vect}(0, 1, 2X + 1) = \mathrm{Vect}(1, 2X + 1)\). Or \(X = \frac{1}{2}\big((2X + 1) – 1\big)\), donc cet espace contient \(1\) et \(X\). Finalement, \(\ker u = \mathbb{R}_0[X]\) et \(\mathrm{Im}\, u = \mathbb{R}_1[X]\), de base \((1, X)\).
- On a \(\dim \ker u + \mathrm{rg}\, u = 1 + 2 = 3 = \dim \mathbb{R}_2[X]\), conformément au théorème du rang. Le noyau n’est pas réduit à \(\{0\}\), donc \(u\) n’est pas injectif. De plus, \(X^2 \notin \mathrm{Im}\, u\). L’endomorphisme \(u\) n’est ni injectif ni surjectif.
Corrigé de l’exercice 3 : Noyau et image d’un endomorphisme de l’espace
- Chaque coordonnée de \(f(x, y, z)\) est une combinaison linéaire de \(x\), \(y\) et \(z\). Pour \(u, v\) et \(\lambda, \mu\), on vérifie donc coordonnée par coordonnée que \(f(\lambda u + \mu v) = \lambda f(u) + \mu f(v)\). Ainsi, \(f\) est linéaire.
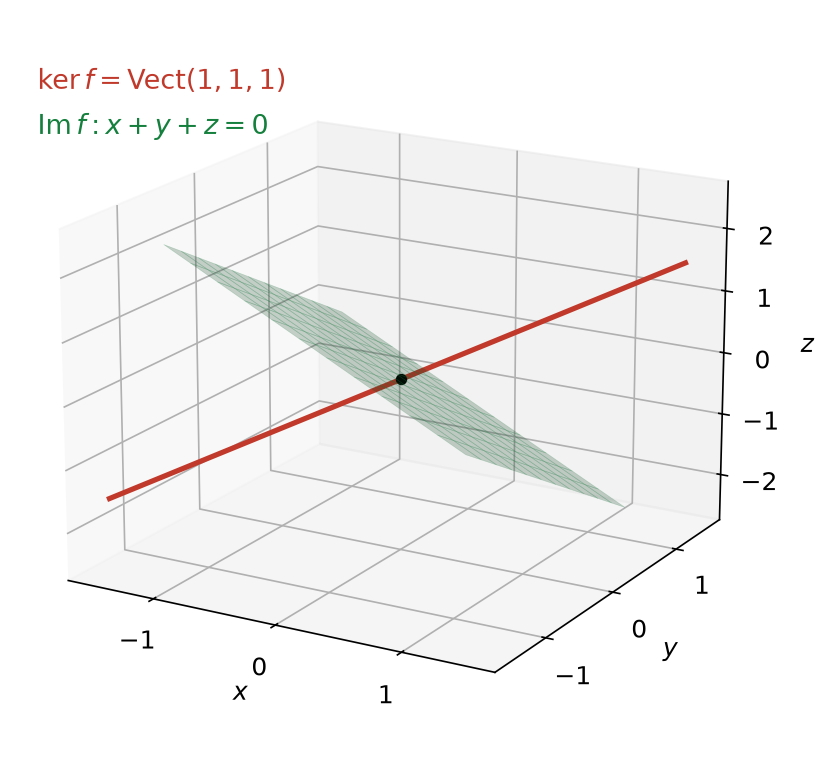
- On résout \(f(x, y, z) = 0\), soit \(x – y = 0\), \(y – z = 0\) et \(z – x = 0\). Ce système équivaut à \(x = y = z\). Donc \(\ker f = \mathrm{Vect}((1, 1, 1))\), et \(((1, 1, 1))\) en est une base.
- Pour tout \((x, y, z)\), la somme des coordonnées de \(f(x, y, z)\) vaut \((x – y) + (y – z) + (z – x) = 0\). Donc \(\mathrm{Im}\, f \subset P\). Ensuite, le théorème du rang donne \(\mathrm{rg}\, f = 3 – \dim \ker f = 2\). Or \(P\) est un plan, donc \(\dim P = 2\). Un sous-espace inclus dans \(P\) et de même dimension lui est égal. Par conséquent, \(\mathrm{Im}\, f = P\).
- Soit \(t(1, 1, 1)\) un vecteur de \(\ker f\) qui appartient aussi à \(P\). Alors \(3t = 0\), donc \(t = 0\). Ainsi, \(\ker f \cap \mathrm{Im}\, f = \{0\}\). De plus, \(\dim \ker f + \dim \mathrm{Im}\, f = 1 + 2 = 3\). Donc \(\mathbb{R}^3 = \ker f \oplus \mathrm{Im}\, f\). La figure ci-dessous montre la droite \(\ker f\) qui perce le plan \(\mathrm{Im}\, f\) en l’origine seulement.
Point de méthode : une inclusion et une égalité de dimensions suffisent pour prouver l’égalité de deux sous-espaces de dimension finie.
Corrigé de l’exercice 4 : Injectivité et équation de l’image
- L’application \(f\) est linéaire, car ses coordonnées sont linéaires en \((x, y)\). Résolvons \(f(x, y) = 0\). Les équations \(x + 2y = 0\) et \(x – y = 0\) donnent, par différence, \(3y = 0\). Donc \(y = 0\), puis \(x = 0\). Ainsi, \(\ker f = \{0\}\). D’après la caractérisation par le noyau, \(f\) est injective.
- Le théorème du rang donne \(\mathrm{rg}\, f = \dim \mathbb{R}^2 – \dim \ker f = 2\). Or \(\dim \mathbb{R}^3 = 3\). Donc \(\mathrm{rg}\, f = 2 < 3\), et \(f\) n’est pas surjective.
- Soit \((a, b, c) \in \mathbb{R}^3\). Ce vecteur est dans l’image si et seulement si le système \(x + 2y = a\), \(3x + 4y = b\), \(x – y = c\) admet une solution. La première et la troisième équation donnent \(3y = a – c\). Ainsi, \(y = \frac{a – c}{3}\) et \(x = c + y = \frac{a + 2c}{3}\). Reportons dans la deuxième équation :
\[ 3x + 4y = (a + 2c) + \frac{4(a – c)}{3} = \frac{7a + 2c}{3}. \]
Le système est donc compatible si et seulement si \(7a + 2c = 3b\). Une équation de \(\mathrm{Im}\, f\) est \(7a – 3b + 2c = 0\). On vérifie d’ailleurs que \(f(1, 0) = (1, 3, 1)\) et \(f(0, 1) = (2, 4, -1)\) satisfont cette équation.
- Pour \((1, 1, -2)\), on trouve \(7 – 3 – 4 = 0\). Ce vecteur appartient donc à l’image. Les formules précédentes donnent \(y = \frac{1 + 2}{3} = 1\) et \(x = \frac{1 – 4}{3} = -1\). On vérifie : \(f(-1, 1) = (1, -3 + 4, -2) = (1, 1, -2)\). L’unique antécédent est \((-1, 1)\) ; il est unique car \(f\) est injective.
Corrigé de l’exercice 5 : Opérations sur deux endomorphismes du plan
- On calcule \(f \circ g(x, y) = f(x, 0) = (0, x)\) et \(g \circ f(x, y) = g(y, x) = (y, 0)\). Par exemple, en \((1, 0)\), on obtient \((0, 1)\) d’un côté et \((0, 0)\) de l’autre. Ainsi, \(f \circ g \neq g \circ f\) : la composition n’est pas commutative.
- Par définition des opérations dans \(\mathcal{L}(\mathbb{R}^2)\), on a \((2f – g)(x, y) = 2(y, x) – (x, 0)\). Donc \((2f – g)(x, y) = (2y – x, 2x)\).
- D’abord, \(f \circ f(x, y) = f(y, x) = (x, y)\), donc \(f \circ f = \mathrm{Id}\). Ensuite, \(g \circ g(x, y) = g(x, 0) = (x, 0)\), donc \(g \circ g = g\). La relation \(f \circ f = \mathrm{Id}\) montre que \(f\) est bijective. Par conséquent, \(f\) est un automorphisme et \(f^{-1} = f\).
- On a \(h(x, y) = (0, x)\), donc \(h \circ h(x, y) = h(0, x) = (0, 0)\). Ainsi, \(h \circ h = 0\) alors que \(h \neq 0\). Dans \(\mathcal{L}(\mathbb{R}^2)\), un produit de composition peut être nul sans qu’aucun facteur ne le soit.
Corrigé de l’exercice 6 : Application définie par l’image d’une base
- Cherchons \(a, b, c\) réels tels que \(a u_1 + b u_2 + c u_3 = (x, y, z)\). Ce système s’écrit \(a + b + c = x\), \(b + c = y\) et \(c = z\). Il est triangulaire, et sa solution unique est \(c = z\), \(b = y – z\), \(a = x – y\). Chaque vecteur s’écrit donc de façon unique dans la famille. La famille \((u_1, u_2, u_3)\) est une base, et \((x, y, z) = (x – y) u_1 + (y – z) u_2 + z\, u_3\).
- Le théorème de détermination par l’image d’une base assure l’existence et l’unicité de \(f\). Par linéarité, on obtient :
\[ f(x, y, z) = (x – y)(1, 2) + (y – z)(0, 1) + z(3, 1). \]
En développant, la première coordonnée vaut \(x – y + 3z\). La seconde vaut \(2x – 2y + y – z + z = 2x – y\). Donc \(f(x, y, z) = (x – y + 3z,\ 2x – y)\). On contrôle que \(f(1, 1, 1) = (3, 1)\).
- L’image contient \((1, 2)\) et \((0, 1)\), qui ne sont pas colinéaires. Donc \(\mathrm{rg}\, f = 2\), et \(f\) est surjective. Le théorème du rang donne \(\dim \ker f = 3 – 2 = 1\). Or \(f(3, 6, 1) = (3 – 6 + 3, 6 – 6) = (0, 0)\). Donc \(\mathrm{rg}\, f = 2\) et \(\ker f = \mathrm{Vect}((3, 6, 1))\).
- On remarque que \((3, 2) = (1, 1) + (2, 1)\). Si \(g\) était linéaire, on aurait \(g(3, 2) = g(1, 1) + g(2, 1) = (1, 0) + (0, 1) = (1, 1)\). Or on impose \(g(3, 2) = (1, 2)\). Une telle application linéaire n’existe pas. En effet, les trois vecteurs imposés ne forment pas une base, donc leurs images ne sont pas libres de choix.
Corrigé de l’exercice 7 : Théorème du rang en dimension 4
- On obtient \(f(e_1) = (1, 1, 2)\), \(f(e_2) = (1, -1, 0)\), \(f(e_3) = (1, 1, 2)\) et \(f(e_4) = (1, -1, 0)\). Donc \(\mathrm{Im}\, f = \mathrm{Vect}((1, 1, 2), (1, -1, 0))\). Ces deux vecteurs ne sont pas colinéaires. Par conséquent, \(\mathrm{rg}\, f = 2\).
- Le théorème du rang donne \(\dim \ker f = 4 – 2 = 2\). Résolvons maintenant \(f(x, y, z, t) = 0\). La troisième équation donne \(z = -x\). La première devient alors \(y + t = 0\), et la deuxième \(-y – t = 0\), qui est la même. Ainsi, \(\ker f = \{(x, y, -x, -y)\}\). Une base de \(\ker f\) est \(((1, 0, -1, 0), (0, 1, 0, -1))\) : ces deux vecteurs engendrent le noyau, et ils sont libres.
- Les deux générateurs vérifient la relation \(c = a + b\). En effet, \(2 = 1 + 1\) et \(0 = 1 – 1\). Le plan d’équation \(c = a + b\) contient donc \(\mathrm{Im}\, f\), et il est de dimension \(2 = \mathrm{rg}\, f\). Donc \(\mathrm{Im}\, f\) a pour équation \(c = a + b\), et \(f\) n’est pas surjective : par exemple, \((0, 0, 1)\) n’est pas atteint.
Corrigé de l’exercice 8 : Un endomorphisme de polynômes inversible
- Si \(\deg P \leq\, n\), alors \(\deg P^{\prime} \leq\, n – 1\). Donc \(P + P^{\prime} \in \mathbb{R}_n[X]\). De plus, la dérivation est linéaire, donc \(u = \mathrm{Id} + D\) l’est aussi. Ainsi, \(u\) est un endomorphisme de \(\mathbb{R}_n[X]\).
- Soit \(P\) non nul de degré \(d\). On a \(\deg P^{\prime} < d\) (avec \(P^{\prime} = 0\) si \(d = 0\)). Donc \(P + P^{\prime}\) a le même terme dominant que \(P\), et \(\deg u(P) = d\). En particulier, \(u(P) \neq 0\). Par conséquent, \(\ker u = \{0\}\).
- L’endomorphisme \(u\) est injectif, et \(\mathbb{R}_n[X]\) est de dimension finie \(n + 1\). D’après le corollaire du théorème du rang, un endomorphisme injectif en dimension finie est bijectif. Donc \(u\) est un automorphisme de \(\mathbb{R}_n[X]\).
- Posons \(P = aX^2 + bX + c\). Alors \(P + P^{\prime} = aX^2 + (b + 2a)X + (c + b)\). L’égalité avec \(X^2\) donne \(a = 1\), puis \(b = -2\), puis \(c = 2\). On trouve \(P = X^2 – 2X + 2\). On vérifie : \(X^2 – 2X + 2 + 2X – 2 = X^2\).
- Soit \(Q \in \mathbb{R}_n[X]\). On a :
\[ u(v(Q)) = \sum_{k=0}^{n} (-1)^k Q^{(k)} + \sum_{k=0}^{n} (-1)^k Q^{(k+1)} = \sum_{k=0}^{n} (-1)^k Q^{(k)} – \sum_{k=1}^{n+1} (-1)^{k} Q^{(k)}. \]
Les termes d’indice \(1\) à \(n\) se simplifient. Il reste \(Q – (-1)^{n+1} Q^{(n+1)}\). Or \(Q^{(n+1)} = 0\) car \(\deg Q \leq\, n\). Donc \(u \circ v = \mathrm{Id}\). Comme \(u\) est bijectif, on compose à gauche par \(u^{-1}\). Il vient \(v = u^{-1}\). Pour \(n = 2\), on retrouve \(v(X^2) = X^2 – 2X + 2\).
Corrigé de l’exercice 9 : Dimension infinie : les équivalences tombent
- La dérivation est linéaire : \((\lambda P + \mu Q)^{\prime} = \lambda P^{\prime} + \mu Q^{\prime}\). De même, \(X(\lambda P + \mu Q) = \lambda XP + \mu XQ\). Ainsi, \(D\) et \(M\) sont des endomorphismes de \(\mathbb{R}[X]\).
- Soit \(Q = \sum_{k=0}^{m} b_k X^k\). Le polynôme \(P = \sum_{k=0}^{m} \frac{b_k}{k + 1} X^{k+1}\) vérifie \(P^{\prime} = Q\). Donc \(D\) est surjectif. En revanche, \(D(1) = 0\), donc \(\ker D \neq \{0\}\). L’endomorphisme \(D\) est surjectif mais pas injectif ; son noyau est l’ensemble des constantes.
- Si \(XP = 0\), alors \(P = 0\) : en effet, si \(P \neq 0\), on aurait \(\deg(XP) = \deg P + 1 \geq\, 1\). Donc \(M\) est injectif. De plus, tout polynôme \(XP\) s’annule en \(0\). Par conséquent, le polynôme constant \(1\) n’est pas dans l’image. L’endomorphisme \(M\) est injectif mais pas surjectif.
- On a \(D(M(P)) = (XP)^{\prime} = P + XP^{\prime}\) et \(M(D(P)) = XP^{\prime}\). Donc \(D \circ M – M \circ D = \mathrm{Id}_{\mathbb{R}[X]}\).
- La restriction \(D_n\) envoie \(\mathbb{R}_n[X]\) dans \(\mathbb{R}_{n-1}[X] \subset \mathbb{R}_n[X]\). Son noyau est \(\mathbb{R}_0[X]\), de dimension \(1\). Le théorème du rang donne donc \(\mathrm{rg}\, D_n = (n + 1) – 1 = n\), et \(\mathrm{Im}\, D_n = \mathbb{R}_{n-1}[X]\). Ainsi, \(D_n\) n’est ni injectif ni surjectif. C’est cohérent avec le cours : en dimension finie, un endomorphisme est injectif si et seulement s’il est surjectif. Les deux propriétés tombent donc ensemble. En dimension infinie, au contraire, \(D\) et \(M\) montrent que l’équivalence est fausse.
Corrigé de l’exercice 10 : Composée nulle et endomorphisme de carré nul
- On a \(g \circ f = 0\) si et seulement si \(g(f(x)) = 0\) pour tout \(x \in E\). Autrement dit, \(g\) s’annule sur tous les vecteurs de la forme \(f(x)\). Donc \(g \circ f = 0 \Leftrightarrow \mathrm{Im}\, f \subset \ker g\).
- Appliquons la question 1 avec \(f = g = u\). On obtient \(\mathrm{Im}\, u \subset \ker u\), donc \(\mathrm{rg}\, u \leq\, \dim \ker u\). Le théorème du rang donne \(\dim \ker u = n – \mathrm{rg}\, u\). Ainsi, \(\mathrm{rg}\, u \leq\, n – \mathrm{rg}\, u\). Finalement, \(\mathrm{rg}\, u \leq\, \frac{n}{2}\).
- On calcule \(u(u(x, y, z, t)) = u(z, t, 0, 0) = (0, 0, 0, 0)\). Donc \(u \circ u = 0\). De plus, \(\mathrm{Im}\, u = \{(z, t, 0, 0)\} = \mathrm{Vect}(e_1, e_2)\). Ainsi, \(\mathrm{rg}\, u = 2 = \frac{4}{2}\) : l’inégalité est une égalité.
- Pour \(n = 3\), l’inégalité donne \(\mathrm{rg}\, u \leq\, \frac{3}{2}\). Comme le rang est entier, \(\mathrm{rg}\, u \leq\, 1\). Il n’existe donc aucun endomorphisme de \(\mathbb{R}^3\) de rang \(2\) et de carré nul.
Corrigé de l’exercice 11 : Rang d’une composée
- Pour tout \(x \in E\), on a \(g(f(x)) \in \mathrm{Im}\, g\). Donc \(\mathrm{Im}(g \circ f) \subset \mathrm{Im}\, g\). En passant aux dimensions, on obtient \(\mathrm{rg}(g \circ f) \leq\, \mathrm{rg}\, g\).
- Notons \(\tilde{g} : \mathrm{Im}\, f \to G\) la restriction de \(g\). Elle est linéaire. Son image est \(g(\mathrm{Im}\, f) = \{g(f(x)) \mid x \in E\} = \mathrm{Im}(g \circ f)\). Le théorème du rang appliqué à \(\tilde{g}\) donne :
\[ \mathrm{rg}\, f = \dim \mathrm{Im}\, f = \dim \ker \tilde{g} + \mathrm{rg}(g \circ f). \]
Par conséquent, \(\mathrm{rg}(g \circ f) \leq\, \mathrm{rg}\, f\).
- Si \(g\) est injective, alors \(\ker \tilde{g} \subset \ker g = \{0\}\). La formule précédente donne \(\mathrm{rg}(g \circ f) = \mathrm{rg}\, f\). Si \(f\) est surjective, alors \(\mathrm{Im}\, f = F\) et \(\tilde{g} = g\). Donc \(\mathrm{Im}(g \circ f) = \mathrm{Im}\, g\). On obtient \(\mathrm{rg}(g \circ f) = \mathrm{rg}\, f\) dans le premier cas et \(\mathrm{rg}(g \circ f) = \mathrm{rg}\, g\) dans le second.
- On a \(\mathrm{rg}\, a \leq\, \dim \mathbb{R}^2 = 2\). D’après la question 2, \(\mathrm{rg}(b \circ a) \leq\, 2 < 3\). Donc \(b \circ a\) n’est pas surjectif. Ainsi, \(b \circ a\) n’est jamais un automorphisme de \(\mathbb{R}^3\).
Corrigé de l’exercice 12 : Reconnaître un projecteur du plan
- L’application \(p\) est linéaire. On calcule ensuite \(p(p(x, y)) = p(2x – 2y, x – y)\). La première coordonnée vaut \(2(2x – 2y) – 2(x – y) = 2x – 2y\). La seconde vaut \((2x – 2y) – (x – y) = x – y\). Donc \(p \circ p = p\), et \(p\) est un projecteur.
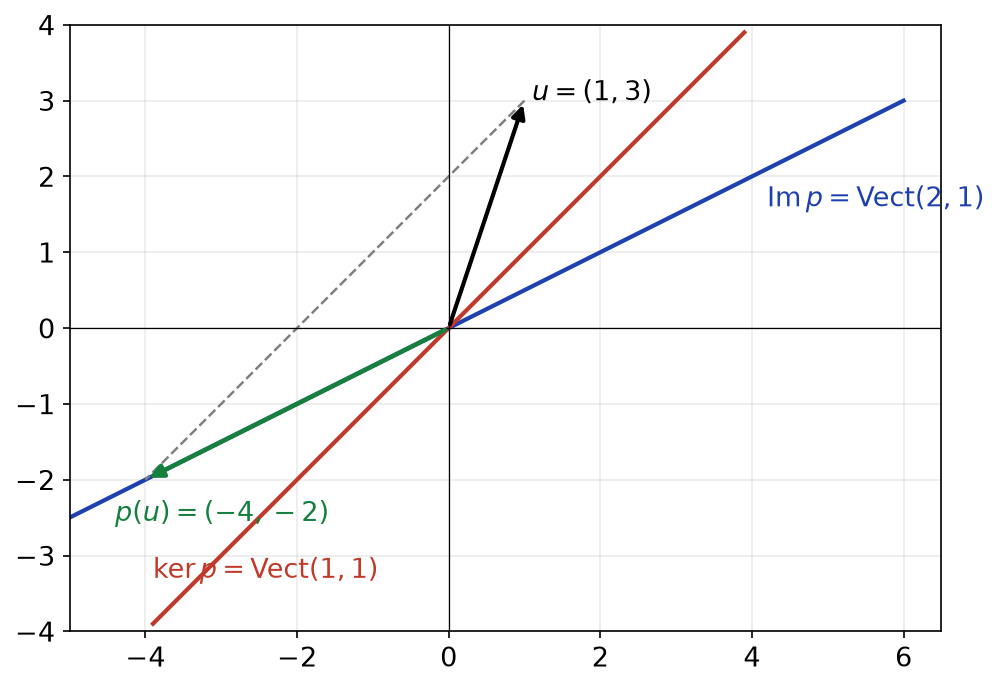
- On a \(p(x, y) = 0\) si et seulement si \(x = y\). Donc \(\ker p = \mathrm{Vect}((1, 1))\). Par ailleurs, \(p(x, y) = (x – y)(2, 1)\), donc \(\mathrm{Im}\, p = \mathrm{Vect}((2, 1))\). Ainsi, \(p\) est la projection sur la droite \(\mathrm{Vect}((2, 1))\) parallèlement à la droite \(\mathrm{Vect}((1, 1))\).
- On trouve \(p(1, 3) = (2 – 6, 1 – 3) = (-4, -2)\). Ensuite, \((1, 3) – (-4, -2) = (5, 5)\), qui appartient bien à \(\ker p\). Donc \((1, 3) = (-4, -2) + (5, 5)\), avec \((-4, -2) \in \mathrm{Im}\, p\) et \((5, 5) \in \ker p\). La figure ci-dessous montre cette décomposition : on descend de \(u\) vers l’image en suivant la direction du noyau.
- La symétrie associée est \(s = 2p – \mathrm{Id}\). Donc \(s(x, y) = (4x – 4y – x, 2x – 2y – y) = (3x – 4y, 2x – 3y)\). Vérifions : la première coordonnée de \(s(s(x, y))\) vaut \(3(3x – 4y) – 4(2x – 3y) = x\). La seconde vaut \(2(3x – 4y) – 3(2x – 3y) = y\). Donc \(s(x, y) = (3x – 4y, 2x – 3y)\) et \(s \circ s = \mathrm{Id}\).
Corrigé de l’exercice 13 : Une symétrie de l’espace
- Les coordonnées de \(s\) sont linéaires, donc \(s\) est linéaire. Ensuite, les deux dernières coordonnées de \(s(s(x, y, z))\) valent \(y\) et \(z\). La première vaut \(-(-x – 2y – 2z) – 2y – 2z = x\). Donc \(s \circ s = \mathrm{Id}\).
- D’une part, \(s(x, y, z) = (x, y, z)\) équivaut à \(-x – 2y – 2z = x\), soit \(x + y + z = 0\). D’autre part, \(s(x, y, z) = -(x, y, z)\) équivaut à \(-x – 2y – 2z = -x\), \(y = -y\) et \(z = -z\). Cela revient à \(y = z = 0\). Ainsi, \(\ker(s – \mathrm{Id}) = P\) et \(\ker(s + \mathrm{Id}) = D\).
- D’après le cours, une application linéaire vérifiant \(s \circ s = \mathrm{Id}\) est la symétrie par rapport à \(\ker(s – \mathrm{Id})\) parallèlement à \(\ker(s + \mathrm{Id})\). Donc \(s\) est la symétrie par rapport au plan \(P\) parallèlement à la droite \(D\).
- Le projecteur associé est \(p = \frac{1}{2}(s + \mathrm{Id})\). On obtient \(p(x, y, z) = \big(\frac{-2y – 2z}{2}, y, z\big)\). Donc \(p(x, y, z) = (-y – z, y, z)\).
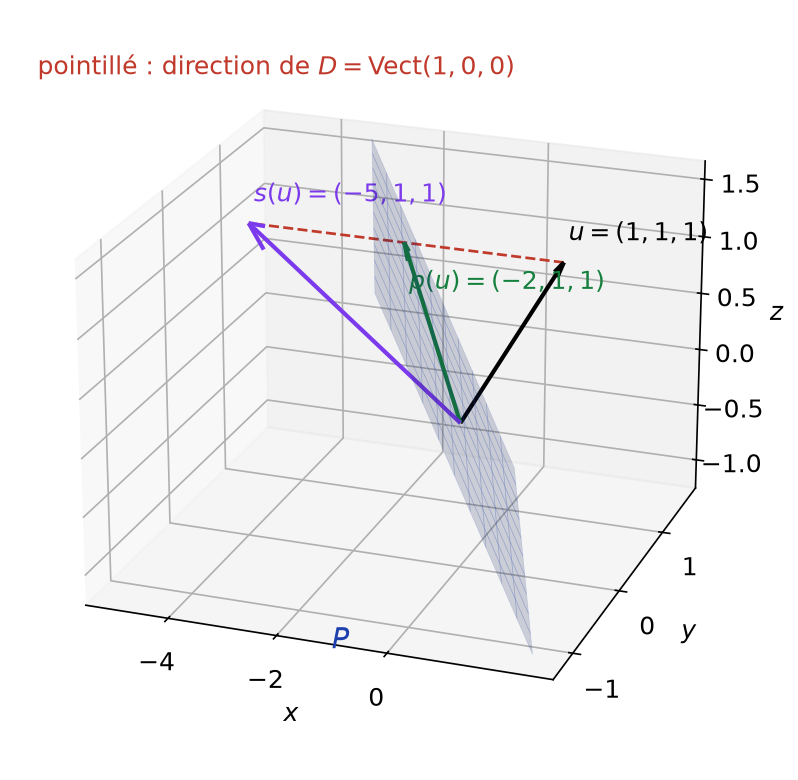
- On calcule \(p(1, 1, 1) = (-2, 1, 1)\) et \(s(1, 1, 1) = (-1 – 2 – 2, 1, 1)\). Ainsi, \(p(1, 1, 1) = (-2, 1, 1)\) et \(s(1, 1, 1) = (-5, 1, 1)\). On contrôle que \((1, 1, 1) = (-2, 1, 1) + (3, 0, 0)\), avec \((-2, 1, 1) \in P\) et \((3, 0, 0) \in D\). Comme le montre la figure ci-dessous, \(s(1, 1, 1)\) s’obtient en retranchant \((3, 0, 0)\) à \(p(1, 1, 1)\).
Corrigé de l’exercice 14 : Transposition et matrices symétriques
- La transposition est linéaire : \((\lambda M + \mu N)^{\mathrm{T}} = \lambda M^{\mathrm{T}} + \mu N^{\mathrm{T}}\). Donc \(T\) est une somme d’applications linéaires. Ainsi, \(T\) est un endomorphisme de \(\mathcal{M}_2(\mathbb{R})\).
- On a \(T(M) = 0\) si et seulement si \(M^{\mathrm{T}} = -M\), c’est-à-dire \(M \in \mathcal{A}_2\). Une matrice antisymétrique d’ordre 2 a une diagonale nulle et s’écrit \(\begin{pmatrix} 0 b \\ -b 0 \end{pmatrix}\). Donc \(\ker T = \mathcal{A}_2 = \mathrm{Vect}\begin{pmatrix} 0 1 \\ -1 0 \end{pmatrix}\), de dimension \(1\).
- Pour toute \(M\), on a \(T(M)^{\mathrm{T}} = M^{\mathrm{T}} + M = T(M)\). Donc \(\mathrm{Im}\, T \subset \mathcal{S}_2\). Le théorème du rang donne \(\mathrm{rg}\, T = 4 – 1 = 3\). Or \(\mathcal{S}_2\) admet pour base \((E_{11}, E_{22}, E_{12} + E_{21})\), donc \(\dim \mathcal{S}_2 = 3\). Par inclusion et égalité des dimensions, \(\mathrm{Im}\, T = \mathcal{S}_2\).
- On calcule \(p(p(M)) = \frac{1}{4}\big(M + M^{\mathrm{T}} + (M + M^{\mathrm{T}})^{\mathrm{T}}\big) = \frac{1}{4} \cdot 2(M + M^{\mathrm{T}}) = p(M)\). Donc \(p\) est un projecteur. Son image et son noyau sont ceux de \(T\). Ainsi, \(p\) est la projection sur \(\mathcal{S}_2\) parallèlement à \(\mathcal{A}_2\).
- La partie symétrique est \(S = p(M) = \frac{1}{2}\begin{pmatrix} 2 6 \\ 6 6 \end{pmatrix}\). La partie antisymétrique est \(A = M – S\).
\[ S = \begin{pmatrix} 1 3 \\ 3 3 \end{pmatrix}, \quad A = \begin{pmatrix} 0 -1 \\ 1 0 \end{pmatrix}. \]
On a bien \(M = S + A\), avec \(S\) symétrique et \(A\) antisymétrique.
Corrigé de l’exercice 15 : Hyperplans en dimension 4 et polynômes
- L’application \(\varphi : (x, y, z, t) \mapsto x + 2y – z + t\) est une forme linéaire non nulle, puisque \(\varphi(e_1) = 1\). Donc \(H = \ker \varphi\) est un hyperplan, de dimension \(3\). Ensuite, un vecteur de \(H\) vérifie \(z = x + 2y + t\). Il s’écrit donc \(x(1, 0, 1, 0) + y(0, 1, 2, 0) + t(0, 0, 1, 1)\). Cette famille engendre \(H\) ; elle comporte trois vecteurs et \(\dim H = 3\). Donc \(((1, 0, 1, 0), (0, 1, 2, 0), (0, 0, 1, 1))\) est une base de \(H\).
- On a \(\varphi(1, 0, 0, 0) = 1 \neq 0\), donc \((1, 0, 0, 0) \notin H\). D’après le cours, toute droite engendrée par un vecteur hors de l’hyperplan en est un supplémentaire. Ainsi, \(\mathbb{R}^4 = H \oplus D\).
- L’évaluation en \(1\) est linéaire. De plus, \(\varphi(1) = 1\), donc \(\varphi \neq 0\). Par conséquent, \(K = \ker \varphi\) est un hyperplan de \(\mathbb{R}_n[X]\), de dimension \(n\).
- Chaque \((X – 1) X^k\) s’annule en \(1\), donc appartient à \(K\). Ces polynômes sont de degrés \(1, 2, \ldots, n\), deux à deux distincts. Une famille de polynômes non nuls de degrés distincts est libre. On a donc \(n\) vecteurs libres dans \(K\), qui est de dimension \(n\). La famille est une base de \(K\). Enfin, le polynôme \(1\) n’est pas dans \(K\), car \(\varphi(1) = 1\). Donc \(\mathbb{R}_n[X] = K \oplus \mathbb{R}_0[X]\).
- Notons \(\psi(P) = P(0) P(1)\). On a \(\psi(1) = 1\) mais \(\psi(2) = 4 \neq 2 \psi(1)\). L’application \(\psi\) n’est pas une forme linéaire.
Corrigé de l’exercice 16 : Formes linéaires et intersection d’hyperplans
- Posons \(H = \ker \varphi\). C’est un hyperplan, car \(\varphi \neq 0\). Choisissons \(a \notin H\) ; alors \(\varphi(a) \neq 0\) et \(E = H \oplus \mathrm{Vect}(a)\). Posons \(\lambda = \frac{\psi(a)}{\varphi(a)}\). La forme \(\psi – \lambda \varphi\) est nulle sur \(H\), car \(H \subset \ker \psi\). Elle est aussi nulle en \(a\), par choix de \(\lambda\). Une application linéaire nulle sur deux sous-espaces supplémentaires est nulle. Donc \(\psi = \lambda \varphi\).
- Notons \(\varphi(x, y, z) = x – y + 2z\). Le plan donné est \(\ker \varphi\). Une forme \(\psi\) s’annule sur ce plan si et seulement si \(\ker \varphi \subset \ker \psi\). D’après la question 1, c’est équivalent à \(\psi = \lambda \varphi\). La réciproque est immédiate. Les formes cherchées sont les \((x, y, z) \mapsto \lambda(x – y + 2z)\), avec \(\lambda \in \mathbb{R}\).
- L’application \(\Phi : E \to \mathbb{K}^2\) est linéaire, et \(\ker \Phi = H_1 \cap H_2\). Montrons que \(\mathrm{rg}\, \Phi = 2\). D’abord, \(\mathrm{Im}\, \Phi \neq \{0\}\), car \(\varphi \neq 0\). Supposons par l’absurde \(\mathrm{rg}\, \Phi = 1\). Alors \(\mathrm{Im}\, \Phi = \mathrm{Vect}((\alpha, \beta))\) avec \((\alpha, \beta) \neq (0, 0)\). Pour tout \(x\), le vecteur \((\varphi(x), \psi(x))\) est colinéaire à \((\alpha, \beta)\), donc \(\beta \varphi(x) – \alpha \psi(x) = 0\).
Si \(\alpha = 0\), alors \(\beta \neq 0\) et \(\varphi = 0\) : c’est absurde. Donc \(\alpha \neq 0\) et \(\psi = \frac{\beta}{\alpha} \varphi\). Comme \(\psi \neq 0\), on a \(\beta \neq 0\), et donc \(\ker \psi = \ker \varphi\). Cela contredit \(H_1 \neq H_2\). Par conséquent, \(\mathrm{rg}\, \Phi = 2\). Le théorème du rang donne \(\dim(H_1 \cap H_2) = n – 2\).
- Les formes \(x + y + z + t\) et \(x – y + z – t\) ne sont pas proportionnelles, donc les hyperplans sont distincts. En additionnant puis en soustrayant les deux équations, on obtient \(x + z = 0\) et \(y + t = 0\). Une base de l’intersection est \(((1, 0, -1, 0), (0, 1, 0, -1))\), et l’on retrouve bien la dimension \(4 – 2 = 2\).
Corrigé de l’exercice 17 : Suites des noyaux et des images itérés
- Soit \(x \in N_k\). Alors \(f^{k+1}(x) = f(f^k(x)) = f(0) = 0\), donc \(x \in N_{k+1}\). Ensuite, soit \(y = f^{k+1}(x) \in I_{k+1}\). On écrit \(y = f^k(f(x))\), donc \(y \in I_k\). Ainsi, \(N_k \subset N_{k+1}\) et \(I_{k+1} \subset I_k\).
- Notons \(d_k = \dim N_k\). Cette suite est croissante et à valeurs dans \(\{0, \ldots, n\}\). Supposons que \(d_{k+1} \geq\, d_k + 1\) pour tout \(k \in \{0, \ldots, n\}\). Alors \(d_{n+1} \geq\, d_0 + n + 1 = n + 1\), ce qui est absurde. Il existe donc \(k \leq\, n\) avec \(d_k = d_{k+1}\). Avec l’inclusion \(N_k \subset N_{k+1}\), on obtient \(N_k = N_{k+1}\).
- Supposons \(N_k = N_{k+1}\). Soit \(x \in N_{k+2}\). Alors \(f^{k+1}(f(x)) = 0\), donc \(f(x) \in N_{k+1} = N_k\). Ainsi, \(f^k(f(x)) = 0\), c’est-à-dire \(x \in N_{k+1}\). Donc \(N_{k+2} \subset N_{k+1}\), et l’autre inclusion est connue. Par récurrence, \(N_j = N_k\) pour tout \(j \geq\, k\).
- Le théorème du rang donne \(\dim I_j = n – \dim N_j\). Pour \(j \geq\, k\), on a donc \(\dim I_{j+1} = \dim I_j\). Or \(I_{j+1} \subset I_j\). Par conséquent, \(I_j = I_k\) pour tout \(j \geq\, k\).
- On a \(f(x, y, z) = (y, z, 0)\), puis \(f^2(x, y, z) = f(y, z, 0) = (z, 0, 0)\), et \(f^3 = 0\). Donc \(N_1 = \{y = z = 0\} = \mathrm{Vect}(e_1)\). Ensuite, \(N_2 = \{z = 0\} = \mathrm{Vect}(e_1, e_2)\) et \(N_3 = \mathbb{R}^3\). Les rangs de \(f\), \(f^2\) et \(f^3\) valent respectivement \(2\), \(1\) et \(0\) ; ici la stabilisation a lieu au rang \(k = 3 = n\).
Corrigé de l’exercice 18 : Noyau et image supplémentaires
- Le sens direct est la définition d’une somme directe. Réciproquement, supposons \(\ker f \cap \mathrm{Im}\, f = \{0\}\), et notons \(n = \dim E\). La formule de Grassmann et le théorème du rang donnent :
\[ \dim(\ker f + \mathrm{Im}\, f) = \dim \ker f + \mathrm{rg}\, f – 0 = n. \]
Donc \(\ker f + \mathrm{Im}\, f = E\), et la somme est directe. Ainsi, \(E = \ker f \oplus \mathrm{Im}\, f\) équivaut à \(\ker f \cap \mathrm{Im}\, f = \{0\}\).
- Supposons \(\ker f = \ker f^2\). Soit \(y \in \ker f \cap \mathrm{Im}\, f\), avec \(y = f(x)\). Alors \(f^2(x) = f(y) = 0\), donc \(x \in \ker f^2 = \ker f\). Ainsi, \(y = f(x) = 0\). Réciproquement, supposons \(\ker f \cap \mathrm{Im}\, f = \{0\}\). On a toujours \(\ker f \subset \ker f^2\). Soit alors \(x \in \ker f^2\). Le vecteur \(f(x)\) est dans \(\mathrm{Im}\, f\) et dans \(\ker f\), donc il est nul. Ainsi, \(\ker f \cap \mathrm{Im}\, f = \{0\} \Leftrightarrow \ker f = \ker f^2\).
- On a toujours \(\ker f \subset \ker f^2\) et \(\mathrm{Im}\, f^2 \subset \mathrm{Im}\, f\). Par le théorème du rang, \(\dim \mathrm{Im}\, f = n – \dim \ker f\) et \(\dim \mathrm{Im}\, f^2 = n – \dim \ker f^2\). Les deux images sont égales si et seulement si leurs dimensions le sont, donc si et seulement si les deux noyaux ont même dimension. Grâce aux inclusions, \(\ker f = \ker f^2 \Leftrightarrow \mathrm{Im}\, f = \mathrm{Im}\, f^2\).
- Pour un projecteur \(p\), on a \(p^2 = p\), donc \(\ker p^2 = \ker p\) et \(\mathrm{Im}\, p^2 = \mathrm{Im}\, p\). Le cours donne aussi \(E = \ker p \oplus \mathrm{Im}\, p\). En revanche, pour \(g(x, y) = (y, 0)\), on a \(\ker g = \mathrm{Vect}(e_1) = \mathrm{Im}\, g\). De plus, \(g^2 = 0\), donc \(\ker g^2 = \mathbb{R}^2 \neq \ker g\). Les trois propriétés sont vraies pour un projecteur et toutes fausses pour \(g\).
Corrigé de l’exercice 19 : Somme de deux projecteurs
- On développe : \((p + q)^2 = p^2 + p \circ q + q \circ p + q^2\). Avec \(p^2 = p\), \(q^2 = q\) et les hypothèses, il reste \(p + q\). Donc \(p + q\) est un projecteur.
- Le même développement donne \(p + q + p \circ q + q \circ p = p + q\), donc \(p \circ q + q \circ p = 0\). Composons à gauche par \(p\) : \(p \circ q + p \circ q \circ p = 0\). Composons ensuite à droite par \(p\) : \(p \circ q \circ p + q \circ p = 0\). Par différence, \(p \circ q = q \circ p\). En reportant, on obtient \(2\, p \circ q = 0\). Comme \(2 \neq 0\) dans \(\mathbb{K}\), on conclut que \(p \circ q = q \circ p = 0\).
- D’abord, \(\mathrm{Im}(p + q) \subset \mathrm{Im}\, p + \mathrm{Im}\, q\). Ensuite, soit \(y \in \mathrm{Im}\, p\). Alors \(p(y) = y\) et \(q(y) = q(p(y)) = 0\). Donc \((p + q)(y) = y\), et \(y \in \mathrm{Im}(p + q)\). Il en va de même pour \(\mathrm{Im}\, q\). La somme est directe : si \(y \in \mathrm{Im}\, p \cap \mathrm{Im}\, q\), alors \(y = p(y) = p(q(y)) = 0\).
Pour le noyau, l’inclusion \(\ker p \cap \ker q \subset \ker(p + q)\) est claire. Réciproquement, si \(p(x) + q(x) = 0\), on applique \(p\). Il vient \(p(x) + p(q(x)) = p(x) = 0\), puis \(q(x) = 0\). Ainsi, \(\mathrm{Im}(p + q) = \mathrm{Im}\, p \oplus \mathrm{Im}\, q\) et \(\ker(p + q) = \ker p \cap \ker q\).
- On a \(p \circ q(x, y, z) = p(0, y, 0) = 0\) et \(q \circ p(x, y, z) = q(x, 0, 0) = 0\). Donc \(p + q : (x, y, z) \mapsto (x, y, 0)\) est un projecteur. Son image est \(\mathrm{Vect}(e_1) \oplus \mathrm{Vect}(e_2)\). Son noyau est \(\mathrm{Vect}(e_2, e_3) \cap \mathrm{Vect}(e_1, e_3) = \mathrm{Vect}(e_3)\). C’est la projection sur le plan \(z = 0\) parallèlement à l’axe \(\mathrm{Vect}(e_3)\).
Corrigé de l’exercice 20 : Problème : endomorphismes de rang 1
- Pour tout \(x\), on a \(f(x) \in \mathrm{Vect}(a)\). Il existe donc un scalaire \(\varphi(x)\) tel que \(f(x) = \varphi(x) a\). Ce scalaire est unique, car \(a \neq 0\). Montrons la linéarité. D’une part, \(f(x + \lambda y) = \varphi(x + \lambda y) a\). D’autre part, \(f(x) + \lambda f(y) = (\varphi(x) + \lambda \varphi(y)) a\). Comme \(a \neq 0\), on identifie les coefficients. Enfin, \(\varphi \neq 0\), sinon \(f\) serait nulle, de rang \(0\). Donc \(\varphi\) est une forme linéaire non nulle, unique.
- On a \(f(x) = 0\) si et seulement si \(\varphi(x) a = 0\), soit \(\varphi(x) = 0\). Donc \(\ker f = \ker \varphi\), qui est un hyperplan puisque \(\varphi \neq 0\). On retrouve \(\dim \ker f = n – 1\), en accord avec le théorème du rang.
- Par linéarité, \(f(f(x)) = f(\varphi(x) a) = \varphi(x) f(a) = \varphi(x) \varphi(a) a\). Donc \(f \circ f = \varphi(a) f\).
- Si \(\varphi(a) = 1\), alors \(f^2 = f\), donc \(f\) est un projecteur. Réciproquement, si \(f^2 = f\), alors \((\varphi(a) – 1) f = 0\), et \(f \neq 0\) impose \(\varphi(a) = 1\). De même, \(f^2 = 0\) équivaut à \(\varphi(a) f = 0\), soit \(\varphi(a) = 0\). Or cela signifie \(a \in \ker \varphi = \ker f\). Ainsi, \(f\) est un projecteur si et seulement si \(\varphi(a) = 1\), et \(f^2 = 0\) si et seulement si \(a \in \ker f\).
- Notons \(c = \varphi(a)\). Si \(c = -1\), alors \((\mathrm{Id} + f)(a) = a + c\, a = 0\) avec \(a \neq 0\). Donc \(\mathrm{Id} + f\) n’est pas injectif. Si \(c \neq -1\), on calcule, grâce à \(f^2 = c f\) :
\[ (\mathrm{Id} + f) \circ \Big(\mathrm{Id} – \frac{f}{1 + c}\Big) = \mathrm{Id} + f – \frac{f + c f}{1 + c} = \mathrm{Id}. \]
En dimension finie, un endomorphisme qui admet un inverse à droite est bijectif. Donc \(\mathrm{Id} + f\) est un automorphisme si et seulement si \(\varphi(a) \neq -1\), d’inverse \(\mathrm{Id} – \frac{1}{1 + \varphi(a)} f\).
- Ici, \(a = (1, 2, -1)\) et \(\varphi(x, y, z) = x + y + z\). On trouve \(\varphi(a) = 1 + 2 – 1 = 2\), donc \(f \circ f = 2f\). En particulier, \(\frac{1}{2} f\) est un projecteur. Comme \(2 \neq -1\), l’endomorphisme \(\mathrm{Id} + f\) est inversible, d’inverse \(\mathrm{Id} – \frac{1}{3} f\). Notons \(S = x + y + z\). On obtient :
\[ (\mathrm{Id} + f)^{-1}(x, y, z) = \Big(\frac{2x – y – z}{3},\ \frac{-2x + y – 2z}{3},\ \frac{x + y + 4z}{3}\Big). \]
Par exemple, \((\mathrm{Id} + f)(1, 0, 0) = (2, 2, -1)\), et la formule renvoie bien \((1, 0, 0)\).
Point de méthode : un endomorphisme de rang 1 s’écrit toujours \(x \mapsto \varphi(x) a\) ; la relation \(f^2 = \varphi(a) f\) règle ensuite toutes les questions.
Corrigé de l’exercice 21 : Problème : interpolation de Lagrange
- Chaque évaluation \(P \mapsto P(a_i)\) est linéaire. Donc \(u(\lambda P + \mu Q) = \lambda u(P) + \mu u(Q)\), coordonnée par coordonnée. L’application \(u\) est linéaire.
- Soit \(P \in \ker u\). Alors \(P\) s’annule en \(a_0, \ldots, a_n\), soit \(n + 1\) points distincts. Or un polynôme non nul de degré au plus \(n\) a au plus \(n\) racines. Donc \(P = 0\), et \(u\) est injective.
- On a \(\dim \mathbb{R}_n[X] = n + 1 = \dim \mathbb{R}^{n+1}\). Une application linéaire injective entre espaces de même dimension finie est bijective. Donc \(u\) est un isomorphisme. Autrement dit, pour tous réels \(b_0, \ldots, b_n\), il existe un unique \(P \in \mathbb{R}_n[X]\) tel que \(P(a_i) = b_i\) pour tout \(i\).
- Pour \(k \neq i\), le facteur \(X – a_k\) figure dans \(L_i\), donc \(L_i(a_k) = 0\). De plus, chaque facteur vaut \(1\) en \(a_i\), donc \(L_i(a_i) = 1\). Enfin, \(\deg L_i = n\). Ainsi, \(u(L_i) = \varepsilon_i\), le \(i\)-ième vecteur de la base canonique de \(\mathbb{R}^{n+1}\). L’isomorphisme \(u^{-1}\) envoie une base sur une base. Donc \((L_0, \ldots, L_n)\) est une base de \(\mathbb{R}_n[X]\).
- Les polynômes de Lagrange associés à \(0, 1, 2\) sont :
\[ L_0 = \frac{(X – 1)(X – 2)}{2}, \quad L_1 = -X(X – 2), \quad L_2 = \frac{X(X – 1)}{2}. \]
Par linéarité de \(u^{-1}\), on a \(P = L_0 + 3 L_1 + 7 L_2\). On développe :
\[ P = \frac{X^2 – 3X + 2 – 6X^2 + 12X + 7X^2 – 7X}{2} = \frac{2X^2 + 2X + 2}{2}. \]
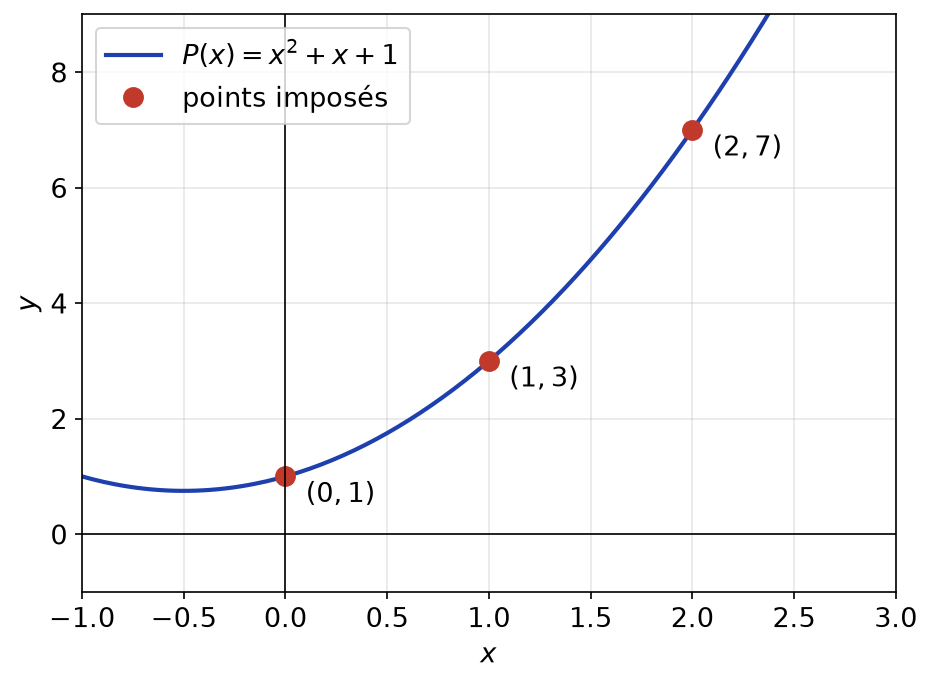
On obtient \(P = X^2 + X + 1\). On vérifie que \(P(0) = 1\), \(P(1) = 3\) et \(P(2) = 7\). La figure ci-dessous montre la parabole obtenue, qui passe exactement par les trois points.
Point de méthode : pour prouver qu’une application linéaire entre espaces de même dimension finie est un isomorphisme, il suffit d’étudier son noyau.
Revenir aux énoncés des exercices
Pour aller plus loin en L1
- Le cours : applications linéaires, cours de maths en L1
- Les énoncés : exercices de maths en L1 sur applications linéaires
- À maîtriser avant : Familles libres, bases et dimension
- Chapitre précédent : Familles libres, bases et dimension
- Chapitre suivant : Matrice d'une application linéaire et changement de base
- Le même thème en maths sup : applications linéaires, exercices de maths sup
- Tester vos connaissances : QCM de maths en L1 par chapitre
- Le sommaire : tous les chapitres de maths de L1 et la licence de maths de L1 à L3