Ce chapitre établit les théorèmes limites qui fondent la statistique. Vous y comparez d’abord quatre modes de convergence des variables aléatoires : presque sûre, en probabilité, dans L^p et en loi. Ensuite, le lemme de Borel-Cantelli fournit l’outil central pour prouver une convergence presque sûre.
Le cours de lois des grands nombres L3 démontre la loi faible dans le cas L^2, puis la loi forte sous un moment d’ordre 4. Il présente enfin le théorème de Lévy sur les fonctions caractéristiques et en déduit le théorème central limite. Chaque résultat est énoncé avec ses hypothèses exactes, et des contre-exemples montrent qu’aucune n’est superflue.
Ce chapitre clôt le semestre 6 et s’appuie sur la théorie de la mesure et sur les fonctions caractéristiques. Il prépare directement les cours de statistique inférentielle, de martingales et de processus stochastiques du master.
Pour vous entraîner ensuite, travaillez les exercices de maths en L3 sur loi des grands nombres et TCL.
I. Les quatre modes de convergence des variables aléatoires
Dans tout le chapitre, \((\Omega, \mathcal{A}, P)\) est un espace probabilisé. Les variables aléatoires sont réelles, sauf mention contraire. Une suite \((X_n)\) de variables aléatoires est une suite de fonctions mesurables sur \(\Omega\). Il existe donc plusieurs façons de dire qu’elle « tend » vers une variable \(X\). Vous connaissez déjà les convergences simple et en norme pour les fonctions. En probabilités, on en retient quatre, de la plus exigeante à la plus faible.
1. Convergence presque sûre
On dit que \((X_n)\) converge presque sûrement vers \(X\) si l’événement \(\{\omega \in \Omega : X_n(\omega) \to X(\omega)\}\) est de probabilité 1. On note \(X_n \xrightarrow{\text{p.s.}} X\).
Cet ensemble est bien un événement. En effet, il s’écrit avec des opérations dénombrables :
\[\{X_n \to X\} = \bigcap_{k \geq\, 1} \bigcup_{N \geq\, 1} \bigcap_{n \geq\, N} \{ |X_n – X| \leq\, \tfrac{1}{k} \}.\]
Autrement dit, c’est la convergence simple de la théorie de la mesure, hors d’un ensemble négligeable. Par conséquent, le théorème de convergence dominée s’applique directement aux suites qui convergent presque sûrement.
2. Convergence en probabilité
On dit que \((X_n)\) converge en probabilité vers \(X\) si, pour tout \(\varepsilon > 0\), \(P(|X_n – X| > \varepsilon) \to 0\) quand \(n \to \infty\). On note \(X_n \xrightarrow{P} X\).
Cette fois, on ne suit pas chaque \(\omega\). On mesure seulement la taille de l’ensemble où l’écart reste grand. Ainsi, la limite est unique à égalité presque sûre près.
3. Convergence dans L^p
Soit \(p \geq\, 1\). On suppose \(X_n\) et \(X\) dans \(L^p\). On dit que \((X_n)\) converge dans \(L^p\) vers \(X\) si \(E(|X_n – X|^p) \to 0\). Pour \(p = 2\), on parle de convergence en moyenne quadratique.
C’est la convergence pour la norme \(\|Y\|_p = E(|Y|^p)^{1/p}\). De plus, sur un espace de probabilité, l’inégalité de Hölder donne \(\|Y\|_p \leq\, \|Y\|_q\) si \(p \leq\, q\). Donc la convergence dans \(L^q\) entraîne celle dans \(L^p\) pour \(p \leq\, q\).
4. Convergence en loi
On dit que \((X_n)\) converge en loi vers \(X\) si, pour toute fonction \(f : \mathbb{R} \to \mathbb{R}\) continue et bornée, \(E(f(X_n)) \to E(f(X))\). On note \(X_n \xrightarrow{\mathcal{L}} X\).
Cette notion ne porte que sur les lois \(P_{X_n}\) et \(P_X\). En particulier, les variables \(X_n\) peuvent vivre sur des espaces différents. On dit aussi que la suite des lois converge étroitement.
Notons \(F_n\) et \(F\) les fonctions de répartition de \(X_n\) et \(X\). Alors \(X_n \xrightarrow{\mathcal{L}} X\) si et seulement si \(F_n(x) \to F(x)\) en tout point \(x\) où \(F\) est continue.
La restriction aux points de continuité est indispensable. Par exemple, prenons \(X_n\) uniforme sur \([-1/n, 1/n]\). Alors \(X_n\) converge en loi vers la constante 0, comme le montre la figure ci-dessous. Pourtant \(F_n(0) = 1/2\) pour tout \(n\), alors que \(F(0) = 1\). Le point 0 est justement le seul point de discontinuité de \(F\).

Soit \(X_n\) de loi géométrique de paramètre \(\lambda / n\), avec \(\lambda > 0\). Pour \(x \geq\, 0\), on a \(P(X_n / n > x) = (1 – \lambda/n)^{\lfloor nx \rfloor}\). Or \(\lfloor nx \rfloor \ln(1 – \lambda/n) \to -\lambda x\). Ainsi \(X_n / n\) converge en loi vers la loi exponentielle de paramètre \(\lambda\).
II. Le lemme de Borel-Cantelli
La convergence presque sûre fait intervenir la limite supérieure d’une suite d’événements. Le lemme de Borel-Cantelli est l’outil principal pour la contrôler.
Pour une suite d’événements \((A_n)\), on pose \(\limsup A_n = \bigcap_{N \geq\, 1} \bigcup_{n \geq\, N} A_n\). C’est l’ensemble des \(\omega\) qui appartiennent à une infinité de \(A_n\).
Lemme de Borel-Cantelli.
- Si \(\sum P(A_n) < \infty\), alors \(P(\limsup A_n) = 0\).
- Si les \(A_n\) sont indépendants et si \(\sum P(A_n) = \infty\), alors \(P(\limsup A_n) = 1\).
1. Pour tout \(N\), \(\limsup A_n \subset \bigcup_{n \geq\, N} A_n\). Donc \(P(\limsup A_n) \leq\, \sum_{n \geq\, N} P(A_n)\). Ce reste de série convergente tend vers 0.
2. Le complémentaire de \(\limsup A_n\) est \(\bigcup_N \bigcap_{n \geq\, N} A_n^c\). Il suffit donc de voir que chaque \(\bigcap_{n \geq\, N} A_n^c\) est négligeable. Par indépendance, puis grâce à \(1 – u \leq\, e^{-u}\), on obtient pour \(M \geq\, N\) :
\[P\Big(\bigcap_{n = N}^{M} A_n^c\Big) = \prod_{n = N}^{M} \big(1 – P(A_n)\big) \leq\, \exp\Big(-\sum_{n = N}^{M} P(A_n)\Big).\]
Le membre de droite tend vers 0 quand \(M \to \infty\). Enfin, la continuité décroissante de \(P\) conclut.
La seconde partie est fausse sans indépendance. Par exemple, avec \(A_n = [0, 1/n]\) dans \([0,1]\) muni de la mesure de Lebesgue, la série \(\sum 1/n\) diverge, mais \(\limsup A_n = \{0\}\) est négligeable.
Pour montrer que \(X_n \to X\) presque sûrement, il suffit d’établir que, pour tout \(\varepsilon > 0\), \(\sum_n P(|X_n – X| > \varepsilon) < \infty\). En effet, Borel-Cantelli donne alors \(|X_n – X| \leq\, \varepsilon\) à partir d’un certain rang, presque sûrement. On prend ensuite \(\varepsilon = 1/k\) et on intersecte ces événements sur \(k \in \mathbb{N}^*\), ce qui reste de probabilité 1.
Soit \((X_n)\) une suite de variables indépendantes de Bernoulli de paramètre \(p_n\). Alors \(X_n \to 0\) presque sûrement si et seulement si \(X_n = 1\) pour un nombre fini d’indices. D’après les deux parties du lemme, cela a lieu si et seulement si \(\sum p_n < \infty\). Ainsi, avec \(p_n = 1/n\), la suite ne converge pas presque sûrement, alors que \(P(X_n \neq 0) = 1/n \to 0\).
III. Liens entre les modes de convergence
Les quatre modes sont hiérarchisés. La figure ci-dessous résume les implications. Les flèches pleines sont toujours vraies. En revanche, les flèches en pointillé demandent une hypothèse supplémentaire.
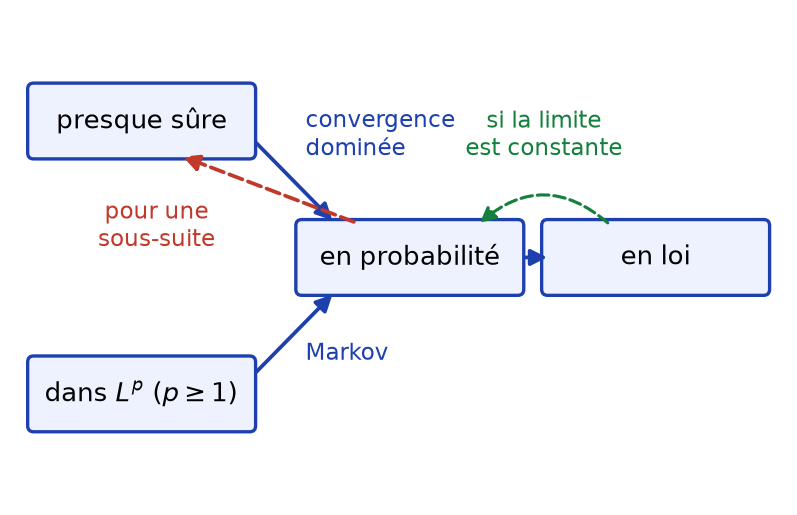
- La convergence presque sûre entraîne la convergence en probabilité.
- La convergence dans \(L^p\) entraîne la convergence en probabilité.
- La convergence en probabilité entraîne la convergence en loi.
- Si \(X_n \xrightarrow{\mathcal{L}} c\), où \(c\) est une constante, alors \(X_n \xrightarrow{P} c\).
- Si \(X_n \xrightarrow{P} X\), il existe une sous-suite \((X_{n_k})\) qui converge presque sûrement vers \(X\).
1. Fixons \(\varepsilon > 0\). La variable \(\mathbf{1}_{\{|X_n – X| > \varepsilon\}}\) tend presque sûrement vers 0 et elle est dominée par 1. Par convergence dominée, son espérance \(P(|X_n – X| > \varepsilon)\) tend vers 0.
2. D’après l’inégalité de Markov, \(P(|X_n – X| > \varepsilon) \leq\, E(|X_n – X|^p) / \varepsilon^p\), qui tend vers 0.
3. Soit \(f\) continue bornée. Montrons que \(E(f(X_n)) \to E(f(X))\). D’abord, soit \(\eta > 0\). Il existe \(A > 0\) tel que \(P(|X| > A) \leq\, \eta\). Ensuite, \(f\) est uniformément continue sur \([-A-1, A+1]\) : il existe \(\delta \in \, ]0, 1]\) tel que \(|f(x) – f(y)| \leq\, \eta\) dès que \(|x| \leq\, A\) et \(|x – y| \leq\, \delta\). En découpant selon les événements \(\{|X| > A\}\) et \(\{|X_n – X| > \delta\}\), on obtient
\[|E(f(X_n)) – E(f(X))| \leq\, \eta + 2\|f\|_\infty \big( \eta + P(|X_n – X| > \delta) \big).\]
Ainsi la limite supérieure est au plus \(\eta(1 + 2\|f\|_\infty)\), pour tout \(\eta > 0\).
4. La fonction de répartition de \(c\) est continue sauf en \(c\). Donc \(F_n(c + \varepsilon) \to 1\) et \(F_n(c – \varepsilon) \to 0\). Par conséquent, \(P(|X_n – c| > \varepsilon) \leq\, 1 – F_n(c + \varepsilon) + F_n(c – \varepsilon) \to 0\).
5. On choisit \(n_1 < n_2 < \cdots\) tels que \(P(|X_{n_k} – X| > 2^{-k}) \leq\, 2^{-k}\). La série converge, donc Borel-Cantelli donne \(|X_{n_k} – X| \leq\, 2^{-k}\) à partir d’un certain rang, presque sûrement.
1. Les réciproques sont fausses
Les contre-exemples classiques se construisent sur \(\Omega = [0,1]\) muni de la mesure de Lebesgue. Ils sont à connaître, car les sujets d’examen les demandent souvent.
Presque sûre sans \(L^1\). Posons \(X_n = n \mathbf{1}_{[0, 1/n]}\). Pour \(\omega > 0\), \(X_n(\omega) = 0\) dès que \(n > 1/\omega\). Donc \(X_n \to 0\) presque sûrement. Cependant \(E(X_n) = 1\) pour tout \(n\) : il n’y a pas convergence dans \(L^1\).
Bosse glissante : \(L^p\) sans presque sûre. Écrivons \(n = 2^k + j\) avec \(0 \leq\, j < 2^k\), et posons \(X_n = \mathbf{1}_{[j 2^{-k}, (j+1) 2^{-k}]}\). Alors \(E(X_n^p) = 2^{-k} \to 0\). Pourtant, chaque \(\omega\) est couvert une fois à chaque génération \(k\). Ainsi la suite \((X_n(\omega))\) prend une infinité de fois la valeur 1, et elle ne converge en aucun point.
La figure ci-dessous montre les huit premières bosses et le point \(\omega = 0{,}3\). On y voit la bosse repasser sur ce point à chaque génération.

En loi sans en probabilité. Soit \(X\) de loi \(\mathcal{N}(0,1)\) et \(X_n = -X\) pour tout \(n\). La loi normale centrée est symétrique, donc \(X_n\) a la même loi que \(X\) : la convergence en loi est triviale. En revanche, \(P(|X_n – X| > 1) = P(|X| > 1/2)\) ne tend pas vers 0.
La convergence presque sûre et la convergence dans \(L^p\) ne sont pas comparables en général. Cependant, si \(X_n \to X\) presque sûrement et si \(|X_n| \leq\, Y\) avec \(Y \in L^p\), la convergence dominée donne la convergence dans \(L^p\).
IV. Fonctions caractéristiques et théorème de Lévy
Pour prouver une convergence en loi, tester toutes les fonctions continues bornées est lourd. On préfère une famille particulière : les fonctions \(x \mapsto e^{itx}\).
La fonction caractéristique de \(X\) est \(\varphi_X(t) = E(e^{itX})\) pour \(t \in \mathbb{R}\). Elle est continue, bornée par 1, et elle caractérise la loi de \(X\).
Rappelons trois formules utiles. D’abord, si \(X \sim \mathcal{N}(m, \sigma^2)\), alors \(\varphi_X(t) = e^{imt – \sigma^2 t^2/2}\). Ensuite, si \(X \sim \mathcal{P}(\lambda)\), alors \(\varphi_X(t) = \exp(\lambda(e^{it} – 1))\). Enfin, si \(X\) et \(Y\) sont indépendantes, \(\varphi_{X+Y} = \varphi_X \varphi_Y\).
Théorème de continuité de Lévy.
- Si \(X_n \xrightarrow{\mathcal{L}} X\), alors \(\varphi_{X_n}(t) \to \varphi_X(t)\) pour tout \(t \in \mathbb{R}\).
- Réciproquement, si \(\varphi_{X_n}\) converge simplement vers une fonction \(\varphi\) continue en 0, alors \(\varphi\) est la fonction caractéristique d’une variable \(X\), et \(X_n \xrightarrow{\mathcal{L}} X\).
Le sens direct est immédiat : on applique la définition aux fonctions continues bornées \(\cos(tx)\) et \(\sin(tx)\). Le sens réciproque est plus profond. Il repose sur la tension de la suite des lois, que la continuité en 0 garantit. La preuve complète dépasse ce cours, mais son usage doit être parfaitement maîtrisé.
La continuité en 0 de la limite n’est pas décorative. Si \(X_n \sim \mathcal{N}(0, n)\), alors \(\varphi_{X_n}(t) = e^{-nt^2/2}\) tend vers \(\mathbf{1}_{\{t = 0\}}\). Cette limite est discontinue en 0 et, de fait, la masse de \(X_n\) « part à l’infini » : il n’y a pas de convergence en loi.
Pour prouver que \(X_n \xrightarrow{\mathcal{L}} X\) par les fonctions caractéristiques :
- calculer \(\varphi_{X_n}(t)\), souvent en utilisant l’indépendance pour passer d’une somme à un produit ;
- faire un développement limité en \(t / \sqrt{n}\) ou en \(1/n\), en contrôlant le reste à \(t\) fixé ;
- reconnaître la limite comme la fonction caractéristique d’une loi connue, puis appliquer le théorème de Lévy.
Soit \(X_n \sim \mathcal{B}(n, \lambda/n)\). Alors \(\varphi_{X_n}(t) = (1 + \frac{\lambda(e^{it} – 1)}{n})^n\). Pour \(z \in \mathbb{C}\) fixé, \((1 + z/n)^n \to e^z\). Donc \(\varphi_{X_n}(t) \to \exp(\lambda(e^{it} – 1))\). Par le théorème de Lévy, \(X_n\) converge en loi vers la loi de Poisson \(\mathcal{P}(\lambda)\).
V. Lois des grands nombres
Soit \((X_n)\) une suite de variables aléatoires. On note \(S_n = X_1 + \cdots + X_n\) et \(\overline{X}_n = S_n / n\) la moyenne empirique. Les lois des grands nombres affirment que \(\overline{X}_n\) tend vers l’espérance commune. Elles justifient l’interprétation d’une probabilité comme fréquence limite.
1. Loi faible dans le cas L^2
Loi faible des grands nombres. Soit \((X_n)\) une suite de variables de carré intégrable, deux à deux non corrélées, de même espérance \(m\) et de variances bornées par \(C\). Alors \(\overline{X}_n \to m\) dans \(L^2\), donc en probabilité. Plus précisément :
\[P(|\overline{X}_n – m| \geq\, \varepsilon) \leq\, \frac{C}{n \varepsilon^2}.\]
Les covariances sont nulles, donc la variance d’une somme est la somme des variances. Ainsi \(\operatorname{Var}(S_n) \leq\, nC\). Comme \(E(\overline{X}_n) = m\), on a \(E((\overline{X}_n – m)^2) = \operatorname{Var}(S_n)/n^2 \leq\, C/n\). Ceci tend vers 0. Enfin, l’inégalité de Bienaymé-Tchebychev donne la majoration annoncée.
L’hypothèse est faible : ni l’indépendance ni l’identité des lois ne sont requises. De plus, on obtient une vitesse explicite, précieuse pour dimensionner un échantillon.
2. Loi forte
Loi forte des grands nombres. Soit \((X_n)\) une suite de variables indépendantes et de même loi, intégrables, d’espérance \(m\). Alors \(\overline{X}_n \to m\) presque sûrement et dans \(L^1\).
La preuve générale, sous la seule hypothèse \(E|X_1| < \infty\), utilise une troncature délicate. En revanche, sous l’hypothèse d’un moment d’ordre 4, la preuve tient en quelques lignes et illustre la méthode de Borel-Cantelli.
On suppose \(E(X_1^4) < \infty\) et, quitte à centrer, \(m = 0\). En développant \(S_n^4\), les termes contenant un \(X_i\) à la puissance 1 sont d’espérance nulle par indépendance. Il reste les termes \(X_i^4\) et \(X_i^2 X_j^2\) avec \(i \neq j\) :
\[E(S_n^4) = n E(X_1^4) + 3n(n-1) E(X_1^2)^2 \leq\, 3n^2 E(X_1^4).\]
La dernière inégalité vient de \(E(X_1^2)^2 \leq\, E(X_1^4)\). Par l’inégalité de Markov, \(P(|\overline{X}_n| > \varepsilon) \leq\, E(S_n^4)/(n^4 \varepsilon^4) \leq\, 3E(X_1^4)/(n^2 \varepsilon^4)\). C’est le terme général d’une série convergente. Par conséquent, la méthode de Borel-Cantelli donne \(\overline{X}_n \to 0\) presque sûrement.
La figure ci-dessous montre cinq suites de moyennes de lancers d’un dé équilibré. Chaque trajectoire se stabilise autour de \(3{,}5\), comme l’annonce la loi forte. Les courbes pointillées donnent l’ordre de grandeur des fluctuations, que le théorème central limite précisera.
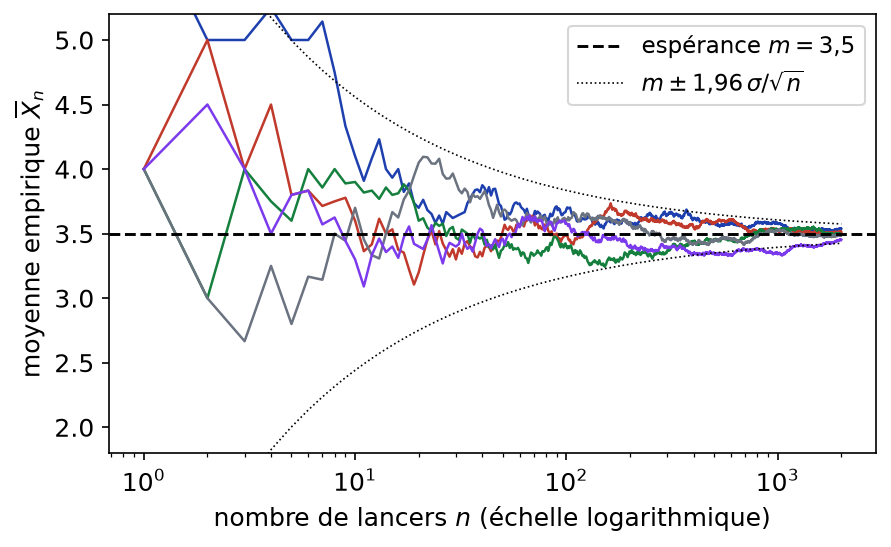
L’intégrabilité est indispensable. Si les \(X_n\) sont indépendantes de loi de Cauchy, de densité \(\frac{1}{\pi(1 + x^2)}\), alors \(\overline{X}_n\) suit encore la loi de Cauchy pour tout \(n\). Autrement dit, la moyenne ne se stabilise jamais.
Méthode de Monte-Carlo. Soit \(f\) intégrable sur \([0,1]\) et \((U_n)\) indépendantes de loi uniforme sur \([0,1]\). Les \(f(U_n)\) sont indépendantes, de même loi, intégrables et d’espérance \(\int_0^1 f\). Par la loi forte, \(\frac{1}{n} \sum_{k=1}^{n} f(U_k) \to \int_0^1 f(x)\, dx\) presque sûrement.
VI. Le théorème central limite
La loi des grands nombres dit que \(\overline{X}_n – m\) tend vers 0. Le théorème central limite précise à quelle vitesse et avec quelle loi. Les fluctuations sont d’ordre \(1/\sqrt{n}\), et leur loi est gaussienne quelle que soit la loi de départ.
Théorème central limite. Soit \((X_n)\) une suite de variables indépendantes, de même loi, de carré intégrable, d’espérance \(m\) et de variance \(\sigma^2 > 0\). Alors
\[\frac{S_n – nm}{\sigma \sqrt{n}} = \sqrt{n}\, \frac{\overline{X}_n – m}{\sigma} \xrightarrow{\mathcal{L}} \mathcal{N}(0, 1).\]
En particulier, pour tous \(a < b\), \(P(a \leq\, \frac{S_n – nm}{\sigma \sqrt{n}} \leq\, b) \to \int_a^b \frac{e^{-x^2/2}}{\sqrt{2\pi}}\, dx\).
Posons \(Y_k = (X_k – m)/\sigma\) : elles sont indépendantes, de même loi, centrées et réduites. Notons \(\varphi\) leur fonction caractéristique. Comme \(Y_1\) admet un moment d’ordre 2, \(\varphi\) est de classe \(C^2\), avec \(\varphi(0) = 1\), \(\varphi^{\prime}(0) = 0\) et \(\varphi^{\prime\prime}(0) = -1\). Par la formule de Taylor-Young :
\[\varphi(u) = 1 – \frac{u^2}{2} + u^2 \varepsilon(u), \quad \varepsilon(u) \to 0.\]
Par indépendance, la fonction caractéristique de \(Z_n = (Y_1 + \cdots + Y_n)/\sqrt{n}\) vaut \(\varphi(t/\sqrt{n})^n\). Or \(\varphi(t/\sqrt{n}) = 1 + z_n / n\) avec \(z_n = -t^2/2 + t^2 \varepsilon(t/\sqrt{n}) \to -t^2/2\). Pour des complexes \(|a|, |b| \leq\, 1\), on a \(|a^n – b^n| \leq\, n|a – b|\). Avec \(b = e^{z_n/n}\), on en déduit que \(\varphi(t/\sqrt{n})^n – e^{z_n}\) tend vers 0. Donc \(\varphi_{Z_n}(t) \to e^{-t^2/2}\). Cette limite est continue et c’est la fonction caractéristique de \(\mathcal{N}(0,1)\). Finalement, le théorème de Lévy conclut. La limite porte sur la fonction de répartition en tout point, car celle de \(\mathcal{N}(0,1)\) est continue.
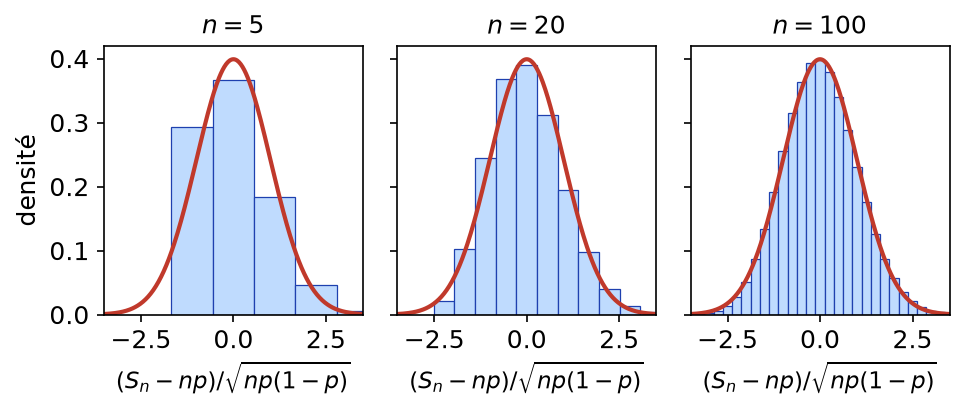
La figure ci-dessous illustre le théorème pour des lois binomiales \(\mathcal{B}(n, 0{,}2)\). Les histogrammes renormalisés épousent la courbe en cloche quand \(n\) grandit. Pourtant, la loi de départ est une loi de Bernoulli très dissymétrique.
Approximation normale. Pour \(n\) grand, on remplace la loi de \(S_n\) par \(\mathcal{N}(nm, n\sigma^2)\) :
- on centre et on réduit : \(P(S_n \leq\, s) = P(\frac{S_n – nm}{\sigma\sqrt{n}} \leq\, \frac{s – nm}{\sigma\sqrt{n}})\) ;
- on lit la valeur dans la table de \(\Phi\), la fonction de répartition de \(\mathcal{N}(0,1)\) ;
- on retient les quantiles \(\Phi(1{,}96) \approx 0{,}975\) et \(\Phi(2) \approx 0{,}977\).
Intervalle de confiance. On observe \(n\) tirages de Bernoulli de paramètre inconnu \(p\), de fréquence \(F_n\). Le théorème central limite donne \(P(|F_n – p| \leq\, 1{,}96 \sqrt{p(1-p)/n}) \to 0{,}95\). De plus, \(p(1-p) \leq\, 1/4\). Ainsi l’intervalle \([F_n – \frac{0{,}98}{\sqrt{n}}, F_n + \frac{0{,}98}{\sqrt{n}}]\) contient \(p\) avec une probabilité asymptotiquement au moins égale à \(0{,}95\).
Le théorème central limite est une convergence en loi, et rien de plus. En effet, la suite \(\sqrt{n}(\overline{X}_n – m)\) ne converge pas en probabilité. De plus, il ne donne aucune borne d’erreur à \(n\) fixé. L’inégalité de Berry-Esseen, hors programme, majore l’écart des fonctions de répartition par \(C\, E|X_1 – m|^3 / (\sigma^3 \sqrt{n})\).
VII. Ce qu’il faut retenir
- Quatre modes de convergence : presque sûre, en probabilité, dans \(L^p\) et en loi.
- Presque sûre et \(L^p\) entraînent en probabilité, qui entraîne en loi. La convergence en loi vers une constante équivaut à la convergence en probabilité.
- De toute suite qui converge en probabilité, on extrait une sous-suite qui converge presque sûrement.
- Contre-exemples à connaître : \(n \mathbf{1}_{[0,1/n]}\), la bosse glissante, et \(X_n = -X\) avec \(X\) symétrique.
- Borel-Cantelli : \(\sum P(A_n) < \infty\) implique \(P(\limsup A_n) = 0\) ; la réciproque demande l’indépendance.
- Critère : si \(\sum P(|X_n – X| > \varepsilon) < \infty\) pour tout \(\varepsilon\), alors \(X_n \to X\) presque sûrement.
- Loi faible \(L^2\) : \(P(|\overline{X}_n – m| \geq\, \varepsilon) \leq\, C/(n\varepsilon^2)\) pour des variables non corrélées de variances bornées.
- Loi forte : des variables indépendantes, de même loi et intégrables ont une moyenne qui converge presque sûrement vers \(m\).
- Théorème de Lévy : la convergence simple des fonctions caractéristiques vers une limite continue en 0 équivaut à la convergence en loi.
- Théorème central limite : \(\sqrt{n}(\overline{X}_n – m)/\sigma\) converge en loi vers \(\mathcal{N}(0,1)\) dès que \(\sigma^2\) est finie et non nulle.
Questions fréquentes sur loi des grands nombres et TCL
Quelle différence entre loi faible et loi forte des grands nombres ?
La loi faible affirme que la moyenne empirique converge en probabilité vers l’espérance, tandis que la loi forte affirme une convergence presque sûre, plus exigeante. La loi faible se prouve en quelques lignes par Bienaymé-Tchebychev dès que les variances sont bornées. La loi forte demande l’indépendance et l’identité des lois, avec une preuve plus délicate.
Quand peut-on appliquer le second lemme de Borel-Cantelli ?
Il faut que les événements soient indépendants et que la série des probabilités diverge. On conclut alors qu’une infinité d’entre eux se réalisent presque sûrement. Sans indépendance, le résultat est faux : les intervalles [0, 1/n] en fournissent un contre-exemple.
Le théorème central limite donne-t-il une convergence en probabilité ?
Non, c’est uniquement une convergence en loi. La suite \(\sqrt{n}(\overline{X}_n – m)\) ne converge pas en probabilité, car ses termes deviennent presque indépendants à grande distance. On l’utilise pour approcher des probabilités, pas pour suivre une trajectoire.
Pourquoi la loi de Cauchy échappe-t-elle à la loi des grands nombres ?
Une variable de Cauchy n’est pas intégrable, donc l’hypothèse de la loi forte n’est pas satisfaite. Sa fonction caractéristique vaut \(e^{-|t|}\), et la moyenne de n variables indépendantes suit encore la loi de Cauchy. La moyenne empirique ne se stabilise donc jamais.
Pour aller plus loin en L3
- Les énoncés : exercices de maths en L3 sur loi des grands nombres et TCL
- À maîtriser avant : Espaces probabilisés, variables aléatoires et espérance
- Chapitre précédent : Espaces probabilisés, variables aléatoires et espérance
- Tester vos connaissances : QCM de maths en L3 par chapitre
- Le sommaire : tous les chapitres de maths de L3 et la licence de maths de L1 à L3