Ce cours de réduction Jordan L3 achève la théorie de la réduction commencée en L2. La diagonalisation laisse de côté de nombreux endomorphismes ; ici, on les classe tous à similitude près. D’abord, le lemme des noyaux découpe l’espace en sous-espaces caractéristiques. Ensuite, la décomposition de Dunford sépare une partie diagonalisable et une partie nilpotente qui commutent.
Le cœur du chapitre est l’étude des endomorphismes nilpotents : noyaux itérés, tableaux de Young et chaînes de vecteurs. On en déduit la réduite de Jordan, puis un critère effectif pour décider si deux matrices sont semblables. Les invariants de similitude prolongent cette classification à tout corps.
Enfin, deux applications complètent le chapitre. L’exponentielle de matrice se calcule par Dunford et résout les systèmes différentiels linéaires. La dualité, avec base duale, orthogonal et transposée, montre qu’une matrice est toujours semblable à sa transposée. Ces outils servent ensuite en équations différentielles, en analyse matricielle et en théorie des représentations.
Pour vous entraîner ensuite, travaillez les exercices de maths en L3 sur réduction de Jordan.
I. Rappels : polynôme minimal et lemme des noyaux
Dans tout le chapitre, \(E\) est un espace vectoriel de dimension finie \(n \geq\, 1\) sur un corps \(\mathbb{K}\) égal à \(\mathbb{R}\) ou \(\mathbb{C}\), et \(u\) est un endomorphisme de \(E\). Le but est ambitieux : classer tous les endomorphismes à similitude près. La diagonalisation ne suffit pas, car beaucoup d’endomorphismes ne sont pas diagonalisables. Nous allons donc chercher une forme réduite qui existe toujours dès que le polynôme caractéristique est scindé.
L’ensemble des polynômes \(P \in \mathbb{K}[X]\) tels que \(P(u) = 0\) est un idéal non nul de \(\mathbb{K}[X]\). Son unique générateur unitaire s’appelle le polynôme minimal de \(u\), noté \(\pi_u\). Ainsi, \(P(u) = 0\) si et seulement si \(\pi_u\) divise \(P\).
Rappelons ensuite deux faits essentiels. D’abord, le théorème de Cayley-Hamilton affirme que \(\chi_u(u) = 0\), donc \(\pi_u\) divise \(\chi_u\). De plus, \(\pi_u\) et \(\chi_u\) ont exactement les mêmes racines, à savoir les valeurs propres de \(u\).
Lemme des noyaux. Soient \(P_1, \ldots, P_r\) des polynômes deux à deux premiers entre eux et \(P = P_1 \cdots P_r\). Alors \[\ker P(u) = \ker P_1(u) \oplus \cdots \oplus \ker P_r(u).\] De plus, les projecteurs associés à cette somme directe sont des polynômes en \(u\).
Traitons le cas \(r = 2\) ; le cas général s’en déduit par récurrence. Par le théorème de Bézout, il existe \(U, V\) tels que \(UP_1 + VP_2 = 1\). Posons \(p_1 = (VP_2)(u)\) et \(p_2 = (UP_1)(u)\), de sorte que \(p_1 + p_2 = \mathrm{id}_E\). Soit \(x \in \ker P(u)\). Alors \(P_1(u)(p_1(x)) = (VP)(u)(x) = 0\), donc \(p_1(x) \in \ker P_1(u)\). De même, \(p_2(x) \in \ker P_2(u)\). Ainsi \(x = p_1(x) + p_2(x)\) est dans la somme. Enfin, si \(x \in \ker P_1(u) \cap \ker P_2(u)\), alors \(x = V(u)P_2(u)(x) + U(u)P_1(u)(x) = 0\). La somme est donc directe.
Si \(\pi_u = (X – 1)^2(X – 2)\), on a \(1 = (X – 1)^2 – X(X – 2)\). Par conséquent, \(E = \ker (u – \mathrm{id})^2 \oplus \ker (u – 2\,\mathrm{id})\), et le projecteur sur le second facteur parallèlement au premier est \((u – \mathrm{id})^2\).
II. Sous-espaces caractéristiques et décomposition de Dunford
1. Sous-espaces caractéristiques
On suppose désormais que \(\chi_u\) est scindé : \(\chi_u = \prod_{i=1}^{r} (X – \lambda_i)^{m_i}\), avec des \(\lambda_i\) distincts. C’est toujours le cas lorsque \(\mathbb{K} = \mathbb{C}\).
Le sous-espace caractéristique de \(u\) associé à \(\lambda_i\) est \(F_{\lambda_i} = \ker (u – \lambda_i\,\mathrm{id}_E)^{m_i}\). Il contient le sous-espace propre \(E_{\lambda_i} = \ker(u – \lambda_i\,\mathrm{id}_E)\).
On a \(E = F_{\lambda_1} \oplus \cdots \oplus F_{\lambda_r}\). Chaque \(F_{\lambda_i}\) est stable par \(u\), de dimension \(m_i\). En outre, la restriction de \(u – \lambda_i\,\mathrm{id}\) à \(F_{\lambda_i}\) est nilpotente. Si \(\pi_u = \prod (X – \lambda_i)^{k_i}\), alors on a aussi \(F_{\lambda_i} = \ker(u – \lambda_i\,\mathrm{id})^{k_i}\).
Les polynômes \((X – \lambda_i)^{m_i}\) sont premiers entre eux deux à deux. Le lemme des noyaux appliqué à \(\chi_u\), avec Cayley-Hamilton, donne la somme directe. La stabilité vient de ce que \(u\) commute avec tout polynôme en \(u\). Notons \(u_i\) la restriction de \(u\) à \(F_{\lambda_i}\) et \(d_i = \dim F_{\lambda_i}\). Comme \((u_i – \lambda_i)^{m_i} = 0\), la seule valeur propre de \(u_i\) est \(\lambda_i\), donc \(\chi_{u_i} = (X – \lambda_i)^{d_i}\). Or \(\chi_u = \prod \chi_{u_i}\) ; par unicité de la factorisation, \(d_i = m_i\). Le même argument avec \(\pi_u\) donne la dernière égalité.
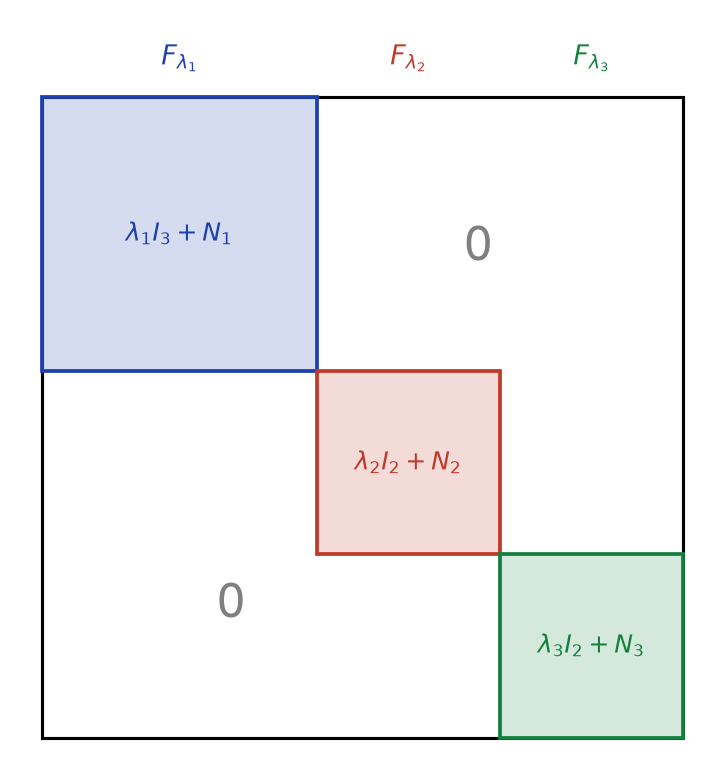
Ainsi, dans une base adaptée à cette décomposition, la matrice de \(u\) est diagonale par blocs, chaque bloc étant de la forme \(\lambda_i I_{m_i} + N_i\) avec \(N_i\) nilpotente. La figure ci-dessous représente cette structure pour trois valeurs propres.
2. Décomposition de Dunford
Décomposition de Dunford. Si \(\chi_u\) est scindé, il existe un unique couple \((d, n)\) d’endomorphismes de \(E\) tel que : \(u = d + n\), \(d\) est diagonalisable, \(n\) est nilpotent et \(d \circ n = n \circ d\). De plus, \(d\) et \(n\) sont des polynômes en \(u\).
Existence. Notons \(p_i\) les projecteurs associés à \(E = \bigoplus F_{\lambda_i}\) ; ce sont des polynômes en \(u\) d’après le lemme des noyaux. Posons \(d = \sum \lambda_i p_i\) et \(n = u – d\). Alors \(d\) est diagonalisable, car il vaut \(\lambda_i\,\mathrm{id}\) sur chaque \(F_{\lambda_i}\). Ensuite, \(n\) agit sur \(F_{\lambda_i}\) comme \(u – \lambda_i\,\mathrm{id}\), qui y est nilpotent : \(n\) est donc nilpotent. Enfin, \(d\) et \(n\) sont des polynômes en \(u\), donc ils commutent.
Unicité. Soit \((d^{\prime}, n^{\prime})\) un autre couple. Comme \(d^{\prime}\) commute avec \(n^{\prime}\), il commute avec \(u\), donc avec \(d\) et \(n\), qui sont des polynômes en \(u\). Alors \(d – d^{\prime} = n^{\prime} – n\). D’une part, \(d\) et \(d^{\prime}\) sont diagonalisables et commutent : ils sont codiagonalisables, donc \(d – d^{\prime}\) est diagonalisable. D’autre part, \(n^{\prime} – n\) est nilpotent, par la formule du binôme. Un endomorphisme diagonalisable et nilpotent est nul. Donc \(d = d^{\prime}\) et \(n = n^{\prime}\).
Pour calculer la décomposition de Dunford d’une matrice \(A\) : factoriser \(\chi_A\) ; écrire une relation de Bézout entre les facteurs \((X – \lambda_i)^{m_i}\) (ou \((X – \lambda_i)^{k_i}\) si l’on connaît \(\pi_A\)) ; en déduire les projecteurs \(P_i\) ; poser \(D = \sum \lambda_i P_i\) puis \(N = A – D\). Vérifiez toujours à la fin que \(DN = ND\) et que \(N\) est nilpotente.
Écrire une matrice triangulaire comme « diagonale plus strictement triangulaire » ne donne pas, en général, sa décomposition de Dunford. Par exemple, \(\begin{pmatrix} 1 1 \\ 0 2 \end{pmatrix} = \begin{pmatrix} 1 0 \\ 0 2 \end{pmatrix} + \begin{pmatrix} 0 1 \\ 0 0 \end{pmatrix}\), mais ces deux matrices ne commutent pas. En réalité, cette matrice est diagonalisable : sa décomposition de Dunford est \(D = A\) et \(N = 0\).
Pour \(A = \begin{pmatrix} 3 1 \\ -1 1 \end{pmatrix}\), on trouve \(\chi_A = (X – 2)^2\). Le seul sous-espace caractéristique est \(\mathbb{K}^2\), donc \(D = 2I_2\) et \(N = A – 2I_2 = \begin{pmatrix} 1 1 \\ -1 -1 \end{pmatrix}\), avec \(N^2 = 0\). Par la formule du binôme, \(A^k = 2^k I_2 + k\,2^{k-1} N\) pour tout \(k \in \mathbb{N}\).
III. Endomorphismes nilpotents et tableaux de Young
La décomposition en sous-espaces caractéristiques ramène l’étude de \(u\) à celle des nilpotents \(u_i – \lambda_i\,\mathrm{id}\). Il reste donc à classer les endomorphismes nilpotents.
1. Indice de nilpotence
Un endomorphisme \(v\) est nilpotent s’il existe \(k \geq\, 1\) tel que \(v^k = 0\). Le plus petit tel entier est l’indice de nilpotence de \(v\). Autrement dit, si \(p\) est l’indice, alors \(\pi_v = X^p\).
Si \(v\) est nilpotent d’indice \(p\), alors \(p \leq\, n\) et \(\chi_v = X^n\). Réciproquement, sur \(\mathbb{C}\), un endomorphisme dont la seule valeur propre est \(0\) est nilpotent. Par ailleurs, la suite des noyaux itérés \(\ker v^k\) est strictement croissante pour \(0 \leq\, k \leq\, p\), puis constante égale à \(E\).
Le polynôme minimal \(X^p\) divise \(\chi_v\), qui est de degré \(n\), donc \(p \leq\, n\). Ensuite, \(X^n\) est annulateur, donc toute valeur propre est nulle. Sur \(\mathbb{C}\), \(\chi_v\) est scindé et a pour seule racine \(0\), d’où \(\chi_v = X^n\). Pour les noyaux, supposons \(\ker v^k = \ker v^{k+1}\). Si \(v^{k+2}(x) = 0\), alors \(v(x) \in \ker v^{k+1} = \ker v^k\), donc \(x \in \ker v^{k+1}\). Ainsi la suite stationne dès qu’elle stagne une fois, ce qui ne peut arriver avant le rang \(p\).
2. Blocs de Jordan nilpotents
Pour \(k \geq\, 1\), on note \(J_k(0)\) la matrice de taille \(k\) dont les coefficients valent \(1\) juste au-dessus de la diagonale et \(0\) ailleurs. On pose \(J_k(\lambda) = \lambda I_k + J_k(0)\). Par exemple, \[J_3(\lambda) = \begin{pmatrix} \lambda 1 0 \\ 0 \lambda 1 \\ 0 0 \lambda \end{pmatrix}.\]
Si \((e_1, \ldots, e_k)\) est la base où \(v\) a pour matrice \(J_k(0)\), alors \(v(e_1) = 0\) et \(v(e_j) = e_{j-1}\) pour \(j \geq\, 2\). Autrement dit, la base est une chaîne : \(e_k \mapsto e_{k-1} \mapsto \cdots \mapsto e_1 \mapsto 0\). Le bloc \(J_k(0)\) est d’indice \(k\) et de rang \(k – 1\).
Si \(v\) est nilpotent, il existe une base de \(E\) dans laquelle la matrice de \(v\) est diagonale par blocs \(\mathrm{diag}(J_{k_1}(0), \ldots, J_{k_s}(0))\), avec \(k_1 \geq\, k_2 \geq\, \cdots \geq\, k_s \geq\, 1\) et \(k_1 + \cdots + k_s = n\). La suite \((k_1, \ldots, k_s)\), qui est une partition de \(n\), est uniquement déterminée par \(v\).
Unicité. Le noyau de \(J_k(0)^j\) est de dimension \(\min(j, k)\). Par conséquent, \(\dim \ker v^j – \dim \ker v^{j-1}\) est égal au nombre de blocs de taille au moins \(j\). Ces nombres ne dépendent que de \(v\), donc la partition non plus.
Existence. On raisonne par récurrence sur l’indice \(p\). On choisit un supplémentaire \(S_p\) de \(\ker v^{p-1}\) dans \(\ker v^p = E\). L’application \(v\) envoie injectivement \(S_p\) dans \(\ker v^{p-1}\), et \(v(S_p)\) est en somme directe avec \(\ker v^{p-2}\). On complète alors \(v(S_p)\) en un supplémentaire \(S_{p-1}\) de \(\ker v^{p-2}\) dans \(\ker v^{p-1}\), et ainsi de suite jusqu’à \(\ker v\). En partant d’une base de chaque complément ajouté et en appliquant \(v\) successivement, on obtient des chaînes dont la réunion est une base de \(E\).
3. Noyaux itérés et tableaux de Young
Posons \(d_j = \dim \ker v^j – \dim \ker v^{j-1}\). La démonstration précédente montre que \(d_j\) compte les blocs de taille au moins \(j\). Ainsi la suite \((d_j)\) est décroissante, et la connaissance des dimensions des noyaux itérés suffit à retrouver les blocs. Prenons par exemple \(n = 8\), avec \(\dim \ker v = 4\), \(\dim \ker v^2 = 7\) et \(\dim \ker v^3 = 8\). La figure suivante représente ces dimensions.
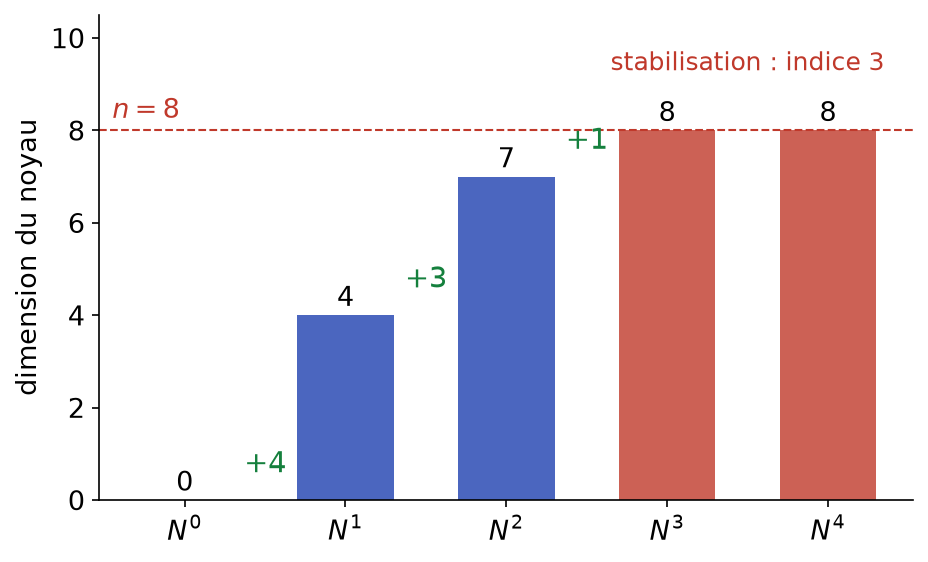
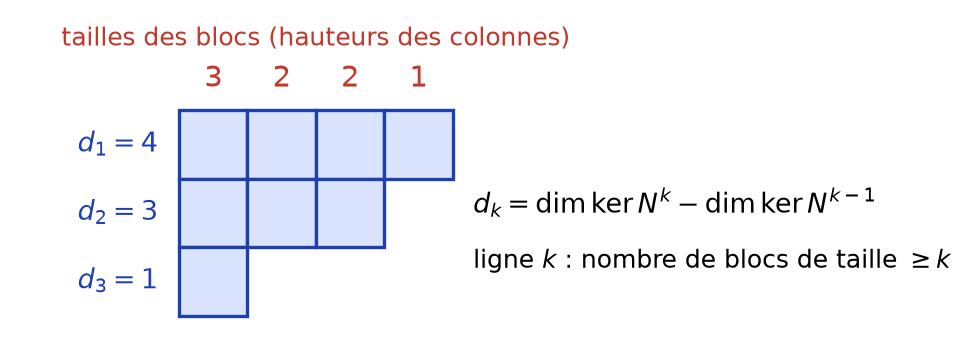
On lit \(d_1 = 4\), \(d_2 = 3\) et \(d_3 = 1\). On range ces nombres dans un tableau de Young : la ligne \(j\) contient \(d_j\) cases. Les hauteurs des colonnes donnent alors les tailles des blocs, ici \(3, 2, 2, 1\), comme le montre la figure ci-dessous.
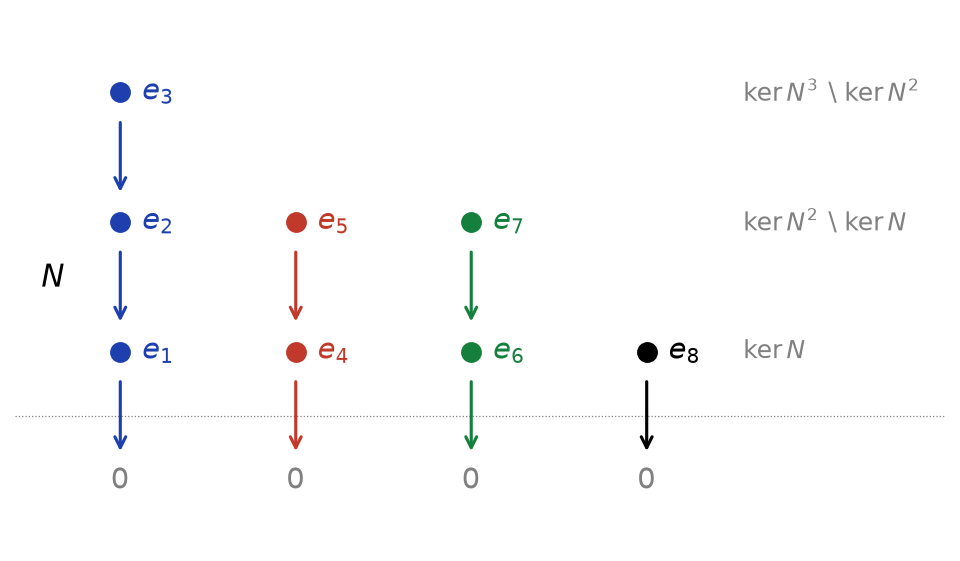
Enfin, chaque colonne du tableau correspond à une chaîne de vecteurs. La figure ci-dessous montre les quatre chaînes : chaque flèche représente l’action de \(v\), et le vecteur du bas de chaque chaîne est dans \(\ker v\).
Pour construire une base de Jordan d’un nilpotent \(v\) d’indice \(p\) : calculer les noyaux \(\ker v^j\) ; choisir des vecteurs de \(\ker v^p\) hors de \(\ker v^{p-1}\) (autant que \(d_p\)) ; leur appliquer \(v\) jusqu’à tomber dans \(\ker v\) ; recommencer au niveau \(p – 1\) en complétant les images déjà obtenues, et ainsi de suite. Rangez enfin chaque chaîne du bas vers le haut : \(v^{k-1}(x), \ldots, v(x), x\).
IV. Réduction de Jordan
1. Le théorème de Jordan
En combinant les sous-espaces caractéristiques et la classification des nilpotents, on obtient le résultat central du chapitre.
Réduction de Jordan. Si \(\chi_u\) est scindé, il existe une base de \(E\) dans laquelle la matrice de \(u\) est diagonale par blocs, chaque bloc étant un bloc de Jordan \(J_k(\lambda)\) avec \(\lambda\) valeur propre de \(u\). Cette matrice, appelée réduite de Jordan, est unique à l’ordre des blocs près.
On applique le théorème des nilpotents à la restriction de \(u – \lambda_i\,\mathrm{id}\) à chaque \(F_{\lambda_i}\), puis on réunit les bases obtenues. Pour l’unicité, les valeurs propres et leurs multiplicités sont déterminées par \(\chi_u\). Ensuite, pour chaque \(\lambda\), le nombre de blocs \(J_k(\lambda)\) de taille au moins \(j\) vaut \(\dim \ker(u – \lambda\,\mathrm{id})^j – \dim \ker(u – \lambda\,\mathrm{id})^{j-1}\). Ces quantités ne dépendent que de \(u\).
La réduite de Jordan permet de lire directement plusieurs invariants. Pour la valeur propre \(\lambda\), le nombre total de blocs est \(\dim E_\lambda\). La somme de leurs tailles est la multiplicité de \(\lambda\) dans \(\chi_u\). Enfin, la taille du plus grand bloc est l’exposant de \(X – \lambda\) dans \(\pi_u\). En particulier, \(u\) est diagonalisable si et seulement si tous ses blocs sont de taille \(1\).
Soit \(A = \begin{pmatrix} 0 1 0 \\ -1 2 0 \\ 1 -1 2 \end{pmatrix}\). On trouve \(\chi_A = (X – 1)^2 (X – 2)\) et \(\dim \ker(A – I_3) = 1\). Il y a donc un seul bloc pour la valeur propre \(1\), de taille \(2\). Avec \(v_1 = (1, 1, 0)\), \(v_2 = (0, 1, 1)\) et \(v_3 = (0, 0, 1)\), on vérifie \(Av_1 = v_1\), \(Av_2 = v_1 + v_2\) et \(Av_3 = 2v_3\). Par conséquent, \[A = P \begin{pmatrix} 1 1 0 \\ 0 1 0 \\ 0 0 2 \end{pmatrix} P^{-1}, \quad P = \begin{pmatrix} 1 0 0 \\ 1 1 0 \\ 0 1 1 \end{pmatrix}.\]
2. Décider si deux matrices sont semblables
Deux matrices de \(\mathcal{M}_n(\mathbb{C})\) sont semblables si et seulement si elles ont la même réduite de Jordan, à l’ordre des blocs près. Autrement dit, elles sont semblables si et seulement si, pour toute valeur propre \(\lambda\) et tout \(j \geq\, 1\), \[\mathrm{rg}(A – \lambda I_n)^j = \mathrm{rg}(B – \lambda I_n)^j.\]
Le polynôme caractéristique et le polynôme minimal ne suffisent pas en général. Par exemple, \(\mathrm{diag}(J_2(0), J_2(0))\) et \(\mathrm{diag}(J_2(0), J_1(0), J_1(0))\) ont toutes deux \(\chi = X^4\) et \(\pi = X^2\), mais leurs rangs valent \(2\) et \(1\). En revanche, ils suffisent en dimension \(n \leq\, 3\).
V. Invariants de similitude
La réduction de Jordan exige un polynôme caractéristique scindé. Les invariants de similitude, eux, existent sur tout corps et donnent une classification valable aussi sur \(\mathbb{R}\).
Un endomorphisme \(v\) est cyclique s’il existe \(x \in E\) tel que \((x, v(x), \ldots, v^{n-1}(x))\) soit une base de \(E\). C’est le cas si et seulement si \(\pi_v = \chi_v\). Dans cette base, la matrice de \(v\) est la matrice compagnon de \(\chi_v\).
Décomposition de Frobenius. Il existe une unique suite de polynômes unitaires non constants \(P_1, \ldots, P_s\) telle que \(P_1\) divise \(P_2\), qui divise \(P_3\), et ainsi de suite, et une décomposition \(E = E_1 \oplus \cdots \oplus E_s\) en sous-espaces stables où \(u\) induit un endomorphisme cyclique de polynôme minimal \(P_i\). Les \(P_i\) sont les invariants de similitude de \(u\). On a \(P_s = \pi_u\) et \(P_1 \cdots P_s = \chi_u\).
Nous admettons ce théorème, dont la preuve relève de la théorie des modules sur \(\mathbb{K}[X]\). Cependant, lorsque \(\chi_u\) est scindé, on passe facilement de la réduite de Jordan aux invariants. Pour chaque valeur propre, on range les tailles de blocs par ordre décroissant. Le polynôme \(P_s\) regroupe le plus grand bloc de chaque valeur propre, \(P_{s-1}\) le suivant, et ainsi de suite.
Pour la réduite \(\mathrm{diag}(J_2(1), J_1(1), J_1(2))\), les blocs de \(1\) sont de tailles \(2\) et \(1\), celui de \(2\) de taille \(1\). Par conséquent, \(P_2 = (X – 1)^2(X – 2)\) et \(P_1 = X – 1\). On vérifie que \(P_1 P_2 = (X – 1)^3(X – 2) = \chi\).
Deux matrices sont semblables si et seulement si elles ont les mêmes invariants de similitude. En particulier, deux matrices réelles semblables dans \(\mathcal{M}_n(\mathbb{C})\) sont semblables dans \(\mathcal{M}_n(\mathbb{R})\), car les invariants ne dépendent pas du corps.
VI. Exponentielle de matrice
1. Définition et propriétés
Pour \(A \in \mathcal{M}_n(\mathbb{K})\), la série \(\sum_{k \geq\, 0} \frac{A^k}{k!}\) converge absolument pour toute norme d’algèbre. Sa somme est l’exponentielle de \(A\), notée \(\exp(A)\) ou \(e^A\).
Si \(AB = BA\), alors \(\exp(A + B) = \exp(A)\exp(B)\). Par conséquent, \(\exp(A)\) est inversible d’inverse \(\exp(-A)\). De plus, \(\exp(PAP^{-1}) = P\exp(A)P^{-1}\) et \(\det \exp(A) = e^{\mathrm{tr}(A)}\).
La commutation est indispensable. En effet, pour \(A = J_2(0)\) et \(B = A^{\top}\), on vérifie que \(\exp(A)\exp(B) \neq \exp(A + B)\). Heureusement, la décomposition de Dunford fournit précisément deux matrices qui commutent.
2. Calcul par la décomposition de Dunford
Si \(A = D + N\) est la décomposition de Dunford, avec \(D = \sum \lambda_i P_i\) et \(N^p = 0\), alors \[\exp(tA) = \exp(tD)\exp(tN) = \Big(\sum_i e^{\lambda_i t} P_i\Big) \sum_{k=0}^{p-1} \frac{t^k N^k}{k!}.\] La somme de droite est finie : c’est tout l’intérêt de la méthode.
Pour un bloc de Jordan, \(J_3(\lambda) = \lambda I_3 + J_3(0)\), avec \(J_3(0)^3 = 0\). Ainsi \[\exp(tJ_3(\lambda)) = e^{\lambda t}\begin{pmatrix} 1 t t^2/2 \\ 0 1 t \\ 0 0 1 \end{pmatrix}.\]
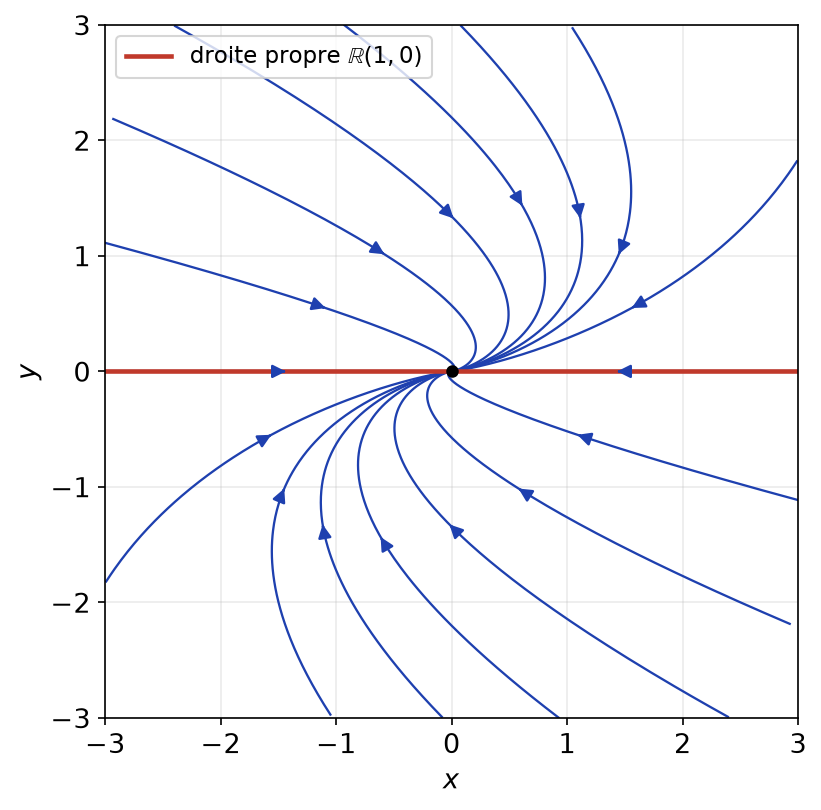
L’exponentielle résout les systèmes différentiels linéaires à coefficients constants : la solution de \(X^{\prime} = AX\) avec \(X(0) = X_0\) est \(X(t) = \exp(tA)X_0\). Prenons par exemple \(A = J_2(-1)\). Alors \(X(t) = e^{-t}(x_0 + ty_0,\ y_0)\). Toutes les trajectoires tendent vers l’origine, tangentiellement à la droite propre, comme le montre la figure ci-dessous.
VII. Dualité : base duale, orthogonal et transposée
La dualité fournit un autre regard sur la réduction. Elle permet notamment de montrer qu’une matrice est toujours semblable à sa transposée.
1. Base duale
Le dual de \(E\) est \(E^* = \mathcal{L}(E, \mathbb{K})\), l’espace des formes linéaires. Si \(\mathcal{B} = (e_1, \ldots, e_n)\) est une base de \(E\), les formes \(e_i^*\) définies par \(e_i^*(e_j) = \delta_{ij}\) forment une base de \(E^*\), appelée base duale. Pour tout \(x \in E\), on a \(x = \sum_i e_i^*(x)\,e_i\) : la forme \(e_i^*\) donne la \(i\)-ème coordonnée.
Si \(P\) est la matrice de passage de la base canonique de \(\mathbb{K}^n\) à \(\mathcal{B}\), alors les lignes de \(P^{-1}\) sont les matrices des formes \(e_1^*, \ldots, e_n^*\) dans la base canonique duale.
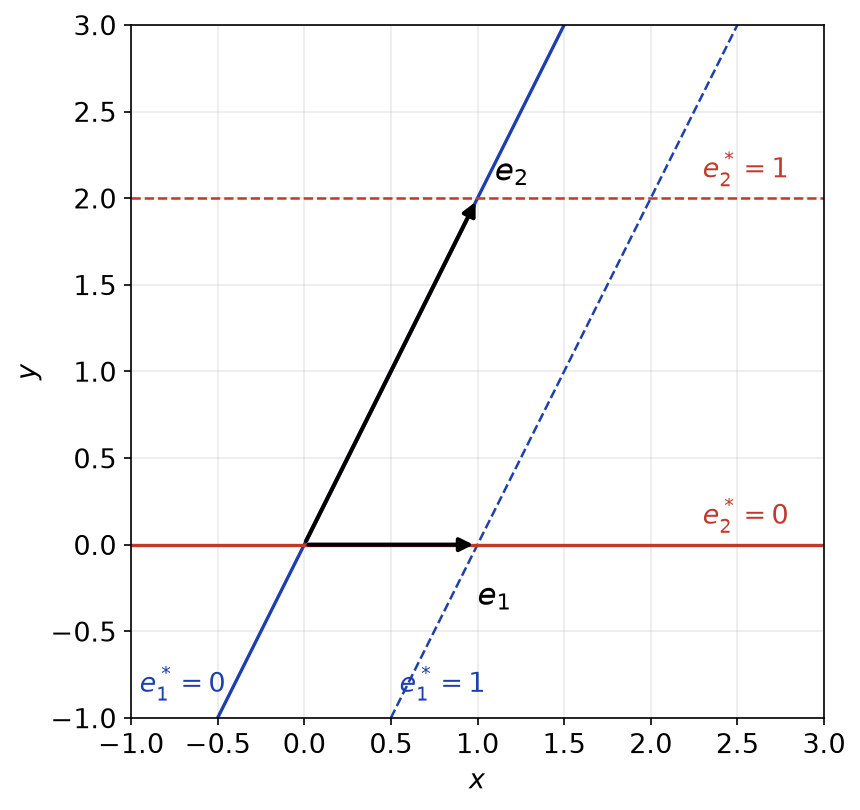
Dans \(\mathbb{R}^2\), prenons \(e_1 = (1, 0)\) et \(e_2 = (1, 2)\). On a \(P^{-1} = \begin{pmatrix} 1 -1/2 \\ 0 1/2 \end{pmatrix}\), donc \(e_1^*(x, y) = x – \frac{y}{2}\) et \(e_2^*(x, y) = \frac{y}{2}\). La figure ci-dessous montre les droites \(e_i^* = 0\) et \(e_i^* = 1\) : le noyau de \(e_1^*\) est la droite portée par \(e_2\), et réciproquement.
2. Orthogonal et transposée
L’orthogonal d’une partie \(F\) de \(E\) est \(F^{\perp} = \{\varphi \in E^* : \forall x \in F,\ \varphi(x) = 0\}\). La transposée de \(u \in \mathcal{L}(E)\) est l’application \(u^{\top} : E^* \to E^*\), \(\varphi \mapsto \varphi \circ u\).
Si \(F\) est un sous-espace de \(E\), alors \(\dim F + \dim F^{\perp} = n\). Si \(A\) est la matrice de \(u\) dans \(\mathcal{B}\), alors la matrice de \(u^{\top}\) dans \(\mathcal{B}^*\) est \(A^{\top}\). Enfin, \(\ker u^{\top} = (\mathrm{Im}\,u)^{\perp}\), donc \(\mathrm{rg}\,u^{\top} = \mathrm{rg}\,u\).
Complétons une base \((e_1, \ldots, e_p)\) de \(F\) en une base \(\mathcal{B}\) de \(E\). Une forme \(\varphi = \sum c_i e_i^*\) s’annule sur \(F\) si et seulement si \(c_1 = \cdots = c_p = 0\). Donc \(F^{\perp} = \mathrm{Vect}(e_{p+1}^*, \ldots, e_n^*)\), de dimension \(n – p\). Ensuite, le coefficient \((i, j)\) de la matrice de \(u^{\top}\) vaut \(u^{\top}(e_j^*)(e_i) = e_j^*(u(e_i)) = a_{ji}\). Enfin, \(\varphi \circ u = 0\) signifie exactement que \(\varphi\) s’annule sur \(\mathrm{Im}\,u\).
Il en découle une conséquence remarquable. Pour tout \(\lambda\) et tout \(j\), on a \(\mathrm{rg}(A^{\top} – \lambda I)^j = \mathrm{rg}\big((A – \lambda I)^j\big)^{\top} = \mathrm{rg}(A – \lambda I)^j\). D’après le critère des rangs, \(A\) et \(A^{\top}\) sont donc semblables sur \(\mathbb{C}\), puis sur \(\mathbb{R}\) grâce aux invariants de similitude.
Ce qu’il faut retenir
- Le lemme des noyaux découpe \(E\) en sous-espaces stables, et ses projecteurs sont des polynômes en \(u\).
- Si \(\chi_u\) est scindé, \(E\) est somme directe des sous-espaces caractéristiques \(\ker(u – \lambda_i)^{m_i}\), de dimensions \(m_i\).
- La décomposition de Dunford \(u = d + n\) (diagonalisable plus nilpotent, qui commutent) existe et est unique ; \(d = \sum \lambda_i p_i\).
- Un nilpotent est classé par la partition de \(n\) formée des tailles de ses blocs, lue sur le tableau de Young des \(d_j = \dim \ker v^j – \dim \ker v^{j-1}\).
- Tout endomorphisme à polynôme caractéristique scindé admet une réduite de Jordan, unique à l’ordre des blocs près.
- Deux matrices complexes sont semblables si et seulement si les rangs de \((A – \lambda I)^j\) coïncident pour tous \(\lambda\) et \(j\).
- Les invariants de similitude \(P_1 \mid \cdots \mid P_s\) classent les matrices sur tout corps ; \(P_s = \pi\) et \(\prod P_i = \chi\).
- On calcule \(\exp(tA) = \exp(tD)\exp(tN)\) avec la décomposition de Dunford, la série en \(N\) étant finie.
- Les lignes de \(P^{-1}\) donnent la base duale ; \(u^{\top}\) a pour matrice \(A^{\top}\), et \(A\) est semblable à \(A^{\top}\).
Questions fréquentes sur réduction de Jordan
Quelle différence entre la décomposition de Dunford et la réduction de Jordan ?
La décomposition de Dunford écrit \(u = d + n\) avec \(d\) diagonalisable, \(n\) nilpotent et \(dn = nd\) ; elle est unique mais ne donne pas de forme matricielle simple pour \(n\). La réduction de Jordan va plus loin : elle fournit une base où la matrice est diagonale par blocs \(J_k(\lambda)\). La partie diagonale de la réduite de Jordan correspond exactement à \(d\).
Comment trouver la taille des blocs de Jordan sans construire de base ?
Pour chaque valeur propre \(\lambda\), on calcule les dimensions des noyaux \(\ker(A – \lambda I)^j\). La différence \(\dim \ker(A – \lambda I)^j – \dim \ker(A – \lambda I)^{j-1}\) est le nombre de blocs de taille au moins \(j\). Le tableau de Young construit avec ces nombres donne les tailles des blocs comme hauteurs de ses colonnes.
Le polynôme caractéristique et le polynôme minimal suffisent-ils pour conclure à la similitude ?
Oui en dimension au plus \(3\), mais pas au-delà. Par exemple, \(\mathrm{diag}(J_2(0), J_2(0))\) et \(\mathrm{diag}(J_2(0), J_1(0), J_1(0))\) ont le même polynôme caractéristique \(X^4\) et le même polynôme minimal \(X^2\), mais pas le même rang. Il faut alors comparer les rangs des puissances \((A – \lambda I)^j\).
Pourquoi utiliser Dunford pour calculer une exponentielle de matrice ?
La formule \(\exp(A + B) = \exp(A)\exp(B)\) n’est vraie que si \(A\) et \(B\) commutent, ce qui est le cas pour \(D\) et \(N\). De plus, \(\exp(tD)\) s’obtient avec les projecteurs spectraux et \(\exp(tN)\) est une somme finie, car \(N\) est nilpotente. On obtient ainsi une formule exacte sans calculer de série infinie.
Pour aller plus loin en L3
- Les énoncés : exercices de maths en L3 sur réduction de Jordan
- Chapitre précédent : Corps, extensions et corps finis
- Chapitre suivant : Calcul différentiel dans les espaces normés
- Tester vos connaissances : QCM de maths en L3 par chapitre
- Le sommaire : tous les chapitres de maths de L3 et la licence de maths de L1 à L3