Ce cours de diagonalisation L2 ouvre la réduction des endomorphismes au premier semestre. Vous y étudiez les sous-espaces stables, les valeurs propres et les vecteurs propres, puis le polynôme caractéristique, qui transforme la recherche du spectre en calcul de racines.
Le fil conducteur est un théorème : les sous-espaces propres sont en somme directe. Tous les critères de diagonalisabilité en découlent, avec des démonstrations complètes. Ainsi, vous saurez comparer multiplicité algébrique et multiplicité géométrique, puis décider rapidement si une matrice est diagonalisable.
Enfin, le chapitre montre à quoi sert cette réduction : calculer des puissances de matrices, résoudre des suites récurrentes linéaires et des systèmes différentiels à coefficients constants. Ces outils serviront ensuite pour la trigonalisation, les espaces euclidiens et le théorème spectral.
Pour vous entraîner ensuite, travaillez les exercices de maths en L2 sur diagonalisation.
I. Sous-espaces stables par un endomorphisme
Dans tout le chapitre, \(\mathbb{K}\) désigne \(\mathbb{R}\) ou \(\mathbb{C}\). Sauf mention contraire, \(E\) est un \(\mathbb{K}\)-espace vectoriel de dimension finie \(n \geq\, 1\) et \(u\) est un endomorphisme de \(E\). L’idée directrice est simple : on cherche une base dans laquelle la matrice de \(u\) est la plus simple possible. D’abord, il faut repérer les parties de \(E\) que \(u\) ne mélange pas avec le reste.
Un sous-espace vectoriel \(F\) de \(E\) est stable par \(u\) si \(u(F) \subset F\), autrement dit si \(\forall x \in F,\ u(x) \in F\). L’application \(u_F : F \to F\), \(x \mapsto u(x)\), est alors un endomorphisme de \(F\), appelé endomorphisme induit par \(u\) sur \(F\).
Les sous-espaces \(\{0\}\) et \(E\) sont toujours stables. De plus, \(\ker u\) et \(\operatorname{Im} u\) le sont aussi. En effet, si \(u(x) = 0\), alors \(u(u(x)) = 0\). Par ailleurs, \(u(y)\) appartient toujours à \(\operatorname{Im} u\).
Soient \(u\) et \(v\) deux endomorphismes de \(E\) qui commutent (\(u \circ v = v \circ u\)). Alors \(\ker v\) et \(\operatorname{Im} v\) sont stables par \(u\).
Soit \(x \in \ker v\). Alors \(v(u(x)) = u(v(x)) = u(0) = 0\), donc \(u(x) \in \ker v\). Ensuite, soit \(y = v(z) \in \operatorname{Im} v\). On a \(u(y) = u(v(z)) = v(u(z))\), donc \(u(y) \in \operatorname{Im} v\).
La stabilité se lit sur les matrices. Soit \(F\) de dimension \(p\), et soit \(\mathcal{B} = (e_1, \ldots, e_n)\) une base de \(E\) dont les \(p\) premiers vecteurs forment une base de \(F\). Alors \(F\) est stable par \(u\) si et seulement si la matrice de \(u\) dans \(\mathcal{B}\) est triangulaire par blocs :
\[\operatorname{Mat}_{\mathcal{B}}(u) = \begin{pmatrix} A B \\ 0 C \end{pmatrix}, \quad A \in \mathcal{M}_p(\mathbb{K}).\]
Le bloc \(A\) est la matrice de l’endomorphisme induit \(u_F\). Ainsi, si \(E = F \oplus G\) avec \(F\) et \(G\) stables, la matrice devient diagonale par blocs. C’est exactement ce que l’on cherche à obtenir, avec des blocs de taille 1.
Une droite \(D = \mathrm{Vect}(x)\), avec \(x \neq 0\), est stable par \(u\) si et seulement s’il existe \(\lambda \in \mathbb{K}\) tel que \(u(x) = \lambda x\).
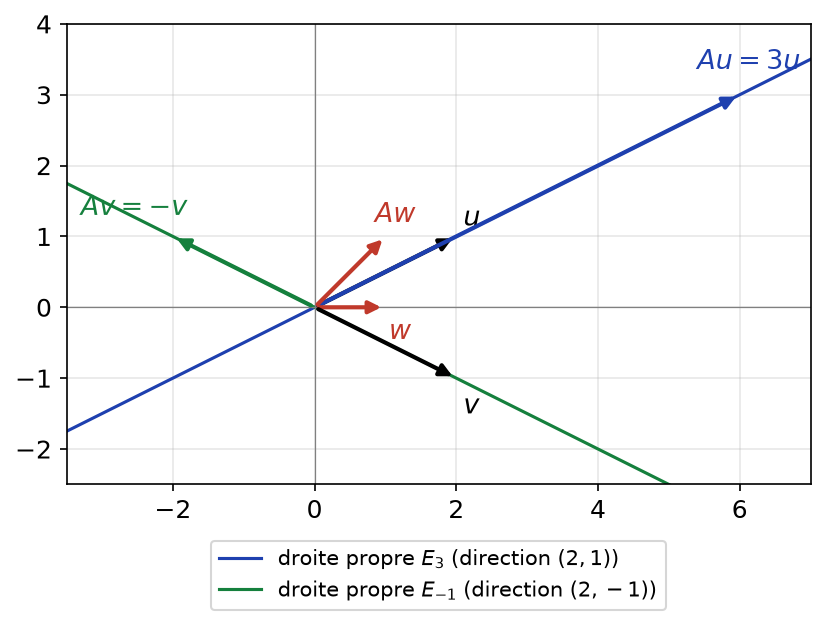
Soit \(A = \begin{pmatrix} 1 4 \\ 1 1 \end{pmatrix}\), vue comme endomorphisme de \(\mathbb{R}^2\). Pour \(u = (2,1)\), on trouve \(Au = (6,3) = 3u\). Pour \(v = (2,-1)\), on trouve \(Av = (-2,1) = -v\). Les droites \(\mathrm{Vect}(u)\) et \(\mathrm{Vect}(v)\) sont donc stables. En revanche, pour \(w = (1,0)\), \(Aw = (1,1)\) n’est pas colinéaire à \(w\).
Dans cet exemple, \(\mathbb{R}^2 = \mathrm{Vect}(u) \oplus \mathrm{Vect}(v)\), et les deux droites sont stables. Par conséquent, dans la base \((u, v)\), la matrice de l’endomorphisme est \(\mathrm{diag}(3, -1)\). Tout le chapitre consiste à généraliser cette situation : trouver assez de droites stables pour reconstituer l’espace entier.
La figure ci-dessous montre ces deux droites stables : sur chacune, \(A\) agit comme une simple multiplication. Hors de ces droites, la direction du vecteur change.
II. Valeurs propres et vecteurs propres
1. Définitions
La proposition précédente conduit naturellement aux notions centrales du chapitre.
Un scalaire \(\lambda \in \mathbb{K}\) est une valeur propre de \(u\) s’il existe \(x \neq 0\) tel que \(u(x) = \lambda x\). Un tel vecteur \(x\) est un vecteur propre associé à \(\lambda\). Le sous-espace \(E_\lambda(u) = \ker(u – \lambda \,\mathrm{id}_E)\) est le sous-espace propre associé à \(\lambda\). L’ensemble des valeurs propres est le spectre de \(u\), noté \(\mathrm{Sp}(u)\).
Autrement dit, \(\lambda\) est valeur propre si et seulement si \(u – \lambda\,\mathrm{id}_E\) n’est pas injectif. En dimension finie, cela revient à dire que \(u – \lambda\,\mathrm{id}_E\) n’est pas inversible. En particulier, \(0\) est valeur propre de \(u\) si et seulement si \(u\) n’est pas bijectif.
Un vecteur propre est non nul par définition. En revanche, le sous-espace propre \(E_\lambda(u)\) contient \(0\) : il est formé des vecteurs propres associés à \(\lambda\) et du vecteur nul.
Pour une matrice \(A \in \mathcal{M}_n(\mathbb{K})\), on parle des valeurs propres, des vecteurs propres (colonnes \(X \neq 0\) telles que \(AX = \lambda X\)) et du spectre de l’endomorphisme \(X \mapsto AX\) de \(\mathbb{K}^n\). Le spectre dépend du corps : la matrice de rotation \(\begin{pmatrix} 0 -1 \\ 1 0 \end{pmatrix}\) n’a aucune valeur propre réelle, mais elle admet \(i\) et \(-i\) comme valeurs propres complexes.
Sur l’espace \(C^\infty(\mathbb{R}, \mathbb{R})\), qui est de dimension infinie, considérons la dérivation \(D : f \mapsto f^{\prime}\). Pour tout réel \(\lambda\), la fonction \(x \mapsto e^{\lambda x}\) vérifie \(D(f) = \lambda f\). Ainsi, tout réel est valeur propre de \(D\), et \(E_\lambda(D)\) est la droite engendrée par cette exponentielle.
2. Somme directe des sous-espaces propres
Le résultat suivant est le pivot du chapitre. En effet, tous les critères de diagonalisabilité en découlent.
Soient \(\lambda_1, \ldots, \lambda_p\) des valeurs propres deux à deux distinctes de \(u\). Alors la somme \(E_{\lambda_1}(u) + \cdots + E_{\lambda_p}(u)\) est directe. En particulier, toute famille de vecteurs propres associés à des valeurs propres distinctes est libre.
On raisonne par récurrence sur \(p\). Pour \(p = 1\), il n’y a rien à montrer. Supposons le résultat vrai au rang \(p – 1\). Soient \(x_i \in E_{\lambda_i}(u)\) tels que \(x_1 + \cdots + x_p = 0\). On applique \(u – \lambda_p\,\mathrm{id}_E\) à cette égalité. Comme \(u(x_i) = \lambda_i x_i\), on obtient :
\[\sum_{i=1}^{p-1} (\lambda_i – \lambda_p)\, x_i = 0.\]
Chaque \((\lambda_i – \lambda_p) x_i\) appartient à \(E_{\lambda_i}(u)\). Par hypothèse de récurrence, tous ces vecteurs sont nuls. Or \(\lambda_i – \lambda_p \neq 0\), donc \(x_i = 0\) pour \(i \leq\, p – 1\). Enfin, \(x_p = -(x_1 + \cdots + x_{p-1}) = 0\). La somme est donc directe.
Une conséquence immédiate : en dimension \(n\), un endomorphisme possède au plus \(n\) valeurs propres distinctes. De plus, \(\sum_{\lambda \in \mathrm{Sp}(u)} \dim E_\lambda(u) \leq\, n\).
III. Polynôme caractéristique et spectre d’une matrice
1. Définition et premières propriétés
Il faut maintenant un outil de calcul. D’après la partie II, \(\lambda\) est valeur propre de \(A\) si et seulement si \(A – \lambda I_n\) n’est pas inversible, c’est-à-dire si \(\det(\lambda I_n – A) = 0\).
Le polynôme caractéristique de \(A \in \mathcal{M}_n(\mathbb{K})\) est \(\chi_A(X) = \det(X I_n – A)\). C’est un polynôme unitaire de degré \(n\). Pour un endomorphisme \(u\), on pose \(\chi_u = \chi_A\), où \(A\) est la matrice de \(u\) dans une base quelconque.
Cette définition ne dépend pas de la base choisie. En effet, si \(B = P^{-1}AP\), alors \(XI_n – B = P^{-1}(XI_n – A)P\), donc les deux déterminants coïncident. Deux matrices semblables ont donc le même polynôme caractéristique, donc le même spectre.
Pour \(A \in \mathcal{M}_n(\mathbb{K})\) :
- \(\mathrm{Sp}(A)\) est l’ensemble des racines de \(\chi_A\) dans \(\mathbb{K}\) ;
- \(\chi_A(X) = X^n – \operatorname{tr}(A)\, X^{n-1} + \cdots + (-1)^n \det A\) ;
- pour \(n = 2\), \(\chi_A(X) = X^2 – \operatorname{tr}(A)\, X + \det A\) ;
- \(\chi_{A^{T}} = \chi_A\), et si \(A\) est triangulaire, \(\mathrm{Sp}(A)\) est l’ensemble de ses coefficients diagonaux.
Calculons le polynôme caractéristique de \(A = \begin{pmatrix} 2 1 1 \\ 1 2 1 \\ 1 1 2 \end{pmatrix}\). Plutôt que de développer brutalement, on ajoute d’abord toutes les colonnes à la première. Chaque coefficient de la première colonne de \(XI_3 – A\) devient alors \(X – 4\). On factorise ce terme, puis on retranche la première ligne aux deux autres :
\[\chi_A(X) = (X – 4)\begin{vmatrix} 1 -1 -1 \\ 1 X – 2 -1 \\ 1 -1 X – 2 \end{vmatrix} = (X – 4)\begin{vmatrix} 1 -1 -1 \\ 0 X – 1 0 \\ 0 0 X – 1 \end{vmatrix} = (X – 4)(X – 1)^2.\]
Le spectre est donc \(\{1, 4\}\). On contrôle avec la trace : \(1 + 1 + 4 = 6 = \operatorname{tr}(A)\). De même, le produit \(1 \times 1 \times 4 = 4\) redonne bien \(\det A\).
Sur \(\mathbb{C}\), le théorème de d’Alembert-Gauss assure que \(\chi_A\) est scindé. Par conséquent, toute matrice complexe possède au moins une valeur propre. Lorsque \(\chi_A\) est scindé, la somme des valeurs propres comptées avec multiplicité vaut \(\operatorname{tr}(A)\) et leur produit vaut \(\det A\).
2. Multiplicité algébrique et multiplicité géométrique
Soit \(\lambda \in \mathrm{Sp}(u)\). Sa multiplicité algébrique \(m(\lambda)\) est sa multiplicité comme racine de \(\chi_u\). Sa multiplicité géométrique est \(\dim E_\lambda(u)\).
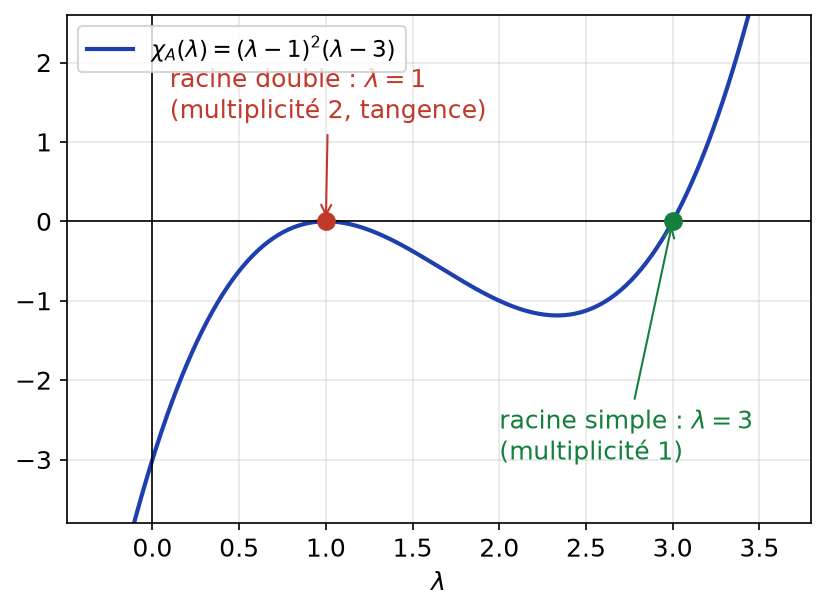
La figure ci-dessous représente le polynôme caractéristique \(\chi_A(\lambda) = (\lambda – 1)^2(\lambda – 3)\) de la matrice \(A = \begin{pmatrix} 1 0 2 \\ 0 1 -1 \\ 0 0 3 \end{pmatrix}\). On y voit une racine double, où la courbe est tangente à l’axe, et une racine simple.
Pour toute valeur propre \(\lambda\) de \(u\), on a \(1 \leq\, \dim E_\lambda(u) \leq\, m(\lambda)\).
D’abord, \(E_\lambda(u)\) contient un vecteur non nul, donc \(d = \dim E_\lambda(u) \geq\, 1\). Ensuite, on complète une base \((e_1, \ldots, e_d)\) de \(E_\lambda(u)\) en une base \(\mathcal{B}\) de \(E\). Comme \(u(e_i) = \lambda e_i\) pour \(i \leq\, d\), on obtient :
\[\operatorname{Mat}_{\mathcal{B}}(u) = \begin{pmatrix} \lambda I_d B \\ 0 C \end{pmatrix}, \qquad \chi_u(X) = (X – \lambda)^d \, \chi_C(X).\]
Le déterminant d’une matrice triangulaire par blocs est le produit des déterminants des blocs diagonaux. Donc \((X – \lambda)^d\) divise \(\chi_u\), et finalement \(d \leq\, m(\lambda)\).
Pour \(N = \begin{pmatrix} 1 1 \\ 0 1 \end{pmatrix}\), on a \(\chi_N = (X-1)^2\), donc \(m(1) = 2\). Cependant \(N – I_2\) est de rang 1, donc \(\dim E_1(N) = 1\). Les deux multiplicités diffèrent. Pour la matrice \(A\) de la figure, au contraire, \(A – I_3\) est de rang 1, donc \(\dim E_1(A) = 2 = m(1)\).
Pour trouver les éléments propres d’une matrice \(A\) :
- calculer \(\chi_A\) en factorisant le plus tôt possible (opérations sur les lignes ou colonnes avant de développer) ;
- chercher ses racines : ce sont les valeurs propres ;
- pour chaque \(\lambda\), résoudre le système \((A – \lambda I_n)X = 0\) ; la dimension de la solution vaut \(n – \operatorname{rg}(A – \lambda I_n)\) ;
- vérifier le résultat : \(\operatorname{tr}(A)\) doit être égale à la somme des valeurs propres comptées avec multiplicité.
IV. Critères de diagonalisation
1. Endomorphismes et matrices diagonalisables
L’endomorphisme \(u\) est diagonalisable s’il existe une base de \(E\) formée de vecteurs propres de \(u\). Une matrice \(A\) est diagonalisable si elle est semblable à une matrice diagonale : il existe \(P\) inversible et \(D\) diagonale telles que \(A = PDP^{-1}\).
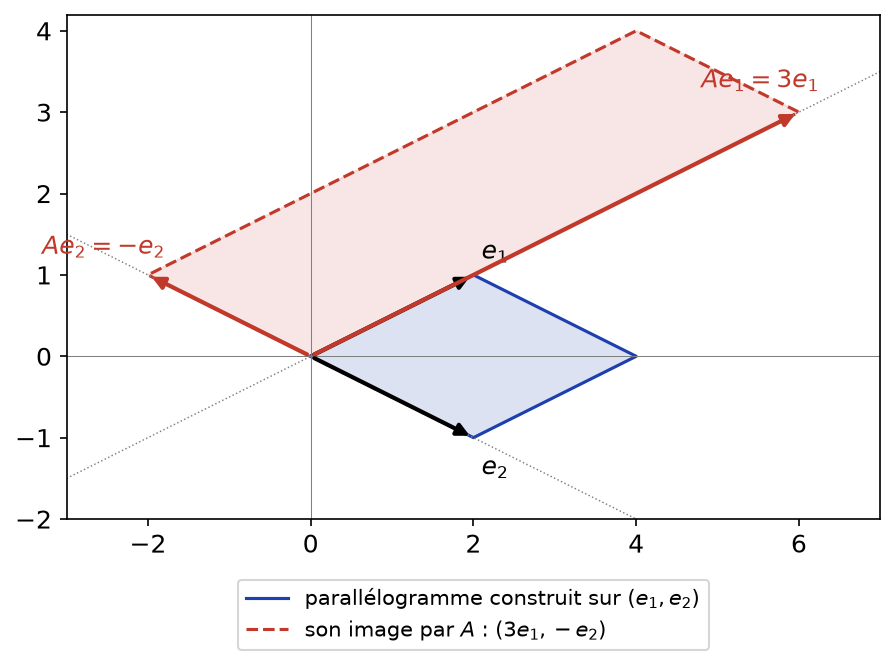
Les deux notions se correspondent. En effet, si \(P\) a pour colonnes des vecteurs propres \(X_1, \ldots, X_n\) formant une base, avec \(AX_j = \lambda_j X_j\), alors \(AP = PD\) avec \(D = \mathrm{diag}(\lambda_1, \ldots, \lambda_n)\). Dans cette base propre, l’endomorphisme agit par dilatation le long de chaque axe. La figure ci-dessous l’illustre pour la matrice \(A = \begin{pmatrix} 1 4 \\ 1 1 \end{pmatrix}\) de la partie I, avec \(e_1 = (2,1)\) et \(e_2 = (2,-1)\).
2. Les critères
Le théorème de somme directe fournit alors une caractérisation complète.
Les assertions suivantes sont équivalentes :
- \(u\) est diagonalisable ;
- \(E = \bigoplus_{\lambda \in \mathrm{Sp}(u)} E_\lambda(u)\) ;
- \(\sum_{\lambda \in \mathrm{Sp}(u)} \dim E_\lambda(u) = n\) ;
- \(\chi_u\) est scindé sur \(\mathbb{K}\) et, pour tout \(\lambda \in \mathrm{Sp}(u)\), \(\dim E_\lambda(u) = m(\lambda)\).
(1 ⇒ 2) Une base propre se regroupe selon les valeurs propres. Ainsi, tout vecteur de \(E\) est somme de vecteurs des \(E_\lambda(u)\). La somme étant directe (partie II), on obtient 2.
(2 ⇒ 1) On concatène des bases des \(E_\lambda(u)\). Comme la somme est directe et vaut \(E\), on obtient une base de \(E\), formée de vecteurs propres.
(2 ⇔ 3) La somme est toujours directe, donc sa dimension vaut \(\sum \dim E_\lambda(u)\). Elle est égale à \(E\) si et seulement si cette dimension vaut \(n\).
(3 ⇔ 4) D’après la partie III, on a la chaîne d’inégalités :
\[\sum_{\lambda} \dim E_\lambda(u) \leq\, \sum_{\lambda} m(\lambda) \leq\, \deg \chi_u = n.\]
La seconde inégalité est une égalité si et seulement si \(\chi_u\) est scindé. Par conséquent, l’égalité globale a lieu si et seulement si \(\chi_u\) est scindé et \(\dim E_\lambda(u) = m(\lambda)\) pour chaque \(\lambda\).
Si \(\chi_u\) est scindé à racines simples, c’est-à-dire si \(u\) possède \(n\) valeurs propres distinctes, alors \(u\) est diagonalisable et chaque sous-espace propre est une droite.
La condition du corollaire est suffisante mais pas nécessaire : \(I_n\) est diagonale, alors que \(1\) est racine de multiplicité \(n\). De même, les valeurs propres simples ne posent jamais problème, puisque \(1 \leq\, \dim E_\lambda \leq\, 1\). Seules les valeurs propres multiples doivent être examinées.
Pour décider si \(A \in \mathcal{M}_n(\mathbb{K})\) est diagonalisable :
- factoriser \(\chi_A\) ; s’il n’est pas scindé sur \(\mathbb{K}\), \(A\) n’est pas diagonalisable sur \(\mathbb{K}\) ;
- pour chaque valeur propre multiple \(\lambda\), calculer \(\operatorname{rg}(A – \lambda I_n)\) et comparer \(n – \operatorname{rg}(A – \lambda I_n)\) à \(m(\lambda)\) ;
- si \(A\) est diagonalisable, former \(P\) avec des bases des sous-espaces propres, dans l’ordre choisi pour \(D\).
La matrice \(N = \begin{pmatrix} 1 1 \\ 0 1 \end{pmatrix}\) n’est pas diagonalisable, car \(\dim E_1(N) = 1 < 2 = m(1)\). Par un argument direct, si \(N = PDP^{-1}\), alors \(D = I_2\) (seule valeur propre 1), donc \(N = I_2\), ce qui est faux. La matrice \(A = \begin{pmatrix} 1 0 2 \\ 0 1 -1 \\ 0 0 3 \end{pmatrix}\), en revanche, est diagonalisable puisque \(\dim E_1(A) = 2 = m(1)\) et \(\dim E_3(A) = 1 = m(3)\).
V. Application aux puissances et aux suites récurrentes
1. Puissances d’une matrice diagonalisable
Une fois \(A = PDP^{-1}\) obtenue, les puissances se calculent sans effort. En effet, les facteurs \(P^{-1}P\) se simplifient deux à deux.
Si \(A = PDP^{-1}\) avec \(D = \mathrm{diag}(\lambda_1, \ldots, \lambda_n)\), alors pour tout \(k \in \mathbb{N}\) :
\[A^k = P D^k P^{-1}, \qquad D^k = \mathrm{diag}(\lambda_1^k, \ldots, \lambda_n^k).\]
Pour \(A = \begin{pmatrix} 1 4 \\ 1 1 \end{pmatrix}\), on prend \(P = \begin{pmatrix} 2 2 \\ 1 -1 \end{pmatrix}\) et \(D = \mathrm{diag}(3, -1)\). Comme \(P^{-1} = \frac{1}{4}\begin{pmatrix} 1 2 \\ 1 -2 \end{pmatrix}\), le calcul donne :
\[A^k = \frac{1}{4}\begin{pmatrix} 2 \cdot 3^k + 2(-1)^k 4 \cdot 3^k – 4(-1)^k \\ 3^k – (-1)^k 2 \cdot 3^k + 2(-1)^k \end{pmatrix}.\]
On vérifie aisément que \(k = 0\) redonne \(I_2\) et que \(k = 1\) redonne \(A\).
2. Systèmes de suites récurrentes linéaires
Considérons des suites \((x_n)\) et \((y_n)\) liées par un système linéaire. On pose \(X_n = \begin{pmatrix} x_n \\ y_n \end{pmatrix}\), si bien que le système s’écrit \(X_{n+1} = MX_n\). Par récurrence immédiate, \(X_n = M^n X_0\).
Pour résoudre \(X_{n+1} = MX_n\) avec \(M\) diagonalisable, de vecteurs propres \(V_1, \ldots, V_p\) formant une base :
- décomposer la donnée initiale : \(X_0 = c_1 V_1 + \cdots + c_p V_p\) ;
- en déduire \(X_n = c_1 \lambda_1^n V_1 + \cdots + c_p \lambda_p^n V_p\), sans calculer \(P^{-1}\) en entier.
Une suite récurrente d’ordre 2, \(u_{n+2} = a u_{n+1} + b u_n\), se traite de même avec \(X_n = \begin{pmatrix} u_n \\ u_{n+1} \end{pmatrix}\) et \(M = \begin{pmatrix} 0 1 \\ b a \end{pmatrix}\).
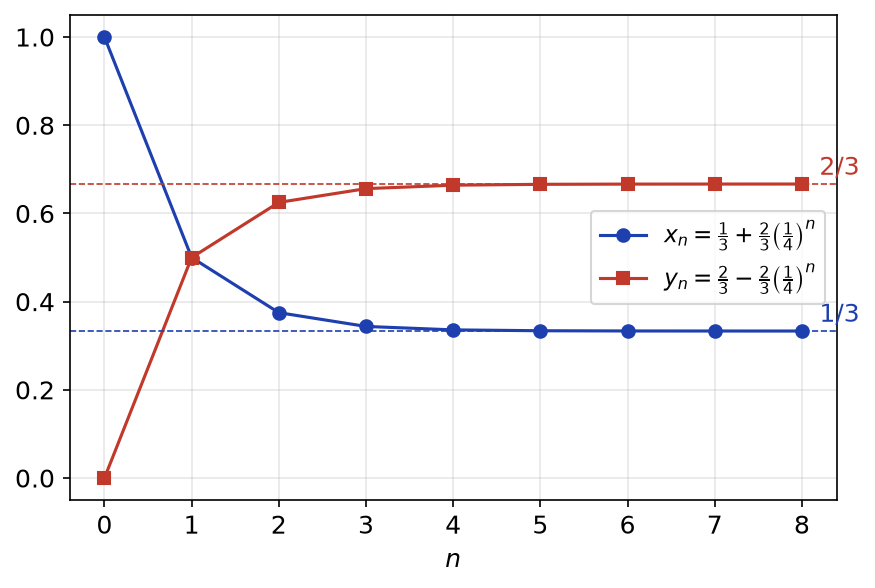
Soit le système \(x_{n+1} = \frac{1}{2}x_n + \frac{1}{4}y_n\), \(y_{n+1} = \frac{1}{2}x_n + \frac{3}{4}y_n\), avec \(x_0 = 1\) et \(y_0 = 0\). La matrice \(M\) a pour polynôme caractéristique \(X^2 – \frac{5}{4}X + \frac{1}{4} = (X – 1)(X – \frac{1}{4})\). Ensuite, \(V_1 = (1, 2)\) est propre pour 1 et \(V_2 = (1, -1)\) est propre pour \(\frac{1}{4}\). Or \(X_0 = \frac{1}{3}V_1 + \frac{2}{3}V_2\), donc :
\[x_n = \frac{1}{3} + \frac{2}{3}(\frac{1}{4})^n, \qquad y_n = \frac{2}{3} – \frac{2}{3}(\frac{1}{4})^n.\]
Le terme en \((\frac{1}{4})^n\) tend vers 0. Par conséquent, \(X_n\) converge vers \(\frac{1}{3}V_1\), qui est un vecteur propre pour la valeur propre 1. La figure ci-dessous montre cette convergence rapide.
VI. Application aux systèmes différentiels linéaires
On cherche les fonctions dérivables \(X : \mathbb{R} \to \mathbb{K}^n\) telles que \(X^{\prime}(t) = AX(t)\), où \(A \in \mathcal{M}_n(\mathbb{K})\) est une matrice constante. Si \(A\) est diagonalisable, le changement d’inconnue \(Y = P^{-1}X\) découple le système.
Soit \(A = PDP^{-1}\) avec \(D = \mathrm{diag}(\lambda_1, \ldots, \lambda_n)\), et soient \(V_1, \ldots, V_n\) les colonnes de \(P\). Les solutions de \(X^{\prime} = AX\) sont exactement les fonctions :
\[X(t) = c_1 e^{\lambda_1 t} V_1 + \cdots + c_n e^{\lambda_n t} V_n, \qquad (c_1, \ldots, c_n) \in \mathbb{K}^n.\]
Posons \(Y = P^{-1}X\). Comme \(P\) est constante, \(Y^{\prime} = P^{-1}X^{\prime}\). Ainsi, \(X^{\prime} = AX\) équivaut à \(Y^{\prime} = P^{-1}APY = DY\). Ce système est découplé : \(y_j^{\prime} = \lambda_j y_j\) pour chaque \(j\). Donc \(y_j(t) = c_j e^{\lambda_j t}\). Finalement, \(X = PY = \sum_j y_j V_j\).
Les constantes \(c_j\) se déterminent par la condition initiale : on décompose \(X(0)\) dans la base propre, exactement comme pour les suites.
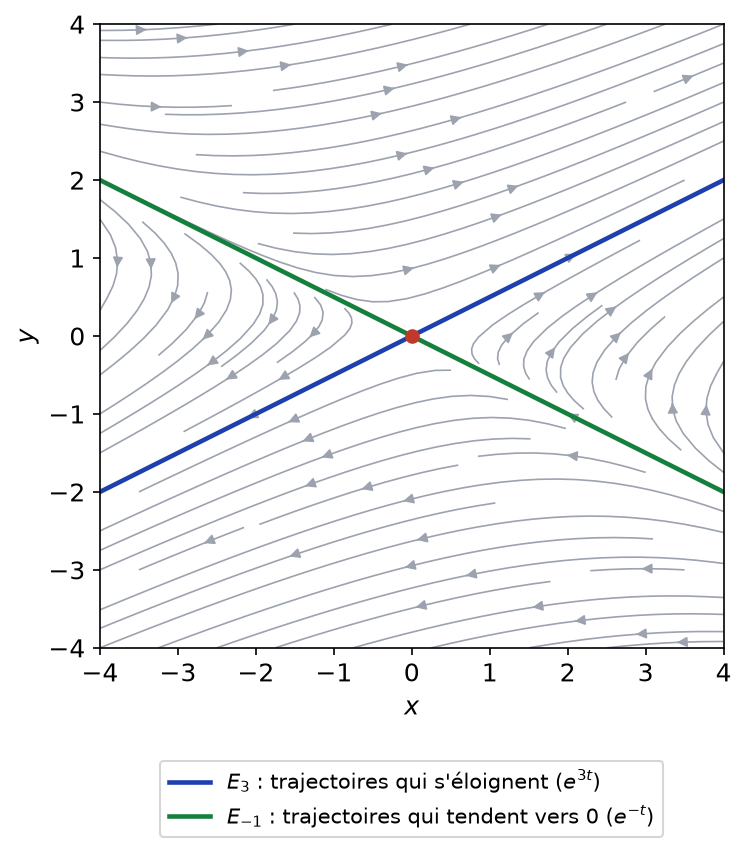
Résolvons \(x^{\prime} = x + 4y\), \(y^{\prime} = x + y\). La matrice est \(A = \begin{pmatrix} 1 4 \\ 1 1 \end{pmatrix}\), de valeurs propres 3 et \(-1\), avec les vecteurs propres \((2,1)\) et \((2,-1)\). Les solutions sont donc :
\[\begin{pmatrix} x(t) \\ y(t) \end{pmatrix} = c_1 e^{3t}\begin{pmatrix} 2 \\ 1 \end{pmatrix} + c_2 e^{-t}\begin{pmatrix} 2 \\ -1 \end{pmatrix}.\]
Par exemple, avec \(x(0) = 4\) et \(y(0) = 0\), on trouve \(c_1 = c_2 = 1\), d’où \(x(t) = 2e^{3t} + 2e^{-t}\) et \(y(t) = e^{3t} – e^{-t}\).
Le portrait de phase ci-dessous représente les trajectoires dans le plan \((x, y)\). Les deux droites propres sont invariantes. Sur la première, les solutions s’éloignent de l’origine ; sur la seconde, elles s’en rapprochent. Ailleurs, les trajectoires suivent d’abord la direction de \(E_{-1}\), puis celle de \(E_3\).
Si \(A\) est réelle avec des valeurs propres complexes non réelles, on diagonalise sur \(\mathbb{C}\), puis on prend les parties réelles et imaginaires des solutions complexes. Si \(A\) n’est pas diagonalisable, il faut une réduction plus fine, étudiée dans un chapitre ultérieur (trigonalisation).
VII. Ce qu’il faut retenir
- Un sous-espace \(F\) est stable par \(u\) si \(u(F) \subset F\) ; une droite est stable si et seulement si elle est engendrée par un vecteur propre.
- \(\lambda\) est valeur propre si et seulement si \(u – \lambda\,\mathrm{id}_E\) n’est pas injectif, et \(E_\lambda(u) = \ker(u – \lambda\,\mathrm{id}_E)\).
- Des sous-espaces propres associés à des valeurs propres distinctes sont en somme directe.
- Le spectre d’une matrice est l’ensemble des racines de \(\chi_A(X) = \det(XI_n – A)\), invariant par similitude.
- Pour toute valeur propre : \(1 \leq\, \dim E_\lambda \leq\, m(\lambda)\).
- \(u\) est diagonalisable si et seulement si \(\sum \dim E_\lambda = n\), si et seulement si \(\chi_u\) est scindé avec \(\dim E_\lambda = m(\lambda)\) pour tout \(\lambda\).
- \(n\) valeurs propres distinctes suffisent pour être diagonalisable.
- Si \(A = PDP^{-1}\), alors \(A^k = PD^kP^{-1}\), et \(X_{n+1} = AX_n\) donne \(X_n = \sum c_j \lambda_j^n V_j\).
- Le système \(X^{\prime} = AX\) a pour solutions \(X(t) = \sum c_j e^{\lambda_j t} V_j\).
Questions fréquentes sur diagonalisation
Quelle différence entre multiplicité algébrique et multiplicité géométrique ?
La multiplicité algébrique m(λ) est l’ordre de λ comme racine du polynôme caractéristique. La multiplicité géométrique est la dimension du sous-espace propre E_λ. On a toujours 1 ≤ dim E_λ ≤ m(λ), et la matrice est diagonalisable exactement quand le polynôme caractéristique est scindé et que ces deux nombres coïncident pour chaque valeur propre.
Une matrice qui a une valeur propre double peut-elle être diagonalisable ?
Oui, à condition que le sous-espace propre associé soit de dimension 2. Par exemple, la matrice identité d’ordre 2 est diagonale avec la valeur propre double 1. En revanche, la matrice triangulaire de diagonale (1, 1) et de coefficient 1 en haut à droite n’est pas diagonalisable, car son sous-espace propre est une droite.
Pourquoi une matrice réelle peut-elle être diagonalisable sur C mais pas sur R ?
Le spectre dépend du corps. Si le polynôme caractéristique a des racines complexes non réelles, il n’est pas scindé sur R, donc la matrice n’est pas diagonalisable sur R. Sur C, il est toujours scindé : si de plus les dimensions des sous-espaces propres sont les bonnes, par exemple si les racines sont simples, la matrice devient diagonalisable.
Faut-il toujours calculer l'inverse de la matrice de passage P ?
Non. Pour une suite X(n+1) = AX(n) ou un système X’ = AX, il suffit de décomposer la condition initiale dans la base de vecteurs propres. On calcule P^(-1) seulement si l’on veut la matrice A^n en entier, ou pour vérifier le résultat par le produit PDP^(-1).
Pour aller plus loin en L2
- Les énoncés : exercices de maths en L2 sur diagonalisation
- Chapitre précédent : Intégrales généralisées
- Chapitre suivant : Polynômes d'endomorphismes et trigonalisation
- Tester vos connaissances : QCM de maths en L2 par chapitre
- Le sommaire : tous les chapitres de maths de L2 et la licence de maths de L1 à L3