Ce chapitre clôt la partie probabilités de la première année de MPSI et de MP2I. Il associe à une variable aléatoire deux indicateurs : l’espérance, qui mesure sa position moyenne, et la variance, qui mesure sa dispersion. Le cours espérance variance sup établit d’abord la linéarité, la formule de transfert et l’espérance d’un produit de variables indépendantes.
Vous verrez ensuite la formule de König-Huygens, les moments des lois de Bernoulli et binomiale, puis la covariance et la variance d’une somme. La méthode des indicatrices permet alors de traiter des variables de comptage sans connaître leur loi.
Enfin, les inégalités de Markov et de Bienaymé-Tchebychev majorent des probabilités à partir de ces seuls indicateurs. Elles mènent à une version quantitative de la loi faible des grands nombres. En seconde année, tout ceci s’étend aux variables discrètes infinies.
Pour vous entraîner ensuite, travaillez les exercices de maths sup sur espérance et variance.
I. Espérance d’une variable aléatoire
Dans tout le chapitre, \((\Omega, P)\) est un espace probabilisé fini. Une variable aléatoire \(X\) sur \(\Omega\) ne prend donc qu’un nombre fini de valeurs. On note \(X(\Omega)\) l’ensemble de ces valeurs. L’espérance résume la loi de \(X\) par un seul nombre : sa valeur moyenne, pondérée par les probabilités.
1. Définition
Soit \(X\) une variable aléatoire réelle ou complexe sur \(\Omega\). On appelle espérance de \(X\) le nombre
\[E(X) = \sum_{x \in X(\Omega)} x \, P(X = x).\]
On a aussi \(E(X) = \sum_{\omega \in \Omega} X(\omega) P(\{\omega\})\). Une variable d’espérance nulle est dite centrée.
Les deux écritures coïncident. En effet, il suffit de regrouper les \(\omega\) selon la valeur \(X(\omega)\) : la somme sur \(\Omega\) se découpe selon le système complet d’événements \((\{X = x\})_{x \in X(\Omega)}\). La seconde écriture est souvent la plus commode pour démontrer des propriétés. En revanche, la première sert pour les calculs pratiques.
Pour une variable complexe \(Z = X + iY\), avec \(X\) et \(Y\) réelles, on obtient \(E(Z) = E(X) + i E(Y)\). Autrement dit, \(\mathrm{Re}(E(Z)) = E(\mathrm{Re}(Z))\) et \(\mathrm{Im}(E(Z)) = E(\mathrm{Im}(Z))\).
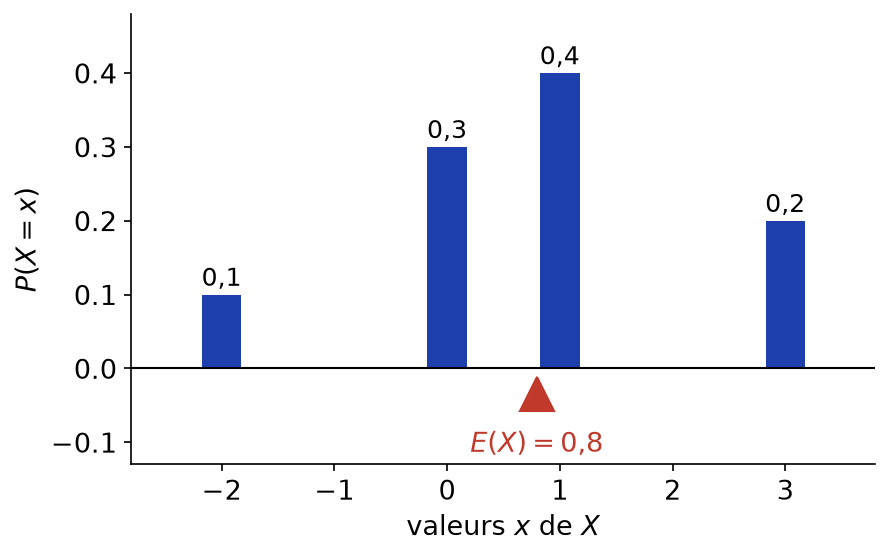
Soit \(X\) de loi \(P(X = -2) = 0{,}1\), \(P(X = 0) = 0{,}3\), \(P(X = 1) = 0{,}4\) et \(P(X = 3) = 0{,}2\). Alors
\[E(X) = -2 \times 0{,}1 + 0 \times 0{,}3 + 1 \times 0{,}4 + 3 \times 0{,}2 = 0{,}8.\]
L’espérance s’interprète comme un centre de gravité. On place une masse \(P(X = x)\) au point d’abscisse \(x\). Le point d’équilibre de la barre est alors \(E(X)\), comme le montre la figure ci-dessous.
2. Premiers exemples
Une variable constante égale à \(a\) a pour espérance \(a\). Ensuite, pour un événement \(A\), l’indicatrice \(\mathbf{1}_A\) vaut \(1\) sur \(A\) et \(0\) ailleurs. Elle suit la loi de Bernoulli de paramètre \(P(A)\), donc \(E(\mathbf{1}_A) = P(A)\). Ce résultat très simple sera l’outil central de la partie II.
Si \(X \sim \mathcal{B}(p)\), alors \(E(X) = p\). Si \(X\) suit la loi uniforme sur \(\{1, \ldots, n\}\), alors \(E(X) = \dfrac{n+1}{2}\).
Pour la loi uniforme, on calcule en effet \(\frac{1}{n} \sum_{k=1}^{n} k = \frac{1}{n} \cdot \frac{n(n+1)}{2}\). Par exemple, le résultat d’un dé équilibré a pour espérance \(7/2\).
II. Propriétés de l’espérance et formule de transfert
1. Linéarité, positivité, croissance
Soient \(X, Y\) deux variables aléatoires réelles ou complexes sur \(\Omega\) et \(\lambda, \mu\) deux scalaires.
- Linéarité : \(E(\lambda X + \mu Y) = \lambda E(X) + \mu E(Y)\).
- Positivité : si \(X\) est réelle et \(X \geq\, 0\), alors \(E(X) \geq\, 0\).
- Croissance : si \(X\) et \(Y\) sont réelles et \(X \leq\, Y\), alors \(E(X) \leq\, E(Y)\).
- Inégalité triangulaire : \(|E(X)| \leq\, E(|X|)\).
On utilise l’écriture sur \(\Omega\). D’abord, \(E(\lambda X + \mu Y) = \sum_{\omega} (\lambda X(\omega) + \mu Y(\omega)) P(\{\omega\})\), qui se sépare en deux sommes. Ensuite, si \(X \geq\, 0\), tous les termes \(X(\omega) P(\{\omega\})\) sont positifs. La croissance s’obtient en appliquant la positivité à \(Y – X\) puis la linéarité. Enfin, l’inégalité triangulaire pour une somme finie donne \(|\sum_\omega X(\omega) P(\{\omega\})| \leq\, \sum_\omega |X(\omega)| P(\{\omega\})\).
La linéarité est remarquable : elle ne demande aucune indépendance. C’est pourquoi elle permet de calculer des espérances sans connaître la loi de la variable étudiée.
Pour calculer l’espérance d’une variable \(N\) qui compte des objets, on l’écrit comme une somme d’indicatrices : \(N = \sum_{i=1}^{n} \mathbf{1}_{A_i}\), où \(A_i\) est l’événement « le \(i\)-ième objet est compté ». Par linéarité, \(E(N) = \sum_{i=1}^{n} P(A_i)\). On n’a besoin ni de la loi de \(N\), ni de l’indépendance des \(A_i\).
On range au hasard \(n\) lettres dans \(n\) enveloppes. Soit \(N\) le nombre de lettres dans la bonne enveloppe. L’événement \(A_i\) « la lettre \(i\) est bien placée » a pour probabilité \(\frac{(n-1)!}{n!} = \frac{1}{n}\). Donc \(E(N) = n \times \frac{1}{n} = 1\), quel que soit \(n\).
2. Formule de transfert
On veut souvent l’espérance de \(f(X)\), où \(f\) est une fonction. Il serait coûteux de déterminer d’abord la loi de \(f(X)\). Heureusement, la formule de transfert permet d’éviter ce détour.
Formule de transfert. Soient \(X\) une variable aléatoire à valeurs dans un ensemble \(E\) et \(f : E \to \mathbb{C}\). Alors
\[E(f(X)) = \sum_{x \in X(\Omega)} f(x) \, P(X = x).\]
On part de l’écriture sur \(\Omega\) et on regroupe les \(\omega\) selon la valeur de \(X(\omega)\) :
\[E(f(X)) = \sum_{x \in X(\Omega)} \sum_{\omega \in \{X = x\}} f(x) P(\{\omega\}) = \sum_{x \in X(\Omega)} f(x) P(X = x).\]
La formule s’applique aussi à un couple. Ainsi, pour un couple \((X, Y)\), on a \(E(g(X, Y)) = \sum_{(x, y)} g(x, y) P(X = x, Y = y)\). Il suffit en effet de voir \((X, Y)\) comme une seule variable à valeurs dans un produit.
Avec la loi de l’exemple de la partie I, on obtient directement
\[E(X^2) = 4 \times 0{,}1 + 0 \times 0{,}3 + 1 \times 0{,}4 + 9 \times 0{,}2 = 2{,}6.\]
On n’a pas eu besoin de la loi de \(X^2\).
En général, \(E(f(X)) \neq f(E(X))\). Par exemple, ci-dessus, \(E(X^2) = 2{,}6\) alors que \(E(X)^2 = 0{,}64\). L’égalité n’est garantie que pour \(f\) affine, par linéarité.
3. Espérance d’un produit de variables indépendantes
Si \(X\) et \(Y\) sont deux variables aléatoires indépendantes, réelles ou complexes, alors \(E(XY) = E(X) E(Y)\). Plus généralement, si \(X_1, \ldots, X_n\) sont mutuellement indépendantes, alors \(E(X_1 \cdots X_n) = E(X_1) \cdots E(X_n)\).
Par la formule de transfert appliquée au couple, puis par indépendance :
\[E(XY) = \sum_{(x, y)} x y \, P(X = x) P(Y = y) = \Big(\sum_{x} x P(X = x)\Big) \Big(\sum_{y} y P(Y = y)\Big).\]
Le cas de \(n\) variables s’obtient par récurrence, grâce au lemme des coalitions : \(X_1 \cdots X_{n-1}\) est indépendante de \(X_n\).
La réciproque est fausse. Par exemple, si \(X\) suit la loi uniforme sur \(\{-1, 0, 1\}\) et \(Y = X^2\), alors \(E(XY) = E(X^3) = 0 = E(X) E(Y)\). Cependant, \(P(X = 0, Y = 1) = 0\) alors que \(P(X = 0) P(Y = 1) = 2/9\).
III. Variance et écart type
1. Définitions et formule de König-Huygens
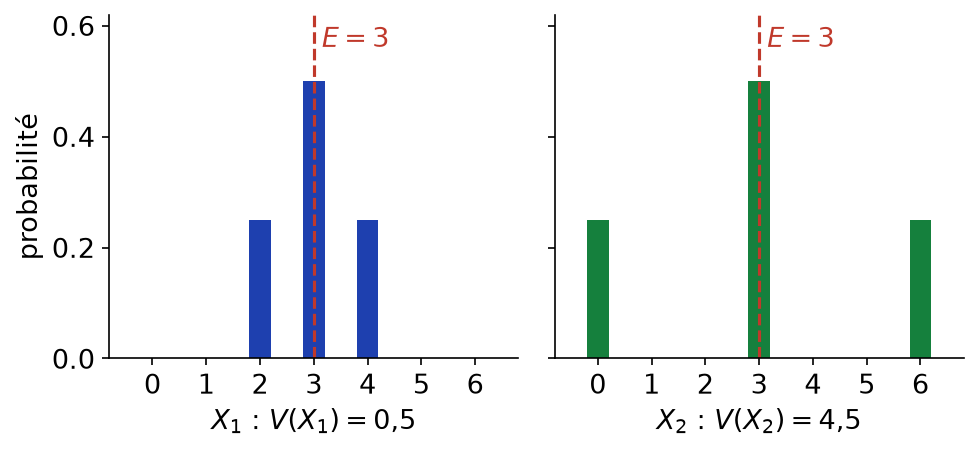
Deux variables peuvent avoir la même espérance et des comportements très différents. La variance mesure la dispersion de \(X\) autour de sa moyenne.
Soit \(X\) une variable aléatoire réelle. Sa variance est \(V(X) = E\big((X – E(X))^2\big)\). Son écart type est \(\sigma(X) = \sqrt{V(X)}\). La variance est positive, par positivité de l’espérance.
Comme le montre la figure ci-dessous, les deux variables \(X_1\) et \(X_2\) ont la même espérance \(3\). Pourtant, \(X_2\) s’écarte beaucoup plus de \(3\) : sa variance est neuf fois plus grande.
Formule de König-Huygens. Pour toute variable aléatoire réelle \(X\), on a \(V(X) = E(X^2) – E(X)^2\).
Notons \(m = E(X)\). On développe le carré puis on applique la linéarité :
\[V(X) = E(X^2 – 2mX + m^2) = E(X^2) – 2m E(X) + m^2 = E(X^2) – m^2.\]
Dans l’exemple de la partie I, on trouve donc \(V(X) = 2{,}6 – 0{,}64 = 1{,}96\), puis \(\sigma(X) = 1{,}4\). De plus, la formule montre que \(E(X)^2 \leq\, E(X^2)\).
2. Transformation affine et variance nulle
Pour tous réels \(a\) et \(b\) : \(V(aX + b) = a^2 V(X)\) et \(\sigma(aX + b) = |a| \sigma(X)\).
De plus, \(V(X) = 0\) si et seulement si \(P(X = E(X)) = 1\) : \(X\) est alors presque sûrement constante.
Par linéarité, \(aX + b – E(aX + b) = a(X – E(X))\). Il suffit alors d’élever au carré et de prendre l’espérance. Pour le second point, \(V(X) = \sum_x (x – m)^2 P(X = x)\) est une somme de termes positifs. Elle est nulle si et seulement si \(P(X = x) = 0\) pour tout \(x \neq m\).
Si \(\sigma(X) > 0\), la variable \(\dfrac{X – E(X)}{\sigma(X)}\) est ainsi d’espérance \(0\) et de variance \(1\). On dit qu’elle est centrée réduite.
3. Lois usuelles
- Si \(X \sim \mathcal{B}(p)\), alors \(E(X) = p\) et \(V(X) = p(1-p)\).
- Si \(X \sim \mathcal{B}(n, p)\), alors \(E(X) = np\) et \(V(X) = np(1-p)\).
- Si \(X\) suit la loi uniforme sur \(\{1, \ldots, n\}\), alors \(E(X) = \dfrac{n+1}{2}\) et \(V(X) = \dfrac{n^2 – 1}{12}\).
Pour la loi de Bernoulli, \(X^2 = X\), donc \(V(X) = p – p^2\). Pour la loi binomiale, on écrit \(X = X_1 + \cdots + X_n\) avec des \(X_i\) indépendantes de loi \(\mathcal{B}(p)\). La linéarité donne alors \(E(X) = np\). La variance sera obtenue dans la partie IV. Pour la loi uniforme, on utilise \(\sum_{k=1}^{n} k^2 = \frac{n(n+1)(2n+1)}{6}\) et la formule de König-Huygens.
Pour le résultat \(D\) d’un dé équilibré, la loi uniforme sur \(\{1, \ldots, 6\}\) donne \(E(D) = \frac{7}{2}\) et \(V(D) = \frac{36 – 1}{12} = \frac{35}{12}\). Par conséquent, \(\sigma(D) \approx 1{,}71\). Ensuite, pour le gain \(G = 10D – 20\) d’un jeu, on obtient \(E(G) = 15\) et \(V(G) = 100 \times \frac{35}{12}\). Autrement dit, l’écart type est multiplié par \(10\), tandis que la translation de \(-20\) ne change rien à la dispersion.
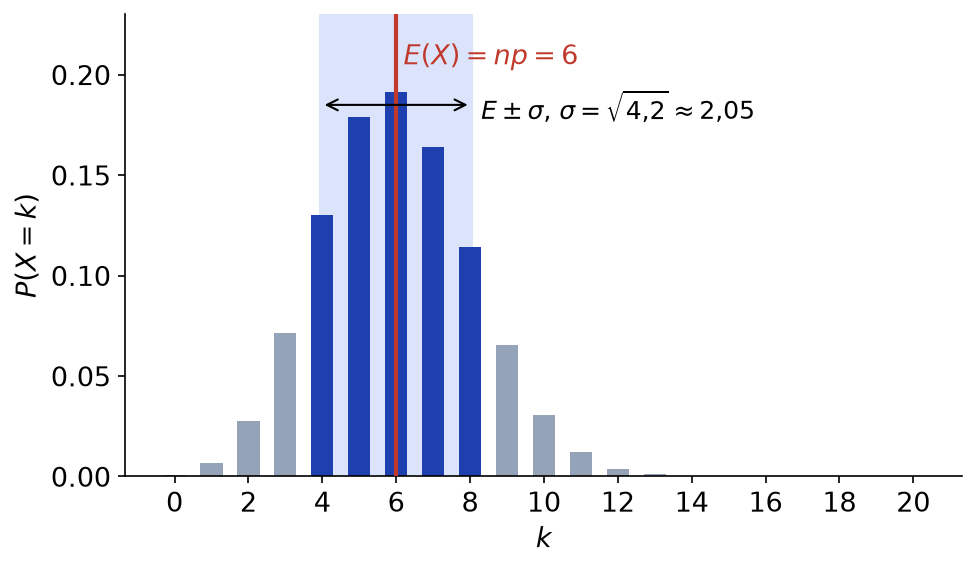
Pour \(X \sim \mathcal{B}(20; 0{,}3)\), on obtient \(E(X) = 6\), \(V(X) = 4{,}2\) et \(\sigma(X) \approx 2{,}05\). Sur la figure ci-dessous, les valeurs de \(X\) situées à moins d’un écart type de la moyenne sont en bleu foncé. Elles concentrent l’essentiel de la probabilité.
IV. Covariance et variance d’une somme
1. Covariance
La covariance de deux variables aléatoires réelles \(X\) et \(Y\) est
\[\mathrm{Cov}(X, Y) = E\big((X – E(X))(Y – E(Y))\big) = E(XY) – E(X) E(Y).\]
Si \(\mathrm{Cov}(X, Y) = 0\), on dit que \(X\) et \(Y\) sont décorrélées.
La seconde expression s’obtient en développant, exactement comme pour König-Huygens. D’ailleurs, \(\mathrm{Cov}(X, X) = V(X)\).
- La covariance est symétrique et bilinéaire, et \(\mathrm{Cov}(X, a) = 0\) pour toute constante \(a\).
- Si \(X\) et \(Y\) sont indépendantes, alors elles sont décorrélées.
- La réciproque est fausse.
Le deuxième point découle de \(E(XY) = E(X)E(Y)\). Le contre-exemple de la partie II, avec \(Y = X^2\), montre le troisième. Par conséquent, une covariance nulle ne prouve jamais l’indépendance. En revanche, une covariance non nulle prouve la dépendance.
2. Variance d’une somme
Pour des variables aléatoires réelles \(X_1, \ldots, X_n\) :
\[V\Big(\sum_{i=1}^{n} X_i\Big) = \sum_{i=1}^{n} V(X_i) + 2 \sum_{1 \leq\, i < j \leq\, n} \mathrm{Cov}(X_i, X_j).\]
En particulier, \(V(X + Y) = V(X) + V(Y) + 2 \mathrm{Cov}(X, Y)\). Si les \(X_i\) sont deux à deux décorrélées, par exemple indépendantes, alors la variance de la somme est la somme des variances.
On a \(V(S) = \mathrm{Cov}(S, S)\) avec \(S = \sum_i X_i\). Par bilinéarité, \(\mathrm{Cov}(S, S) = \sum_{i, j} \mathrm{Cov}(X_i, X_j)\). Les termes diagonaux donnent les variances. Ensuite, les termes \((i, j)\) et \((j, i)\) sont égaux par symétrie, d’où le facteur \(2\).
On lance un dé équilibré. Soit \(X\) l’indicatrice de « le résultat est pair » et \(Y\) celle de « le résultat vaut au moins \(4\) ». Alors \(E(X) = E(Y) = \frac{1}{2}\) et \(V(X) = V(Y) = \frac{1}{4}\). De plus, \(XY\) est l’indicatrice de \(\{4, 6\}\), donc \(E(XY) = \frac{1}{3}\). Ainsi, \(\mathrm{Cov}(X, Y) = \frac{1}{3} – \frac{1}{4} = \frac{1}{12}\). Par conséquent, \(V(X + Y) = \frac{1}{4} + \frac{1}{4} + \frac{1}{6} = \frac{2}{3}\). La covariance positive traduit ici une tendance commune : un grand résultat est plus souvent pair.
Si \(X \sim \mathcal{B}(n, p)\), on écrit \(X = X_1 + \cdots + X_n\) avec des Bernoulli indépendantes. Les covariances sont nulles, donc \(V(X) = n p(1-p)\).
Pour la variance d’une variable de comptage \(N = \sum_{i=1}^{n} \mathbf{1}_{A_i}\) :
- on calcule \(V(\mathbf{1}_{A_i}) = P(A_i)(1 – P(A_i))\) ;
- on calcule, pour \(i \neq j\), \(\mathrm{Cov}(\mathbf{1}_{A_i}, \mathbf{1}_{A_j}) = P(A_i \cap A_j) – P(A_i) P(A_j)\), car \(\mathbf{1}_{A_i} \mathbf{1}_{A_j} = \mathbf{1}_{A_i \cap A_j}\) ;
- on somme avec la formule du théorème, en exploitant les symétries du problème.
Reprenons les \(n\) lettres rangées au hasard, avec \(n \geq\, 2\). Pour \(i \neq j\), \(P(A_i \cap A_j) = \frac{(n-2)!}{n!} = \frac{1}{n(n-1)}\). Chaque covariance vaut donc \(\frac{1}{n(n-1)} – \frac{1}{n^2} = \frac{1}{n^2(n-1)}\). Ainsi, avec \(n(n-1)\) couples ordonnés \((i, j)\),
\[V(N) = n \cdot \frac{1}{n}\Big(1 – \frac{1}{n}\Big) + n(n-1) \cdot \frac{1}{n^2(n-1)} = 1 – \frac{1}{n} + \frac{1}{n} = 1.\]
L’inégalité \(|\mathrm{Cov}(X, Y)| \leq\, \sigma(X) \sigma(Y)\) est vraie. Elle se démontre comme l’inégalité de Cauchy-Schwarz : le polynôme \(\lambda \mapsto V(Y – \lambda X)\) est positif, donc son discriminant est négatif. Le coefficient de corrélation \(\rho = \frac{\mathrm{Cov}(X, Y)}{\sigma(X) \sigma(Y)}\) appartient donc à \([-1, 1]\).
V. Inégalités de Markov et de Bienaymé-Tchebychev
Connaître l’espérance et la variance suffit pour contrôler certaines probabilités. Les deux inégalités suivantes ne demandent aucune information sur la loi exacte. C’est ce qui fait leur force, mais aussi leur faiblesse.
Inégalité de Markov. Soit \(X\) une variable aléatoire réelle positive. Pour tout \(a > 0\),
\[P(X \geq\, a) \leq\, \frac{E(X)}{a}.\]
On compare deux variables. Comme \(X \geq\, 0\), on a \(X \geq\, a \mathbf{1}_{\{X \geq\, a\}}\) en tout point de \(\Omega\). En effet, si \(X(\omega) \geq\, a\), le membre de droite vaut \(a\) ; sinon, il vaut \(0\). Par croissance de l’espérance, \(E(X) \geq\, a P(X \geq\, a)\).
Dans le rangement aléatoire de \(n\) lettres, le nombre \(N\) de lettres bien placées est positif et d’espérance \(1\). Par Markov, \(P(N \geq\, 4) \leq\, \frac{1}{4}\), quel que soit \(n\). Cette borne n’utilise aucune autre information sur la loi de \(N\).
Inégalité de Bienaymé-Tchebychev. Soit \(X\) une variable aléatoire réelle. Pour tout \(\varepsilon > 0\),
\[P\big(|X – E(X)| \geq\, \varepsilon\big) \leq\, \frac{V(X)}{\varepsilon^2}.\]
La variable \(Y = (X – E(X))^2\) est positive et \(E(Y) = V(X)\). De plus, les événements \(\{|X – E(X)| \geq\, \varepsilon\}\) et \(\{Y \geq\, \varepsilon^2\}\) sont égaux. L’inégalité de Markov appliquée à \(Y\) avec \(a = \varepsilon^2\) conclut.
Pour majorer une probabilité :
- pour un événement \(\{X \geq\, a\}\) avec \(X \geq\, 0\) et seulement l’espérance connue, on utilise Markov ;
- pour un écart à la moyenne \(\{|X – m| \geq\, \varepsilon\}\), on utilise Bienaymé-Tchebychev ;
- pour minorer \(P(|X – m| < \varepsilon)\), on passe au complémentaire : \(P(|X – m| < \varepsilon) \geq\, 1 – \frac{V(X)}{\varepsilon^2}\).
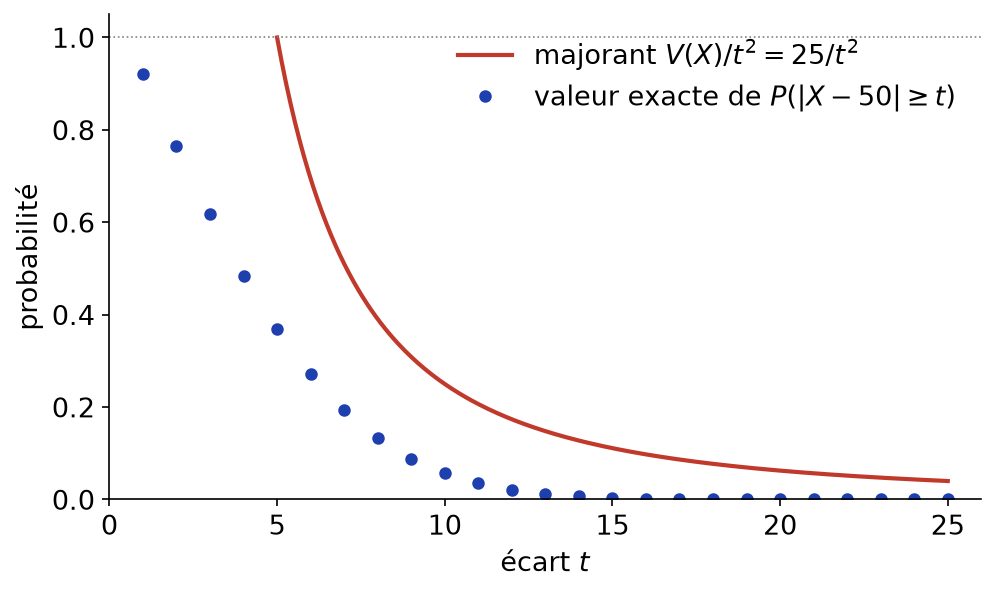
On lance \(100\) fois une pièce équilibrée et \(X\) compte les piles. Alors \(E(X) = 50\) et \(V(X) = 25\). Par Bienaymé-Tchebychev, \(P(|X – 50| \geq\, 10) \leq\, \frac{25}{100} = 0{,}25\). La valeur exacte vaut environ \(0{,}057\).
Le majorant est donc correct, mais assez grossier. La figure ci-dessous compare, pour chaque écart \(t\), la probabilité exacte et le majorant \(25/t^2\). Pour \(t \leq\, 5\), le majorant dépasse \(1\) et n’apporte rien.
VI. Moyenne de variables indépendantes de même loi
1. Moyenne empirique
On répète une même expérience \(n\) fois de façon indépendante. On modélise les résultats par des variables \(X_1, \ldots, X_n\) mutuellement indépendantes, de même loi, d’espérance \(m\) et de variance \(\sigma^2\). On étudie leur moyenne empirique \(M_n = \frac{1}{n}(X_1 + \cdots + X_n)\).
On a \(E(M_n) = m\) et \(V(M_n) = \dfrac{\sigma^2}{n}\). Par conséquent, pour tout \(\varepsilon > 0\),
\[P\big(|M_n – m| \geq\, \varepsilon\big) \leq\, \frac{\sigma^2}{n \varepsilon^2}.\]
La linéarité donne \(E(M_n) = \frac{1}{n} \cdot nm = m\). Ensuite, les \(X_i\) sont indépendantes, donc décorrélées. Ainsi, \(V(M_n) = \frac{1}{n^2} \sum_{i=1}^{n} V(X_i) = \frac{n \sigma^2}{n^2}\). On applique enfin Bienaymé-Tchebychev à \(M_n\).
Cette inégalité est une version non asymptotique de la loi faible des grands nombres. Elle donne une borne explicite pour chaque \(n\), et cette borne tend vers \(0\) quand \(n\) tend vers \(+\infty\). Autrement dit, la moyenne de nombreuses répétitions se concentre autour de l’espérance.
2. Interprétation fréquentiste
Prenons \(X_i = \mathbf{1}_{A_i}\), où \(A_i\) est la réalisation d’un événement de probabilité \(p\) lors de la \(i\)-ième expérience. Alors \(M_n = F_n\) est la fréquence de réalisation, avec \(\sigma^2 = p(1-p) \leq\, \frac{1}{4}\). On obtient donc
\[P\big(|F_n – p| \geq\, \varepsilon\big) \leq\, \frac{p(1-p)}{n \varepsilon^2} \leq\, \frac{1}{4 n \varepsilon^2}.\]
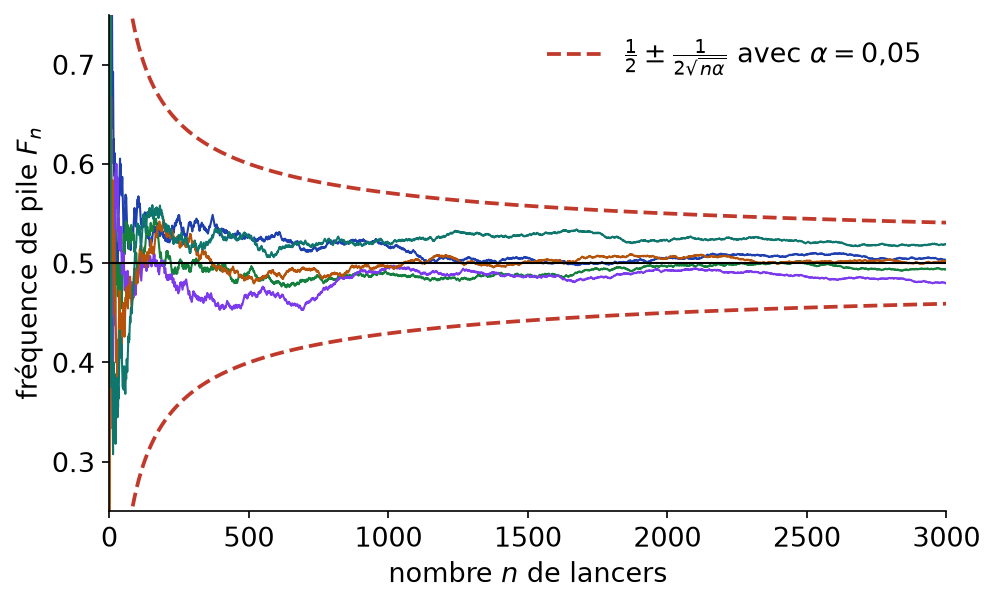
Ce résultat justifie l’interprétation fréquentiste de la probabilité : \(p\) est la valeur autour de laquelle se stabilise la fréquence observée. La figure ci-dessous montre cinq simulations de \(3000\) lancers d’une pièce équilibrée. Les courbes en pointillés délimitent la bande \(\frac{1}{2} \pm \frac{1}{2\sqrt{n\alpha}}\). D’après l’inégalité, \(F_n\) sort de cette bande avec une probabilité au plus \(\alpha = 0{,}05\).
Pour trouver un nombre d’expériences suffisant garantissant \(P(|M_n – m| \geq\, \varepsilon) \leq\, \alpha\) :
- on majore la variance \(\sigma^2\), au besoin par une borne connue, comme \(p(1-p) \leq\, \frac{1}{4}\) ;
- on impose \(\dfrac{\sigma^2}{n \varepsilon^2} \leq\, \alpha\), c’est-à-dire \(n \geq\, \dfrac{\sigma^2}{\alpha \varepsilon^2}\) ;
- on conclut par le plus petit entier convenable.
On veut estimer une proportion \(p\) inconnue à \(0{,}05\) près, avec un risque d’erreur au plus \(0{,}1\). Il suffit que \(\frac{1}{4n \times 0{,}0025} \leq\, 0{,}1\), soit \(n \geq\, 1000\). Diviser la précision par \(2\) multiplie ce nombre par \(4\).
Le nombre obtenu est suffisant, mais rarement nécessaire. En effet, Bienaymé-Tchebychev est une inégalité universelle, donc pessimiste. Des outils plus fins, vus plus tard, réduisent nettement ces tailles d’échantillon.
Ce qu’il faut retenir
- \(E(X) = \sum_x x P(X = x)\), et la formule de transfert donne \(E(f(X)) = \sum_x f(x) P(X = x)\) sans chercher la loi de \(f(X)\).
- L’espérance est linéaire, positive et croissante ; la linéarité ne demande aucune indépendance.
- Une variable de comptage s’écrit comme somme d’indicatrices, et \(E(\mathbf{1}_A) = P(A)\).
- Si \(X\) et \(Y\) sont indépendantes, \(E(XY) = E(X)E(Y)\) ; la réciproque est fausse.
- \(V(X) = E(X^2) – E(X)^2\) et \(V(aX + b) = a^2 V(X)\).
- Bernoulli : \(p\) et \(p(1-p)\) ; binomiale : \(np\) et \(np(1-p)\).
- \(V(X + Y) = V(X) + V(Y) + 2\mathrm{Cov}(X, Y)\) ; indépendantes implique décorrélées, pas l’inverse.
- Markov : \(P(X \geq\, a) \leq\, E(X)/a\) pour \(X \geq\, 0\) ; Bienaymé-Tchebychev : \(P(|X – E(X)| \geq\, \varepsilon) \leq\, V(X)/\varepsilon^2\).
- La moyenne de \(n\) variables indépendantes de même loi vérifie \(V(M_n) = \sigma^2/n\), d’où \(n \geq\, \sigma^2/(\alpha \varepsilon^2)\) expériences suffisent.
Questions fréquentes sur espérance et variance
Faut-il des variables indépendantes pour écrire E(X + Y) = E(X) + E(Y) ?
Non. La linéarité de l’espérance est toujours vraie, sans aucune hypothèse d’indépendance. C’est justement ce qui rend la méthode des indicatrices si efficace. En revanche, l’indépendance sert pour \(E(XY) = E(X)E(Y)\) et pour écrire que la variance d’une somme est la somme des variances.
Une covariance nulle prouve-t-elle l'indépendance ?
Non. L’indépendance implique une covariance nulle, mais la réciproque est fausse. Par exemple, si \(X\) est uniforme sur \(\{-1, 0, 1\}\) et \(Y = X^2\), alors \(\mathrm{Cov}(X, Y) = 0\) alors que \(Y\) est une fonction de \(X\). En revanche, une covariance non nulle prouve que les variables sont dépendantes.
Quand utiliser Markov plutôt que Bienaymé-Tchebychev ?
L’inégalité de Markov demande une variable positive et ne fait intervenir que son espérance. Bienaymé-Tchebychev contrôle un écart à la moyenne et demande la variance. Quand la variance est connue, Bienaymé-Tchebychev donne en général une meilleure borne, en décroissance en \(1/\varepsilon^2\).
Comment déterminer un nombre d'expériences suffisant ?
On applique Bienaymé-Tchebychev à la moyenne \(M_n\) de \(n\) répétitions indépendantes : \(P(|M_n – m| \geq\, \varepsilon) \leq\, \sigma^2/(n\varepsilon^2)\). Il suffit d’imposer que ce majorant soit au plus le risque \(\alpha\), soit \(n \geq\, \sigma^2/(\alpha\varepsilon^2)\). Pour une fréquence, on majore \(\sigma^2 = p(1-p)\) par \(1/4\).
Pour aller plus loin en maths sup
- Les énoncés : exercices de maths sup sur espérance et variance
- À maîtriser avant : Probabilités sur un univers fini et variables aléatoires
- Chapitre précédent : Probabilités sur un univers fini et variables aléatoires
- Chapitre suivant : Espaces préhilbertiens réels
- Le même thème en maths spé : espérance et variance, cours de maths spé
- Tester vos connaissances : QCM de maths sup par chapitre
- Le sommaire : tous les chapitres de maths sup et les chapitres de maths spé