Ce corrigé différentiel L3 rédige entièrement les 23 exercices, comme on l’attend dans une copie de partiel. Chaque différentielle est obtenue en deux temps : on isole le terme linéaire, puis on majore le reste pour prouver qu’il est négligeable. Les théorèmes utilisés sont cités par leur nom, avec leurs hypothèses.
Soyez attentifs à trois pièges. D’abord, l’existence des dérivées directionnelles ne suffit jamais à la différentiabilité. Ensuite, sur un espace de matrices, les produits ne commutent pas. Enfin, l’inégalité des accroissements finis exige un segment inclus dans le domaine.
Des figures accompagnent les solutions : coupes d’une fonction discontinue, point anguleux de la norme infinie, saut de l’argument, sous-niveau convexe et descente de gradient.
Les énoncés se trouvent sur la page exercices de maths en L3 sur calcul différentiel.
Corrigé de l’exercice 1 : Différentielle d’une forme quadratique
- L’application \(B\) est linéaire en \(x\) et en \(y\). De plus, par l’inégalité de Cauchy-Schwarz, \(|B(x,y)| \leq\, \|Ax\|\,\|y\| \leq\, \|A\|\,\|x\|\,\|y\|\) : elle est donc bilinéaire continue. Or \(q(x) = B(x,x)\) est la composée de \(x \mapsto (x,x)\), linéaire, et de \(B\). Par la règle de la chaîne et la différentielle d’une application bilinéaire,
\[ dq(x)(h) = B(x,h) + B(h,x) = \langle Ax, h \rangle + \langle Ah, x \rangle. \]
Enfin, \(\langle Ah, x \rangle = \langle h, {^tAx \rangle\). Ainsi \(dq(x)(h) = \langle (A+{^tA)x, h \rangle\). - Par définition du gradient, \(\nabla q(x) = (A + {^tA)x\), soit \(2Ax\) lorsque \(A\) est symétrique.
- D’une part, \(A + {^tA = \begin{pmatrix} 2 2 \\ 2 6 \end{pmatrix}\), donc \((A+{^tA)(1,-1) = (0,-4)\). D’autre part, \(q(x,y) = x^2 + 2xy + 3y^2\) a pour dérivées partielles \(2x+2y\) et \(2x+6y\). En \((1,-1)\), on retrouve \((0,-4)\). Donc \(\nabla q(1,-1) = (0,-4)\).
- La fonction \(t \mapsto \langle u(t), v(t) \rangle\) est la composée de \(t \mapsto (u(t),v(t))\) et du produit scalaire, bilinéaire. Par conséquent sa dérivée vaut \(\langle u^{\prime}(t), v(t) \rangle + \langle u(t), v^{\prime}(t) \rangle\). Si \(\|u(t)\|^2 = \langle u(t),u(t) \rangle\) est constante, sa dérivée \(2\langle u^{\prime}(t), u(t) \rangle\) est nulle. Donc \(u^{\prime}(t) \perp u(t)\) pour tout \(t\).
Corrigé de l’exercice 2 : Matrice jacobienne d’une application de R² dans R³
- Chaque composante est obtenue par produits et composées de fonctions polynomiales, de l’exponentielle et du sinus. Ses dérivées partielles existent donc et sont continues sur \(\mathbb{R}^2\). D’après le théorème du cours, \(f\) est de classe \(C^1\) sur \(\mathbb{R}^2\).
- On dérive chaque composante par rapport à \(x\), puis à \(y\) :
\[ J_f(x,y) = \begin{pmatrix} 2xy x^2 \\ e^{x-y} -e^{x-y} \\ y\cos(xy) x\cos(xy) \end{pmatrix}. \] - En \((1,1)\), on a \(e^{0} = 1\) et \(\cos(1)\). D’où \(J_f(1,1) = \begin{pmatrix} 2 1 \\ 1 -1 \\ \cos 1 \cos 1 \end{pmatrix}\). Donc \(df(1,1)(h,k) = \big(2h+k,\ h-k,\ (h+k)\cos 1\big)\).
- Posons \(\gamma(t) = (t^2,t)\), de sorte que \(g = f \circ \gamma\). On a \(\gamma(1) = (1,1)\) et \(\gamma^{\prime}(1) = (2,1)\). La règle de la chaîne donne \(g^{\prime}(1) = df(1,1)(2,1) = (5, 1, 3\cos 1)\). Vérifions directement : \(g(t) = \big(t^5, e^{t^2-t}, \sin(t^3)\big)\), donc \(g^{\prime}(t) = \big(5t^4, (2t-1)e^{t^2-t}, 3t^2\cos(t^3)\big)\). En \(t = 1\), \(g^{\prime}(1) = (5,1,3\cos 1)\), comme prévu.
Corrigé de l’exercice 3 : Dérivées directionnelles sans continuité
- On a \((x^2 – |y|)^2 \geq\, 0\), donc \(2x^2|y| \leq\, x^4 + y^2\). Pour \((x,y) \neq (0,0)\), on en déduit \(|f(x,y)| \leq\, \frac{1}{2}\). Ainsi \(f\) est bornée par \(\frac{1}{2}\).
- Pour \(t \neq 0\), \(f(ta,tb) = \dfrac{t^3a^2b}{t^4a^4 + t^2b^2} = \dfrac{t\,a^2b}{t^2a^4+b^2}\). Si \(b \neq 0\), alors \(\dfrac{f(ta,tb)}{t} = \dfrac{a^2b}{t^2a^4 + b^2} \to \dfrac{a^2}{b}\). Si \(b = 0\), alors \(a \neq 0\) et \(f(ta,0) = 0\). Donc \(D_vf(0,0) = \frac{a^2}{b}\) si \(b \neq 0\), et \(D_vf(0,0) = 0\) si \(b = 0\).
- On trouve \(D_{(1,0)}f(0,0) = 0\) et \(D_{(0,1)}f(0,0) = 0\). Si l’application était linéaire, elle serait nulle. Or \(D_{(1,1)}f(0,0) = 1\). L’application \(v \mapsto D_vf(0,0)\) n’est pas linéaire.
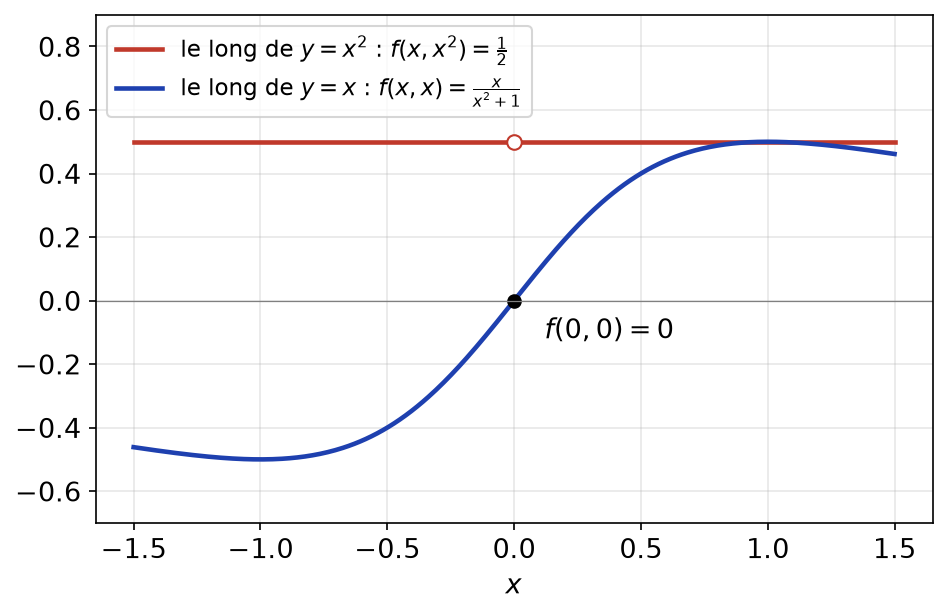
- Pour \(x \neq 0\), \(f(x,x^2) = \dfrac{x^4}{2x^4} = \dfrac{1}{2}\). Quand \(x \to 0\), le point \((x,x^2)\) tend vers l’origine alors que \(f\) reste égale à \(\frac{1}{2} \neq f(0,0)\). La figure ci-dessous compare deux chemins d’approche : le long de la droite \(y=x\), la limite est bien \(0\) ; le long de la parabole, elle vaut \(\frac{1}{2}\). Donc \(f\) n’est pas continue en \((0,0)\), a fortiori pas différentiable. La question 3 donnait déjà la non-différentiabilité.

Point de méthode : pour prouver qu’une fonction n’est pas différentiable, cherchez d’abord une discontinuité le long d’une courbe, puis testez la linéarité de \(v \mapsto D_vf(a)\).
Corrigé de l’exercice 4 : Différentielle de la norme euclidienne
- Posons \(q(x) = \langle x,x \rangle\). D’après l’exercice 1 avec \(A = I_n\), \(dq(x)(h) = 2\langle x,h \rangle\). Sur \(\mathbb{R}^n\setminus\{0\}\), \(q\) est à valeurs dans \(]0,+\infty[\), où la racine carrée est dérivable de dérivée \(\frac{1}{2\sqrt{s}}\). Par la règle de la chaîne, \(N = \sqrt{\cdot} \circ q\) est différentiable et \(dN(x)(h) = \dfrac{2\langle x,h\rangle}{2\sqrt{q(x)}} = \dfrac{\langle x,h\rangle}{\|x\|_2}\).
- Supposons \(N\) différentiable en \(0\). Alors, pour \(h \neq 0\), \(\frac{N(th)-N(0)}{t} = \frac{|t|}{t}\|h\|_2\) aurait une limite quand \(t \to 0\). Or cette quantité vaut \(\|h\|_2\) pour \(t > 0\) et \(-\|h\|_2\) pour \(t < 0\). Donc \(N\) n’est pas différentiable en \(0\).
- Le gradient \(\nabla N(x) = \frac{x}{\|x\|_2}\) est continu sur \(\mathbb{R}^n\setminus\{0\}\) comme quotient de fonctions continues. Ainsi \(N\) est de classe \(C^1\) sur cet ouvert. Ensuite, Cauchy-Schwarz donne \(|dN(x)(h)| \leq\, \|h\|_2\), avec égalité pour \(h = x\). Par conséquent \(\|dN(x)\| = 1\) pour tout \(x \neq 0\).
Corrigé de l’exercice 5 : Différentiabilité de la norme infinie
- Comme \(|x_0| > |y_0| \geq\, 0\), on a \(x_0 \neq 0\). Par continuité, il existe une boule \(V\) centrée en \((x_0,y_0)\) sur laquelle \(|x| > |y|\) et \(x\) a le signe \(\varepsilon\) de \(x_0\). Sur \(V\), \(N_\infty(x,y) = \varepsilon x\), fonction linéaire. Donc \(N_\infty\) est différentiable en \((x_0,y_0)\) et \(dN_\infty(x_0,y_0)(h,k) = \varepsilon h\). Par symétrie, si \(|y_0| > |x_0|\), on trouve \(dN_\infty(x_0,y_0)(h,k) = \mathrm{sgn}(y_0)\,k\).
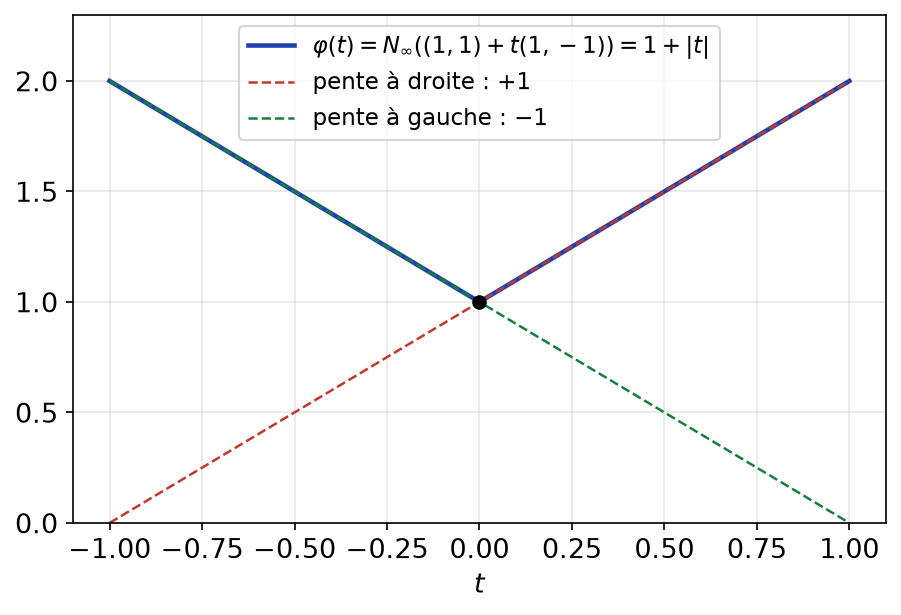
- Pour \(|t|\) assez petit, \(1+th > 0\) et \(1+tk > 0\). Donc \(N_\infty(1+th,1+tk) = 1 + \max(th,tk)\). Si \(t > 0\), \(\max(th,tk) = t\max(h,k)\) ; si \(t < 0\), \(\max(th,tk) = t\min(h,k)\). La limite à droite vaut \(\max(h,k)\) et la limite à gauche vaut \(\min(h,k)\).
- Si \(N_\infty\) était différentiable en \((1,1)\), la dérivée selon \((h,k)\) existerait pour tout vecteur. Or, pour \((h,k) = (1,-1)\), les limites à droite et à gauche valent \(1\) et \(-1\). La figure ci-dessous montre ce point anguleux : \(t \mapsto N_\infty\big((1,1)+t(1,-1)\big) = 1+|t|\). Donc \(N_\infty\) n’est pas différentiable en \((1,1)\).

- En \((0,0)\), \(N_\infty\) est positivement homogène de degré \(1\) : comme pour la norme euclidienne, \(\frac{N_\infty(tv)}{t} = \frac{|t|}{t}N_\infty(v)\) n’a pas de limite. Soit maintenant \((x_0,y_0)\) avec \(|x_0| = |y_0| = a > 0\), et \(\varepsilon, \varepsilon^{\prime}\) les signes de \(x_0\) et \(y_0\). L’application \(S(x,y) = (\varepsilon x, \varepsilon^{\prime} y)\) est une isométrie linéaire pour \(N_\infty\), et \((x_0,y_0) = a\,S(1,1)\). Ainsi \(N_\infty\big((x_0,y_0)+tw\big) = a\,N_\infty\big((1,1)+\frac{t}{a}S(w)\big)\). La question 3 montre alors l’absence de différentiabilité. L’ensemble cherché est \(\{(x,y) : |x| \neq |y|\}\).
Corrigé de l’exercice 6 : Puissances et trace sur un espace de matrices
- Pour \(p = 1\), \(f_1 = \mathrm{id}\) et \(df_1(M)(H) = H\), ce qui correspond à la formule. Supposons le résultat vrai au rang \(p\). On a \(f_{p+1}(M) = P\big(M, f_p(M)\big)\), où \(P(X,Y) = XY\) est bilinéaire continue, car \(\|XY\| \leq\, \|X\|\,\|Y\|\). Par la règle de dérivation d’un produit,
\[ df_{p+1}(M)(H) = HM^p + M\,df_p(M)(H) = HM^p + \sum_{i=0}^{p-1} M^{i+1}HM^{p-1-i}. \]
En posant \(j = i+1\), on obtient \(df_{p+1}(M)(H) = \sum_{j=0}^{p} M^jHM^{p-j}\), ce qui achève la récurrence. - La trace est linéaire, donc \(dg_p(M) = \mathrm{tr} \circ df_p(M)\). De plus, \(\mathrm{tr}(XY) = \mathrm{tr}(YX)\) donne \(\mathrm{tr}(M^iHM^{p-1-i}) = \mathrm{tr}(M^{p-1-i}M^iH) = \mathrm{tr}(M^{p-1}H)\). Les \(p\) termes sont égaux. Donc \(dg_p(M)(H) = p\,\mathrm{tr}(M^{p-1}H)\).
- On cherche \(G\) telle que \(\mathrm{tr}({^tGH) = p\,\mathrm{tr}(M^{p-1}H)\) pour tout \(H\). Il suffit de prendre \({^tG = pM^{p-1}\). Ainsi \(\nabla g_p(M) = p\,{^t(M^{p-1})\).
- On calcule \(MH = \begin{pmatrix} 1 0 \\ 1 0 \end{pmatrix}\) et \(HM = \begin{pmatrix} 0 0 \\ 1 1 \end{pmatrix}\). Donc \(df_2(M)(H) = \begin{pmatrix} 1 0 \\ 2 1 \end{pmatrix}\), alors que \(2MH = \begin{pmatrix} 2 0 \\ 2 0 \end{pmatrix}\). Les deux diffèrent, car \(M\) et \(H\) ne commutent pas.
Corrigé de l’exercice 7 : Différentielle de l’inversion matricielle
- Le déterminant est une fonction polynomiale des coefficients, donc continue. Or \(GL_n(\mathbb{R}) = \det^{-1}(\mathbb{R}^*)\) est l’image réciproque d’un ouvert. C’est donc un ouvert.
- Comme \(\|H^k\| \leq\, \|H\|^k\) et \(\|H\| < 1\), la série \(\sum_k (-H)^k\) converge absolument dans l’espace complet \(\mathcal{M}_n(\mathbb{R})\). Notons \(S\) sa somme. Par télescopage, \((I_n+H)\sum_{k=0}^{N}(-H)^k = I_n – (-H)^{N+1} \to I_n\). Donc \((I_n+H)S = I_n\), et de même \(S(I_n+H) = I_n\). Ensuite, \(R(H) = \sum_{k \geq\, 2}(-H)^k\) vérifie \(\|R(H)\| \leq\, \sum_{k \geq\, 2}\|H\|^k\). Ainsi \(\|R(H)\| \leq\, \frac{\|H\|^2}{1-\|H\|}\).
- Soit \(M \in GL_n(\mathbb{R})\) et \(\|H\| < \frac{1}{\|M^{-1}\|}\). Alors \(\|M^{-1}H\| < 1\) et \(M + H = M(I_n + M^{-1}H)\) est inversible. De plus,
\[ (M+H)^{-1} = (I_n+M^{-1}H)^{-1}M^{-1} = M^{-1} – M^{-1}HM^{-1} + R(M^{-1}H)M^{-1}. \]
Le reste est majoré par \(\dfrac{\|M^{-1}\|^3\|H\|^2}{1 – \|M^{-1}\|\,\|H\|}\), qui est un \(o(\|H\|)\). Enfin, \(H \mapsto -M^{-1}HM^{-1}\) est linéaire, donc continue en dimension finie. Donc \(d\iota(M)(H) = -M^{-1}HM^{-1}\). - On a \(d\iota = \Phi \circ \iota\), où \(\Phi(A) = \big(H \mapsto -AHA\big)\). Or \(AHA – BHB = (A-B)HA + BH(A-B)\), donc \(\|\Phi(A)-\Phi(B)\| \leq\, \|A-B\|\,(\|A\|+\|B\|)\). Ainsi \(\Phi\) est continue. Par ailleurs \(\iota\) est continue, car différentiable. Par composition, \(d\iota\) est continue : \(\iota\) est de classe \(C^1\).
- Première méthode : \(A(t)^{-1} = \dfrac{1}{1-t^2}\begin{pmatrix} 1 -t \\ -t 1 \end{pmatrix}\), dont la dérivée en \(0\) vaut \(\begin{pmatrix} 0 -1 \\ -1 0 \end{pmatrix}\). Seconde méthode : par la règle de la chaîne, la dérivée vaut \(d\iota(A(0))\big(A^{\prime}(0)\big) = -A^{\prime}(0)\), puisque \(A(0) = I_2\). Les deux méthodes donnent \(\begin{pmatrix} 0 -1 \\ -1 0 \end{pmatrix}\).
Corrigé de l’exercice 8 : Différentielle du déterminant
- Le déterminant est une fonction polynomiale des \(n^2\) coefficients. Ses dérivées partielles sont donc polynomiales, en particulier continues. Ainsi \(\det\) est de classe \(C^1\).
- Par définition, \(\det(I_n + tH) = \sum_{\sigma \in \mathfrak{S}_n} \varepsilon(\sigma) \prod_{i=1}^n \big(\delta_{\sigma(i)i} + t\,h_{\sigma(i)i}\big)\). Si \(\sigma \neq \mathrm{id}\), au moins deux indices vérifient \(\sigma(i) \neq i\) ; le produit correspondant est alors un \(O(t^2)\). Pour \(\sigma = \mathrm{id}\), le produit vaut \(\prod_i (1 + t\,h_{ii}) = 1 + t\,\mathrm{tr}(H) + O(t^2)\). Ainsi la dérivée de \(\det\) en \(I_n\) selon \(H\) vaut \(\mathrm{tr}(H)\). Comme \(\det\) est différentiable, cette dérivée est \(d\det(I_n)(H)\). Donc \(d\det(I_n)(H) = \mathrm{tr}(H)\).
- Pour \(M\) inversible, \(\det(M+H) = \det(M)\det(I_n + M^{-1}H)\). L’application \(H \mapsto M^{-1}H\) est linéaire. Par la règle de la chaîne, \(d\det(M)(H) = \det(M)\,\mathrm{tr}(M^{-1}H)\). Enfin, \(M^{-1} = \frac{1}{\det M}\,{^t\mathrm{com}(M)\). D’où \(d\det(M)(H) = \mathrm{tr}\big({^t\mathrm{com}(M)H\big)\).
- Fixons \(H\). Les applications \(M \mapsto d\det(M)(H)\) et \(M \mapsto \mathrm{tr}\big({^t\mathrm{com}(M)H\big)\) sont continues : la première parce que \(\det\) est \(C^1\), la seconde parce qu’elle est polynomiale. Elles coïncident sur \(GL_n(\mathbb{R})\), qui est dense dans \(\mathcal{M}_n(\mathbb{R})\) : en effet, \(M – \frac{1}{p}I_n\) est inversible pour \(p\) assez grand. Par densité, la formule vaut pour toute matrice \(M\).
- Soit \(M = \begin{pmatrix} a b \\ c d \end{pmatrix}\). On a \(\det(M+H) = (a+h_{11})(d+h_{22}) – (b+h_{12})(c+h_{21})\), dont la partie linéaire en \(H\) est \(d\,h_{11} + a\,h_{22} – c\,h_{12} – b\,h_{21}\). Par ailleurs, \({^t\mathrm{com}(M) = \begin{pmatrix} d -b \\ -c a \end{pmatrix}\), et la trace de \({^t\mathrm{com}(M)H\) vaut \(d\,h_{11} – b\,h_{21} – c\,h_{12} + a\,h_{22}\). Les deux expressions coïncident.
Corrigé de l’exercice 9 : Dérivées partielles en coordonnées polaires
- On a \(F = f \circ \Phi\), avec \(\Phi(r,\theta) = (r\cos\theta, r\sin\theta)\). La jacobienne de \(\Phi\) vaut \(\begin{pmatrix} \cos\theta -r\sin\theta \\ \sin\theta r\cos\theta \end{pmatrix}\). La règle de la chaîne donne donc \(\partial_rF = \cos\theta\,\partial_1f + \sin\theta\,\partial_2f\) et \(\partial_\theta F = -r\sin\theta\,\partial_1f + r\cos\theta\,\partial_2f\).
- Notons \(a = \partial_1f\), \(b = \partial_2f\), \(c = \cos\theta\) et \(s = \sin\theta\). Alors \((\partial_rF)^2 + \frac{1}{r^2}(\partial_\theta F)^2 = (ca+sb)^2 + (-sa+cb)^2\). Les doubles produits \(2csab\) et \(-2csab\) s’annulent. Il reste \((c^2+s^2)(a^2+b^2)\). Donc l’expression vaut \(a^2+b^2 = \|\nabla f\|^2\).
- Pour \(f(x,y) = x^2-y^2\), on a \(F(r,\theta) = r^2\cos 2\theta\). Directement, \(\partial_rF = 2r\cos 2\theta\) et \(\partial_\theta F = -2r^2\sin 2\theta\). Avec les formules : \(\partial_rF = \cos\theta \cdot 2r\cos\theta + \sin\theta\cdot(-2r\sin\theta) = 2r\cos 2\theta\). De même, \(\partial_\theta F = -r\sin\theta\cdot 2r\cos\theta + r\cos\theta\cdot(-2r\sin\theta) = -2r^2\sin 2\theta\). Les résultats concordent.
- En \((x,y) = (r\cos\theta, r\sin\theta)\), on a \(\partial_\theta F = x\,\partial_2f – y\,\partial_1f = 0\). Pour \(r > 0\) fixé, \(\theta \mapsto F(r,\theta)\) a une dérivée nulle sur l’intervalle \(\mathbb{R}\) : elle est constante. Donc \(f(r\cos\theta, r\sin\theta) = f(r,0)\) pour tout \(\theta\). Ainsi \(f(x,y) = f\big(\sqrt{x^2+y^2},0\big)\) ne dépend que de \(\sqrt{x^2+y^2}\).
Corrigé de l’exercice 10 : Fonctionnelles intégrales sur C([0,1])
- On développe : \(\varphi(u+h) – \varphi(u) = 2\int_0^1 uh + \int_0^1 h^2\). La forme \(L_u(h) = 2\int_0^1 uh\) est linéaire et \(|L_u(h)| \leq\, 2\|u\|_\infty\|h\|_\infty\) : elle est continue. Le reste vérifie \(0 \leq\, \int_0^1 h^2 \leq\, \|h\|_\infty^2 = o(\|h\|_\infty)\). Donc \(d\varphi(u) = L_u\). Ensuite, \(|(L_u – L_v)(h)| \leq\, 2\|u-v\|_\infty\|h\|_\infty\), soit \(\|d\varphi(u)-d\varphi(v)\| \leq\, 2\|u-v\|_\infty\). Ainsi \(d\varphi\) est lipschitzienne, et \(\varphi\) est de classe \(C^1\).
- La formule de Taylor-Lagrange à l’ordre \(2\) pour le sinus donne \(\sin(a+b) = \sin a + b\cos a – \frac{b^2}{2}\sin c\) pour un certain réel \(c\). Comme \(|\sin c| \leq\, 1\), l’inégalité suit. Appliquons-la avec \(a = u(t)\) et \(b = h(t)\), puis intégrons :
\[ \Big|\psi(u+h) – \psi(u) – \int_0^1 \cos\big(u(t)\big)h(t)\,dt\Big| \leq\, \frac{1}{2}\int_0^1 h^2 \leq\, \frac{\|h\|_\infty^2}{2}. \]
La forme \(h \mapsto \int_0^1 \cos(u)h\) est linéaire, de norme au plus \(1\). Donc \(\psi\) est différentiable et \(d\psi(u)(h) = \int_0^1 \cos\big(u(t)\big)h(t)\,dt\). - Le cosinus est \(1\)-lipschitzien, donc \(|\cos u(t) – \cos v(t)| \leq\, \|u-v\|_\infty\). Par conséquent, \(|(d\psi(u) – d\psi(v))(h)| \leq\, \|u-v\|_\infty\|h\|_\infty\). Ainsi \(\|d\psi(u)-d\psi(v)\| \leq\, \|u-v\|_\infty\) et \(\psi\) est de classe \(C^1\).
- Comme \(\cos\frac{\pi}{2} = 0\), \(d\psi(u_0) = 0\) : \(u_0\) est un point critique. Ce n’est pas un hasard. En effet, \(\psi(u) \leq\, 1 = \psi(u_0)\) pour tout \(u\), donc \(u_0\) réalise le maximum global de \(\psi\).
- Supposons \(\varphi\) différentiable en \(u\) pour \(\|\cdot\|_1\), de différentielle \(L\). Alors \(L(h)\) est la dérivée de \(\varphi\) selon \(h\), qui vaut \(\lim_{t \to 0}\frac{\varphi(u+th)-\varphi(u)}{t} = 2\int_0^1 uh\). Le reste vaut donc \(\int_0^1 h^2\), et il devrait être un \(o(\|h\|_1)\). Prenons \(h_n(t) = \max(0, 1-nt)\). On calcule \(\|h_n\|_1 = \frac{1}{2n}\) et \(\int_0^1 h_n^2 = \frac{1}{3n}\). Le rapport vaut \(\frac{2}{3}\) et ne tend pas vers \(0\), alors que \(\|h_n\|_1 \to 0\). Donc \(\varphi\) n’est différentiable en aucun point pour la norme \(\|\cdot\|_1\).
Point de méthode : en dimension infinie, la différentiabilité dépend de la norme ; le candidat différentielle se lit toujours sur les dérivées directionnelles.
Corrigé de l’exercice 11 : Différentiable mais pas de classe C¹
- Sur l’ouvert \(\mathbb{R}^2\setminus\{(0,0)\}\), la fonction \(r\) est de classe \(C^1\) et strictement positive, avec \(\partial_1 r = \frac{x}{r}\). Par composition et produit, \(g\) y est de classe \(C^1\). De plus,
\[ \partial_1g(x,y) = 2x\sin\frac{1}{r} + r^2\cos\frac{1}{r}\cdot\Big(-\frac{1}{r^2}\Big)\frac{x}{r}. \]
Ainsi \(\partial_1g(x,y) = 2x\sin\frac{1}{r} – \frac{x}{r}\cos\frac{1}{r}\). - Pour \((h,k) \neq (0,0)\), on a \(|g(h,k)| \leq\, h^2+k^2 = \|(h,k)\|_2^2\), qui est un \(o(\|(h,k)\|_2)\). Autrement dit, \(g(h,k) = g(0,0) + 0 + o(\|(h,k)\|)\). Donc \(g\) est différentiable en \((0,0)\) et \(dg(0,0) = 0\).
- Pour \(x > 0\), \(r = x\) et \(\partial_1g(x,0) = 2x\sin\frac{1}{x} – \cos\frac{1}{x}\). Pour \(x_k = \frac{1}{2k\pi}\), on obtient \(-1\) ; pour \(x^{\prime}_k = \frac{1}{(2k+1)\pi}\), on obtient \(1\). Les deux suites tendent vers \(0\). Donc \(\partial_1g(x,0)\) n’a pas de limite en \(0^+\).
- D’après les questions 1 et 2, \(g\) est différentiable en tout point. Si \(g\) était \(C^1\), alors \(\partial_1g\) serait continue en \((0,0)\) et tendrait vers \(\partial_1g(0,0) = 0\). La question 3 l’interdit. Donc \(g\) est différentiable sur \(\mathbb{R}^2\) sans être de classe \(C^1\).
Corrigé de l’exercice 12 : Une application contractante du plan
- Notons \(c = \cos(x+y)\) et \(s = \sin(x-y)\). On a \(\partial_x\cos(x-y) = -s\) et \(\partial_y\cos(x-y) = s\). Donc \(J = \frac{1}{3}\begin{pmatrix} c c \\ -s s \end{pmatrix}\).
- On calcule \({^tJJ = \frac{1}{9}\begin{pmatrix} c^2+s^2 c^2-s^2 \\ c^2-s^2 c^2+s^2 \end{pmatrix}\). Cette matrice symétrique admet les vecteurs propres \((1,1)\) et \((1,-1)\), de valeurs propres \(\frac{2c^2}{9}\) et \(\frac{2s^2}{9}\). Or la norme subordonnée euclidienne de \(J\) est la racine de la plus grande valeur propre de \({^tJJ\). Donc \(\|dF(x,y)\| = \frac{\sqrt{2}}{3}\max(|c|,|s|) \leq\, \frac{\sqrt{2}}{3}\).
- L’ouvert \(\mathbb{R}^2\) est convexe et \(F\) est de classe \(C^1\). L’inégalité des accroissements finis donne \(\|F(X)-F(Y)\| \leq\, \frac{\sqrt{2}}{3}\|X-Y\|\). Ainsi \(F\) est \(\frac{\sqrt{2}}{3}\)-lipschitzienne.
- Comme \(\frac{\sqrt{2}}{3} < 1\), \(F\) est contractante sur l’espace complet \(\mathbb{R}^2\). Le théorème du point fixe de Picard fournit un unique point fixe, c’est-à-dire une unique solution du système. Enfin, un point fixe vérifie \(|x| = \frac{1}{3}|\sin(x+y)| \leq\, \frac{1}{3}\), et de même pour \(y\). L’unique solution appartient donc à \([-\frac{1}{3},\frac{1}{3}]^2\).
Corrigé de l’exercice 13 : Accroissements finis sur un ouvert non convexe
- La relation \(y\cos\theta = x\sin\theta\) découle de \(x = r\cos\theta\) et \(y = r\sin\theta\). Dérivons-la par rapport à \(x\) : \(-y\sin\theta\,\partial_x\theta = \sin\theta + x\cos\theta\,\partial_x\theta\). Donc \(-(x\cos\theta + y\sin\theta)\,\partial_x\theta = \sin\theta\). Or \(x\cos\theta + y\sin\theta = r\). Ainsi \(\partial_x\theta = -\frac{\sin\theta}{r} = -\frac{y}{r^2}\). Par rapport à \(y\), on obtient de même \(\cos\theta = r\,\partial_y\theta\). Donc \(\nabla\theta = \big(-\frac{y}{r^2}, \frac{x}{r^2}\big)\).
- La norme de \(d\theta(x,y)\) pour la norme euclidienne est celle du gradient, soit \(\frac{\sqrt{x^2+y^2}}{r^2} = \frac{1}{r}\). Comme \(r > 1\) sur \(U\), on a \(\|d\theta\| < 1\).
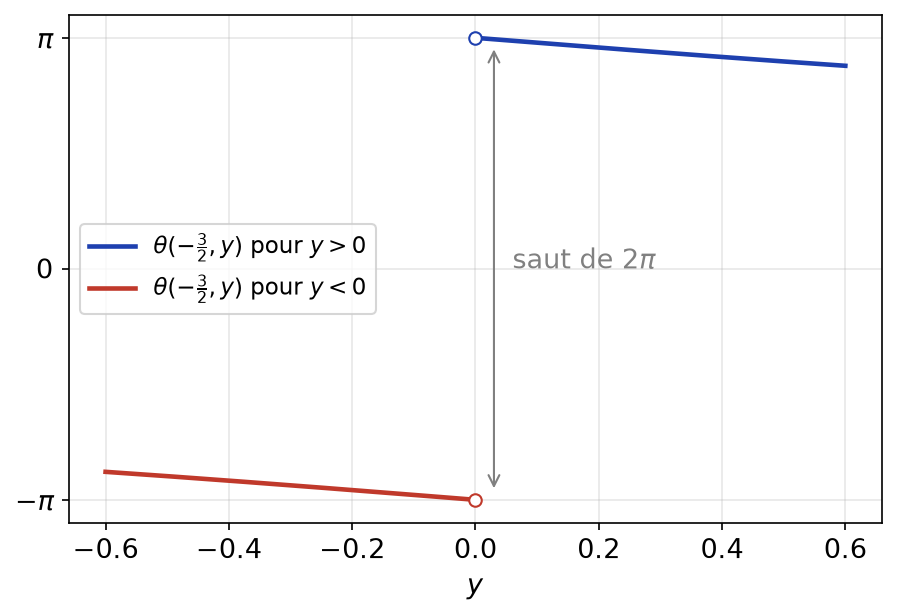
- Le point \(A_\varepsilon\) est dans le demi-plan \(y > 0\), à gauche. Son argument vaut \(\pi – \arctan\frac{2\varepsilon}{3}\). Par symétrie, \(\theta(B_\varepsilon) = -\pi + \arctan\frac{2\varepsilon}{3}\). Par conséquent, \(\theta(A_\varepsilon) – \theta(B_\varepsilon) = 2\pi – 2\arctan\frac{2\varepsilon}{3} \to 2\pi\). Pourtant, la distance \(\|A_\varepsilon – B_\varepsilon\| = 2\varepsilon\) est inférieure à \(1\). La figure ci-dessous montre ce saut de \(2\pi\) de part et d’autre de la coupure. La fonction \(\theta\) n’est donc pas \(1\)-lipschitzienne sur \(U\).

- L’inégalité des accroissements finis exige que le segment \([A_\varepsilon, B_\varepsilon]\) soit inclus dans \(U\). Or il traverse la coupure au point \((-\frac{3}{2},0)\), qui n’est pas dans \(U\). Il n’y a donc aucune contradiction. En revanche, une boule ouverte incluse dans \(U\) est convexe, et \(\|d\theta\| \leq\, 1\) sur celle-ci. Par l’inégalité des accroissements finis, \(\theta\) est \(1\)-lipschitzienne sur toute boule incluse dans \(U\).
Corrigé de l’exercice 14 : Différentielle nulle et connexité
- Prenons \(U = \{(x,y) : x \neq 0\}\), réunion de deux demi-plans ouverts disjoints. La fonction \(f\) égale à \(1\) si \(x > 0\) et à \(0\) si \(x < 0\) est localement constante. Elle est donc \(C^1\), de différentielle nulle, mais non constante : l’ouvert \(U\) n’est pas connexe.
- Soient \((x,y)\) et \((x^{\prime},y)\) dans \(U\). Par convexité, le segment horizontal qui les joint est inclus dans \(U\). La fonction \(g(t) = f(t,y)\) est dérivable sur l’intervalle d’extrémités \(x\) et \(x^{\prime}\), de dérivée \(\partial_1f(t,y) = 0\). Elle y est donc constante. Ainsi \(f(x,y) = f(x^{\prime},y)\).
- Soit \(\eta(y) = y^2\) pour \(y > 0\) et \(\eta(y) = 0\) sinon ; cette fonction est de classe \(C^1\) sur \(\mathbb{R}\), avec \(\eta^{\prime}(0) = 0\). Sur le demi-plan \(x > 0\), \(f(x,y) = \eta(y)\) ; sur \(x < 0\), \(f = 0\). Enfin, un point \((0,y)\) de \(U\) vérifie \(y < 0\) : il possède un voisinage inclus dans \(\{y < 0\}\), sur lequel \(f = 0\). Donc \(f\) est \(C^1\) sur \(U\) et \(\partial_1f = 0\). Pourtant, \(f(1,1) = 1\) et \(f(-1,1) = 0\). La conclusion de la question 2 tombe en défaut, car \(U\) n’est pas convexe.
- Fixons \(x\) et posons \(g(t) = f(tx)\). Pour \(t \neq 0\), \(g^{\prime}(t) = df(tx)(x) = \frac{1}{t}\,df(tx)(tx) = 0\). Ainsi \(g\) est constante sur \(]0,+\infty[\) et sur \(]-\infty,0[\). Comme \(g\) est continue en \(0\), ces deux constantes valent \(g(0) = f(0)\). Donc \(f(x) = g(1) = f(0)\) : \(f\) est constante.
Corrigé de l’exercice 15 : Formule de Taylor à l’ordre 2 pour un polynôme
- On a \(\partial_1 f = 3x^2-3y\) et \(\partial_2 f = 3y^2-3x\). Donc \(\nabla f(x,y) = (3x^2-3y,\ 3y^2-3x)\) et \(H_f(x,y) = \begin{pmatrix} 6x -3 \\ -3 6y \end{pmatrix}\).
- Les points critiques vérifient \(y = x^2\) et \(x = y^2\). Donc \(x = x^4\), soit \(x = 0\) ou \(x = 1\). Les points critiques sont \((0,0)\) et \((1,1)\).
- En \((1,1)\), \(f(1,1) = -1\), le gradient est nul et \(H_f(1,1) = \begin{pmatrix} 6 -3 \\ -3 6 \end{pmatrix}\). La formule de Taylor-Young s’écrit \(f(1+h,1+k) = -1 + \frac{1}{2}(6h^2 – 6hk + 6k^2) + o(h^2+k^2)\). Vérifions par un développement exact :
\[ \begin{aligned} f(1+h,1+k) = (1+h)^3 + (1+k)^3 – 3(1+h)(1+k) \\ = -1 + 3h^2 + 3k^2 – 3hk + h^3 + k^3. \end{aligned} \]
Ainsi \(f(1+h,1+k) = -1 + 3(h^2-hk+k^2) + h^3 + k^3\) : le reste est exactement \(h^3+k^3\). - On a \(h^2 – hk + k^2 – \frac{1}{2}(h^2+k^2) = \frac{1}{2}(h-k)^2 \geq\, 0\). Posons \(\rho = \max(|h|,|k|)\). Comme \(|h^3| \leq\, \rho h^2\) et \(|k^3| \leq\, \rho k^2\),
\[ f(1+h,1+k) + 1 \geq\, \Big(\frac{3}{2} – \rho\Big)(h^2+k^2). \]
Pour \(0 < \rho < \frac{3}{2}\), ce minorant est strictement positif. Donc \((1,1)\) est un minimum local strict, de valeur \(-1\). - On a \(f(t,t) = 2t^3 – 3t^2 = t^2(2t-3) < 0\) pour \(t\) petit non nul, et \(f(t,-t) = 3t^2 > 0\). Dans tout voisinage de l’origine, \(f\) prend des valeurs des deux signes, alors que \(f(0,0) = 0\). Donc \((0,0)\) n’est pas un extremum local.
Corrigé de l’exercice 16 : Contre-exemple au théorème de Schwarz
- On écrit \(x^2 – y^2 = (x^2+y^2) – 2y^2\). Donc \(\dfrac{xy(x^2-y^2)}{x^2+y^2} = xy – \dfrac{2xy^3}{x^2+y^2}\). C’est l’égalité demandée.
- Hors de l’origine, on dérive la forme précédente, avec \(r^2 = x^2+y^2\) :
\[ \partial_1f = y – \frac{2y^3(y^2-x^2)}{r^4}, \qquad \partial_2f = x – \frac{2x(3x^2y^2+y^4)}{r^4}. \]
En effet, \(\partial_x\frac{x}{r^2} = \frac{y^2-x^2}{r^4}\) et \(\partial_y\frac{y^3}{r^2} = \frac{3y^2r^2 – 2y^4}{r^4} = \frac{3x^2y^2+y^4}{r^4}\). En \((0,0)\), on a \(f(x,0) = 0\) et \(f(0,y) = 0\). Donc \(\partial_1f(0,0) = \partial_2f(0,0) = 0\). - Sur \(\mathbb{R}^2\setminus\{(0,0)\}\), \(f\) est \(C^1\) comme fraction rationnelle. À l’origine, \(|2y^3(y^2-x^2)| \leq\, 2r^3\cdot r^2\), donc le second terme de \(\partial_1 f\) est majoré par \(2r\). De même, \(3x^2y^2 + y^4 \leq\, 3r^4\) et le second terme de \(\partial_2f\) est majoré par \(6r\). Ainsi \(\partial_1f\) et \(\partial_2f\) tendent vers \(0\) en l’origine. Les dérivées partielles sont continues sur \(\mathbb{R}^2\), donc \(f\) est de classe \(C^1\).
- Pour \(y \neq 0\), \(\partial_1f(0,y) = y – \frac{2y^5}{y^4} = -y\), formule encore vraie pour \(y = 0\). Donc \(\partial_2(\partial_1f)(0,0) = -1\). De même, \(\partial_2f(x,0) = x\), d’où \(\partial_1(\partial_2f)(0,0) = 1\). Les deux dérivées croisées valent \(-1\) et \(1\).
- Si \(f\) était de classe \(C^2\), le théorème de Schwarz imposerait l’égalité des dérivées croisées. Donc \(f\) est de classe \(C^1\) mais pas de classe \(C^2\) sur \(\mathbb{R}^2\).
Corrigé de l’exercice 17 : Développement à l’ordre 2 de l’inverse et du déterminant
- Pour \(\|H\| < 1\), l’exercice 7 donne \((I_n+H)^{-1} = \sum_{k \geq\, 0}(-H)^k\). Le reste \(\sum_{k \geq\, 3}(-H)^k\) est majoré par \(\frac{\|H\|^3}{1-\|H\|} = o(\|H\|^2)\). Donc \((I_n+H)^{-1} = I_n – H + H^2 + o(\|H\|^2)\).
Ensuite, \(d\iota = \Phi\circ\iota\), où \(\Phi(A) = (H \mapsto -AHA)\) est polynomiale, donc différentiable. Ainsi \(\iota\) est deux fois différentiable, et Taylor-Young donne \(\iota(I_n+H) = I_n – H + \frac{1}{2}d^2\iota(I_n)(H,H) + o(\|H\|^2)\). Par différence, \(Q(H) = \frac{1}{2}d^2\iota(I_n)(H,H) – H^2\) est un \(o(\|H\|^2)\). Or \(Q(tH) = t^2Q(H)\) ; en faisant \(t \to 0\), on obtient \(Q(H) = 0\). Donc \(d^2\iota(I_n)(H,H) = 2H^2\). Enfin, par symétrie (théorème de Schwarz), on polarise : \(d^2\iota(I_n)(H,K) = \frac{1}{2}\big(2(H+K)^2 – 2H^2 – 2K^2\big)\). Ainsi \(d^2\iota(I_n)(H,K) = HK + KH\).
- On a \(d\iota(M)(H) = -\iota(M)H\iota(M)\). Pour \(H\) fixé, c’est la composée de \(\iota\) et de l’application bilinéaire \((X,Y) \mapsto -XHY\). Sa dérivée selon \(K\) vaut \(-d\iota(M)(K)\,H\,\iota(M) – \iota(M)\,H\,d\iota(M)(K)\). En \(M = I_n\), avec \(d\iota(I_n)(K) = -K\), on retrouve \(d^2\iota(I_n)(H,K) = KH + HK\).
- Le déterminant \(\det(I_n+H) = \sum_\sigma \varepsilon(\sigma)\prod_i(\delta_{\sigma(i)i} + h_{\sigma(i)i})\) est un polynôme en les \(h_{ij}\). En dimension finie, chaque \(|h_{ij}|\) est majoré par \(C\|H\|\). Ainsi les termes de degré au moins \(3\) forment un \(O(\|H\|^3)\). Cherchons les termes de degré au plus \(2\).
D’abord, \(\sigma = \mathrm{id}\) donne \(\prod_i(1+h_{ii}) = 1 + \sum_i h_{ii} + \sum_{i<j}h_{ii}h_{jj} + \ldots\). Ensuite, une transposition \((i\ j)\), de signature \(-1\), donne \(-h_{ij}h_{ji}\) exactement. Enfin, toute autre permutation déplace au moins trois indices et ne produit que des termes de degré au moins \(3\). Le terme de degré \(2\) vaut donc \(\sum_{i<j}(h_{ii}h_{jj} – h_{ij}h_{ji})\).
Or \((\mathrm{tr}\,H)^2 – \mathrm{tr}(H^2) = \sum_{i,j}h_{ii}h_{jj} – \sum_{i,j}h_{ij}h_{ji}\). Les termes \(i = j\) s’éliminent, et les couples \(i \neq j\) apparaissent deux fois. On obtient \(2\sum_{i<j}(h_{ii}h_{jj} – h_{ij}h_{ji})\). Donc \(\det(I_n+H) = 1 + \mathrm{tr}\,H + \frac{1}{2}\big((\mathrm{tr}\,H)^2 – \mathrm{tr}(H^2)\big) + o(\|H\|^2)\).
- Pour \(H = \begin{pmatrix} a b \\ c d \end{pmatrix}\), on a \(\det(I_2+H) = (1+a)(1+d) – bc = 1 + (a+d) + (ad-bc)\). Par ailleurs, \(\mathrm{tr}(H^2) = a^2 + 2bc + d^2\). Ainsi \(\frac{1}{2}\big((a+d)^2 – a^2 – 2bc – d^2\big) = ad – bc\). La formule est exacte pour \(n = 2\), le terme d’ordre deux étant \(\det H\).
- Si \({^tH = -H\), alors \(\mathrm{tr}\,H = 0\) et \(h_{ji} = -h_{ij}\). Donc \(\mathrm{tr}(H^2) = \sum_{i,j}h_{ij}h_{ji} = -\sum_{i,j}h_{ij}^2\). Par conséquent \(\det(I_n+H) = 1 + \frac{1}{2}\sum_{i,j}h_{ij}^2 + o(\|H\|^2)\).
Corrigé de l’exercice 18 : Convexité par la hessienne
- On a \(\partial_xf = \frac{2x}{y}\) et \(\partial_yf = -\frac{x^2}{y^2}\). En dérivant encore, \(H_f(x,y) = \begin{pmatrix} \frac{2}{y} -\frac{2x}{y^2} \\ -\frac{2x}{y^2} \frac{2x^2}{y^3} \end{pmatrix}\).
- On calcule \(d^2f(x,y)\big((h,k),(h,k)\big) = \frac{2h^2}{y} – \frac{4xhk}{y^2} + \frac{2x^2k^2}{y^3}\). En factorisant par \(\frac{2}{y}\), on reconnaît \(\frac{2}{y}\big(h^2 – 2h\frac{x}{y}k + \frac{x^2}{y^2}k^2\big) = \frac{2}{y}\big(h – \frac{x}{y}k\big)^2\). Comme \(y > 0\), cette quantité est positive. L’ouvert \(U\) est convexe. D’après le cours, \(f\) est convexe sur \(U\).
- Le long de la demi-droite \(t \mapsto (t,t)\), \(t > 0\), on a \(f(t,t) = t\), fonction affine. La restriction de \(f\) à un segment de cette demi-droite n’est pas strictement convexe. Donc \(f\) n’est pas strictement convexe. On le voit aussi sur la hessienne, dégénérée dans la direction \((h,k) = (x,y)\).
- En \((1,1)\), \(f(1,1) = 1\) et \(\nabla f(1,1) = (2,-1)\). L’inégalité du plan tangent s’écrit \(f(x,y) \geq\, 1 + 2(x-1) – (y-1) = 2x – y\). Directement, \(\frac{x^2}{y} – 2x + y = \frac{(x-y)^2}{y} \geq\, 0\). On retrouve bien \(\frac{x^2}{y} \geq\, 2x – y\) sur \(U\).
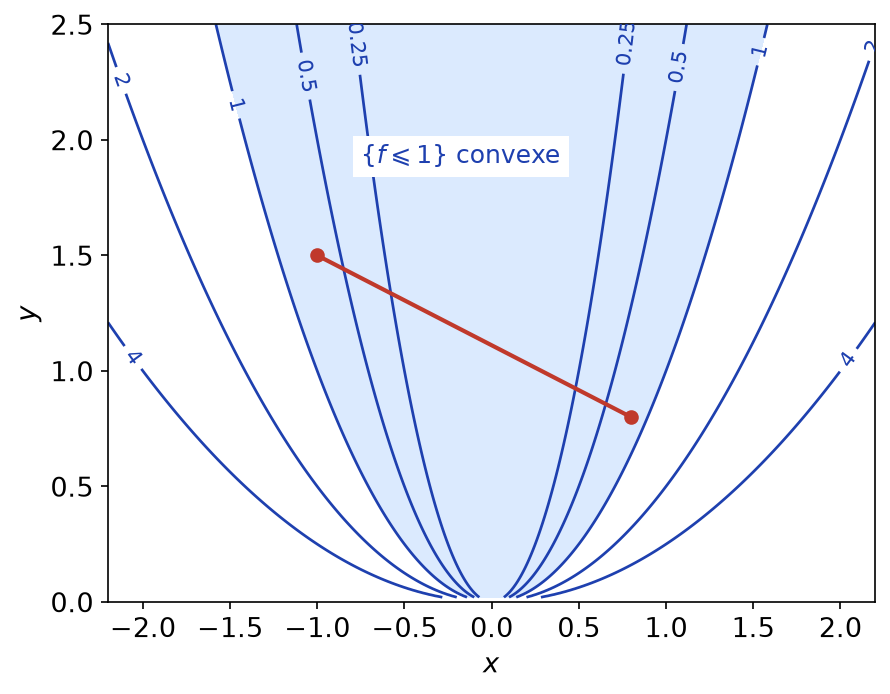
- L’ensemble proposé est \(\{p \in U : f(p) \leq\, 1\}\). Si \(f(p) \leq\, 1\) et \(f(q) \leq\, 1\), alors \(f(tp+(1-t)q) \leq\, tf(p) + (1-t)f(q) \leq\, 1\). La figure ci-dessous représente ce sous-niveau et un segment qui y reste inclus. Cet ensemble est donc convexe.

Point de méthode : pour prouver qu’une hessienne est positive, écrivez la forme quadratique \(d^2f(x)(h,h)\) et cherchez une somme de carrés.
Corrigé de l’exercice 19 : Minimisation d’une fonctionnelle quadratique
- D’après l’exercice 1, avec \(A\) symétrique, le gradient de \(x \mapsto \frac{1}{2}\langle Ax,x\rangle\) vaut \(Ax\). Celui de \(x \mapsto \langle b,x\rangle\) vaut \(b\). Donc \(\nabla J(x) = Ax – b\), et la hessienne de \(J\) est la matrice constante \(A\).
- La hessienne \(A\) est positive, et \(\mathbb{R}^n\) est convexe. Ainsi \(J\) est convexe. Son unique point critique vérifie \(Ax = b\), soit \(x^* = A^{-1}b\), car \(A\) est inversible. Par le corollaire du cours, \(x^*\) est un point de minimum global. De plus, \(J(x^*) = \frac{1}{2}\langle b, A^{-1}b\rangle – \langle b, A^{-1}b\rangle\). Donc \(x^* = A^{-1}b\) et \(J(x^*) = -\frac{1}{2}\langle b, A^{-1}b\rangle\).
- On développe, en utilisant la symétrie de \(A\) : \(J(x^*+h) = J(x^*) + \langle Ax^* – b, h\rangle + \frac{1}{2}\langle Ah,h\rangle\). Or \(Ax^* = b\). Ainsi \(J(x^*+h) = J(x^*) + \frac{1}{2}\langle Ah,h\rangle\), qui est strictement supérieur à \(J(x^*)\) si \(h \neq 0\). Cela confirme l’unicité du minimum.
- On résout \(2x+y = 1\) et \(x+2y = 1\), d’où \(x = y = \frac{1}{3}\). Ensuite, \(\langle b, x^*\rangle = \frac{2}{3}\). Le minimum est atteint en \((\frac{1}{3},\frac{1}{3})\) et vaut \(-\frac{1}{3}\).
- On a \(\|Mx-y\|^2 = \langle {^tMMx, x\rangle – 2\langle {^tMy, x\rangle + \|y\|^2 = 2J(x) + \|y\|^2\), avec \(A = {^tMM\) et \(b = {^tMy\). La matrice \(A\) est symétrique. De plus, \(\langle Ax,x\rangle = \|Mx\|^2 > 0\) si \(x \neq 0\), car \(M\) est injective (rang \(n\)). Ainsi \(A\) est définie positive. D’après la question 2, le minimum est unique et vérifie \({^tMMx = {^tMy\).
Corrigé de l’exercice 20 : Différentielle de M ↦ ᵗMM
- On développe : \(f(M+H) = {^tMM + {^tHM + {^tMH + {^tHH\). La norme de Frobenius est sous-multiplicative et invariante par transposition. Donc \(\|{^tHH\| \leq\, \|H\|^2 = o(\|H\|)\). Le terme \({^tHM + {^tMH\) est linéaire en \(H\). Ainsi \(df(M)(H) = {^tHM + {^tMH\).
- On a \(df(I_n)(H) = H + {^tH\). Le noyau est formé des \(H\) telles que \({^tH = -H\). L’image est incluse dans \(\mathcal{S}_n\) ; réciproquement, \(S \in \mathcal{S}_n\) vérifie \(S = df(I_n)(\frac{1}{2}S)\). Donc \(\ker df(I_n) = \mathcal{A}_n\) et \(\mathrm{Im}\,df(I_n) = \mathcal{S}_n\). Les dimensions \(\frac{n(n-1)}{2} + \frac{n(n+1)}{2} = n^2\) sont cohérentes avec le théorème du rang.
- L’image de \(df(M)\) est incluse dans \(\mathcal{S}_n\), car \({^t({^tHM) = {^tMH\). Soit \(S \in \mathcal{S}_n\) et \(H = \frac{1}{2}\,{^tM^{-1}S\). Alors \({^tMH = \frac{1}{2}S\) et \({^tHM = \frac{1}{2}SM^{-1}M = \frac{1}{2}S\). Donc \(df(M)(H) = S\) : l’application est surjective. Ensuite, \(df(M)(H) = 0\) équivaut à \({^tMH\) antisymétrique. Donc \(\ker df(M) = \{{^tM^{-1}A : A \in \mathcal{A}_n\}\).
- Pour tout \(t\), \(f(\Omega(t)) = I_n\). En dérivant en \(0\) par la règle de la chaîne, \(df(I_n)(\Omega^{\prime}(0)) = 0\), c’est-à-dire \({^t\Omega^{\prime}(0) + \Omega^{\prime}(0) = 0\). Pour la rotation \(R(t) = \begin{pmatrix} \cos t -\sin t \\ \sin t \cos t \end{pmatrix}\), on trouve \(R^{\prime}(0) = \begin{pmatrix} 0 -1 \\ 1 0 \end{pmatrix}\). Dans les deux cas, \(\Omega^{\prime}(0)\) est antisymétrique.
Corrigé de l’exercice 21 : Fonctions homogènes et relation d’Euler
- Fixons \(x \neq 0\) et dérivons \(t \mapsto f(tx) = t^\alpha f(x)\) sur \(]0,+\infty[\). Par la règle de la chaîne, \(df(tx)(x) = \alpha t^{\alpha-1}f(x)\). En \(t = 1\), on obtient \(df(x)(x) = \alpha f(x)\).
- Posons \(g(t) = t^{-\alpha}f(tx)\) pour \(t > 0\). Alors \(g^{\prime}(t) = -\alpha t^{-\alpha-1}f(tx) + t^{-\alpha}df(tx)(x)\). Or \(df(tx)(x) = \frac{1}{t}df(tx)(tx) = \frac{\alpha}{t}f(tx)\) par la relation d’Euler. Donc \(g^{\prime}(t) = 0\) sur l’intervalle \(]0,+\infty[\), et \(g(t) = g(1) = f(x)\). Ainsi \(f(tx) = t^\alpha f(x)\) : \(f\) est homogène de degré \(\alpha\).
- Fixons \(t > 0\) et dérivons \(x \mapsto f(tx) = t^\alpha f(x)\) par rapport à \(x_i\). La règle de la chaîne donne \(t\,\partial_if(tx) = t^\alpha\partial_if(x)\). Donc \(\partial_if(tx) = t^{\alpha-1}\partial_if(x)\) : \(\partial_i f\) est homogène de degré \(\alpha-1\).
- On a \(f(tx) = t^3f(x)\) pour \(t > 0\). Par ailleurs \(f = q^{3/2}\) avec \(q(x) = \|x\|_2^2\), donc \(\nabla f(x) = \frac{3}{2}q(x)^{1/2}\cdot 2x = 3\|x\|_2\,x\). Ainsi \(df(x)(x) = 3\|x\|_2\|x\|_2^2\). On retrouve \(df(x)(x) = 3f(x)\).
- D’abord, pour \(x \neq 0\) et \(t > 0\), \(f(x) = \frac{f(tx)}{t} = \frac{f(tx) – f(0)}{t}\). Quand \(t \to 0^+\), ce quotient tend vers \(df(0)(x)\). Donc \(f(x) = df(0)(x)\) pour tout \(x\), et \(f = df(0)\) est linéaire.
La fonction \(f(x,y) = \frac{x^3}{x^2+y^2}\) est homogène de degré \(1\). Pour tout \(t \neq 0\), \(\frac{f(tv)}{t} = f(v)\) : elle admet donc en \(0\) la dérivée \(D_vf(0) = f(v)\) selon tout vecteur. Cependant \(f(1,0) = 1\), \(f(0,1) = 0\) et \(f(1,1) = \frac{1}{2} \neq 1 + 0\). Elle n’est pas linéaire. D’après ce qui précède, \(f\) n’est pas différentiable en \((0,0)\).
Corrigé de l’exercice 22 : Dérivée seconde bornée et descente de gradient
- La formule de Taylor avec reste intégral donne \(f(x+h) = f(x) + \langle\nabla f(x),h\rangle + \int_0^1(1-t)\langle H_f(x+th)h,h\rangle\,dt\). Or \(|\langle H_f(z)h,h\rangle| \leq\, \|H_f(z)\|\,\|h\|^2 \leq\, M\|h\|^2\), et \(\int_0^1(1-t)\,dt = \frac{1}{2}\). D’où \(|f(x+h) – f(x) – \langle\nabla f(x),h\rangle| \leq\, \frac{M}{2}\|h\|^2\).
- L’application \(\nabla f : \mathbb{R}^n \to \mathbb{R}^n\) est de classe \(C^1\), de matrice jacobienne \(H_f(x)\). Sa différentielle est donc de norme au plus \(M\). Par l’inégalité des accroissements finis sur le convexe \(\mathbb{R}^n\), \(\|\nabla f(x) – \nabla f(y)\| \leq\, M\|x-y\|\).
- Appliquons la question 1 avec \(h = -t\nabla f(x)\). On obtient \(f(x_+) \leq\, f(x) – t\|\nabla f(x)\|^2 + \frac{M}{2}t^2\|\nabla f(x)\|^2\). Ainsi \(f(x_+) \leq\, f(x) – t\big(1-\frac{Mt}{2}\big)\|\nabla f(x)\|^2\). Pour \(0 < t < \frac{2}{M}\), la valeur de \(f\) décroît donc strictement tant que \(\nabla f(x) \neq 0\).
- Avec \(t = \frac{1}{M}\), on a \(t(1-\frac{Mt}{2}) = \frac{1}{2M}\). Donc \(\|\nabla f(x_k)\|^2 \leq\, 2M\big(f(x_k) – f(x_{k+1})\big)\). En sommant de \(0\) à \(N\), la somme télescopique donne \(\sum_{k=0}^N\|\nabla f(x_k)\|^2 \leq\, 2M\big(f(x_0) – f(x_{N+1})\big) \leq\, 2M\big(f(x_0) – m\big)\). La série converge, donc son terme général \(\|\nabla f(x_k)\|^2\) tend vers \(0\).
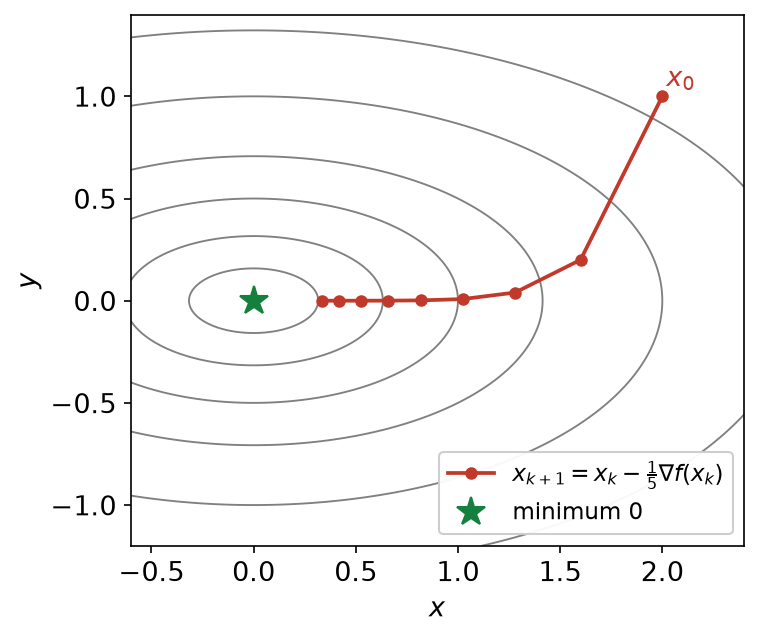
- Ici \(\nabla f(x,y) = (x,4y)\) et \(H_f = \mathrm{diag}(1,4)\), donc \(M = 4\) ; le pas \(\frac{1}{5}\) est bien dans \(]0,\frac{1}{2}[\). Les itérés vérifient \(x_{k+1} = \frac{4}{5}x_k\) et \(y_{k+1} = \frac{1}{5}y_k\). Donc \(x_k = 2\big(\frac{4}{5}\big)^k\) et \(y_k = \big(\frac{1}{5}\big)^k\), qui tendent vers le minimum \((0,0)\), comme le montre la figure ci-dessous. Pour le premier pas, \(f(2,1) = 4\) et \(x_1 = (1{,}6\,;\,0{,}2)\), donc \(f(x_1) = \frac{2{,}56 + 0{,}16}{2} = 1{,}36\). La borne vaut \(4 – \frac{1}{5}\cdot\frac{3}{5}\cdot 20 = 1{,}6\). On a bien \(1{,}36 \leq\, 1{,}6\).

Point de méthode : l’inégalité de Taylor-Lagrange à l’ordre \(2\) est l’outil standard pour contrôler une fonction autour de son approximation affine.
Corrigé de l’exercice 23 : Problème, une équation intégrale non linéaire
- Pour \(u \in E\), \(u^2\) est continue, donc sa primitive \(G(u)\) nulle en \(0\) est continue : \(G(u) \in E\). Ensuite, pour \(t \in [0,1]\),
\[ G(u+h)(t) – G(u)(t) – 2\int_0^t uh = \int_0^t h(s)^2\,ds \in [0, \|h\|_\infty^2]. \]
Posons \(L_u(h)(t) = 2\int_0^t u(s)h(s)\,ds\). Cette application est linéaire et vérifie \(|L_u(h)(t)| \leq\, 2t\|u\|_\infty\|h\|_\infty\). Elle est donc continue et le reste est un \(o(\|h\|_\infty)\). Ainsi \(dG(u) = L_u\), avec \(\|dG(u)\| \leq\, 2\|u\|_\infty\). - On a \((dG(u) – dG(v))(h)(t) = 2\int_0^t(u-v)h\), de valeur absolue au plus \(2\|u-v\|_\infty\|h\|_\infty\). Donc \(\|dG(u) – dG(v)\| \leq\, 2\|u-v\|_\infty\). L’application \(dG\) est lipschitzienne, donc \(G\) est de classe \(C^1\).
- Posons \(\Lambda(k)(h)(t) = \int_0^t k(s)h(s)\,ds\). Alors \(dG = 2\Lambda\), et \(\Lambda : E \to \mathcal{L}_c(E,E)\) est linéaire, de norme au plus \(1\). Une application linéaire continue est différentiable et égale à sa différentielle. Donc \(dG\) est différentiable, et \(d^2G(u)(h,k)(t) = 2\int_0^t h(s)k(s)\,ds\), forme bilinéaire symétrique. Enfin, \(\frac{1}{2}d^2G(u)(h,h) = \int_0^t h^2\), qui est exactement le reste de la question 1. La formule de Taylor à l’ordre \(2\) est donc exacte : \(G(u+h) = G(u) + dG(u)(h) + \frac{1}{2}d^2G(u)(h,h)\).
- La boule \(B\) est convexe et, pour \(u \in B\), \(\|dG(u)\| \leq\, 2\|u\|_\infty \leq\, 2\). L’inégalité des accroissements finis s’applique sur tout segment de \(B\), qui reste dans \(B\). Elle est énoncée pour un ouvert, mais on l’applique sur la boule ouverte de rayon \(1 + \delta\), où \(\|dG\| \leq\, 2 + 2\delta\), puis on fait \(\delta \to 0\). Ainsi \(\|G(u) – G(v)\|_\infty \leq\, 2\|u-v\|_\infty\) pour \(u, v \in B\).
- Soit \(u \in B\). Alors \(|G(u)(t)| \leq\, \int_0^1 u^2 \leq\, 1\), donc \(\|T(u)\|_\infty \leq\, \frac{1}{2} + \frac{1}{4} = \frac{3}{4} \leq\, 1\) : \(T(B) \subset B\). Ensuite, \(\|T(u) – T(v)\|_\infty = |\lambda|\,\|G(u)-G(v)\|_\infty \leq\, \frac{1}{2}\|u-v\|_\infty\). Enfin, \(B\) est fermée dans l’espace complet \(E\), donc complète. Le théorème du point fixe de Picard s’applique. L’équation \(u = f + \lambda G(u)\) admet une unique solution dans \(B\).
- Soit \(u(t) = \frac{1}{2-\lambda t}\), bien défini car \(2 – \lambda t \geq\, \frac{7}{4}\). Si \(\lambda \neq 0\), on calcule \(\frac{1}{2} + \lambda\int_0^t\frac{ds}{(2-\lambda s)^2} = \frac{1}{2} + \Big[\frac{1}{2-\lambda s}\Big]_0^t = \frac{1}{2-\lambda t}\) ; si \(\lambda = 0\), \(u = \frac{1}{2}\) convient aussi. De plus, \(0 < u(t) \leq\, \frac{4}{7}\), donc \(u \in B\). Par unicité, la solution est \(u(t) = \dfrac{1}{2-\lambda t}\).
Revenir aux énoncés des exercices
Pour aller plus loin en L3
- Le cours : calcul différentiel, cours de maths en L3
- Les énoncés : exercices de maths en L3 sur calcul différentiel
- À maîtriser avant : Espaces normés et applications linéaires continues
- Chapitre précédent : Réduction de Jordan et décomposition de Dunford
- Chapitre suivant : Inversion locale, fonctions implicites et extrema liés
- Le même thème en maths spé : calcul différentiel, exercices de maths spé
- Tester vos connaissances : QCM de maths en L3 par chapitre
- Le sommaire : tous les chapitres de maths de L3 et la licence de maths de L1 à L3