Ce corrigé Jordan L3 rédige entièrement les solutions, comme on l’attend dans une copie de partiel. Chaque calcul de polynôme caractéristique, de noyau ou de puissance de matrice est détaillé. Les théorèmes invoqués sont nommés : lemme des noyaux, Cayley-Hamilton, unicité de la décomposition de Dunford, classification des nilpotents.
La méthode suivie est toujours la même. On factorise d’abord le polynôme caractéristique, puis on calcule les noyaux itérés pour obtenir les tailles des blocs, et seulement ensuite on construit les chaînes de Jordan en partant du haut. Soyez vigilants sur deux points : une décomposition « diagonale plus triangulaire » n’est pas celle de Dunford si les termes ne commutent pas, et l’exponentielle d’une somme n’est le produit des exponentielles que si les matrices commutent. Des figures illustrent les tableaux de Young, les trajectoires d’un système différentiel et une base duale.
Les énoncés se trouvent sur la page exercices de maths en L3 sur réduction de Jordan.
Corrigé de l’exercice 1 : Polynôme minimal et lemme des noyaux
- On développe \(\det(XI_3 – A)\) selon la troisième colonne, qui n’a qu’un coefficient non nul : \[\chi_A = (X – 2)\det\begin{pmatrix} X -1 \\ 1 X – 2 \end{pmatrix} = (X – 2)(X^2 – 2X + 1).\] Donc \(\chi_A = (X – 1)^2 (X – 2)\).
- On a \(A – I_3 = \begin{pmatrix} -1 1 0 \\ -1 1 0 \\ 1 -1 1 \end{pmatrix}\). Le système se réduit à \(y = x\) et \(x – y + z = 0\), c’est-à-dire \(y = x\) et \(z = 0\). Ainsi \(\ker(A – I_3) = \mathrm{Vect}\big((1, 1, 0)\big)\), de dimension \(1\). Or la valeur propre \(1\) est de multiplicité \(2\). Par conséquent, \(A\) n’est pas diagonalisable.
- Le polynôme minimal divise \(\chi_A\) et admet les mêmes racines. Les seuls candidats sont donc \((X – 1)(X – 2)\) et \((X – 1)^2(X – 2)\). Cependant, le premier est scindé à racines simples : s’il annulait \(A\), celle-ci serait diagonalisable. Donc \(\pi_A = (X – 1)^2(X – 2)\).
- Un calcul direct donne \((A – I_3)^2 = \begin{pmatrix} 0 0 0 \\ 0 0 0 \\ 1 -1 1 \end{pmatrix}\). Ainsi \(F_1\) est le plan d’équation \(x – y + z = 0\), de base \((1, 1, 0)\), \((0, 1, 1)\). Ensuite, \(A – 2I_3 = \begin{pmatrix} -2 1 0 \\ -1 0 0 \\ 1 -1 0 \end{pmatrix}\) impose \(x = 0\) puis \(y = 0\), d’où \(F_2 = \mathrm{Vect}(e_3)\). Enfin, \(e_3\) ne vérifie pas \(x – y + z = 0\), donc \(F_1 \cap F_2 = \{0\}\). Comme \(2 + 1 = 3\), on a bien \(\mathbb{R}^3 = F_1 \oplus F_2\), conformément au lemme des noyaux.
Point de méthode : pour trouver \(\pi_A\), on teste les diviseurs de \(\chi_A\) ayant toutes les valeurs propres pour racines, du plus petit degré au plus grand.
Corrigé de l’exercice 2 : Projecteurs spectraux par Bézout
- On développe : \((X – 1)^2 – X(X – 2) = X^2 – 2X + 1 – X^2 + 2X\). On obtient bien \(1\).
- Posons \(P_2 = (A – I_3)^2\). Si \(x \in F_1\), alors \(P_2 x = 0\) par définition. Si \(x \in F_2\), alors \(Ax = 2x\), donc \(P_2 x = (2 – 1)^2 x = x\). Une application linéaire est déterminée par ses restrictions à deux supplémentaires. Donc \(P_2\) est le projecteur sur \(F_2\) parallèlement à \(F_1\), et \(P_2 = \begin{pmatrix} 0 0 0 \\ 0 0 0 \\ 1 -1 1 \end{pmatrix}\).
- On obtient \(P_1 = I_3 – P_2 = \begin{pmatrix} 1 0 0 \\ 0 1 0 \\ -1 1 0 \end{pmatrix}\). D’autre part, l’identité de Bézout évaluée en \(A\) donne \(I_3 = P_2 – A(A – 2I_3)\). Ainsi \(P_1 = A(2I_3 – A)\). On le vérifie : les lignes de \(A(2I_3 – A)\) sont \((1, 0, 0)\), \((0, 1, 0)\) et \((-1, 1, 0)\). Donc \(P_1 = A(2I_3 – A)\).
- La troisième ligne de \(P_2^2\) vaut \(1 \cdot (0, 0, 0) – 1 \cdot (0, 0, 0) + 1 \cdot (1, -1, 1)\), et les autres lignes sont nulles. Donc \(P_2^2 = P_2\). Ensuite, \(P_1 P_2 = P_2 – P_2^2 = 0\) et \(P_1^2 = I_3 – 2P_2 + P_2^2 = P_1\). Ainsi \(P_1^2 = P_1\) et \(P_1 P_2 = 0\).
Corrigé de l’exercice 3 : Dunford d’une matrice d’ordre 2
- On a \(\mathrm{tr}(B) = 4\) et \(\det(B) = 3 + 1 = 4\), donc \(\chi_B = X^2 – 4X + 4 = (X – 2)^2\). Si \(B\) était diagonalisable, elle serait semblable à \(2I_2\), donc égale à \(2I_2\). Ce n’est pas le cas. Ainsi \(B\) n’est pas diagonalisable.
- Le seul sous-espace caractéristique est \(\mathbb{R}^2\), et le projecteur associé est \(I_2\). Par conséquent, \(D = 2I_2\) et \(N = B – 2I_2 = \begin{pmatrix} 1 1 \\ -1 -1 \end{pmatrix}\). On vérifie que \(N^2 = 0\), et \(D\) commute avec toute matrice. Donc \(B = 2I_2 + N\) est la décomposition de Dunford.
- Comme \(2I_2\) et \(N\) commutent, la formule du binôme s’applique, et les termes en \(N^j\) avec \(j \geq\, 2\) sont nuls : \[B^k = 2^k I_2 + k\,2^{k-1} N.\] Ainsi \(B^k = 2^{k-1}\begin{pmatrix} 2 + k k \\ -k 2 – k \end{pmatrix}\) pour tout \(k \geq\, 0\) (pour \(k = 0\), on retrouve \(I_2\)).
Corrigé de l’exercice 4 : Dunford et puissances d’une matrice d’ordre 3
- D’après le cours, la partie diagonalisable vaut \(D = \sum \lambda_i P_i\), où les \(P_i\) sont les projecteurs spectraux. Ici, \(D = 1 \cdot P_1 + 2 \cdot P_2\). On trouve \(D = \begin{pmatrix} 1 0 0 \\ 0 1 0 \\ 1 -1 2 \end{pmatrix}\).
- On calcule \(N = A – D = \begin{pmatrix} -1 1 0 \\ -1 1 0 \\ 0 0 0 \end{pmatrix}\). Chaque coefficient de \(N^2\) est de la forme \((-1)a + 1 \cdot a = 0\), donc \(N^2 = 0\). Ensuite, les deux premières lignes de \(D\) sont celles de \(I_3\), et la troisième ligne de \(DN\) vaut \((-1, 1, 0) – (-1, 1, 0) + 0 = 0\) ; ainsi \(DN = N\). De même, \(ND = N\) car les lignes \((-1, 1, 0)\) vérifient \((-1, 1, 0)D = (-1, 1, 0)\). Donc \(N^2 = 0\) et \(DN = ND = N\).
- La troisième ligne de \(P_2 N\) vaut \(1 \cdot (-1, 1, 0) – 1 \cdot (-1, 1, 0) + 1 \cdot 0 = 0\). Ainsi \(P_2 N = 0\), puis \(P_1 N = N – P_2 N\). On obtient \(P_2 N = 0\) et \(P_1 N = N\).
- Comme \(P_1\) et \(P_2\) sont des projecteurs associés à une somme directe, \(D^k = P_1 + 2^k P_2\). Ensuite, par la formule du binôme avec \(N^2 = 0\), on a \(A^k = D^k + kD^{k-1}N\). Or \(D^{k-1}N = P_1 N + 2^{k-1}P_2 N = N\). Par conséquent, \[A^k = P_1 + 2^k P_2 + kN.\] Ainsi \(A^k = \begin{pmatrix} 1 – k k 0 \\ -k 1 + k 0 \\ 2^k – 1 1 – 2^k 2^k \end{pmatrix}\). Pour \(k = 1\), on retrouve bien \(A\).
Point de méthode : les relations \(P_i P_j = 0\) et \(P_i N = N P_i\) rendent les calculs de puissances presque immédiats.
Corrigé de l’exercice 5 : Un piège classique de Dunford
- La matrice \(A\) est triangulaire, donc \(\chi_A = (X – 1)(X – 2)\). Ce polynôme est scindé à racines simples. Donc \(A\) est diagonalisable.
- Le couple \((A, 0)\) convient : \(A\) est diagonalisable, \(0\) est nilpotente, et elles commutent. Par unicité, la décomposition de Dunford est \(D = A\) et \(N = 0\).
- On calcule \(D_0 N_0 = \begin{pmatrix} 0 1 \\ 0 0 \end{pmatrix}\) et \(N_0 D_0 = \begin{pmatrix} 0 2 \\ 0 0 \end{pmatrix}\). Ces matrices diffèrent. Ainsi \(D_0\) et \(N_0\) ne commutent pas, et la condition de commutation de Dunford n’est pas satisfaite.
- La matrice \(\mathrm{diag}(1, 1, 2)\) est diagonale, et \(E_{12}^2 = 0\). Multiplier \(E_{12}\) à gauche par \(\mathrm{diag}(1, 1, 2)\) multiplie sa première ligne par \(1\). À droite, cela multiplie sa deuxième colonne par \(1\). Dans les deux cas, on retrouve \(E_{12}\). Les deux matrices commutent, donc c’est bien la décomposition de Dunford de \(C\). La différence vient de ce que le coefficient \(1\) hors diagonale relie ici deux coefficients diagonaux égaux.
Corrigé de l’exercice 6 : Premiers pas avec les nilpotents
- On calcule successivement \[N^2 = \begin{pmatrix} 0 0 1 4 \\ 0 0 0 1 \\ 0 0 0 0 \\ 0 0 0 0 \end{pmatrix}, \quad N^3 = \begin{pmatrix} 0 0 0 1 \\ 0 0 0 0 \\ 0 0 0 0 \\ 0 0 0 0 \end{pmatrix}, \quad N^4 = 0.\] L’indice de nilpotence de \(N\) est donc \(4\).
- Comme \(N^4 = 0\), on a \((I_4 – N)(I_4 + N + N^2 + N^3) = I_4 – N^4 = I_4\). Donc \(I_4 – N\) est inversible. En additionnant, \((I_4 – N)^{-1} = \begin{pmatrix} 1 1 3 8 \\ 0 1 1 3 \\ 0 0 1 1 \\ 0 0 0 1 \end{pmatrix}\), où par exemple \(8 = 3 + 4 + 1\).
- Comme \(v^{n-1} \neq 0\), il existe \(x\) tel que \(v^{n-1}(x) \neq 0\). Supposons \(\sum_{k=0}^{n-1} a_k v^k(x) = 0\) avec des \(a_k\) non tous nuls, et soit \(j\) le plus petit indice tel que \(a_j \neq 0\). En appliquant \(v^{n-1-j}\), tous les termes d’indice \(k > j\) s’annulent, car \(v^{n} = 0\). Il reste \(a_j v^{n-1}(x) = 0\), ce qui est absurde. La famille est donc libre, et elle a \(n\) vecteurs : c’est une base. Posons \(e_j = v^{n-j}(x)\). Alors \(v(e_1) = 0\) et \(v(e_j) = e_{j-1}\) pour \(j \geq\, 2\). Dans cette base, la matrice de \(v\) est \(J_n(0)\).
- Si \(v\) est nilpotent, sa seule valeur propre est \(0\). S’il est de plus diagonalisable, il est semblable à la matrice diagonale dont tous les coefficients sont nuls. Donc \(v = 0\).
Corrigé de l’exercice 7 : Noyaux itérés et tableau de Young
- La suite des noyaux atteint \(E\) pour la première fois au rang \(4\). L’indice de nilpotence de \(v\) est donc \(4\).
- On lit \(d_1 = 3 – 0 = 3\), \(d_2 = 5 – 3 = 2\), \(d_3 = 6 – 5 = 1\) et \(d_4 = 7 – 6 = 1\). Le tableau de Young a donc des lignes de longueurs \(3, 2, 1, 1\), comme le montre la figure ci-dessous. Ses colonnes ont pour hauteurs \(4\), \(2\) et \(1\).
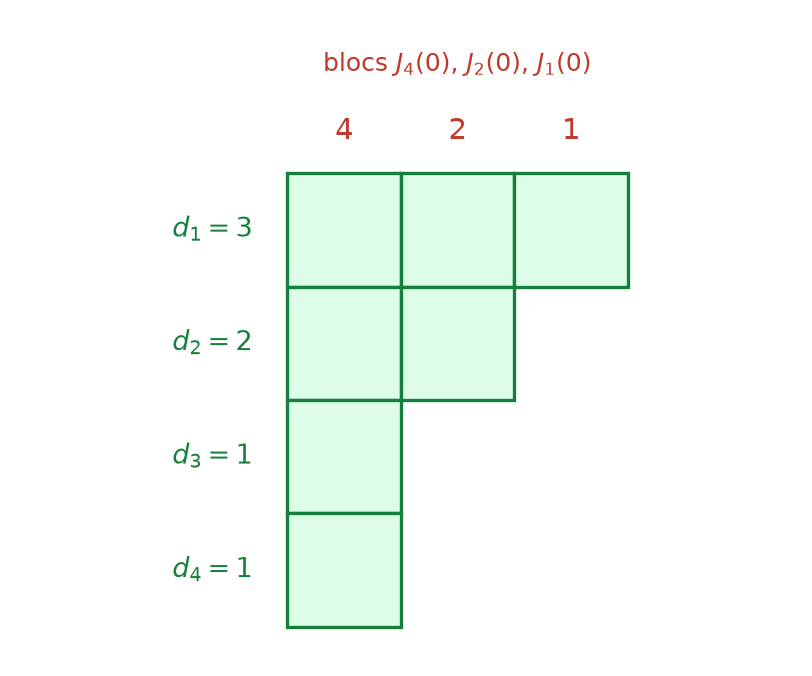
- D’après le cours, les hauteurs des colonnes sont les tailles des blocs. La réduite de Jordan de \(v\) est \(\mathrm{diag}(J_4(0), J_2(0), J_1(0))\). Par le théorème du rang, \(\mathrm{rg}\,v^j = 7 – \dim \ker v^j\). On trouve \(\mathrm{rg}\,v = 4\), \(\mathrm{rg}\,v^2 = 2\) et \(\mathrm{rg}\,v^3 = 1\). Bloc par bloc, on retrouve \(3 + 1 + 0 = 4\), puis \(2 + 0 + 0\) et \(1 + 0 + 0\).
- On aurait \(d_1 = 3\), \(d_2 = 1\) et \(d_3 = 2\). Or la suite \((d_j)\) est décroissante. En effet, \(v\) induit une application injective de \(\ker v^{j+1} / \ker v^j\) dans \(\ker v^j / \ker v^{j-1}\), d’où \(d_{j+1} \leq\, d_j\). Ici \(d_3 > d_2\). Un tel nilpotent n’existe donc pas.
Corrigé de l’exercice 8 : Classes de nilpotents en dimension 4
- Les partitions de \(4\) sont \((4)\), \((3, 1)\), \((2, 2)\), \((2, 1, 1)\) et \((1, 1, 1, 1)\). D’après le théorème de classification, les classes de nilpotents correspondent exactement aux partitions de \(n\). Il y a donc \(5\) classes de similitude de nilpotents dans \(\mathcal{M}_4(\mathbb{C})\).
- L’indice est la taille du plus grand bloc. Le rang est la somme des rangs des blocs, soit \(\sum (k_i – 1) = 4 – s\), où \(s\) est le nombre de blocs. La figure ci-dessous résume les résultats. On obtient les couples (indice, rang) : \((4, 3)\), \((3, 2)\), \((2, 2)\), \((2, 1)\) et \((1, 0)\).
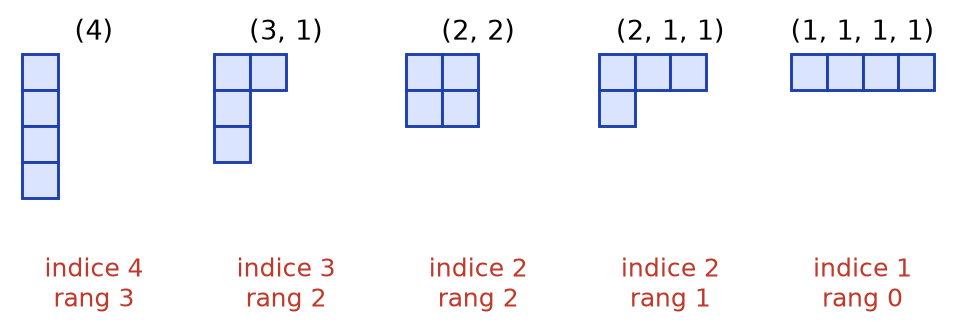
- Les cinq couples obtenus sont deux à deux distincts. Par conséquent, deux nilpotents de même indice et de même rang ont la même partition. En dimension \(4\), le couple (indice, rang) caractérise donc la classe.
- Pour \((3, 2, 2)\), l’indice vaut \(3\) et le rang \(2 + 1 + 1 = 4\). Pour \((3, 3, 1)\), l’indice vaut \(3\) et le rang \(2 + 2 + 0 = 4\). Le couple ne suffit donc plus. En revanche, \(\mathrm{rg}\,N^2\) vaut \(1\) dans le premier cas et \(2\) dans le second. Le rang de \(N^2\), c’est-à-dire \(\dim \ker N^2\), distingue ces deux classes.
Corrigé de l’exercice 9 : Réduite de Jordan d’un bloc unique
- On développe selon la dernière ligne de \(XI_3 – B\) : \[\chi_B = (X – 1)\det\begin{pmatrix} X -1 \\ 1 X – 2 \end{pmatrix} = (X – 1)(X^2 – 2X + 1).\] Donc \(\chi_B = (X – 1)^3\).
- On a \(N = \begin{pmatrix} -1 1 1 \\ -1 1 2 \\ 0 0 0 \end{pmatrix}\), puis \(N^2 = \begin{pmatrix} 0 0 1 \\ 0 0 1 \\ 0 0 0 \end{pmatrix}\) et \(N^3 = 0\). Ainsi \(N\) est nilpotente d’indice \(3\). Donc \(\pi_B = (X – 1)^3 = \chi_B\).
- On a \(\ker N^2 = \{z = 0\}\). On choisit donc \(v_3 = e_3 = (0, 0, 1)\), qui n’est pas dans \(\ker N^2\). Ensuite, \(v_2 = Nv_3 = (1, 2, 0)\) et \(v_1 = Nv_2 = (-1 + 2, -1 + 2, 0) = (1, 1, 0)\). On vérifie que \(Nv_1 = (0, 0, 0)\). La famille est une base d’après l’exercice 6. Avec \(P = \begin{pmatrix} 1 1 0 \\ 1 2 0 \\ 0 0 1 \end{pmatrix}\), de déterminant \(1\), on a \(P^{-1}BP = J_3(1)\).
- Comme \(I_3\) et \(N\) commutent et \(N^3 = 0\), la formule du binôme donne \[B^k = I_3 + kN + \frac{k(k-1)}{2}N^2.\] Ainsi \(B^k = \begin{pmatrix} 1 – k k \frac{k(k+1)}{2} \\ -k 1 + k \frac{k(k+3)}{2} \\ 0 0 1 \end{pmatrix}\). En effet, \(k + \frac{k(k-1)}{2} = \frac{k(k+1)}{2}\) et \(2k + \frac{k(k-1)}{2} = \frac{k(k+3)}{2}\).
Corrigé de l’exercice 10 : Réduite de Jordan en dimension 4
- La première colonne de \(C – XI_4\) n’a qu’un coefficient non nul, \(1 – X\). On développe ensuite le mineur restant selon sa dernière ligne, réduite au coefficient \(-1 – X\), puis on calcule un déterminant triangulaire d’ordre \(2\). On obtient \(\det(C – XI_4) = (1 – X)^3(-1 – X)\). Donc \(\chi_C = (X – 1)^3(X + 1)\).
- On a \(C – I_4 = \begin{pmatrix} 0 1 0 1 \\ 0 0 0 0 \\ 0 1 0 1 \\ 0 0 0 -2 \end{pmatrix}\). Les équations \(y + t = 0\) et \(t = 0\) donnent \(\ker(C – I_4) = \mathrm{Vect}(e_1, e_3)\). Ensuite, \((C – I_4)^2\) a toutes ses colonnes nulles sauf la dernière, égale à \((-2, 0, -2, 4)\). Ainsi \(\ker(C – I_4)^2 = \mathrm{Vect}(e_1, e_2, e_3)\). Enfin, pour \(C + I_4\), on trouve \(y = 0\), \(2x + t = 0\) et \(2z + t = 0\). Donc \(\ker(C + I_4) = \mathrm{Vect}\big((1, 0, 1, -2)\big)\).
- Le sous-espace caractéristique de \(1\) est de dimension \(3\), et il est déjà atteint par \(\ker(C – I_4)^2\). L’exposant de \(X – 1\) dans \(\pi_C\) vaut donc \(2\). Ainsi \(\pi_C = (X – 1)^2(X + 1)\). Pour la valeur propre \(1\), il y a \(\dim \ker(C – I_4) = 2\) blocs, de tailles totales \(3\), le plus grand étant de taille \(2\). Donc \(J = \mathrm{diag}(J_2(1), J_1(1), J_1(-1))\).
- On prend \(w_2 = e_2\), qui est dans \(\ker(C – I_4)^2\) mais pas dans \(\ker(C – I_4)\). Puis \(w_1 = (C – I_4)e_2 = (1, 0, 1, 0)\). On complète avec \(w_3 = e_1\), indépendant de \(w_1\) dans \(\ker(C – I_4)\), et \(w_4 = (1, 0, 1, -2)\). On vérifie que \(Cw_4 = (-1, 0, -1, 2) = -w_4\). Avec \(P = \begin{pmatrix} 1 0 1 1 \\ 0 1 0 0 \\ 1 0 0 1 \\ 0 0 0 -2 \end{pmatrix}\), on a \(P^{-1}CP = J\).
Point de méthode : on commence toujours une chaîne par le haut, avec un vecteur du plus grand noyau itéré qui n’est pas dans le précédent.
Corrigé de l’exercice 11 : Semblables ou non : nilpotents d’ordre 4
- Les trois matrices sont strictement triangulaires supérieures, donc \(\chi = X^4\) pour chacune. On vérifie ensuite que \(M_1^2 = M_2^2 = M_3^2 = 0\), alors qu’aucune n’est nulle. Ainsi \(\pi = X^2\) pour les trois. Enfin, \(\mathrm{rg}\,M_1 = 2\), \(\mathrm{rg}\,M_2 = 1\) et \(\mathrm{rg}\,M_3 = 2\).
- Deux matrices semblables ont le même rang, donc \(M_2\) n’est semblable à aucune des deux autres. Ensuite, un nilpotent d’indice \(2\) et de rang \(2\) en dimension \(4\) a pour partition \((2, 2)\) d’après l’exercice 8. Donc \(M_1\) et \(M_3\) sont semblables, et \(M_2\) est seule dans sa classe. Pour la matrice de passage, on a \(M_3 e_3 = e_1\), \(M_3 e_4 = e_2\) et \(M_3 e_1 = M_3 e_2 = 0\). Dans la base \((e_1, e_3, e_2, e_4)\), la matrice de \(M_3\) est donc \(M_1\). Avec \(P = \begin{pmatrix} 1 0 0 0 \\ 0 0 1 0 \\ 0 1 0 0 \\ 0 0 0 1 \end{pmatrix}\), on a \(P^{-1}M_3P = M_1\).
- Soit \(\lambda\) une valeur propre de multiplicité \(m \leq\, 3\) dans \(\chi\), et \(k\) l’exposant de \(X – \lambda\) dans \(\pi\). Les blocs associés forment une partition de \(m\) de plus grande part \(k\). Pour \(m = 1\), seule \((1)\) est possible. Pour \(m = 2\), \(k = 1\) donne \((1, 1)\) et \(k = 2\) donne \((2)\). Pour \(m = 3\), \(k = 1, 2, 3\) donnent respectivement \((1, 1, 1)\), \((2, 1)\) et \((3)\). Dans tous les cas, la partition est déterminée par \(m\) et \(k\). Donc \(\chi\) et \(\pi\) déterminent la réduite de Jordan, et les deux matrices sont semblables.
Corrigé de l’exercice 12 : Une matrice est semblable à sa transposée
- On a \((W^2)_{ij} = \sum_l w_{il}w_{lj} = w_{i, k+1-i}\,w_{k+1-i, j}\). Ce terme vaut \(1\) si \(j = i\) et \(0\) sinon, donc \(W^2 = I_k\). De même, \((WMW)_{ij} = \sum_{a, b} w_{ia} m_{ab} w_{bj}\). Seul le terme \(a = k + 1 – i\), \(b = k + 1 – j\) subsiste. Ainsi \((WMW)_{ij} = m_{k+1-i,\, k+1-j}\).
- Posons \(a = k + 1 – i\) et \(b = k + 1 – j\). Le coefficient \((J_k(\lambda))_{ab}\) vaut \(\lambda\) si \(a = b\), c’est-à-dire \(i = j\). Il vaut \(1\) si \(b = a + 1\), c’est-à-dire \(i = j + 1\). Les \(1\) se retrouvent donc juste sous la diagonale. Par conséquent, \(WJ_k(\lambda)W = J_k(\lambda)^{\top}\).
- Écrivons \(A = PJP^{-1}\) avec \(J = \mathrm{diag}(J_{k_1}(\lambda_1), \ldots, J_{k_s}(\lambda_s))\). Posons \(W^{\prime} = \mathrm{diag}(W_{k_1}, \ldots, W_{k_s})\). Alors \(W^{\prime}JW^{\prime} = J^{\top}\) bloc par bloc, et \(W^{\prime 2} = I_n\). Ensuite, \[A^{\top} = (P^{-1})^{\top} J^{\top} P^{\top} = (P^{-1})^{\top} W^{\prime} J W^{\prime} P^{\top} = Q J Q^{-1},\] avec \(Q = (P^{\top})^{-1} W^{\prime}\). Comme \(J = P^{-1}AP\), \(A^{\top} = (QP^{-1})A(QP^{-1})^{-1}\) est semblable à \(A\).
- Si \(A\) est réelle, \(A\) et \(A^{\top}\) sont deux matrices réelles semblables dans \(\mathcal{M}_n(\mathbb{C})\). D’après le cours, leurs invariants de similitude coïncident, et ces invariants ne dépendent pas du corps. Donc \(A\) et \(A^{\top}\) sont semblables dans \(\mathcal{M}_n(\mathbb{R})\).
Corrigé de l’exercice 13 : Invariants de similitude et classes
- Pour la valeur propre \(2\), les blocs sont de tailles \(3\) et \(1\) ; pour \(-1\), un seul bloc de taille \(2\). Le dernier invariant regroupe les plus grands blocs : \(P_2 = (X – 2)^3(X + 1)^2\). Il reste le bloc \(J_1(2)\), d’où \(P_1 = X – 2\). Les invariants de \(M\) sont \(P_1 = X – 2\) et \(P_2 = (X – 2)^3(X + 1)^2\). On vérifie que \(P_1 P_2 = (X – 2)^4(X + 1)^2 = \chi_M\).
- Les invariants doivent vérifier \(P_1 \mid P_2\). Or \((X – 1)^2\) ne divise pas \((X – 1)(X – 2)\). Cette suite n’est donc pas une suite d’invariants de similitude.
- La valeur propre \(2\) est simple, donc elle donne un bloc \(J_1(2)\). Pour la valeur propre \(1\), les blocs forment une partition de \(3\). Il y a donc trois classes :
- partition \((3)\) : réduite \(\mathrm{diag}(J_3(1), J_1(2))\), un seul invariant \((X – 1)^3(X – 2)\) ;
- partition \((2, 1)\) : réduite \(\mathrm{diag}(J_2(1), J_1(1), J_1(2))\), invariants \(X – 1\) et \((X – 1)^2(X – 2)\) ;
- partition \((1, 1, 1)\) : réduite \(\mathrm{diag}(1, 1, 1, 2)\), invariants \(X – 1\), \(X – 1\) et \((X – 1)(X – 2)\).
- Une matrice est cyclique si et seulement si \(\pi = \chi\), c’est-à-dire si elle n’a qu’un invariant de similitude. Seule la classe de \(\mathrm{diag}(J_3(1), J_1(2))\) est formée de matrices cycliques.
Corrigé de l’exercice 14 : Décider la similitude
- Les trois matrices sont triangulaires, de polynôme caractéristique \((X – 1)^3\). On calcule les rangs : \(\mathrm{rg}(A – I_3) = 1\), \(\mathrm{rg}(B – I_3) = 1\) et \(\mathrm{rg}(C – I_3) = 2\). Ainsi \(A\) et \(B\) ont deux blocs, de tailles \(2\) et \(1\), tandis que \(C\) n’en a qu’un, de taille \(3\). Donc \(A\) et \(B\) sont semblables, mais \(C\) n’est semblable à aucune des deux. Concrètement, dans la base \((e_1, e_3, e_2)\), on a \(Be_1 = e_1\), \(Be_3 = e_1 + e_3\) et \(Be_2 = e_2\) : la matrice obtenue est \(A\).
- Les deux matrices sont triangulaires, de polynôme caractéristique \((X – 2)^2(X – 3)\). Ensuite, \(S_1 – 2I_3\) et \(S_2 – 2I_3 = \begin{pmatrix} 1 0 0 \\ 1 0 0 \\ 0 1 0 \end{pmatrix}\) sont toutes deux de rang \(2\). Pour la valeur propre \(2\), il y a donc un seul bloc, de taille \(2\), dans les deux cas. Les deux matrices ont pour réduite \(\mathrm{diag}(J_2(2), J_1(3))\) : elles sont semblables.
- On a \(\chi_{R_1} = X^2 + 1\) et \(\chi_{R_2} = X^2 – 0 \cdot X + (-1 + 2) = X^2 + 1\). Dans \(\mathbb{C}\), ce polynôme a deux racines simples \(\pm i\), donc les deux matrices sont semblables à \(\mathrm{diag}(i, -i)\). Elles sont donc semblables sur \(\mathbb{C}\), et par conséquent sur \(\mathbb{R}\) d’après le cours. Pour une matrice explicite, on prend \(f_1 = e_1\) et \(f_2 = R_2 e_1 = (1, 1)\). Comme \(R_2^2 = -I_2\), on a \(R_2 f_1 = f_2\) et \(R_2 f_2 = -f_1\). Avec \(P = \begin{pmatrix} 1 1 \\ 0 1 \end{pmatrix}\), on obtient \(P^{-1}R_2P = R_1\). On vérifie : \(R_2P = PR_1 = \begin{pmatrix} 1 -1 \\ 1 0 \end{pmatrix}\).
Corrigé de l’exercice 15 : Exponentielle de blocs de Jordan
- On écrit \(tJ_3(\lambda) = \lambda t I_3 + tJ_3(0)\). Ces deux matrices commutent, et \(J_3(0)^3 = 0\), avec \(J_3(0)^2 = E_{13}\). Par conséquent, \(\exp(tJ_3(\lambda)) = e^{\lambda t}\big(I_3 + tJ_3(0) + \frac{t^2}{2}J_3(0)^2\big)\). Ainsi \(\exp(tJ_3(\lambda)) = e^{\lambda t}\begin{pmatrix} 1 t t^2/2 \\ 0 1 t \\ 0 0 1 \end{pmatrix}\).
- On calcule \(N^2 = \begin{pmatrix} 0 0 3 \\ 0 0 0 \\ 0 0 0 \end{pmatrix}\) et \(N^3 = 0\). Donc \(\exp(N) = I_3 + N + \frac{1}{2}N^2\), avec pour coefficient \((1, 3)\) la somme \(2 + \frac{3}{2}\). On obtient \(\exp(N) = \begin{pmatrix} 1 1 7/2 \\ 0 1 3 \\ 0 0 1 \end{pmatrix}\).
- On a \(K^2 = -I_2\). Ainsi \(K^{2p} = (-1)^p I_2\) et \(K^{2p+1} = (-1)^p K\). En séparant les termes pairs et impairs de la série, \[\exp(\theta K) = \Big(\sum_{p \geq\, 0} \frac{(-1)^p \theta^{2p}}{(2p)!}\Big) I_2 + \Big(\sum_{p \geq\, 0} \frac{(-1)^p \theta^{2p+1}}{(2p+1)!}\Big) K.\] Donc \(\exp(\theta K) = \begin{pmatrix} \cos\theta -\sin\theta \\ \sin\theta \cos\theta \end{pmatrix}\) : c’est la rotation d’angle \(\theta\).
Corrigé de l’exercice 16 : Systèmes différentiels et exponentielle
- D’après l’exercice 3, \(tB = 2tI_2 + tN\) avec \(N^2 = 0\), et ces deux matrices commutent. Donc \(\exp(tB) = e^{2t}(I_2 + tN)\). Ainsi \(\exp(tB) = e^{2t}\begin{pmatrix} 1 + t t \\ -t 1 – t \end{pmatrix}\).
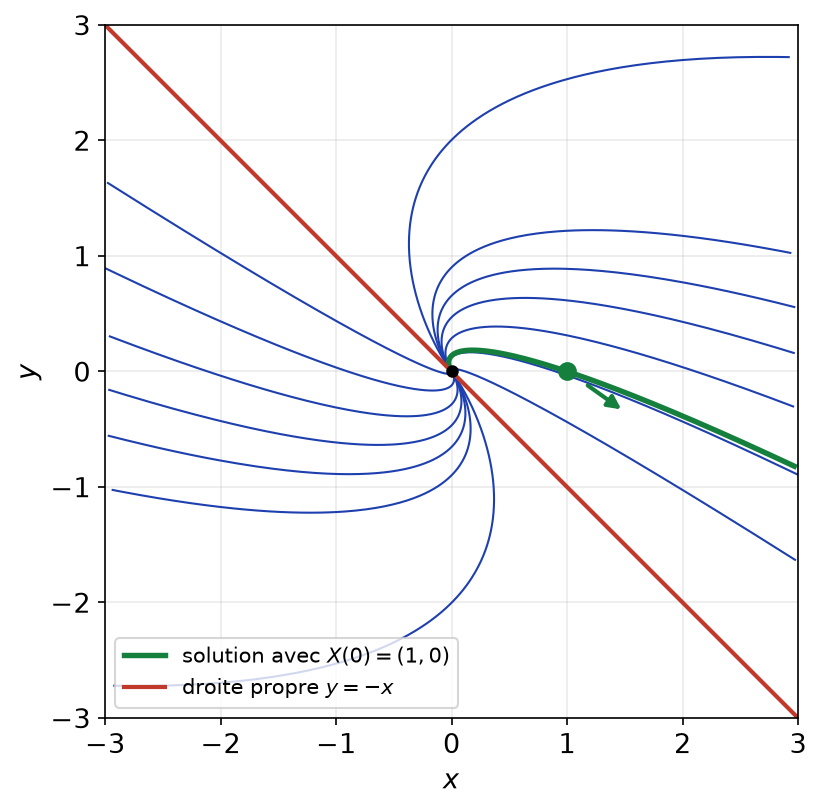
- Le système s’écrit \(X^{\prime} = BX\). Sa solution vaut \(X(t) = \exp(tB)X(0)\), c’est-à-dire la première colonne de \(\exp(tB)\). Donc \(x(t) = (1 + t)e^{2t}\) et \(y(t) = -t\,e^{2t}\). On vérifie : \(x^{\prime}(t) = (3 + 2t)e^{2t} = 3x + y\) et \(y^{\prime}(t) = -(1 + 2t)e^{2t} = -x + y\). Par croissances comparées, \(te^{2t} \to 0\) quand \(t \to -\infty\). La solution tend donc vers l’origine. La figure ci-dessous montre cette trajectoire parmi d’autres : toutes sortent de l’origine tangentiellement à la droite propre \(y = -x\).
- D’après l’exercice 4, \(A = D + N\) avec \(\exp(tD) = e^t P_1 + e^{2t} P_2\) et \(\exp(tN) = I_3 + tN\). Comme \(P_1 N = N\) et \(P_2 N = 0\), on obtient \(\exp(tA) = e^t P_1 + e^{2t} P_2 + te^t N\). Ainsi \(\exp(tA) = \begin{pmatrix} (1 – t)e^t te^t 0 \\ -te^t (1 + t)e^t 0 \\ e^{2t} – e^t e^t – e^{2t} e^{2t} \end{pmatrix}\).
- La solution cherchée est la première colonne de \(\exp(tA)\). Donc \(X(t) = \big((1 – t)e^t,\ -te^t,\ e^{2t} – e^t\big)\). En \(t = 0\), on retrouve bien \((1, 0, 0)\).
Corrigé de l’exercice 17 : Exponentielle et commutation
- Comme \(A^2 = B^2 = 0\), on a \(\exp(A) = I_2 + A\) et \(\exp(B) = I_2 + B\). Ensuite, par un produit direct, \(\exp(A)\exp(B) = \begin{pmatrix} 2 1 \\ 1 1 \end{pmatrix}\) et \(\exp(B)\exp(A) = \begin{pmatrix} 1 1 \\ 1 2 \end{pmatrix}\).
- On a \(A + B = \begin{pmatrix} 0 1 \\ 1 0 \end{pmatrix}\), donc \((A + B)^2 = I_2\). En séparant les puissances paires et impaires, \(\exp(A + B) = \mathrm{ch}(1) I_2 + \mathrm{sh}(1)(A + B)\). Ainsi \(\exp(A + B) = \begin{pmatrix} \mathrm{ch}\,1 \mathrm{sh}\,1 \\ \mathrm{sh}\,1 \mathrm{ch}\,1 \end{pmatrix}\), avec \(\mathrm{ch}\,1 \approx 1{,}54\). Cette matrice diffère des deux produits. On en conclut que la formule \(\exp(A + B) = \exp(A)\exp(B)\) est fausse sans commutation ; d’ailleurs \(AB \neq BA\) ici.
- Toute matrice complexe est trigonalisable : \(M = PTP^{-1}\) avec \(T\) triangulaire supérieure, de diagonale \(\lambda_1, \ldots, \lambda_n\). Ensuite, \(T^k\) est triangulaire de diagonale \(\lambda_i^k\). Par passage à la limite, \(\exp(T)\) est triangulaire de diagonale \(e^{\lambda_i}\). Comme \(\exp(M) = P\exp(T)P^{-1}\), on obtient \(\det \exp(M) = \prod e^{\lambda_i} = e^{\sum \lambda_i}\). Donc \(\det \exp(M) = e^{\mathrm{tr}(M)}\).
Corrigé de l’exercice 18 : Base duale dans le plan et l’espace
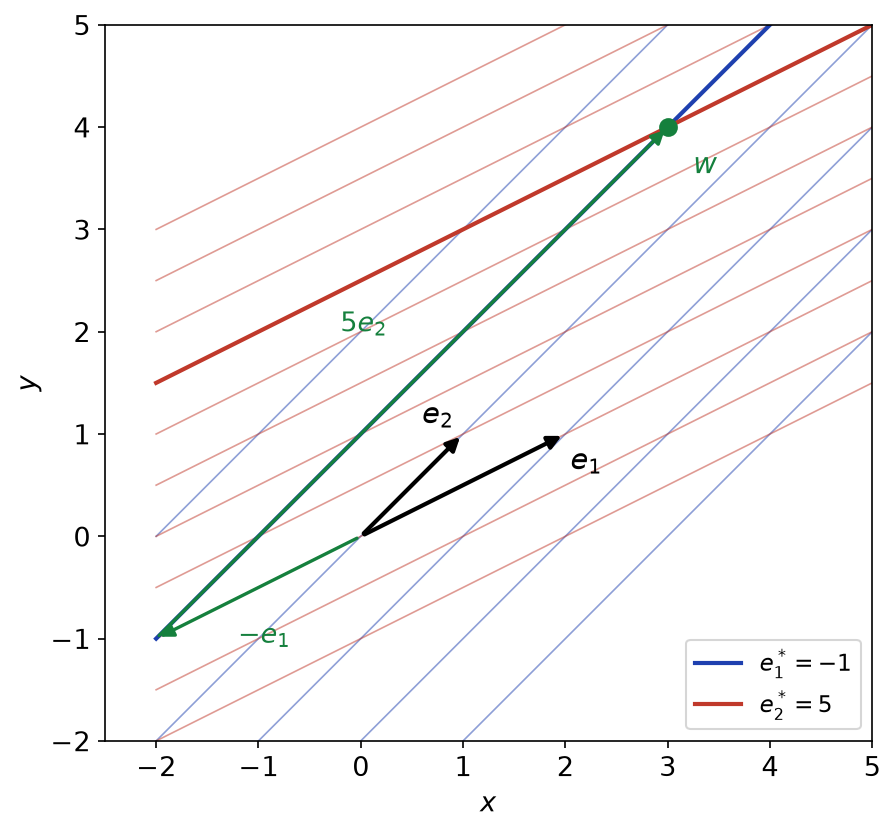
- La matrice \(P = \begin{pmatrix} 2 1 \\ 1 1 \end{pmatrix}\) a pour déterminant \(1\), donc \((e_1, e_2)\) est une base. D’après le cours, les lignes de \(P^{-1} = \begin{pmatrix} 1 -1 \\ -1 2 \end{pmatrix}\) donnent la base duale. Ainsi \(e_1^*(x, y) = x – y\) et \(e_2^*(x, y) = -x + 2y\). On vérifie : \(e_1^*(e_1) = 1\), \(e_1^*(e_2) = 0\), \(e_2^*(e_1) = 0\) et \(e_2^*(e_2) = 1\).
- Les coordonnées de \(w\) sont \(e_1^*(w) = 3 – 4 = -1\) et \(e_2^*(w) = -3 + 8 = 5\). Donc \(w = -e_1 + 5e_2\). La figure ci-dessous le confirme : \(w\) est à l’intersection de la droite \(e_1^* = -1\) et de la droite \(e_2^* = 5\).
- La matrice \(Q = \begin{pmatrix} 1 1 0 \\ 0 1 1 \\ 1 0 1 \end{pmatrix}\) a pour déterminant \(2\), et \[Q^{-1} = \frac{1}{2}\begin{pmatrix} 1 -1 1 \\ 1 1 -1 \\ -1 1 1 \end{pmatrix}.\] Donc \(u_1^* = \frac{1}{2}(x – y + z)\), \(u_2^* = \frac{1}{2}(x + y – z)\) et \(u_3^* = \frac{1}{2}(-x + y + z)\). On vérifie par exemple que \(u_1^*(u_1) = 1\), \(u_1^*(u_2) = 0\) et \(u_1^*(u_3) = 0\).
- Pour \((2, 3, 5)\), on trouve \(u_1^* = 2\), \(u_2^* = 0\) et \(u_3^* = 3\). Ainsi \((2, 3, 5) = 2u_1 + 3u_3\). Ensuite, le plan \(\mathrm{Vect}(u_1, u_2)\) est le noyau de \(u_3^*\). Il a pour équation \(-x + y + z = 0\).
Corrigé de l’exercice 19 : Base duale et interpolation de Lagrange
- Comme \(\dim E^* = \dim E = 3\), il suffit de montrer que la famille est libre. Supposons \(a_0\varphi_0 + a_1\varphi_1 + a_2\varphi_2 = 0\). En l’appliquant à \((X – 1)(X – 2)\), qui s’annule en \(1\) et \(2\), on obtient \(2a_0 = 0\). De même, \(X(X – 2)\) donne \(-a_1 = 0\), et \(X(X – 1)\) donne \(2a_2 = 0\). La famille est donc une base de \(E^*\).
- On cherche \(L_j\) tel que \(L_j(i) = \delta_{ij}\). Le polynôme \(L_j\) s’annule aux deux autres points, donc il est proportionnel à leur produit. On obtient \(L_0 = \frac{(X – 1)(X – 2)}{2}\), \(L_1 = -X(X – 2)\) et \(L_2 = \frac{X(X – 1)}{2}\).
- Pour toute forme \(\psi\), on a \(\psi = \sum \psi(L_i)\varphi_i\), car les deux membres coïncident sur la base \((L_i)\). Calculons : \(\int_0^2 \frac{(x – 1)(x – 2)}{2}\,\mathrm{d}x = \frac{1}{2}\big(\frac{8}{3} – 6 + 4\big) = \frac{1}{3}\). Ensuite, \(\int_0^2 -x(x – 2)\,\mathrm{d}x = -\big(\frac{8}{3} – 4\big) = \frac{4}{3}\). Enfin, \(\int_0^2 \frac{x(x – 1)}{2}\,\mathrm{d}x = \frac{1}{2}\big(\frac{8}{3} – 2\big) = \frac{1}{3}\). Par conséquent, \(\int_0^2 P(x)\,\mathrm{d}x = \frac{1}{3}\big(P(0) + 4P(1) + P(2)\big)\) pour tout \(P \in \mathbb{R}_2[X]\) : c’est la formule de Simpson, exacte en degré \(2\).
- Le sous-espace \(F = \ker \varphi_1\) est un hyperplan, donc \(\dim F^{\perp} = 3 – 2 = 1\). Or \(\varphi_1\) s’annule sur \(F\) par définition. Donc \(F^{\perp} = \mathrm{Vect}(\varphi_1)\).
Corrigé de l’exercice 20 : Transposée, orthogonal et rang
- Une forme \(\varphi\) est dans \(\ker u^{\top}\) si et seulement si \(\varphi \circ u = 0\), c’est-à-dire si \(\varphi\) s’annule sur \(\mathrm{Im}\,u\). Ainsi \(\ker u^{\top} = (\mathrm{Im}\,u)^{\perp}\), de dimension \(n – \mathrm{rg}\,u\). Par le théorème du rang appliqué à \(u^{\top}\), on obtient \(\mathrm{rg}\,u^{\top} = n – (n – \mathrm{rg}\,u) = \mathrm{rg}\,u\).
- Supposons \(F\) stable par \(u\). Soient \(\varphi \in F^{\perp}\) et \(x \in F\). Alors \(u^{\top}(\varphi)(x) = \varphi(u(x)) = 0\), car \(u(x) \in F\). Donc \(F^{\perp}\) est stable par \(u^{\top}\). Réciproquement, supposons \(F^{\perp}\) stable et soit \(x \in F\) tel que \(y = u(x) \notin F\). En complétant une base de \(F\) par \(y\), puis en une base de \(E\), la forme coordonnée associée à \(y\) est dans \(F^{\perp}\) et vaut \(1\) en \(y\). Pour cette forme \(\varphi\), on a \(u^{\top}(\varphi)(x) = \varphi(y) = 1\), donc \(u^{\top}(\varphi) \notin F^{\perp}\). C’est absurde. Ainsi \(F\) est stable par \(u\) si et seulement si \(F^{\perp}\) est stable par \(u^{\top}\).
- Si \(H = \ker \varphi\), alors \(H^{\perp} = \mathrm{Vect}(\varphi)\), car c’est une droite qui contient \(\varphi\). Une droite est stable si et seulement si elle est engendrée par un vecteur propre. Donc \(H\) est stable par \(u\) si et seulement si \(\varphi\) est vecteur propre de \(u^{\top}\).
- Une forme \(\varphi(x, y, z) = ax + by + cz\) a pour image \(\varphi \circ u\), de coefficients \((a, b, c)A\). On cherche donc les vecteurs propres de \(A^{\top} = \begin{pmatrix} 0 -1 1 \\ 1 2 -1 \\ 0 0 2 \end{pmatrix}\). Pour la valeur propre \(1\), on trouve \(c = 0\) et \(a + b = 0\), d’où \((1, -1, 0)\). Pour la valeur propre \(2\), on trouve \(a = c\) et \(b = -a\), d’où \((1, -1, 1)\). Chaque sous-espace propre est une droite, car \(\mathrm{rg}(A^{\top} – \lambda I_3) = \mathrm{rg}(A – \lambda I_3) = 2\). Les plans stables sont donc exactement \(x – y = 0\) et \(x – y + z = 0\). Le second est \(F_1\) ; le premier est \(\mathrm{Vect}\big((1, 1, 0), e_3\big)\), somme des deux droites propres de \(A\).
Corrigé de l’exercice 21 : Racines carrées de matrices
- Supposons \(R^2 = N\). Alors \(R^6 = N^3 = 0\), donc \(R\) est nilpotente. D’après le cours, son indice est au plus \(3\), d’où \(R^3 = 0\). Mais alors \(N^2 = R^4 = R^3 R = 0\). Or \(N^2 = E_{13} \neq 0\). C’est absurde : \(J_3(0)\) n’a pas de racine carrée.
- Comme \(N^3 = 0\), on a \((I_3 + aN + bN^2)^2 = I_3 + 2aN + (a^2 + 2b)N^2\). Il faut \(2a = 1\) et \(a^2 + 2b = 0\). Donc \(a = \frac{1}{2}\) et \(b = -\frac{1}{8}\) : la matrice \(R = I_3 + \frac{1}{2}N – \frac{1}{8}N^2\) vérifie \(R^2 = I_3 + N = J_3(1)\).
- Écrivons \(J_k(\lambda) = \lambda(I_k + M)\) avec \(M = \frac{1}{\lambda}J_k(0)\), nilpotente d’indice \(k\). Soit \(\mu \in \mathbb{C}\) tel que \(\mu^2 = \lambda\). Le développement en série entière \(\sqrt{1 + x} = \sum_{j \geq\, 0} c_j x^j\) vérifie \(\big(\sum c_j x^j\big)^2 = 1 + x\) sur \(]-1, 1[\). Par unicité des coefficients, le polynôme \(T = \sum_{j=0}^{k-1} c_j X^j\) vérifie \(T^2 \equiv 1 + X\) modulo \(X^k\). Comme \(M^k = 0\), on en déduit \(T(M)^2 = I_k + M\). Ainsi \(R = \mu\,T(M)\) vérifie \(R^2 = J_k(\lambda)\), et \(R\) est un polynôme en \(J_k(\lambda)\), puisque \(M = \frac{1}{\lambda}(J_k(\lambda) – \lambda I_k)\).
- Soit \(A \in \mathrm{GL}_n(\mathbb{C})\). On écrit \(A = P\,\mathrm{diag}(J_{k_1}(\lambda_1), \ldots, J_{k_s}(\lambda_s))P^{-1}\). Toutes les valeurs propres sont non nulles, car \(A\) est inversible. La question précédente fournit des \(R_i\) tels que \(R_i^2 = J_{k_i}(\lambda_i)\). Alors \(R = P\,\mathrm{diag}(R_1, \ldots, R_s)P^{-1}\) vérifie \(R^2 = A\).
Corrigé de l’exercice 22 : Commutant d’un nilpotent cyclique
- L’identité commute avec \(v\). Si \(w_1\) et \(w_2\) commutent avec \(v\), alors \(w_1 + \alpha w_2\) aussi, et \(w_1 w_2 v = w_1 v w_2 = v w_1 w_2\). Donc \(\mathcal{C}(v)\) est une sous-algèbre. Enfin, tout polynôme en \(v\) commute avec \(v\), d’où \(\mathbb{K}[v] \subset \mathcal{C}(v)\).
- Posons \(Q = \sum_{k=0}^{n-1} c_k X^k\), de sorte que \(w(x) = Q(v)(x)\). Pour \(0 \leq\, j \leq\, n – 1\), comme \(w\) commute avec \(v^j\), on a \(w(v^j(x)) = v^j(w(x)) = v^j Q(v)(x) = Q(v)(v^j(x))\). Ainsi \(w\) et \(Q(v)\) coïncident sur la base \(\mathcal{B}\). Donc \(w = Q(v) = \sum_{k=0}^{n-1} c_k v^k\).
- La question 2 donne \(\mathcal{C}(v) \subset \mathbb{K}[v]\), d’où l’égalité. Ensuite, \(\pi_v = X^n\), donc \((\mathrm{id}, v, \ldots, v^{n-1})\) est une base de \(\mathbb{K}[v]\). Ainsi \(\mathcal{C}(v) = \mathbb{K}[v]\) et \(\dim \mathcal{C}(v) = n\).
- Les matrices qui commutent avec \(J = J_3(0)\) sont les \(aI_3 + bJ + cJ^2\). Ce sont exactement les matrices \(\begin{pmatrix} a b c \\ 0 a b \\ 0 0 a \end{pmatrix}\), avec \(a, b, c \in \mathbb{K}\).
Point de méthode : dès qu’un endomorphisme est cyclique, un vecteur cyclique suffit à déterminer entièrement tout endomorphisme qui commute avec lui.
Corrigé de l’exercice 23 : Matrices semblables à leur double
- Deux matrices semblables ont le même spectre. De plus, les valeurs propres de \(2A\) sont les \(2\lambda\), pour \(\lambda\) valeur propre de \(A\). Si \(\lambda \in \mathrm{Sp}(A)\), alors \(2\lambda \in \mathrm{Sp}(2A) = \mathrm{Sp}(A)\). Par récurrence, \(2^j\lambda \in \mathrm{Sp}(A)\) pour tout \(j\). Or le spectre est fini ; si \(\lambda \neq 0\), les \(2^j \lambda\) seraient deux à deux distincts. Donc \(\mathrm{Sp}(A) = \{0\}\) et \(\chi_A = X^n\). Par le théorème de Cayley-Hamilton, \(A^n = 0\) : \(A\) est nilpotente.
- On a \((\Delta^{-1}J_k(0)\Delta)_{ij} = 2^{-(i-1)}(J_k(0))_{ij}\,2^{j-1}\). Ce coefficient n’est non nul que pour \(j = i + 1\), où il vaut \(2^{-(i-1)} \cdot 2^{i} = 2\). Ainsi \(\Delta^{-1}J_k(0)\Delta = 2J_k(0)\).
- Si \(A\) est nilpotente, on écrit \(A = PJP^{-1}\) avec \(J = \mathrm{diag}(J_{k_1}(0), \ldots, J_{k_s}(0))\). En posant \(\Delta^{\prime} = \mathrm{diag}(\Delta_{k_1}, \ldots, \Delta_{k_s})\), on obtient \(\Delta^{\prime -1}J\Delta^{\prime} = 2J\). Par conséquent, \(2A = P\Delta^{\prime -1}J\Delta^{\prime}P^{-1}\). Donc \(2A\) est semblable à \(J\), puis à \(A\).
- Le même calcul avec \(\Delta_\mu = \mathrm{diag}(1, \mu, \ldots, \mu^{k-1})\) donne \(\Delta_\mu^{-1}J_k(0)\Delta_\mu = \mu J_k(0)\). Toute matrice nilpotente est donc semblable à \(\mu A\) pour tout \(\mu \neq 0\).
Corrigé de l’exercice 24 : Problème : exponentielle diagonalisable
- Les matrices \(D\) et \(N\) commutent, donc \(\exp(A) = \exp(D + N) = \exp(D)\exp(N)\). Ensuite, si \(D = Q\Lambda Q^{-1}\) avec \(\Lambda\) diagonale, on a \(\exp(D) = Q\exp(\Lambda)Q^{-1}\), et \(\exp(\Lambda)\) est diagonale. Donc \(\exp(D)\) est diagonalisable.
- Comme \(N^n = 0\), on a \(\exp(N) – I_n = \sum_{k=1}^{n-1} \frac{N^k}{k!} = N\sum_{k=0}^{n-2} \frac{N^k}{(k+1)!}\). Le terme d’indice \(k = n – 1\) de \(S\) donne \(N^n = 0\), donc on peut l’ajouter : \(\exp(N) – I_n = NS\). Ensuite, \(S = I_n + NT\) avec \(T\) polynôme en \(N\). La matrice \(NT\) est nilpotente, car \(N\) et \(T\) commutent. Donc \(S\) est inversible (son inverse est \(\sum_{j} (-NT)^j\)) et commute avec \(N\).
- Posons \(D^{\prime} = \exp(D)\) et \(N^{\prime} = \exp(D)(\exp(N) – I_n)\). Alors \(\exp(A) = D^{\prime} + N^{\prime}\), et \(D^{\prime}\) est diagonalisable. Ensuite, \(\exp(D)\) est limite de polynômes en \(D\), donc un polynôme en \(D\), puisque \(\mathbb{C}[D]\) est un sous-espace fermé. Il commute donc avec \(N\), avec \(S\) et avec \(N^{\prime}\). Enfin, \(N^{\prime n} = \exp(nD) N^n S^n = 0\). Par unicité de la décomposition de Dunford, celle de \(\exp(A)\) est \(D^{\prime} + N^{\prime}\).
- La matrice \(\exp(A)\) est diagonalisable si et seulement si sa partie nilpotente \(N^{\prime} = \exp(D)NS\) est nulle. Comme \(\exp(D)\) et \(S\) sont inversibles, cela équivaut à \(N = 0\), c’est-à-dire à \(A = D\). Donc \(\exp(A)\) est diagonalisable si et seulement si \(A\) l’est. Au passage, \(\exp(N) – I_n = NS\) est nul si et seulement si \(N = 0\) : \(\exp(N) = I_n \Leftrightarrow N = 0\).
- On a \(A = 2\pi K\), où \(K\) est la matrice de l’exercice 15. Ainsi \(\exp(A)\) est la rotation d’angle \(2\pi\). Donc \(\exp(A) = I_2\), qui est diagonale. Cependant, \(\chi_A = X^2 + 4\pi^2\) n’a pas de racine réelle, donc \(A\) n’est pas diagonalisable sur \(\mathbb{R}\). L’équivalence devient fausse avec « diagonalisable sur \(\mathbb{R}\) » ; elle reste vraie pour la diagonalisabilité sur \(\mathbb{C}\), puisque \(A\) a deux valeurs propres distinctes \(\pm 2i\pi\).
Point de méthode : l’unicité de la décomposition de Dunford est l’outil clé : on exhibe un couple qui convient, puis on lit la partie nilpotente.
Revenir aux énoncés des exercices
Pour aller plus loin en L3
- Le cours : réduction de Jordan, cours de maths en L3
- Les énoncés : exercices de maths en L3 sur réduction de Jordan
- Chapitre précédent : Corps, extensions et corps finis
- Chapitre suivant : Calcul différentiel dans les espaces normés
- Tester vos connaissances : QCM de maths en L3 par chapitre
- Le sommaire : tous les chapitres de maths de L3 et la licence de maths de L1 à L3