Ce chapitre clôt la partie sur les variables aléatoires discrètes du programme de MP. Il relie deux chapitres du premier semestre et du second : les séries entières et les probabilités. L’idée est de coder la loi d’une variable à valeurs entières dans une seule fonction, la fonction génératrice \(G_X(t) = E(t^X)\).
Le cours fonctions génératrices spé établit d’abord la convergence normale sur le disque unité fermé, puis le fait que \(G_X\) caractérise la loi. Vous apprendrez ensuite à lire l’espérance et la variance sur les dérivées en 1, avec les fonctions génératrices des lois de Bernoulli, binomiale, géométrique et de Poisson.
Enfin, la fonction génératrice d’une somme de variables indépendantes est un produit. Cet outil transforme alors des convolutions pénibles en simples calculs de fonctions. Il sert aussi aux dénombrements, aux temps d’attente et aux suites récurrentes, très fréquents à l’oral des concours.
Pour vous entraîner ensuite, travaillez les exercices de maths spé sur fonctions génératrices.
I. Définition des fonctions génératrices
Dans tout le chapitre, \((\Omega, \mathcal{A}, P)\) est un espace probabilisé. Les variables étudiées sont discrètes et prennent leurs valeurs dans \(\mathbb{N}\). L’idée est simple : on range les probabilités \(P(X = n)\) comme coefficients d’une série entière. Ainsi, la loi de \(X\) devient une fonction, et les calculs sur les lois deviennent des calculs d’analyse.
Soit \(X\) une variable aléatoire à valeurs dans \(\mathbb{N}\). On appelle fonction génératrice de \(X\) la fonction \(G_X\) définie par
\[G_X(t) = E(t^X) = \sum_{n=0}^{+\infty} P(X = n)\, t^n,\]
pour tout réel ou complexe \(t\) tel que la série converge.
L’égalité entre \(E(t^X)\) et la somme de la série est la formule de transfert appliquée à la fonction \(n \mapsto t^n\). En effet, la variable \(t^X\) est d’espérance finie dès que la famille \((P(X = n)\, t^n)_n\) est sommable.
Le rayon de convergence de la série entière \(\sum P(X = n)\, t^n\) est au moins égal à 1. De plus, cette série converge normalement sur le disque unité fermé \(\{t \in \mathbb{C},\ |t| \leq\, 1\}\). Par conséquent, \(G_X\) est continue sur ce disque, \(G_X(1) = 1\) et \(|G_X(t)| \leq\, 1\) pour \(|t| \leq\, 1\).
Pour \(|t| \leq\, 1\) et tout \(n\), on a \(|P(X = n)\, t^n| \leq\, P(X = n)\). Or la série \(\sum P(X = n)\) converge et vaut 1, car les événements \((X = n)\) forment un système complet. Donc la série converge normalement sur le disque fermé. Ensuite, chaque terme est continu, donc la somme est continue. Enfin, \(|G_X(t)| \leq\, \sum P(X = n) = 1\), avec égalité en \(t = 1\). Le rayon est donc au moins 1.
Si \(X\) suit la loi de Bernoulli \(\mathcal{B}(p)\), avec \(q = 1 – p\), alors \(G_X(t) = q + pt\) pour tout \(t\). Ici, la série est un polynôme : son rayon est infini. De même, toute variable bornée a pour fonction génératrice un polynôme.
Quelques valeurs particulières se lisent directement. D’abord, \(G_X(0) = P(X = 0)\). Ensuite, \(G_X(-1) = P(X \text{ pair}) – P(X \text{ impair})\). Par conséquent, \(P(X \text{ pair}) = \frac{1 + G_X(-1)}{2}\). De plus, sur \([0, 1]\), la fonction \(G_X\) est positive, croissante et convexe, car tous ses coefficients sont positifs. Cette convexité joue un rôle clé dans l’étude des probabilités d’extinction d’une population.
La figure ci-dessous trace plusieurs fonctions génératrices sur \([-1, 1]\). Toutes passent par le point \((1, 1)\), et toutes restent comprises entre \(-1\) et \(1\).
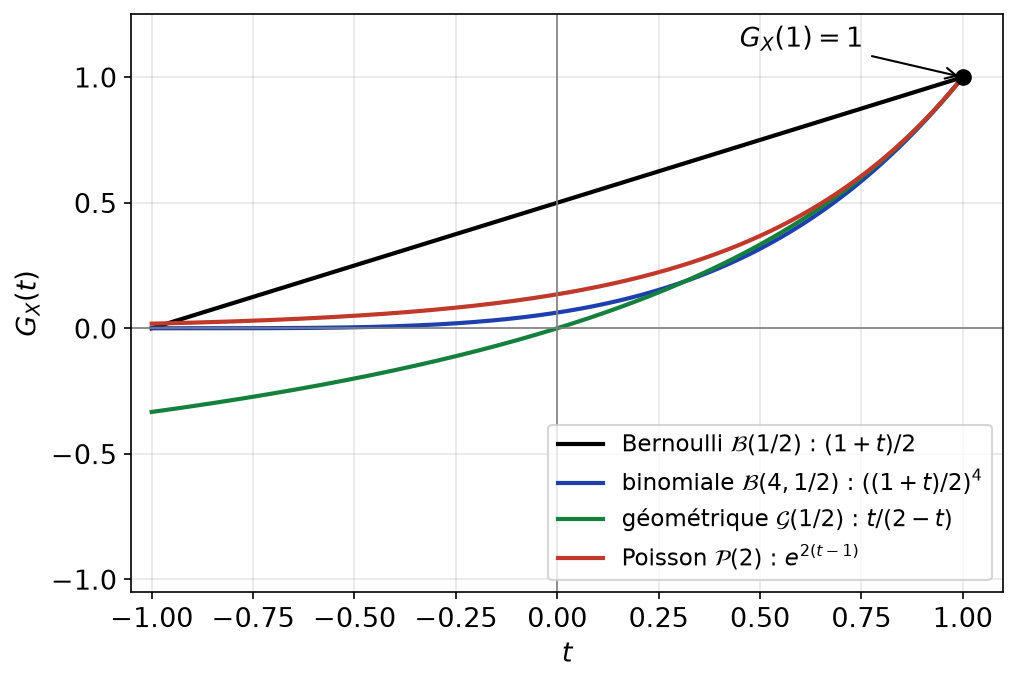
Le rayon peut valoir exactement 1. Par exemple, si \(P(X = n) = \dfrac{6}{\pi^2 n^2}\) pour \(n \geq\, 1\), la série \(\sum \frac{t^n}{n^2}\) a un rayon égal à 1. En revanche, il peut être infini (loi de Poisson) ou strictement compris entre 1 et \(+\infty\) (loi géométrique).
II. La fonction génératrice caractérise la loi
Une série entière de rayon non nul est déterminée par sa somme au voisinage de 0. D’où le résultat central du chapitre : connaître \(G_X\), c’est connaître la loi de \(X\).
Pour tout \(n \in \mathbb{N}\), on a \(P(X = n) = \dfrac{G_X^{(n)}(0)}{n!}\). En particulier, si \(X\) et \(Y\) sont à valeurs dans \(\mathbb{N}\) et si \(G_X\) et \(G_Y\) coïncident sur un intervalle \(]-a, a[\) avec \(a > 0\), alors \(X\) et \(Y\) ont la même loi.
La fonction \(G_X\) est la somme d’une série entière de rayon \(R \geq\, 1\). Elle est donc de classe \(\mathcal{C}^\infty\) sur \(]-1, 1[\), et ses coefficients s’obtiennent par la formule de Taylor : \(a_n = G_X^{(n)}(0)/n!\). Ensuite, si \(G_X = G_Y\) sur \(]-a, a[\), leurs dérivées en 0 coïncident à tout ordre. Par conséquent, \(P(X = n) = P(Y = n)\) pour tout \(n\).
Pour retrouver une loi à partir de sa fonction génératrice :
- on développe \(G_X(t)\) en série entière au voisinage de 0, avec les développements usuels (\(e^t\), \(\frac{1}{1-t}\), \((1+t)^\alpha\)) ;
- si \(G_X\) est une fraction rationnelle, on la décompose d’abord en éléments simples ;
- on lit \(P(X = n)\) comme le coefficient de \(t^n\) ;
- enfin, on reconnaît si possible une loi usuelle, éventuellement décalée.
Cherchons la loi de \(X\) telle que \(G_X(t) = \dfrac{(1+t)\,e^{t-1}}{2}\). D’abord, \(e^{t-1} = e^{-1} \sum_{k \geq\, 0} \frac{t^k}{k!}\). Ensuite, on multiplie par \(1 + t\) :
\[G_X(t) = \frac{e^{-1}}{2} \sum_{n \geq\, 0} (\frac{1}{n!} + \frac{1}{(n-1)!}) t^n,\]
avec la convention \(\frac{1}{(-1)!} = 0\). Donc \(P(X = n) = \dfrac{e^{-1}}{2}(\dfrac{1}{n!} + \dfrac{1}{(n-1)!})\). Nous verrons plus loin que \(X\) a la loi d’une somme \(B + Y\), avec \(B \sim \mathcal{B}(1/2)\) et \(Y \sim \mathcal{P}(1)\) indépendantes.
III. Fonctions génératrices des lois usuelles
Les quatre lois du programme ont des fonctions génératrices simples. Il faut les connaître par cœur, mais aussi savoir les retrouver en quelques lignes.
Soit \(p \in ]0, 1[\), \(q = 1 – p\), \(n \in \mathbb{N}^*\) et \(\lambda > 0\).
- Loi de Bernoulli \(\mathcal{B}(p)\) : \(G_X(t) = q + pt\), pour tout \(t \in \mathbb{R}\).
- Loi binomiale \(\mathcal{B}(n, p)\) : \(G_X(t) = (q + pt)^n\), pour tout \(t \in \mathbb{R}\).
- Loi géométrique \(\mathcal{G}(p)\), sur \(\mathbb{N}^*\) : \(G_X(t) = \dfrac{pt}{1 – qt}\), pour \(|t| < \dfrac{1}{q}\).
- Loi de Poisson \(\mathcal{P}(\lambda)\) : \(G_X(t) = e^{\lambda(t – 1)}\), pour tout \(t \in \mathbb{R}\).
Pour la loi binomiale, la formule du binôme donne \(\sum_{k=0}^{n} \binom\,{n}{k} p^k q^{n-k} t^k = (pt + q)^n\). Pour la loi géométrique, \(P(X = k) = q^{k-1} p\) pour \(k \geq\, 1\). Ainsi, pour \(|qt| < 1\) :
\[G_X(t) = \sum_{k=1}^{+\infty} p\, q^{k-1} t^k = pt \sum_{j=0}^{+\infty} (qt)^j = \frac{pt}{1 – qt}.\]
Enfin, pour la loi de Poisson, on reconnaît la série exponentielle :
\[G_X(t) = \sum_{k=0}^{+\infty} e^{-\lambda} \frac{\lambda^k}{k!} t^k = e^{-\lambda} e^{\lambda t} = e^{\lambda(t-1)}.\]
Une transformation affine de la variable se traduit simplement. Si \(a, b \in \mathbb{N}\), alors \(G_{aX + b}(t) = E(t^{aX+b}) = t^b\, G_X(t^a)\). Par exemple, si \(X \sim \mathcal{G}(p)\), la variable \(X – 1\), à valeurs dans \(\mathbb{N}\), vérifie \(G_{X-1}(t) = \dfrac{p}{1 – qt}\).
Le programme définit la loi géométrique sur \(\mathbb{N}^*\) : c’est le rang du premier succès. Si l’énoncé compte le nombre d’échecs avant le premier succès, la variable vaut \(X – 1\) et sa fonction génératrice perd le facteur \(t\).
IV. Espérance, variance et fonction génératrice
La fonction génératrice contient aussi les moments de \(X\). Autrement dit, dériver \(G_X\) en 1 revient à calculer une espérance. Le point délicat est que 1 est au bord de l’intervalle de convergence quand le rayon vaut 1.
1. Espérance
La variable \(X\) est d’espérance finie si, et seulement si, \(G_X\) est dérivable (à gauche) en 1. Dans ce cas, \(E(X) = G_X^{\prime}(1)\).
Pour \(t \in [0, 1[\), on utilise \(1 – t^n = (1 – t)(1 + t + \cdots + t^{n-1})\). Ainsi :
\[\frac{G_X(1) – G_X(t)}{1 – t} = \sum_{n=1}^{+\infty} P(X = n) \sum_{k=0}^{n-1} t^k = \sum_{k=0}^{+\infty} P(X > k)\, t^k.\]
L’interversion est permise, car tous les termes sont positifs (sommation par paquets). Or cette dernière fonction est croissante en \(t\). Elle a donc une limite en \(1^-\), égale à \(\sum_{k \geq\, 0} P(X > k)\), finie ou non. D’après le chapitre précédent, cette somme vaut \(E(X)\). Par conséquent, le taux d’accroissement a une limite finie si, et seulement si, \(E(X) < +\infty\).
Le cas d’une espérance infinie se voit sur le graphe. Comme le montre la figure ci-dessous, avec \(P(X = n) = \frac{6}{\pi^2 n^2}\), les cordes issues de \((1, 1)\) deviennent de plus en plus raides. En effet, \(E(X) = \frac{6}{\pi^2}\sum \frac{1}{n} = +\infty\) : la courbe arrive en 1 avec une demi-tangente verticale.
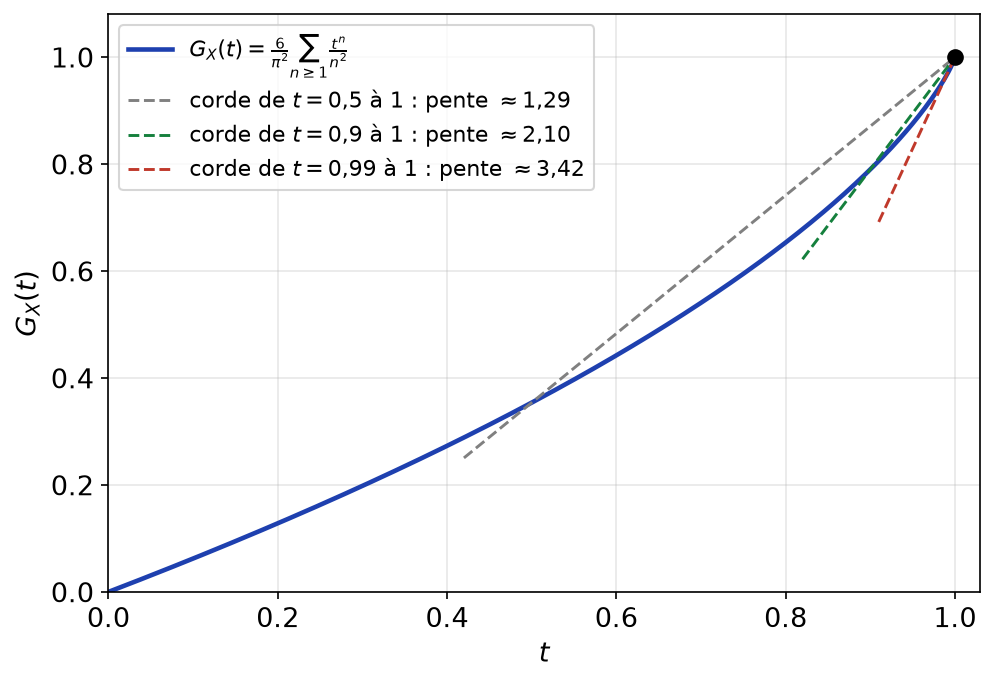
Quand le rayon vaut exactement 1, le point 1 est au bord de l’intervalle ouvert de convergence. On ne peut donc pas y appliquer directement le théorème de dérivation d’une série entière. Il faut soit utiliser le théorème ci-dessus, soit prouver la convergence normale de la série dérivée sur \([0, 1]\). En revanche, si le rayon est strictement supérieur à 1, la fonction \(G_X\) est de classe \(\mathcal{C}^\infty\) au voisinage de 1, et tous les moments de \(X\) sont finis.
2. Variance
Si \(X\) admet un moment d’ordre 2, alors \(G_X\) est de classe \(\mathcal{C}^2\) sur \([-1, 1]\), et
\[G_X^{\prime\prime}(1) = E\big(X(X-1)\big), \qquad V(X) = G_X^{\prime\prime}(1) + G_X^{\prime}(1) – G_X^{\prime}(1)^2.\]
Réciproquement, si \(G_X\) est deux fois dérivable en 1, alors \(X\) admet un moment d’ordre 2.
Supposons \(E(X^2)\) finie. Pour \(|t| \leq\, 1\), les séries dérivées vérifient \(|n P(X = n) t^{n-1}| \leq\, n P(X = n)\) et \(|n(n-1) P(X = n) t^{n-2}| \leq\, n^2 P(X = n)\). Ce sont des majorants sommables. Donc les séries dérivées convergent normalement sur \([-1, 1]\). Le théorème de dérivation terme à terme donne alors \(G_X\) de classe \(\mathcal{C}^2\) et \(G_X^{\prime\prime}(1) = \sum n(n-1) P(X = n) = E(X(X-1))\). Ensuite, \(V(X) = E(X^2) – E(X)^2 = E(X(X-1)) + E(X) – E(X)^2\). La réciproque se prouve comme dans le théorème précédent ; elle est admise ici.
Pour obtenir espérance et variance à partir de \(G_X\) :
- on vérifie que \(G_X\) est dérivable deux fois en 1 (c’est automatique si le rayon est strictement supérieur à 1) ;
- on calcule \(G_X^{\prime}(1) = E(X)\) puis \(G_X^{\prime\prime}(1) = E(X(X-1))\) ;
- enfin, on conclut par \(V(X) = G_X^{\prime\prime}(1) + G_X^{\prime}(1) – G_X^{\prime}(1)^2\).
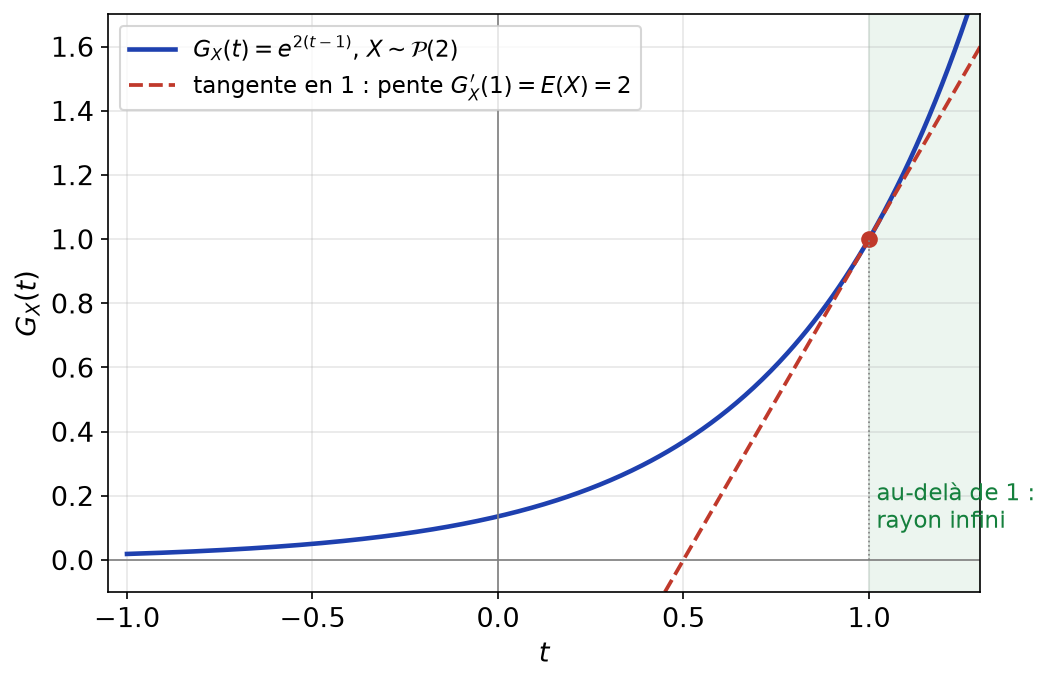
Si \(X \sim \mathcal{P}(\lambda)\), alors \(G_X(t) = e^{\lambda(t-1)}\), de rayon infini. D’abord, \(G_X^{\prime}(t) = \lambda e^{\lambda(t-1)}\), donc \(E(X) = \lambda\). Ensuite, \(G_X^{\prime\prime}(1) = \lambda^2\). Par conséquent, \(V(X) = \lambda^2 + \lambda – \lambda^2 = \lambda\).
De même, pour \(X \sim \mathcal{G}(p)\), le rayon vaut \(1/q > 1\). On trouve \(G_X^{\prime}(t) = \dfrac{p}{(1 – qt)^2}\) et \(G_X^{\prime\prime}(t) = \dfrac{2pq}{(1 – qt)^3}\). Donc \(E(X) = \dfrac{1}{p}\) et \(V(X) = \dfrac{2q}{p^2} + \dfrac{1}{p} – \dfrac{1}{p^2} = \dfrac{q}{p^2}\).
La figure ci-dessous illustre le cas de la loi de Poisson de paramètre 2. La tangente en 1 a pour pente l’espérance.
Plus généralement, si le rayon est strictement supérieur à 1, on a \(G_X^{(k)}(1) = E\big(X(X-1)\cdots(X-k+1)\big)\) pour tout \(k\). Ces nombres s’appellent les moments factoriels de \(X\).
V. Fonction génératrice d’une somme de variables indépendantes
C’est ici que l’outil devient vraiment puissant. En effet, la loi d’une somme se calcule en général par un produit de convolution, souvent pénible. Avec les fonctions génératrices, ce produit de convolution devient un simple produit de fonctions.
Si \(X\) et \(Y\) sont des variables indépendantes à valeurs dans \(\mathbb{N}\), alors, pour tout \(t \in [-1, 1]\),
\[G_{X+Y}(t) = G_X(t)\, G_Y(t).\]
Plus généralement, si \(X_1, \ldots, X_n\) sont mutuellement indépendantes, \(G_{X_1 + \cdots + X_n} = G_{X_1} \cdots G_{X_n}\) sur \([-1, 1]\).
Fixons \(t \in [-1, 1]\). Les variables \(t^X\) et \(t^Y\) sont des fonctions de \(X\) et de \(Y\) : elles sont donc indépendantes. De plus, elles sont bornées par 1, donc d’espérance finie. Ainsi, \(E(t^X t^Y) = E(t^X)\, E(t^Y)\), c’est-à-dire \(G_{X+Y}(t) = G_X(t)\, G_Y(t)\). Le cas de \(n\) variables s’obtient par récurrence, grâce au lemme des coalitions : \(X_1 + \cdots + X_{n-1}\) est indépendante de \(X_n\).
- Si \(X_1, \ldots, X_n\) sont indépendantes de loi \(\mathcal{B}(p)\), alors \(X_1 + \cdots + X_n \sim \mathcal{B}(n, p)\).
- Si \(X \sim \mathcal{B}(n, p)\) et \(Y \sim \mathcal{B}(m, p)\) sont indépendantes, alors \(X + Y \sim \mathcal{B}(n + m, p)\).
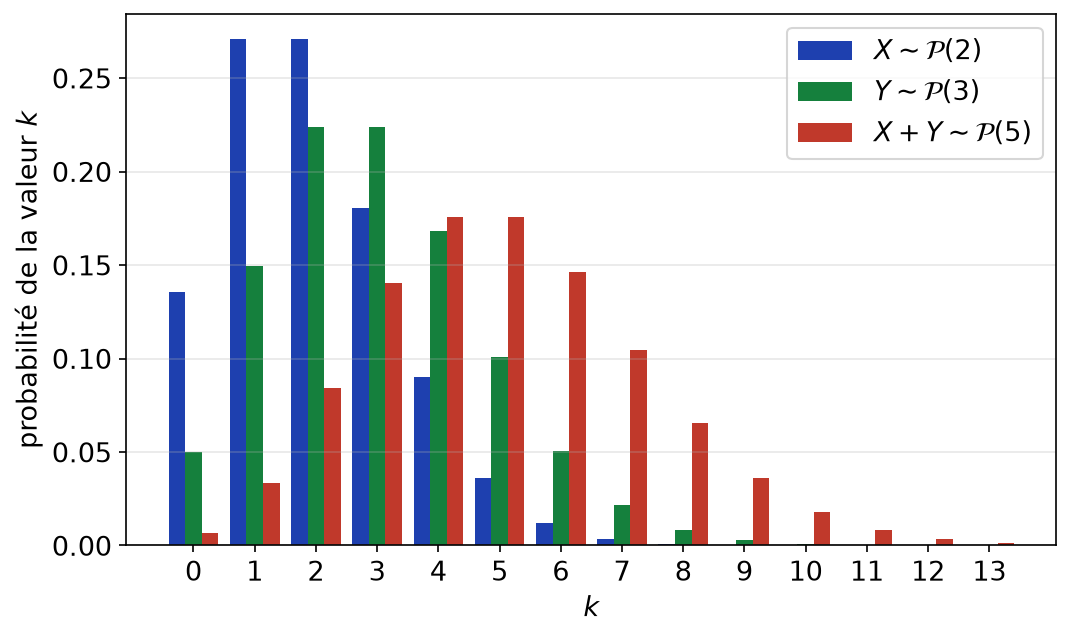
- Si \(X \sim \mathcal{P}(\lambda)\) et \(Y \sim \mathcal{P}(\mu)\) sont indépendantes, alors \(X + Y \sim \mathcal{P}(\lambda + \mu)\).
Pour le premier point, \(G_{X_1 + \cdots + X_n}(t) = (q + pt)^n\), qui est la fonction génératrice de \(\mathcal{B}(n, p)\). Ensuite, \((q + pt)^n (q + pt)^m = (q + pt)^{n+m}\). Enfin, \(e^{\lambda(t-1)} e^{\mu(t-1)} = e^{(\lambda + \mu)(t-1)}\). Dans chaque cas, on conclut par le théorème de caractérisation de la loi.
La figure ci-dessous montre la stabilité de la loi de Poisson : la somme de deux variables de Poisson indépendantes, de paramètres 2 et 3, suit la loi de Poisson de paramètre 5.
Pour identifier la loi d’une somme \(S = X_1 + \cdots + X_n\) de variables indépendantes :
- on vérifie l’hypothèse d’indépendance mutuelle ;
- on écrit \(G_S\) comme produit des \(G_{X_i}\) ;
- on reconnaît une fonction génératrice connue, ou bien on développe \(G_S\) en série entière pour lire \(P(S = k)\).
On lance \(n\) fois une pièce qui donne pile avec probabilité \(p\), et on note \(S\) le nombre de piles. Alors \(S = X_1 + \cdots + X_n\), où \(X_i\) vaut 1 si le \(i\)-ième lancer donne pile. Les \(X_i\) sont indépendantes de loi \(\mathcal{B}(p)\). Donc \(G_S(t) = (q + pt)^n\), et \(S \sim \mathcal{B}(n, p)\). Ensuite, \(G_S^{\prime}(1) = np\) et \(G_S^{\prime\prime}(1) = n(n-1)p^2\). On retrouve ainsi \(E(S) = np\) et \(V(S) = n(n-1)p^2 + np – n^2p^2 = npq\), sans aucune somme de coefficients binomiaux.
Sans indépendance, la formule est fausse. Par exemple, si \(X \sim \mathcal{B}(1/2)\), alors \(G_{X + X}(t) = G_{2X}(t) = \frac{1 + t^2}{2}\), alors que \(G_X(t)^2 = \frac{(1 + t)^2}{4}\).
Reprenons la loi de la partie II. Si \(B \sim \mathcal{B}(1/2)\) et \(Y \sim \mathcal{P}(1)\) sont indépendantes, alors \(G_{B+Y}(t) = \dfrac{1 + t}{2}\, e^{t-1}\). C’est bien la fonction étudiée : \(X\) a donc la loi de \(B + Y\). On en déduit sans calcul \(E(X) = \frac{1}{2} + 1 = \frac{3}{2}\).
VI. Dénombrements et récurrences par fonction génératrice
Le même principe s’applique hors des probabilités. À une suite \((a_n)\), on associe la série entière \(A(t) = \sum a_n t^n\). Une relation de récurrence devient alors une équation sur \(A\), et un dénombrement devient un produit de séries.
1. Lancers de dés et coefficients d’un polynôme
Soit \(S\) la somme de deux dés équilibrés indépendants. Chaque dé a pour fonction génératrice \(\frac{1}{6}(t + t^2 + \cdots + t^6)\). Donc \(G_S(t) = \frac{1}{36}(t + \cdots + t^6)^2\). Ainsi, \(36\, P(S = s)\) est le nombre de couples \((i, j) \in [\![1, 6]\!]^2\) tels que \(i + j = s\). La figure ci-dessous donne ces coefficients.
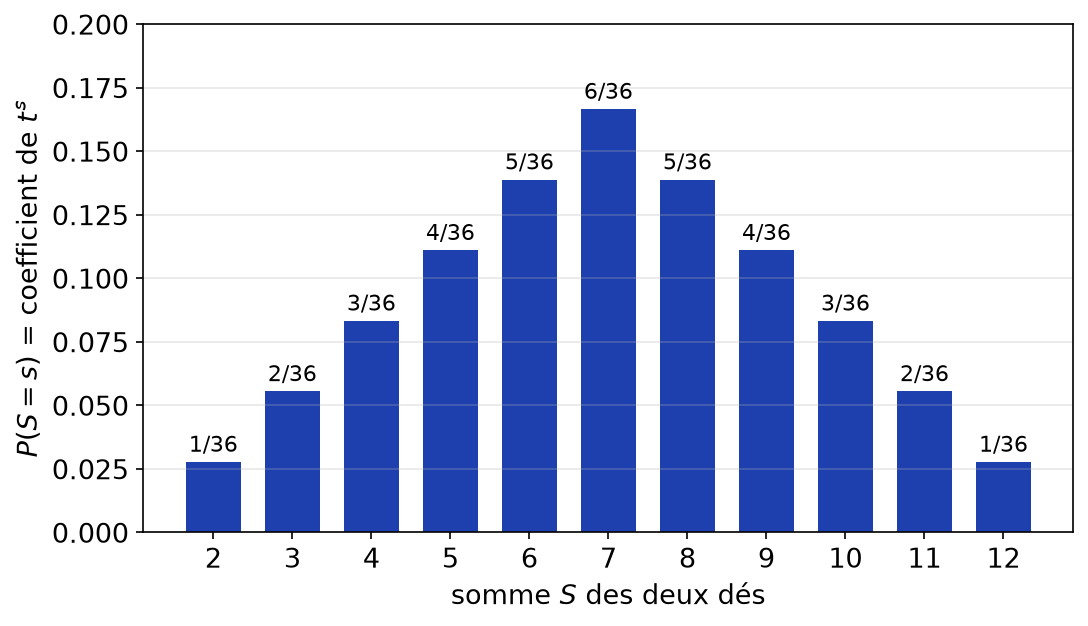
Cette lecture évite de dresser un tableau à 36 cases. Par exemple, \((t + \cdots + t^6)^2 = t^2 (1 + t + \cdots + t^5)^2\), et le coefficient de \(t^7\) vaut 6. Ainsi, \(P(S = 7) = \frac{6}{36} = \frac{1}{6}\) : c’est la valeur la plus probable. Avec trois dés, on développe de même \((1 – t^6)^3 (1 – t)^{-3}\), ce qui donne chaque probabilité en une ligne.
2. Suites récurrentes linéaires
Pour une suite définie par une récurrence linéaire à coefficients constants :
- on multiplie la relation par \(t^n\) et on somme sur les rangs où elle est valable ;
- on obtient une équation dont la solution \(A(t)\) est une fraction rationnelle ;
- on décompose \(A\) en éléments simples, puis on développe chaque terme en série entière ;
- enfin, on identifie les coefficients, ce qui justifie l’unicité du développement.
Soit \(a_n\) le nombre de façons de monter un escalier de \(n\) marches par pas de une ou deux marches. On a \(a_0 = a_1 = 1\) et \(a_n = a_{n-1} + a_{n-2}\) pour \(n \geq\, 2\). En effet, le premier pas compte une ou deux marches. Comme \(a_n \leq\, 2^n\), la série \(A(t) = \sum a_n t^n\) a un rayon au moins \(1/2\). Pour \(|t| < 1/2\), on somme la relation :
\[A(t) – 1 – t = t\big(A(t) – 1\big) + t^2 A(t), \quad \text{donc} \quad A(t) = \frac{1}{1 – t – t^2}.\]
Ensuite, \(1 – t – t^2 = (1 – \varphi t)(1 – \psi t)\), avec \(\varphi = \frac{1 + \sqrt{5}}{2}\) et \(\psi = \frac{1 – \sqrt{5}}{2}\). La décomposition en éléments simples donne alors \(a_n = \dfrac{\varphi^{n+1} – \psi^{n+1}}{\sqrt{5}}\).
En probabilités, on raisonne de même sur \(p_n = P(T = n)\), où \(T\) est un temps d’attente. On conditionne par les premiers lancers, par la formule des probabilités totales. On obtient une récurrence sur \(p_n\), puis une équation sur \(G_T\). Finalement, \(G_T^{\prime}(1)\) donne le temps moyen d’attente, sans connaître \(p_n\) explicitement.
Ce qu’il faut retenir
- \(G_X(t) = E(t^X) = \sum P(X = n)\, t^n\) : rayon au moins 1, convergence normale sur le disque unité fermé, \(G_X(1) = 1\).
- La fonction génératrice caractérise la loi : \(P(X = n) = G_X^{(n)}(0)/n!\).
- Bernoulli : \(q + pt\) ; binomiale : \((q + pt)^n\) ; géométrique : \(\frac{pt}{1 – qt}\) ; Poisson : \(e^{\lambda(t-1)}\).
- \(X\) est d’espérance finie si, et seulement si, \(G_X\) est dérivable en 1, et alors \(E(X) = G_X^{\prime}(1)\).
- Si \(X\) admet un moment d’ordre 2 : \(V(X) = G_X^{\prime\prime}(1) + G_X^{\prime}(1) – G_X^{\prime}(1)^2\).
- Pour des variables indépendantes, la fonction génératrice de la somme est le produit des fonctions génératrices.
- Les lois binomiales de même \(p\) et les lois de Poisson sont stables par somme indépendante.
- Pour retrouver une loi : développement en série entière, souvent après une décomposition en éléments simples.
- Une récurrence sur \(P(T = n)\) se traduit en une équation sur \(G_T\), qui donne \(E(T)\) par dérivation en 1.
Questions fréquentes sur fonctions génératrices
Pourquoi le rayon de convergence d'une fonction génératrice vaut-il au moins 1 ?
Pour \(|t| \leq\, 1\), on a \(|P(X = n)\, t^n| \leq\, P(X = n)\), et la série des \(P(X = n)\) converge vers 1. La série converge donc normalement sur le disque unité fermé. Le rayon peut être plus grand : il est infini pour une loi de Poisson et vaut \(1/q\) pour une loi géométrique.
Peut-on toujours écrire E(X) = G_X'(1) ?
Non : cette formule suppose que \(X\) est d’espérance finie, ce qui équivaut à la dérivabilité à gauche de \(G_X\) en 1. Si le rayon est strictement supérieur à 1, c’est automatique. Si le rayon vaut 1, il faut vérifier la dérivabilité, qui peut échouer, comme pour \(P(X = n) = \frac{1}{n(n+1)}\).
Comment calculer la variance avec la fonction génératrice ?
On calcule \(G_X^{\prime\prime}(1) = E(X(X-1))\), puis on utilise \(V(X) = G_X^{\prime\prime}(1) + G_X^{\prime}(1) – G_X^{\prime}(1)^2\). Pour un produit ou une puissance, la dérivée logarithmique \(G^{\prime}/G\) simplifie beaucoup les calculs, car \(G(1) = 1\).
La formule G_{X+Y} = G_X G_Y reste-t-elle vraie sans indépendance ?
Non, en général. Par exemple, si \(X \sim \mathcal{B}(1/2)\), alors \(G_{X+X}(t) = \frac{1 + t^2}{2}\), alors que \(G_X(t)^2 = \frac{(1+t)^2}{4}\). L’indépendance sert à écrire \(E(t^X t^Y) = E(t^X) E(t^Y)\).
Pour aller plus loin en maths spé
- Les énoncés : exercices de maths spé sur fonctions génératrices
- À maîtriser avant : Espérance, variance et loi faible des grands nombres, Séries entières
- Chapitre précédent : Espérance, variance et loi faible des grands nombres
- Chapitre suivant : Adjoint et isométries d'un espace euclidien
- Tester vos connaissances : QCM de maths spé par chapitre
- Le sommaire : tous les chapitres de maths spé et les chapitres de maths sup