Ce corrigé espérance L3 rédige chaque solution comme en partiel. Les hypothèses sont vérifiées, et les théorèmes sont cités par leur nom : transfert, Fubini-Tonelli, changement de variables, injectivité de la fonction caractéristique.
La démarche est toujours la même. D’abord, on identifie une loi par une fonction test ou par sa fonction caractéristique. Ensuite, on prouve l’indépendance par une factorisation de densité ou par une covariance nulle dans un vecteur gaussien. Soyez vigilant sur trois points : le difféomorphisme doit porter sur les bons ouverts, la valeur absolue du jacobien ne doit pas être oubliée, et une covariance nulle ne suffit pas hors du cadre gaussien.
Des figures illustrent les résultats obtenus : densités, simulations et nuages de points.
Les énoncés se trouvent sur la page exercices de maths en L3 sur variables aléatoires et espérance.
Corrigé de l’exercice 1 : Variables aléatoires sur l’espace de Lebesgue
- La mesure de Lebesgue restreinte aux boréliens de \([0,1]\) est une mesure, et \(\lambda([0,1]) = 1\). C’est donc une probabilité. Ensuite, \(X\) est constante sur chacun des intervalles \([0, 1/3[\), \([1/3, 2/3[\), \([2/3, 1[\) et \(\{1\}\). Ainsi, l’image réciproque de toute partie de \(\mathbb{R}\) est une réunion finie d’intervalles, donc un borélien. Par ailleurs, \(Y\) est continue, donc borélienne. Les deux applications sont des variables aléatoires.
- La variable \(X\) prend les valeurs 0, 1, 2 et 3. D’une part, \(P(X = 0) = \lambda([0, 1/3[) = 1/3\). De même, \(P(X = 1) = P(X = 2) = 1/3\). D’autre part, \(P(X = 3) = \lambda(\{1\}) = 0\). Par conséquent, \(X\) suit presque sûrement la loi uniforme sur \(\{0, 1, 2\}\), et \(E[X] = (0 + 1 + 2)/3 = 1\).
- La variable \(Y\) est à valeurs dans \([0,1]\). Soit \(y \in [0,1]\). On a \(4\omega(1-\omega) \leq\, y\) si et seulement si \(\omega^2 – \omega + y/4 \geq\, 0\). Les racines de ce trinôme sont \(\omega_{\pm} = \frac{1 \pm \sqrt{1-y}}{2}\). Donc \(\{Y \leq\, y\} = [0, \omega_{-}] \cup [\omega_{+}, 1]\), et
\[F_Y(y) = \omega_{-} + (1 – \omega_{+}) = 1 – \sqrt{1-y}.\]
De plus, \(F_Y(y) = 0\) pour \(y < 0\) et \(F_Y(y) = 1\) pour \(y > 1\). Cette fonction est continue et de classe \(C^1\) sur \(]0,1[\). Ainsi, \(Y\) a pour densité \(f_Y(y) = \frac{1}{2\sqrt{1-y}} \mathbf{1}_{]0,1[}(y)\). En effet, \(F_Y(y) = \int_{-\infty}^{y} f_Y\) pour tout \(y\), et la fonction de répartition caractérise la loi.La figure ci-dessous confronte cette densité à l’histogramme d’un grand nombre de valeurs simulées de \(Y\). On constate que \(Y\) prend plus souvent des valeurs proches de 1, là où la parabole est plate.
![Histogramme de valeurs simulées de Y et densité 1/(2√(1-y)) sur ]0,1[ avec la moyenne 2/3](data:image/svg+xml,%3Csvg%20xmlns='http://www.w3.org/2000/svg'%20viewBox='0%200%20800%20512'%3E%3C/svg%3E)
- D’abord, par transfert sur \(\Omega\) :
\[E[Y] = \int_0^1 4\omega(1-\omega) \, d\omega = 4\Big(\frac{1}{2} – \frac{1}{3}\Big) = \frac{2}{3}.\]
Ensuite, avec la densité et le changement de variable \(u = 1 – y\) :
\[E[Y] = \int_0^1 \frac{y}{2\sqrt{1-y}} \, dy = \int_0^1 \frac{1-u}{2\sqrt{u}} \, du = \frac{1}{2}\Big(2 – \frac{2}{3}\Big) = \frac{2}{3}.\]
Les deux calculs donnent \(E[Y] = 2/3\). - Prenons \(y = 3/4\). Alors \(\sqrt{1-y} = 1/2\), donc \(\{Y \leq\, 3/4\} = [0, 1/4] \cup [3/4, 1]\), de probabilité \(1/2\). Or \(\{X = 1\} = [1/3, 2/3[\) ne rencontre pas cet ensemble. Par conséquent, \(P(X = 1, Y \leq\, 3/4) = 0\), alors que \(P(X = 1) P(Y \leq\, 3/4) = \frac{1}{3} \times \frac{1}{2} = \frac{1}{6}\). Les variables \(X\) et \(Y\) ne sont pas indépendantes.
![Histogramme de valeurs simulées de Y et densité 1/(2√(1-y)) sur ]0,1[ avec la moyenne 2/3](https://mathovore.fr/wp-content/uploads/sup-maths/l3/probabilites-variables-aleatoires-esperance-corr-ex1-densite.png)
Point de méthode : sur un espace probabilisé concret, la loi d’une variable se lit en mesurant les ensembles \(\{X \leq\, x\}\), exactement comme on mesure des ensembles de niveau en intégration.
Corrigé de l’exercice 2 : Fonction muette et loi uniforme
- Soit \(h\) mesurable bornée. Par transfert, \(E[h(Y)] = \int_0^1 h\big(-\frac{1}{\lambda}\ln x\big) \, dx\). L’application \(x \mapsto -\frac{1}{\lambda}\ln x\) est un \(C^1\)-difféomorphisme décroissant de \(]0,1[\) sur \(]0, +\infty[\). On pose \(y = -\frac{1}{\lambda}\ln x\), soit \(x = e^{-\lambda y}\) et \(dx = -\lambda e^{-\lambda y} dy\). Donc
\[E[h(Y)] = \int_0^{+\infty} h(y) \lambda e^{-\lambda y} \, dy.\]
Par la méthode de la fonction muette, \(Y\) suit la loi \(\mathcal{E}(\lambda)\). - De même, \(E[h(X^2)] = \int_0^1 h(x^2) \, dx\). Avec \(z = x^2\), on a \(x = \sqrt{z}\) et \(dx = \frac{dz}{2\sqrt{z}}\). Ainsi, \(E[h(Z)] = \int_0^1 h(z) \frac{1}{2\sqrt{z}} \, dz\). Par conséquent, \(Z\) a pour densité \(\frac{1}{2\sqrt{z}} \mathbf{1}_{]0,1[}(z)\), et \(E[Z] = E[X^2] = \int_0^1 x^2 \, dx = \frac{1}{3}\).
- On a \(E[h(1/X)] = \int_0^1 h(1/x) \, dx\). Avec \(w = 1/x\), on obtient \(dx = -dw/w^2\), et \(w\) décrit \(]1, +\infty[\). Donc \(W\) a pour densité \(\frac{1}{w^2} \mathbf{1}_{]1,+\infty[}(w)\). Ensuite, \(E[W] = \int_1^{+\infty} \frac{dw}{w} = +\infty\). La variable \(W\) n’est pas intégrable.
- La fonction \(F^{-1}\) est une bijection strictement croissante de \(]0,1[\) sur \(\mathbb{R}\). Donc, pour tout réel \(t\), \(F^{-1}(X) \leq\, t\) équivaut à \(X \leq\, F(t)\). Comme \(F(t) \in ]0,1[\) et que \(X\) est uniforme, on obtient \(P(F^{-1}(X) \leq\, t) = F(t)\). La variable \(F^{-1}(X)\) a pour fonction de répartition \(F\). C’est le principe de la simulation par inversion ; la question 1 en est le cas particulier \(F(t) = 1 – e^{-\lambda t}\), avec \(1 – X\) à la place de \(X\).
Corrigé de l’exercice 3 : Moments des lois usuelles
- Par transfert, on a
\[E[X] = \sum_{k \geq\, 1} k e^{-\lambda} \frac{\lambda^k}{k!} = \lambda e^{-\lambda} \sum_{k \geq\, 1} \frac{\lambda^{k-1}}{(k-1)!} = \lambda.\]
De même, \(E[X(X-1)] = \lambda^2 e^{-\lambda} \sum_{k \geq\, 2} \frac{\lambda^{k-2}}{(k-2)!} = \lambda^2\). Donc \(E[X^2] = \lambda^2 + \lambda\) et \(\operatorname{Var}(X) = \lambda^2 + \lambda – \lambda^2 = \lambda\). - Pour \(|x| < 1\), on dérive la série géométrique : \(\sum_{k \geq\, 1} k x^{k-1} = \frac{1}{(1-x)^2}\) et \(\sum_{k \geq\, 2} k(k-1) x^{k-2} = \frac{2}{(1-x)^3}\). Avec \(x = 1 – p\), on obtient \(E[G] = p \cdot \frac{1}{p^2} = \frac{1}{p}\). Ensuite,
\[E[G(G-1)] = p(1-p) \sum_{k \geq\, 2} k(k-1)(1-p)^{k-2} = \frac{2(1-p)}{p^2}.\]
Par conséquent, \(\operatorname{Var}(G) = \frac{2(1-p)}{p^2} + \frac{1}{p} – \frac{1}{p^2} = \frac{2 – 2p + p – 1}{p^2}\). Ainsi, \(E[G] = 1/p\) et \(\operatorname{Var}(G) = (1-p)/p^2\). - Pour \(n \geq\, 1\), on intègre par parties :
\[E[T^n] = \int_0^{+\infty} x^n \lambda e^{-\lambda x} \, dx = \big[-x^n e^{-\lambda x}\big]_0^{+\infty} + \int_0^{+\infty} n x^{n-1} e^{-\lambda x} \, dx = \frac{n}{\lambda} E[T^{n-1}].\]
Comme \(E[T^0] = 1\), une récurrence immédiate donne \(E[T^n] = n!/\lambda^n\). En particulier, \(\operatorname{Var}(T) = \frac{2}{\lambda^2} – \frac{1}{\lambda^2} = \frac{1}{\lambda^2}\). - La fonction \(z \mapsto z e^{-z^2/2}\) est intégrable et impaire, donc \(E[Z] = 0\). Ensuite, une intégration par parties donne
\[\int_{\mathbb{R}} z \cdot z e^{-z^2/2} \, dz = \big[-z e^{-z^2/2}\big]_{-\infty}^{+\infty} + \int_{\mathbb{R}} e^{-z^2/2} \, dz = \sqrt{2\pi}.\]
Donc \(E[Z^2] = 1\). Enfin, par linéarité et par \(\operatorname{Var}(aZ + b) = a^2 \operatorname{Var}(Z)\), \(E[m + \sigma Z] = m\) et \(\operatorname{Var}(m + \sigma Z) = \sigma^2\).
Corrigé de l’exercice 4 : Espérance et fonction de queue
- Pour tout \(\omega\), on a \(X(\omega) = \int_0^{+\infty} \mathbf{1}_{\{t < X(\omega)\}} \, dt\). L’ensemble \(D = \{(\omega, t) : t < X(\omega)\}\) est mesurable pour la tribu produit, car \((\omega, t) \mapsto X(\omega) – t\) est mesurable. La fonction \(\mathbf{1}_D\) est positive. Donc le théorème de Fubini-Tonelli autorise l’échange :
\[E[X] = \int_{\Omega} \int_0^{+\infty} \mathbf{1}_D \, dt \, dP = \int_0^{+\infty} P(X > t) \, dt.\]
La formule est démontrée, les deux membres pouvant valoir \(+\infty\). - Pour \(X\) de loi \(\mathcal{E}(\lambda)\), on a \(P(X > t) = e^{-\lambda t}\) pour \(t \geq\, 0\). Donc \(E[X] = \int_0^{+\infty} e^{-\lambda t} \, dt = 1/\lambda\).
- Soit \(k \geq\, 1\) et \(t \in [k-1, k[\). Comme \(N\) est entière, \(N > t\) équivaut à \(N \geq\, k\). Donc \(t \mapsto P(N > t)\) est constante égale à \(P(N \geq\, k)\) sur \([k-1, k[\). Par conséquent, \(E[N] = \sum_{k \geq\, 1} P(N \geq\, k)\). Pour \(G\) de loi \(\mathcal{G}(p)\), on a \(P(G \geq\, k) = (1-p)^{k-1}\) : les \(k-1\) premiers essais échouent. Ainsi, \(E[G] = \sum_{k \geq\, 1} (1-p)^{k-1} = 1/p\).
- On écrit cette fois \(X^p = \int_0^{X} p t^{p-1} \, dt = \int_0^{+\infty} p t^{p-1} \mathbf{1}_{\{t < X\}} \, dt\). Le même argument de Fubini-Tonelli donne \(E[X^p] = \int_0^{+\infty} p t^{p-1} P(X > t) \, dt\). Pour \(p = 2\) et \(X\) de loi \(\mathcal{E}(\lambda)\), on obtient \(\int_0^{+\infty} 2t e^{-\lambda t} \, dt = \frac{2}{\lambda^2}\). Cela coïncide avec \(E[X^2] = 2!/\lambda^2\) de l’exercice 3.
Point de méthode : écrire une quantité positive comme une intégrale d’indicatrice, puis échanger par Tonelli, est un réflexe très efficace en probabilités.
Corrigé de l’exercice 5 : Loi de Cauchy et absence d’espérance
- La fonction \(\tan\) est un \(C^1\)-difféomorphisme de \(]-\pi/2, \pi/2[\) sur \(\mathbb{R}\), de réciproque \(\arctan\). Soit \(h\) mesurable bornée. Avec \(x = \tan u\), donc \(du = \frac{dx}{1+x^2}\), on a
\[E[h(X)] = \frac{1}{\pi} \int_{-\pi/2}^{\pi/2} h(\tan u) \, du = \int_{\mathbb{R}} h(x) \frac{1}{\pi(1+x^2)} \, dx.\]
Donc \(X\) a pour densité \(f(x) = \frac{1}{\pi(1+x^2)}\). - On a \(\frac{|x|}{\pi(1+x^2)} \sim \frac{1}{\pi |x|}\) en \(\pm\infty\). Or \(x \mapsto 1/x\) n’est pas intégrable sur \([1, +\infty[\). Donc \(E[|X|] = +\infty\) : la loi de Cauchy n’a pas d’espérance.
- On a \(P(X = 0) = 0\), donc \(1/X\) est définie presque sûrement. Sur \(]0, +\infty[\), le changement \(y = 1/x\) donne \(dx = -dy/y^2\) et
\[\frac{1}{\pi(1 + 1/y^2)} \cdot \frac{1}{y^2} = \frac{1}{\pi(1 + y^2)}.\]
Le même calcul vaut sur \(]-\infty, 0[\). Ainsi, \(E[h(1/X)] = \int h(y) \frac{1}{\pi(1+y^2)} \, dy\). La variable \(1/X\) suit donc la loi de Cauchy. - Par parité de la densité, pour \(t > 0\),
\[P(|X| > t) = \frac{2}{\pi} \int_t^{+\infty} \frac{dx}{1+x^2} = \frac{2}{\pi}\Big(\frac{\pi}{2} – \arctan t\Big) = \frac{2}{\pi} \arctan\frac{1}{t}.\]
Comme \(\arctan u \sim u\) en 0, on obtient \(P(|X| > t) \sim \frac{2}{\pi t}\) quand \(t \to +\infty\). Cette queue lente explique l’absence d’espérance : en effet, \(\int_0^{+\infty} P(|X| > t) \, dt = +\infty\), d’après l’exercice 4.
Corrigé de l’exercice 6 : Calcul de fonctions caractéristiques
- Pour \(X\) de loi \(\mathcal{B}(p)\), on a \(\varphi_X(t) = (1-p) e^{0} + p e^{it} = 1 – p + p e^{it}\). Une variable de loi \(\mathcal{B}(n,p)\) a la loi d’une somme de \(n\) variables de Bernoulli indépendantes. Donc \(\varphi(t) = (1 – p + p e^{it})^n\). On peut aussi le vérifier directement par la formule du binôme.
- On somme la série exponentielle :
\[\varphi(t) = \sum_{k \geq\, 0} e^{-\lambda} \frac{(\lambda e^{it})^k}{k!} = e^{-\lambda} e^{\lambda e^{it}} = \exp\big(\lambda(e^{it} – 1)\big).\]
C’est la fonction caractéristique de \(\mathcal{P}(\lambda)\). - Pour \(t \neq 0\), on a
\[\varphi(t) = \frac{1}{2a} \int_{-a}^{a} e^{itx} \, dx = \frac{1}{2a} \cdot \frac{e^{iat} – e^{-iat}}{it} = \frac{\sin(at)}{at}.\]
De plus, \(\varphi(0) = 1\). Donc \(\varphi(t) = \frac{\sin(at)}{at}\), prolongée par 1 en 0. - Comme \(\operatorname{Re}(\lambda – it) = \lambda > 0\), on a \(|e^{-(\lambda – it)x}| = e^{-\lambda x} \to 0\) en \(+\infty\). Donc
\[\varphi(t) = \int_0^{+\infty} \lambda e^{-(\lambda – it)x} \, dx = \Big[\frac{-\lambda e^{-(\lambda – it)x}}{\lambda – it}\Big]_0^{+\infty} = \frac{\lambda}{\lambda – it}.\]
Le résultat est démontré. - On a \(\varphi(t) = \lambda (\lambda – it)^{-1}\), d’où \(\varphi^{\prime}(t) = i\lambda (\lambda – it)^{-2}\) et \(\varphi^{\prime\prime}(t) = -2\lambda (\lambda – it)^{-3}\). La loi \(\mathcal{E}(\lambda)\) a des moments de tous ordres, donc \(\varphi^{(k)}(0) = i^k E[X^k]\). Ainsi, \(i E[X] = i/\lambda\) et \(-E[X^2] = -2/\lambda^2\). On retrouve \(E[X] = 1/\lambda\) et \(\operatorname{Var}(X) = 2/\lambda^2 – 1/\lambda^2 = 1/\lambda^2\).
Corrigé de l’exercice 7 : Indépendance deux à deux et mutuelle
- On a \(P(A \cap B^c) = P(A) – P(A \cap B) = P(A) – P(A)P(B) = P(A) P(B^c)\). Par symétrie, \(A^c\) et \(B\) sont indépendants. En appliquant de nouveau ce résultat, \(A^c\) et \(B^c\) le sont aussi. Enfin, la formule produit est évidente si l’un des événements est \(\emptyset\) ou \(\Omega\). Les tribus \(\sigma(A)\) et \(\sigma(B)\) sont donc indépendantes.
- Il y a trois faces paires sur six, donc \(P(A) = P(B) = 1/2\). Ensuite, \(X_1 + X_2\) est pair si et seulement si \(X_1\) et \(X_2\) ont la même parité. Par indépendance, \(P(C) = \frac{1}{4} + \frac{1}{4}\). Ainsi, \(P(A) = P(B) = P(C) = 1/2\).
- D’abord, \(P(A \cap B) = \frac{1}{4} = P(A)P(B)\) par indépendance de \(X_1\) et \(X_2\). Ensuite, \(A \cap C = \{X_1 \text{ pair}, X_2 \text{ pair}\} = A \cap B\), donc \(P(A \cap C) = \frac{1}{4} = P(A)P(C)\). De même, \(B \cap C = A \cap B\) et \(P(B \cap C) = \frac{1}{4}\). Les trois événements sont indépendants deux à deux.
- En revanche, \(A \cap B \cap C = A \cap B\), donc \(P(A \cap B \cap C) = \frac{1}{4} \neq \frac{1}{8} = P(A)P(B)P(C)\). Ils ne sont pas mutuellement indépendants. Par conséquent, les variables \(\mathbf{1}_A\), \(\mathbf{1}_B\), \(\mathbf{1}_C\) sont indépendantes deux à deux, mais pas indépendantes. D’ailleurs, \(\mathbf{1}_C\) est une fonction de \((\mathbf{1}_A, \mathbf{1}_B)\) : \(\mathbf{1}_C = 1 – |\mathbf{1}_A – \mathbf{1}_B|\).
Corrigé de l’exercice 8 : Indépendance et densité produit
- La fonction \(f\) est positive et \(\int_0^1\int_0^1 4xy \, dx \, dy = 4 \times \frac{1}{2} \times \frac{1}{2} = 1\). Par Fubini, \(f_X(x) = \int_0^1 4xy \, dy = 2x\) sur \([0,1]\), et de même \(f_Y(y) = 2y\). Ainsi, \(f(x,y) = f_X(x) f_Y(y)\). La densité se factorise, donc \(X\) et \(Y\) sont indépendantes, de même densité \(2x \mathbf{1}_{[0,1]}(x)\).
- La fonction \(g\) est positive, et \(\int_0^1 \int_0^1 (x+y) \, dx \, dy = \frac{1}{2} + \frac{1}{2} = 1\). Ensuite, \(g_X(x) = \int_0^1 (x+y) \, dy = x + \frac{1}{2}\) sur \([0,1]\). Par symétrie, \(g_X(x) = x + \frac{1}{2}\) et \(g_Y(y) = y + \frac{1}{2}\) sur \([0,1]\).
- Sur le carré \(]0, 1/8]^2\), on a \(g_X(x) g_Y(y) > \frac{1}{4}\) et \(g(x,y) = x + y \leq\, \frac{1}{4}\). Donc \(g \neq g_X \otimes g_Y\) sur un ensemble de mesure non nulle. Or l’indépendance équivaudrait à l’égalité presque partout. Les variables ne sont pas indépendantes. Calculons la covariance. D’une part, \(E[X] = \int_0^1 x\big(x + \frac{1}{2}\big) dx = \frac{1}{3} + \frac{1}{4} = \frac{7}{12}\), et de même \(E[Y] = \frac{7}{12}\). D’autre part,
\[E[XY] = \int_0^1\int_0^1 (x^2 y + x y^2) \, dx \, dy = \frac{1}{6} + \frac{1}{6} = \frac{1}{3}.\]
Donc \(\operatorname{Cov}(X, Y) = \frac{1}{3} – \frac{49}{144} = -\frac{1}{144}\). - Par Fubini,
\[P(X + Y \leq\, 1) = \int_0^1 \int_0^{1-x} (x + y) \, dy \, dx = \int_0^1 \Big(x(1-x) + \frac{(1-x)^2}{2}\Big) dx = \frac{1}{6} + \frac{1}{6}.\]
Ainsi, \(P(X + Y \leq\, 1) = 1/3\).
Corrigé de l’exercice 9 : Minimum d’exponentielles indépendantes
- On a \(P(X > u) = e^{-\lambda u}\) pour \(u \geq\, 0\). Comme \(\{X > s+t\} \subset \{X > s\}\), on obtient \(P(X > s + t \mid X > s) = \frac{e^{-\lambda(s+t)}}{e^{-\lambda s}} = e^{-\lambda t}\). C’est bien \(P(X > t)\) : la loi exponentielle est sans mémoire.
- Pour \(t \geq\, 0\), \(\{M > t\} = \{X > t\} \cap \{Y > t\}\). Par indépendance, \(P(M > t) = e^{-\lambda t} e^{-\mu t} = e^{-(\lambda + \mu)t}\). De plus, \(M > 0\) presque sûrement. Donc \(M\) suit la loi \(\mathcal{E}(\lambda + \mu)\).
- Le couple a pour densité \(\lambda \mu e^{-\lambda x – \mu y}\) sur \(]0, +\infty[^2\), par indépendance. Par Fubini,
\[P(X < Y) = \int_0^{+\infty} \lambda e^{-\lambda x} \Big(\int_x^{+\infty} \mu e^{-\mu y} \, dy\Big) dx = \int_0^{+\infty} \lambda e^{-(\lambda + \mu)x} \, dx.\]
Ainsi, \(P(X < Y) = \frac{\lambda}{\lambda + \mu}\). - Soit \(D = \{X < Y\}\) et \(t \geq\, 0\). On a \(\{M > t\} \cap D = \{t < X < Y\}\). Le même calcul qu’à la question 3 donne
\[P(M > t, D) = \int_t^{+\infty} \lambda e^{-(\lambda + \mu)x} \, dx = \frac{\lambda}{\lambda + \mu} e^{-(\lambda + \mu)t} = P(D) P(M > t).\]
Pour \(t < 0\), on a \(\{M > t\} = \Omega\) et la formule est évidente. Or la classe \(\{\{M > t\}, t \in \mathbb{R}\}\) est stable par intersection, contient \(\Omega\) et engendre \(\sigma(M)\). De même, \(\{\Omega, D\}\) engendre \(\sigma(\mathbf{1}_D)\). Par le lemme des classes stables, \(M\) et l’événement \(\{X < Y\}\) sont indépendants. Autrement dit, savoir lequel des deux instants arrive en premier ne renseigne pas sur la date du premier.
Corrigé de l’exercice 10 : Produit de convolution
- Soit \(h\) mesurable bornée. Par indépendance, le couple a pour densité \(f(x) g(y)\). Donc, par Fubini puis avec le changement \(s = x + y\) à \(x\) fixé,
\[E[h(X+Y)] = \int\!\!\int h(x + y) f(x) g(y) \, dx \, dy = \int h(s) \Big(\int f(x) g(s – x) \, dx\Big) ds.\]
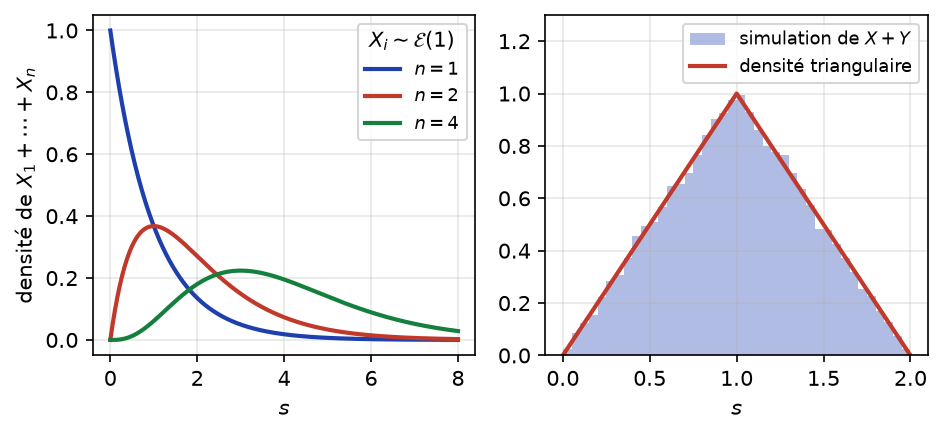
Par la méthode de la fonction muette, \(X + Y\) a pour densité \(f * g\). - Ici, \(f * g(s) = \int \mathbf{1}_{[0,1]}(x) \mathbf{1}_{[0,1]}(s – x) \, dx = \lambda([0,1] \cap [s-1, s])\). Cette longueur vaut \(s\) si \(0 \leq\, s \leq\, 1\), et \(2 – s\) si \(1 \leq\, s \leq\, 2\). Donc \(X + Y\) a la densité triangulaire \(s \mapsto \max(0, 1 – |s – 1|)\).
- On raisonne par récurrence sur \(n\). Pour \(n = 1\), on retrouve la densité de \(\mathcal{E}(\lambda)\). Supposons la formule vraie au rang \(n\). La variable \(X_{n+1}\) est indépendante de \(S_n\), qui est une fonction de \((X_1, \ldots, X_n)\). Donc, pour \(s > 0\),
\[f_{S_{n+1}}(s) = \int_0^s \frac{\lambda^n x^{n-1}}{(n-1)!} e^{-\lambda x} \lambda e^{-\lambda(s – x)} \, dx = \frac{\lambda^{n+1} e^{-\lambda s}}{(n-1)!} \cdot \frac{s^n}{n}.\]
On obtient \(\frac{\lambda^{n+1} s^n}{n!} e^{-\lambda s}\), ce qui achève la récurrence : \(S_n\) suit la loi \(\Gamma(n, \lambda)\).La figure ci-dessous montre, à gauche, ces densités pour \(\lambda = 1\) et plusieurs valeurs de \(n\). À droite, elle superpose la densité triangulaire de la question 2 à une simulation.

- Pour \(\lambda = 1\), \(S_2\) a pour densité \(s e^{-s}\) sur \(]0, +\infty[\). Donc
\[P(S_2 \leq\, 1) = \int_0^1 s e^{-s} \, ds = \big[-(s+1)e^{-s}\big]_0^1 = 1 – \frac{2}{e}.\]
Ainsi, \(P(S_2 \leq\, 1) = 1 – 2/e \approx 0{,}264\).
Corrigé de l’exercice 11 : Coordonnées polaires d’un couple gaussien
- L’application \(\psi : (r, \theta) \mapsto (r\cos\theta, r\sin\theta)\) est un \(C^1\)-difféomorphisme de \(]0, +\infty[ \times ]0, 2\pi[\) sur \(\mathbb{R}^2\) privé de la demi-droite \(\mathbb{R}_{+} \times \{0\}\). Cette demi-droite est négligeable pour la loi de \((X, Y)\), qui a une densité. Le jacobien de \(\psi\) vaut \(r\). Par le théorème de changement de variables, \((R, \Theta)\) a pour densité
\[\frac{1}{2\pi} e^{-r^2/2} \cdot r = \Big(r e^{-r^2/2} \mathbf{1}_{r > 0}\Big) \times \Big(\frac{1}{2\pi} \mathbf{1}_{]0, 2\pi[}(\theta)\Big).\]
La densité se factorise : \(R\) et \(\Theta\) sont indépendantes, \(R\) a pour densité \(r e^{-r^2/2}\) sur \(]0, +\infty[\), et \(\Theta\) est uniforme sur \(]0, 2\pi[\). - Pour \(t \geq\, 0\), on a \(P(R^2 > t) = P(R > \sqrt{t}) = \int_{\sqrt{t}}^{+\infty} r e^{-r^2/2} \, dr = e^{-t/2}\). Donc \(R^2\) suit la loi \(\mathcal{E}(1/2)\), et \(P(X^2 + Y^2 \leq\, 1) = 1 – e^{-1/2} \approx 0{,}393\).
- Posons \(R^{\prime} = \sqrt{-2\ln U}\) et \(\Theta^{\prime} = 2\pi V\). Pour \(r > 0\), on a \(P(R^{\prime} > r) = P(U < e^{-r^2/2}) = e^{-r^2/2}\). C’est aussi \(P(R > r)\), d’après la question 2. Donc \(R^{\prime}\) a la loi de \(R\). De plus, \(\Theta^{\prime}\) est uniforme sur \(]0, 2\pi[\), et \(R^{\prime}\), \(\Theta^{\prime}\) sont indépendantes. Par conséquent, \((R^{\prime}, \Theta^{\prime})\) a la même loi que \((R, \Theta)\). Leurs images par \(\psi\) ont donc même loi. Ainsi, \(\big(R^{\prime}\cos\Theta^{\prime}, R^{\prime}\sin\Theta^{\prime}\big)\) a la loi de \((X, Y)\) : ce sont deux variables indépendantes de loi \(\mathcal{N}(0,1)\). C’est la méthode de Box-Muller.
- On a \(Y/X = \tan \Theta\), défini presque sûrement. Soit \(h\) mesurable bornée. La fonction \(\theta \mapsto h(\tan\theta)\) est \(\pi\)-périodique. Son intégrale sur une période ne dépend donc pas de l’origine. Ainsi,
\[E[h(\tan\Theta)] = \frac{1}{2\pi} \int_0^{2\pi} h(\tan\theta) \, d\theta = \frac{1}{\pi} \int_{-\pi/2}^{\pi/2} h(\tan u) \, du.\]
D’après l’exercice 5, \(Y/X\) suit la loi de Cauchy.
Corrigé de l’exercice 12 : Rapport et somme d’exponentielles
- L’application \(\varphi\) est de classe \(C^1\) sur \(]0, +\infty[^2\), à valeurs dans \(]0, +\infty[ \times ]0,1[\). Pour \((u, v)\) dans cet ensemble, le système \(x + y = u\), \(x = v(x+y)\) a pour unique solution \(x = uv\), \(y = u(1-v)\), avec \(x, y > 0\). La réciproque \(\varphi^{-1}(u, v) = (uv, u(1-v))\) est de classe \(C^1\). Donc \(\varphi\) est un \(C^1\)-difféomorphisme.
- Le jacobien de \(\varphi^{-1}\) vaut
\[\det\begin{pmatrix} v u \\ 1 – v -u \end{pmatrix} = -uv – u(1-v) = -u.\]
Le couple \((X, Y)\) a pour densité \(e^{-x-y}\) sur \(]0, +\infty[^2\). Donc \((U, V)\) a pour densité \(e^{-u} \cdot u\) sur \(]0, +\infty[ \times ]0,1[\). - Cette densité s’écrit \(\big(u e^{-u} \mathbf{1}_{u > 0}\big) \times \mathbf{1}_{]0,1[}(v)\). Chaque facteur est une densité. Donc \(U\) suit la loi \(\Gamma(2, 1)\), \(V\) suit la loi uniforme sur \(]0,1[\), et \(U\), \(V\) sont indépendantes.
- On a \(X = UV\). Soit \(h\) mesurable bornée. Par indépendance, \(E[X h(U)] = E[V] \, E[U h(U)] = E\big[\frac{U}{2} h(U)\big]\). Or \(U/2\) est une fonction de \(U\). Par la caractérisation de l’espérance conditionnelle, \(E[X \mid U] = U/2\). On pouvait l’anticiper par symétrie : \(E[X \mid U] = E[Y \mid U]\) et leur somme vaut \(U\).
Corrigé de l’exercice 13 : Covariance nulle sans indépendance
- Les fonctions \(x \mapsto x\) et \(x \mapsto x^3\) sont impaires, et la densité \(\frac{1}{2}\mathbf{1}_{[-1,1]}\) est paire. Donc \(E[X] = E[X^3] = 0\). Ainsi, \(\operatorname{Cov}(X, Y) = E[X^3] – E[X] E[X^2] = 0\).
- On a \(\{Y \leq\, 1/4\} = \{|X| \leq\, 1/2\}\). Donc \(P(|X| \leq\, 1/2, Y \leq\, 1/4) = P(|X| \leq\, 1/2) = 1/2\). Or \(P(|X| \leq\, 1/2) P(Y \leq\, 1/4) = 1/4\). Les variables ne sont pas indépendantes.
- On a \(E[XY] = P(X = 1, Y = 1)\), \(E[X] = P(X=1)\) et \(E[Y] = P(Y=1)\). Donc la covariance nulle s’écrit \(P(X = 1, Y = 1) = P(X = 1)P(Y = 1)\). Les événements \(\{X = 1\}\) et \(\{Y = 1\}\) sont donc indépendants. D’après l’exercice 7, les tribus qu’ils engendrent sont indépendantes. Or ce sont exactement \(\sigma(X)\) et \(\sigma(Y)\). Pour des variables de Bernoulli, covariance nulle et indépendance sont équivalentes.
- Soient \(A, B\) deux boréliens. On prend \(h = \mathbf{1}_A\) et \(k = \mathbf{1}_B\). Alors \(0 = \operatorname{Cov}(h(X), k(Y)) = P(X \in A, Y \in B) – P(X \in A) P(Y \in B)\). C’est exactement l’indépendance de \(X\) et \(Y\).
Point de méthode : la covariance ne teste l’indépendance que sur les fonctions linéaires ; l’indépendance demande la même relation pour toutes les fonctions bornées.
Corrigé de l’exercice 14 : Matrice de covariance
- La covariance est symétrique, donc \(\Gamma_Z\) aussi. Soit \(a \in \mathbb{R}^d\). Par bilinéarité, \(a^{T} \Gamma_Z a = \sum_{i,j} a_i a_j \operatorname{Cov}(Z_i, Z_j) = \operatorname{Var}\big(\sum_i a_i Z_i\big) \geq\, 0\). Ensuite, \((AZ)_k = \sum_i A_{ki} Z_i\), donc
\[\operatorname{Cov}\big((AZ)_k, (AZ)_l\big) = \sum_{i,j} A_{ki} A_{lj} \operatorname{Cov}(Z_i, Z_j) = (A \Gamma_Z A^{T})_{kl}.\]
Ainsi, \(\Gamma_Z\) est symétrique positive et \(\Gamma_{AZ} = A \Gamma_Z A^{T}\). - On a \(W = A(X, Y)^{T}\) avec \(A = \begin{pmatrix} 1 1 \\ 1 -1 \end{pmatrix}\), et \(\Gamma_{(X,Y)} = \operatorname{diag}(1, 2)\) par indépendance. Donc
\[\Gamma_W = \begin{pmatrix} 1 2 \\ 1 -2 \end{pmatrix} \begin{pmatrix} 1 1 \\ 1 -1 \end{pmatrix} = \begin{pmatrix} 3 -1 \\ -1 3 \end{pmatrix}.\]
On retrouve \(\operatorname{Var}(X \pm Y) = 3\) et \(\operatorname{Cov}(X + Y, X – Y) = \operatorname{Var} X – \operatorname{Var} Y = -1\). - On veut \(\operatorname{Cov}(X – Y, X + Y) – c \operatorname{Var}(X + Y) = 0\), soit \(-1 – 3c = 0\). Donc \(c = -1/3\). La variable \(c(X+Y)\) est la régression linéaire de \(X – Y\) sur \(X + Y\).
- On a \(\operatorname{Cov}(X, X + Y) = 1\), \(\operatorname{Cov}(Y, X + Y) = 2\) et \(\operatorname{Var}(X+Y) = 3\). Donc
\[\Gamma_T = \begin{pmatrix} 1 0 1 \\ 0 2 2 \\ 1 2 3 \end{pmatrix}, \quad \Gamma_T \begin{pmatrix} 1 \\ 1 \\ -1 \end{pmatrix} = \begin{pmatrix} 0 \\ 0 \\ 0 \end{pmatrix}.\]
La matrice n’est pas inversible. En effet, pour \(a = (1, 1, -1)\), on a \(\operatorname{Var}(\langle a, T \rangle) = a^{T}\Gamma_T a = 0\). Autrement dit, \(X + Y – (X + Y)\) est constante : le vecteur \(T\) vit dans un plan.
Corrigé de l’exercice 15 : Lois de Laplace et de Cauchy
- On découpe l’intégrale en deux, puis on change \(x\) en \(-x\) sur \(]-\infty, 0]\) :
\[\varphi(t) = \frac{1}{2}\int_0^{+\infty} e^{-(1 – it)x} \, dx + \frac{1}{2}\int_0^{+\infty} e^{-(1 + it)x} \, dx = \frac{1}{2}\Big(\frac{1}{1 – it} + \frac{1}{1 + it}\Big).\]
En réduisant au même dénominateur, \(\varphi(t) = \frac{1}{1 + t^2}\). - La fonction \(\varphi\) est intégrable sur \(\mathbb{R}\). La formule d’inversion donne, pour tout réel \(x\) (la densité de Laplace étant continue) :
\[\frac{1}{2} e^{-|x|} = \frac{1}{2\pi} \int_{\mathbb{R}} e^{-itx} \frac{1}{1 + t^2} \, dt.\]
On multiplie par 2 et on remplace \(x\) par \(-s\) : \(e^{-|s|} = \int_{\mathbb{R}} e^{ist} \frac{1}{\pi(1+t^2)} \, dt\). Le membre de droite est la fonction caractéristique de la loi de Cauchy en \(s\). Donc \(\varphi_{\text{Cauchy}}(s) = e^{-|s|}\). - On a \(\varphi_{-Y}(t) = \varphi_Y(-t) = \frac{1}{1 + it}\). Par indépendance, \(\varphi_{X – Y}(t) = \frac{1}{1 – it} \cdot \frac{1}{1 + it} = \frac{1}{1 + t^2}\). Comme la fonction caractéristique caractérise la loi, \(X – Y\) suit la loi de Laplace.
- La fonction \(s \mapsto e^{-|s|}\) a une dérivée à droite égale à \(-1\) et une dérivée à gauche égale à \(1\) en 0. Elle n’est donc pas dérivable en 0. C’est cohérent : si \(X\) était intégrable, \(\varphi_X\) serait de classe \(C^1\). On retrouve ainsi l’absence d’espérance.
Corrigé de l’exercice 16 : Moments de la loi normale par la fonction caractéristique
- Pour tout \(n\), on a \(|z|^n e^{-z^2/4} \to 0\) en \(\pm\infty\), donc \(|z|^n e^{-z^2/2} \leq\, C_n e^{-z^2/4}\), qui est intégrable. Donc \(E[|Z|^n] < +\infty\) pour tout \(n\).
- Par la question précédente, \(\varphi\) est de classe \(C^\infty\) et \(\varphi^{(n)}(0) = i^n E[Z^n]\). Or, pour tout réel \(t\),
\[\varphi(t) = \sum_{k \geq\, 0} \frac{(-1)^k t^{2k}}{2^k k!}.\]
Par unicité du développement en série entière, \(\varphi^{(2k+1)}(0) = 0\) et \(\varphi^{(2k)}(0) = (-1)^k \frac{(2k)!}{2^k k!}\). Comme \(i^{2k} = (-1)^k\), \(E[Z^{2k+1}] = 0\) et \(E[Z^{2k}] = \frac{(2k)!}{2^k k!}\). Par exemple, \(E[Z^2] = 1\), \(E[Z^4] = 3\) et \(E[Z^6] = 15\). - On intègre par parties, avec \(z e^{-z^2/2}\) comme dérivée de \(-e^{-z^2/2}\) :
\[\int_{\mathbb{R}} z^{2k+1} \cdot z e^{-z^2/2} \, dz = \big[-z^{2k+1} e^{-z^2/2}\big]_{-\infty}^{+\infty} + (2k+1)\int_{\mathbb{R}} z^{2k} e^{-z^2/2} \, dz.\]
Le crochet est nul. Donc \(E[Z^{2k+2}] = (2k+1)E[Z^{2k}]\), et \(E[Z^{2k}] = 1 \times 3 \times \cdots \times (2k-1)\). Or ce produit des impairs vaut bien \(\frac{(2k)!}{2 \times 4 \times \cdots \times 2k} = \frac{(2k)!}{2^k k!}\). - On écrit \(X = m + \sigma Z\). D’abord, \(E[(X – m)^4] = \sigma^4 E[Z^4]\), donc \(E[(X-m)^4] = 3\sigma^4\). Ensuite, par la formule du binôme,
\[E[X^3] = m^3 + 3m^2 \sigma E[Z] + 3m\sigma^2 E[Z^2] + \sigma^3 E[Z^3] = m^3 + 3m\sigma^2.\]
Ainsi, \(E[X^3] = m^3 + 3m\sigma^2\).
Corrigé de l’exercice 17 : Stabilité des lois normales et de Cauchy
- Par indépendance, \(\varphi_{X+Y}(t) = e^{im_1 t – \sigma_1^2 t^2/2} e^{im_2 t – \sigma_2^2 t^2/2} = e^{i(m_1 + m_2)t – (\sigma_1^2 + \sigma_2^2)t^2/2}\). La fonction caractéristique caractérise la loi. Donc \(X + Y\) suit \(\mathcal{N}(m_1 + m_2, \sigma_1^2 + \sigma_2^2)\).
- Par récurrence, \(X_1 + \cdots + X_n\) suit \(\mathcal{N}(0, n)\). Donc \(\overline{X}_n\) suit \(\mathcal{N}(0, 1/n)\) et s’écrit en loi \(Z/\sqrt{n}\), avec \(Z\) de loi \(\mathcal{N}(0,1)\). Par conséquent, \(P(|\overline{X}_n| > \varepsilon) = P(|Z| > \varepsilon\sqrt{n})\), qui tend vers 0 par convergence dominée. La moyenne se concentre autour de 0.
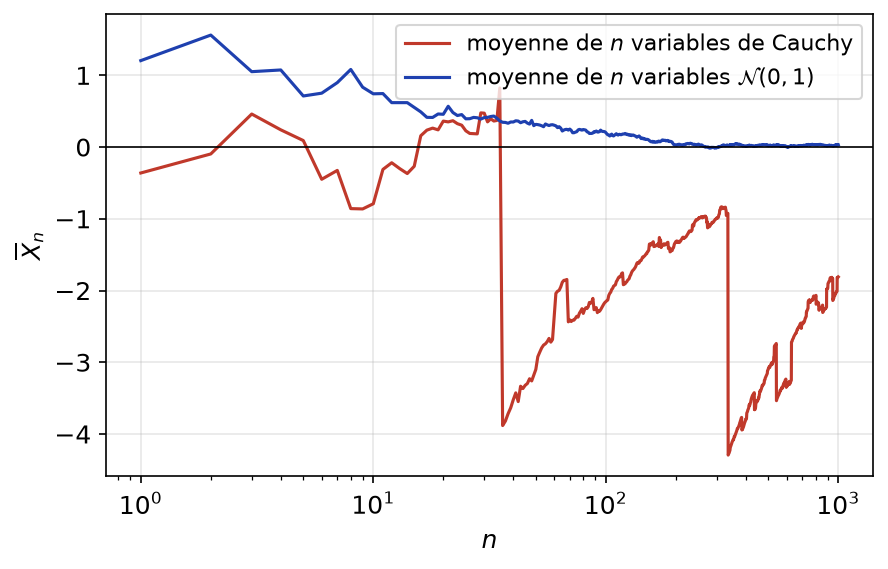
- Par indépendance, \(\varphi_{\overline{X}_n}(t) = \prod_{k=1}^{n} \varphi_{X_k}(t/n) = \big(e^{-|t|/n}\big)^n = e^{-|t|}\). Donc \(\overline{X}_n\) suit encore la loi de Cauchy, et \(P(|\overline{X}_n| > 1) = \frac{2}{\pi}\arctan 1 = \frac{1}{2}\) pour tout \(n\). La moyenne ne se stabilise pas : la loi des grands nombres exige une espérance finie.
La figure ci-dessous compare les moyennes empiriques de variables normales et de variables de Cauchy. Les premières se rapprochent de 0. Les secondes subissent des sauts brusques, dus aux valeurs très grandes qui apparaissent régulièrement.

- Pour \(c > 0\), \(\varphi_{cX}(t) = e^{-c|t|}\). Par indépendance, \(\varphi_{aX + bY}(t) = e^{-a|t|} e^{-b|t|} = e^{-(a+b)|t|} = \varphi_{(a+b)X}(t)\). Donc \(aX + bY\) a la loi de \((a+b)X\). Or \(cX\) a pour densité \(\frac{1}{c} f\big(\frac{x}{c}\big)\). Ainsi, \(aX + bY\) a pour densité \(\frac{a+b}{\pi\big((a+b)^2 + x^2\big)}\).
Corrigé de l’exercice 18 : Manipulation d’un vecteur gaussien
- La matrice \(\Gamma\) est symétrique. Sa trace vaut 4 et son déterminant vaut 3, donc ses valeurs propres sont 1 et 3. Elle est symétrique définie positive, donc c’est une matrice de covariance.
- Toute combinaison linéaire des coordonnées d’un vecteur gaussien est gaussienne. De plus, \(\operatorname{Var}(X_1 + X_2) = 2 + 2 + 2 \times 1 = 6\) et \(\operatorname{Var}(X_1 – X_2) = 2 + 2 – 2 = 2\). Donc \(X_1 + X_2\) suit \(\mathcal{N}(0, 6)\) et \(X_1 – X_2\) suit \(\mathcal{N}(0, 2)\). Ensuite, le vecteur \((X_1 + X_2, X_1 – X_2)\) est l’image linéaire de \(X\), donc gaussien. Sa covariance croisée vaut \(\operatorname{Var} X_1 – \operatorname{Var} X_2 = 0\). Ces deux variables sont donc indépendantes.
- Le vecteur \((X_1, X_2 – aX_1)\) est gaussien. Ses coordonnées sont indépendantes si et seulement si \(\operatorname{Cov}(X_1, X_2 – aX_1) = 1 – 2a = 0\). Donc \(a = 1/2\). Ensuite, \(X_2 = \frac{1}{2}X_1 + (X_2 – \frac{1}{2}X_1)\), où le second terme est centré et indépendant de \(X_1\). Ainsi, \(E[X_2 \mid X_1] = \frac{1}{2}X_1\). Enfin, \(\operatorname{Var}(X_2 – \frac{1}{2}X_1) = 2 – 2 \times \frac{1}{2} \times 1 + \frac{1}{4} \times 2 = \frac{3}{2}\). La variable \(X_2 – E[X_2 \mid X_1]\) suit \(\mathcal{N}(0, 3/2)\).
- On a \(\det \Gamma = 3\) et \(\Gamma^{-1} = \frac{1}{3}\begin{pmatrix} 2 -1 \\ -1 2 \end{pmatrix}\). Donc \(x^{T}\Gamma^{-1}x = \frac{2}{3}(x_1^2 – x_1 x_2 + x_2^2)\). La densité de \(X\) est
\[f(x_1, x_2) = \frac{1}{2\pi\sqrt{3}} \exp\Big(-\frac{x_1^2 – x_1 x_2 + x_2^2}{3}\Big).\] - On cherche \(A = \begin{pmatrix} \alpha 0 \\ \beta \gamma \end{pmatrix}\) avec \(\alpha, \gamma > 0\). La condition \(AA^{T} = \Gamma\) donne \(\alpha^2 = 2\), \(\alpha\beta = 1\) et \(\beta^2 + \gamma^2 = 2\). Donc \(\alpha = \sqrt{2}\), \(\beta = \frac{1}{\sqrt{2}}\) et \(\gamma = \sqrt{3/2}\). Si \(Z_1, Z_2\) sont indépendantes de loi \(\mathcal{N}(0,1)\), alors \(AZ\) est gaussien centré de covariance \(AA^{T} = \Gamma\). On simule donc \(X\) par \(X_1 = \sqrt{2} Z_1\) et \(X_2 = \frac{1}{\sqrt{2}}Z_1 + \sqrt{\frac{3}{2}} Z_2\).
Point de méthode : dans un vecteur gaussien, on décorrèle par une combinaison linéaire ; la non-corrélation donne alors l’indépendance, puis l’espérance conditionnelle.
Corrigé de l’exercice 19 : Amincissement d’une loi de Poisson
- Par la formule des probabilités totales, pour \(k \in \mathbb{N}\),
\[P(X = k) = \sum_{n \geq\, k} e^{-\lambda}\frac{\lambda^n}{n!}\binom\,{n}{k}p^k q^{n-k} = e^{-\lambda}\frac{(\lambda p)^k}{k!}\sum_{j \geq\, 0}\frac{(\lambda q)^j}{j!} = e^{-\lambda p}\frac{(\lambda p)^k}{k!}.\]
Donc \(X\) suit la loi \(\mathcal{P}(\lambda p)\). - On a \(\{X = k, Y = m\} = \{N = k + m, X = k\}\). Donc
\[P(X = k, Y = m) = e^{-\lambda}\frac{\lambda^{k+m}}{(k+m)!}\binom\,{k+m}{k}p^k q^m = \Big(e^{-\lambda p}\frac{(\lambda p)^k}{k!}\Big)\Big(e^{-\lambda q}\frac{(\lambda q)^m}{m!}\Big).\]
La loi du couple est un produit. Donc \(X\) et \(Y\) sont indépendantes, et \(Y\) suit la loi \(\mathcal{P}(\lambda q)\). - Sachant \(N = n\), la loi de \(X\) est \(\mathcal{B}(n, p)\), de moyenne \(np\). Donc \(E[X \mid N = n] = np\), et \(E[X \mid N] = pN\). On vérifie : \(E[pN] = p\lambda = E[X]\), en accord avec la question 1.
- On a \(N = X + Y\), avec \(Y\) indépendante de \(X\). Donc \(E[N \mid X] = X + E[Y \mid X] = X + E[Y]\). Ainsi, \(E[N \mid X] = X + \lambda q\). Savoir que \(k\) clients ont acheté renseigne sur le total, mais pas sur le nombre de non-acheteurs.
Corrigé de l’exercice 20 : Densités conditionnelles sur un domaine
- La fonction \(f\) est positive et mesurable. Par Fubini-Tonelli, \(\int\!\!\int f = \int_0^{+\infty}\Big(\int_0^y dx\Big) e^{-y} \, dy = \int_0^{+\infty} y e^{-y} \, dy = 1\). C’est une densité de probabilité.
- Pour \(x > 0\), \(f_X(x) = \int_x^{+\infty} e^{-y} \, dy = e^{-x}\). Pour \(y > 0\), \(f_Y(y) = \int_0^y e^{-y} \, dx = y e^{-y}\). Donc \(X\) suit \(\mathcal{E}(1)\) et \(Y\) suit \(\Gamma(2, 1)\). Le produit \(f_X(x)f_Y(y)\) est strictement positif sur \(]0,+\infty[^2\), alors que \(f\) est nulle sur \(\{0 < y < x\}\), de mesure non nulle. Les variables ne sont pas indépendantes : d’ailleurs, \(X < Y\) presque sûrement.
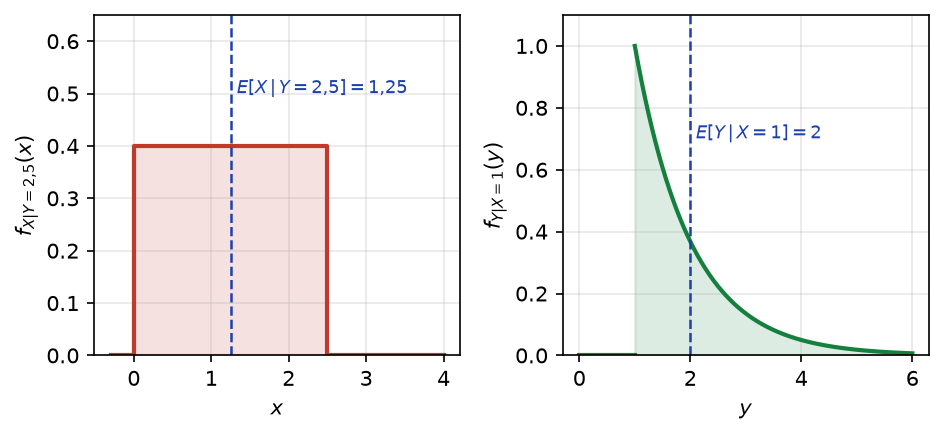
- Pour \(y > 0\), \(f_{X \mid Y = y}(x) = \frac{e^{-y}}{y e^{-y}}\mathbf{1}_{]0,y[}(x) = \frac{1}{y}\mathbf{1}_{]0,y[}(x)\). Sachant \(Y = y\), \(X\) est uniforme sur \(]0, y[\), et \(E[X \mid Y] = Y/2\).
- Pour \(x > 0\), \(f_{Y \mid X = x}(y) = e^{-(y – x)}\mathbf{1}_{]x, +\infty[}(y)\). Sachant \(X = x\), \(Y – x\) suit donc \(\mathcal{E}(1)\). Ainsi, \(E[Y \mid X] = X + 1\). On vérifie : \(E[E[X \mid Y]] = E[Y]/2 = 1 = E[X]\), et \(E[X + 1] = 2 = E[Y]\).
- L’application \((x, y) \mapsto (x, y – x)\) est un \(C^1\)-difféomorphisme de \(\{0 < x < y\}\) sur \(]0, +\infty[^2\), de jacobien 1. Le couple \((X, Y – X)\) a donc pour densité \(e^{-(x + z)} = e^{-x} \cdot e^{-z}\) sur \(]0, +\infty[^2\). Donc \(X\) et \(Y – X\) sont indépendantes, de loi \(\mathcal{E}(1)\).
La figure ci-dessous trace les deux densités conditionnelles obtenues. À gauche, sachant \(Y = 2{,}5\), la tranche horizontale donne une loi uniforme sur \(]0 ; 2{,}5[\). À droite, sachant \(X = 1\), la tranche verticale donne une loi exponentielle décalée.
Corrigé de l’exercice 21 : Composantes gaussiennes d’un vecteur non gaussien
- Soit \(t\) réel. Par la formule des probabilités totales et l’indépendance de \(\varepsilon\) et \(X\),
\[P(Y \leq\, t) = \frac{1}{2}P(X \leq\, t) + \frac{1}{2}P(-X \leq\, t).\]
Or \(-X\) a la même loi que \(X\), par parité de la densité. Donc \(P(Y \leq\, t) = P(X \leq\, t)\) et \(Y\) suit \(\mathcal{N}(0,1)\). - Par indépendance, \(\operatorname{Cov}(X, Y) = E[\varepsilon X^2] = E[\varepsilon]E[X^2] = 0 \times 1\). Donc \(\operatorname{Cov}(X, Y) = 0\).
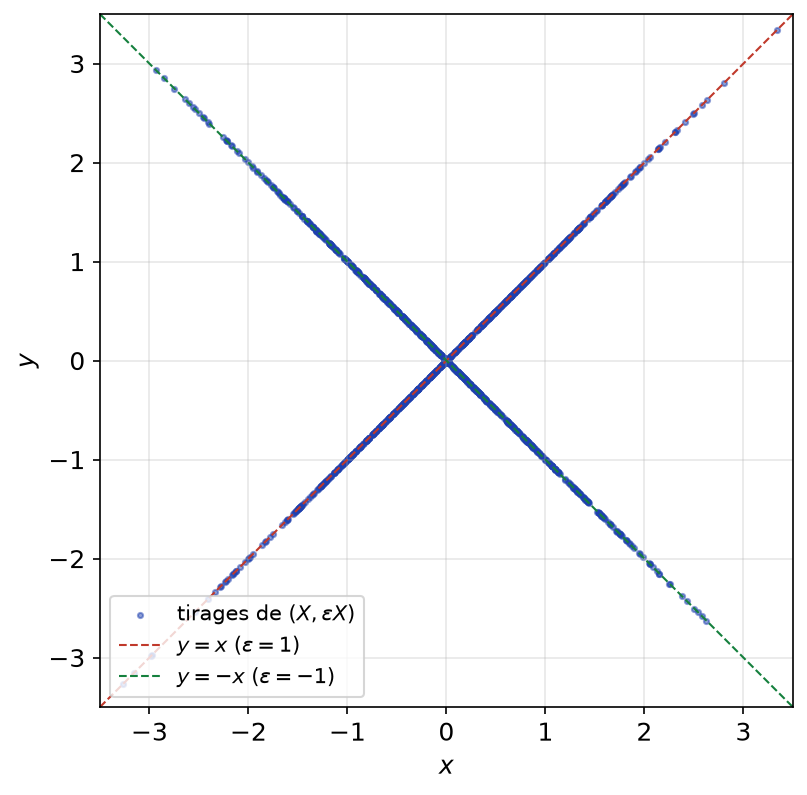
- On a \(X + Y = (1 + \varepsilon)X\). Cette variable est nulle si \(\varepsilon = -1\) ou si \(X = 0\). Or \(P(X = 0) = 0\). Donc \(P(X + Y = 0) = 1/2\). Une loi normale de variance non nulle n’a pas d’atome. De plus, \(X + Y\) n’est pas constante, puisqu’elle vaut \(2X\) avec probabilité \(1/2\). Par conséquent, \(X + Y\) n’est pas gaussienne, et le vecteur \((X, Y)\) n’est pas gaussien.
- On a \(|Y| = |X|\). Donc \(P(|X| \leq\, 1, |Y| > 1) = 0\), alors que \(P(|X| \leq\, 1)P(|Y| > 1) > 0\). Les variables ne sont pas indépendantes, bien que non corrélées et toutes deux gaussiennes.
La figure ci-dessous le montre clairement : les points \((X, Y)\) se placent tous sur les deux diagonales. Un couple gaussien non dégénéré remplirait au contraire tout le plan.

- En conditionnant par la valeur de \(\varepsilon\), puis par indépendance,
\[\varphi_{(X,Y)}(s, t) = \frac{1}{2}E\big[e^{i(s+t)X}\big] + \frac{1}{2}E\big[e^{i(s-t)X}\big] = \frac{1}{2}\Big(e^{-(s+t)^2/2} + e^{-(s-t)^2/2}\Big).\]
On obtient \(\varphi_{(X,Y)}(s,t) = e^{-(s^2 + t^2)/2}\cosh(st)\), qui diffère de \(\varphi_X(s)\varphi_Y(t) = e^{-(s^2+t^2)/2}\) dès que \(st \neq 0\). On retrouve la non-indépendance. - Soit \(h\) mesurable bornée. Par indépendance, \(E[Y h(X)] = E[\varepsilon]E[X h(X)] = 0\). Donc \(E[Y \mid X] = 0\). En revanche, \(Y^2 = X^2\), qui est une fonction de \(X\). Donc \(E[Y^2 \mid X] = X^2\). Connaître \(X\) ne renseigne pas sur le signe de \(Y\), mais donne sa valeur absolue.
Corrigé de l’exercice 22 : Sommes aléatoires et identité de Wald
- D’abord, \(|S| \leq\, \sum_{k=1}^{N}|X_k|\), et le calcul ci-dessous appliqué aux \(|X_k|\) montre que \(E[|S|] \leq\, E[N]E[|X_1|] < +\infty\). Soit \(n\) tel que \(P(N = n) > 0\). Sur \(\{N = n\}\), on a \(S = X_1 + \cdots + X_n\). Or \(N\) est indépendante des \(X_k\). Donc
\[E[S\mathbf{1}_{\{N = n\}}] = E[X_1 + \cdots + X_n] \, P(N = n) = nm \, P(N = n).\]
Ainsi, \(E[S \mid N = n] = nm\), d’où \(E[S \mid N] = mN\) et \(E[S] = E\big[E[S \mid N]\big] = m E[N]\). - De même, \(E[S^2 \mathbf{1}_{\{N = n\}}] = E[(X_1 + \cdots + X_n)^2]P(N = n)\). Or \(E[(X_1 + \cdots + X_n)^2] = n\sigma^2 + n^2 m^2\), variance plus carré de la moyenne. En sommant sur \(n\), on obtient \(E[S^2] = \sigma^2 E[N] + m^2 E[N^2]\). Donc \(\operatorname{Var}(S) = \sigma^2 E[N] + m^2\big(E[N^2] – E[N]^2\big) = \sigma^2 E[N] + m^2\operatorname{Var}(N)\).
- Par le même découpage, \(E[e^{itS}\mathbf{1}_{\{N = n\}}] = \varphi_X(t)^n P(N = n)\), par indépendance. La série converge absolument, car \(|\varphi_X(t)| \leq\, 1\). En sommant, \(\varphi_S(t) = \sum_{n \geq\, 0} P(N = n)\varphi_X(t)^n = G_N(\varphi_X(t))\).
- Ici, \(G_N(z) = e^{\lambda(z – 1)}\) et \(\varphi_X(t) = 1 – p + pe^{it}\). Donc \(\varphi_S(t) = \exp\big(\lambda p(e^{it} – 1)\big)\). Par injectivité, \(S\) suit la loi \(\mathcal{P}(\lambda p)\). On retrouve l’amincissement de l’exercice 19. De plus, la formule de la question 2 donne \(\operatorname{Var}(S) = p(1-p)\lambda + p^2\lambda = \lambda p\), comme il se doit.
- Pour \(|z| \leq\, 1\), on a \(G_N(z) = \sum_{n \geq\, 1} r(1 – r)^{n-1}z^n = \frac{rz}{1 – (1-r)z}\). Avec \(\psi(t) = \frac{\lambda}{\lambda – it}\), on obtient
\[\varphi_S(t) = \frac{r\psi(t)}{1 – (1-r)\psi(t)} = \frac{r\lambda}{\lambda – it – (1 – r)\lambda} = \frac{r\lambda}{r\lambda – it}.\]
C’est la fonction caractéristique de \(\mathcal{E}(r\lambda)\), donc \(S\) suit cette loi. Autrement dit, une somme géométrique d’exponentielles reste exponentielle.
Corrigé de l’exercice 23 : Problème : lois gamma et bêta
- Par définition de la fonction \(\Gamma\), \(E[X] = \frac{1}{\Gamma(a)}\int_0^{+\infty} x^a e^{-x} \, dx = \frac{\Gamma(a+1)}{\Gamma(a)} = a\). De même, \(E[X^2] = \frac{\Gamma(a+2)}{\Gamma(a)} = a(a+1)\). Donc \(E[X] = a\) et \(\operatorname{Var}(X) = a(a+1) – a^2 = a\).
- On a \(\varphi(t) = \frac{1}{\Gamma(a)}\int_0^{+\infty} e^{itx}x^{a-1}e^{-x} \, dx\). La dérivée en \(t\) de l’intégrande est majorée en module par \(x^a e^{-x}\), intégrable et indépendante de \(t\). Par le théorème de dérivation sous l’intégrale,
\[\varphi^{\prime}(t) = \frac{i}{\Gamma(a)}\int_0^{+\infty} x^a e^{-(1-it)x} \, dx.\]
On intègre par parties, avec \(-\frac{e^{-(1-it)x}}{1 – it}\) comme primitive de \(e^{-(1-it)x}\). Le crochet est nul, car \(a > 0\). On obtient \(\varphi^{\prime}(t) = \frac{ia}{1 – it}\varphi(t)\). Posons alors \(\psi(t) = \exp\big(a\operatorname{Log}(1 – it)\big)\varphi(t)\). Comme \(\operatorname{Log}\) est holomorphe de dérivée \(1/z\) sur le demi-plan \(\operatorname{Re} z > 0\), on a
\[\psi^{\prime}(t) = \exp\big(a\operatorname{Log}(1 – it)\big)\Big(\frac{-ia}{1 – it}\varphi(t) + \varphi^{\prime}(t)\Big) = 0.\]
Donc \(\psi\) est constante, égale à \(\psi(0) = 1\). Ainsi, \(\varphi(t) = \exp\big(-a\operatorname{Log}(1 – it)\big) = (1 – it)^{-a}\). - Par indépendance, \(\varphi_{X+Y}(t) = \exp\big(-a\operatorname{Log}(1-it)\big)\exp\big(-b\operatorname{Log}(1-it)\big) = (1 – it)^{-(a+b)}\). Par injectivité, \(X + Y\) suit la loi \(\Gamma(a + b, 1)\).
- Comme à l’exercice 12, \((x, y) \mapsto (x + y, x/(x+y))\) est un \(C^1\)-difféomorphisme de \(]0, +\infty[^2\) sur \(]0, +\infty[ \times ]0, 1[\). Sa réciproque est \((u, v) \mapsto (uv, u(1-v))\), de jacobien \(-u\). Donc \((U, V)\) a pour densité
\[\frac{(uv)^{a-1}\big(u(1-v)\big)^{b-1}e^{-u}}{\Gamma(a)\Gamma(b)} \, u = \frac{u^{a+b-1}e^{-u}}{\Gamma(a+b)} \times \frac{\Gamma(a+b)}{\Gamma(a)\Gamma(b)}v^{a-1}(1-v)^{b-1}.\]
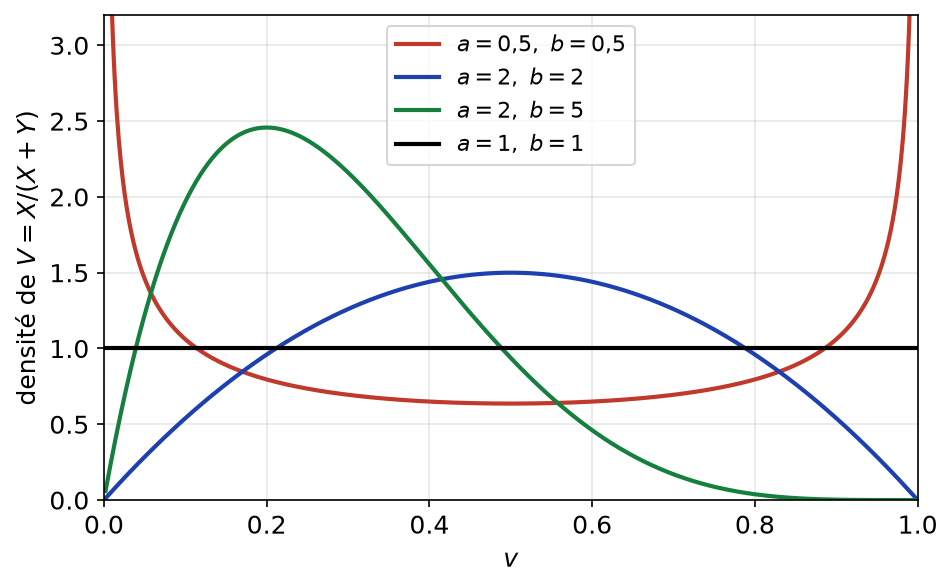
Le premier facteur est la densité de \(\Gamma(a+b, 1)\), d’intégrale 1. En intégrant en \(u\), on obtient la densité de \(V\). Ainsi, \(V\) a pour densité \(\frac{\Gamma(a+b)}{\Gamma(a)\Gamma(b)}v^{a-1}(1-v)^{b-1}\) sur \(]0,1[\), et la densité du couple est le produit des marginales : \(U\) et \(V\) sont indépendantes.La figure ci-dessous montre quelques-unes de ces lois bêta. Pour \(a = b = 1\), on retrouve la loi uniforme de l’exercice 12. Pour \(a = b = 1/2\), la densité explose aux deux bords.

- La densité de \(V\) est d’intégrale 1. Donc \(\int_0^1 v^{a-1}(1-v)^{b-1} \, dv = \frac{\Gamma(a)\Gamma(b)}{\Gamma(a+b)}\). Pour \(a = b = 1/2\), on pose \(v = \sin^2\theta\), avec \(\theta \in ]0, \pi/2[\). Alors \(dv = 2\sin\theta\cos\theta \, d\theta\) et \(\sqrt{v(1-v)} = \sin\theta\cos\theta\). Donc \(\int_0^1 \frac{dv}{\sqrt{v(1-v)}} = \int_0^{\pi/2} 2 \, d\theta = \pi\). Comme \(\Gamma(1) = 1\), on obtient \(\Gamma(1/2)^2 = \pi\). Or \(\Gamma(1/2) > 0\), donc \(\Gamma(1/2) = \sqrt{\pi}\).
- On a \(X = UV\), avec \(U\) et \(V\) indépendantes et intégrables. Donc \(E[X] = E[U]E[V]\), soit \(a = (a + b)E[V]\). Ainsi, \(E[V] = \frac{a}{a+b}\). Ensuite, pour \(h\) mesurable bornée, \(E[X h(U)] = E[V]E[U h(U)]\). Donc \(E[X \mid U] = \frac{a}{a+b}U\).
Corrigé de l’exercice 24 : Problème : moyenne et variance empiriques gaussiennes
- Soit \(a \in \mathbb{R}^n\). Les variables \(a_i X_i\) sont indépendantes, de lois \(\mathcal{N}(a_i m, a_i^2\sigma^2)\). Par l’exercice 17 et une récurrence, \(\langle a, X \rangle\) suit \(\mathcal{N}\big(m\sum a_i, \sigma^2\sum a_i^2\big)\). Donc \(X\) est gaussien, de moyenne \(m(1, \ldots, 1)\) et de covariance \(\sigma^2 I_n\).
- Avec \(a = \frac{1}{n}(1, \ldots, 1)\), on obtient \(\overline{X}\) de loi \(\mathcal{N}(m, \sigma^2/n)\).
- Par bilinéarité, \(\operatorname{Cov}(\overline{X}, X_i) = \frac{1}{n}\sum_j \operatorname{Cov}(X_j, X_i) = \frac{\sigma^2}{n}\). Donc \(\operatorname{Cov}(\overline{X}, X_i – \overline{X}) = \frac{\sigma^2}{n} – \operatorname{Var}(\overline{X}) = 0\). Cette covariance est nulle. Or le vecteur \((\overline{X}, X_1 – \overline{X}, \ldots, X_n – \overline{X})\) est une image linéaire de \(X\), donc il est gaussien. Ses covariances croisées entre \(\overline{X}\) et le bloc \((X_i – \overline{X})_i\) sont nulles. Donc \(\overline{X}\) est indépendante de ce bloc. Comme \(S^2\) est une fonction de ce bloc, \(\overline{X}\) et \(S^2\) sont indépendantes.
- On développe : \(\sum_i (X_i – \overline{X})^2 = \sum_i (X_i – m)^2 – n(\overline{X} – m)^2\). En prenant l’espérance, on obtient \(n\sigma^2 – n \cdot \frac{\sigma^2}{n} = (n-1)\sigma^2\). Donc \(E[S^2] = \sigma^2\) : c’est pourquoi on divise par \(n – 1\).
- Une telle matrice \(Q\) existe : on complète le vecteur unitaire \(\frac{1}{\sqrt{n}}(1, \ldots, 1)\) en une base orthonormée, par Gram-Schmidt. Le vecteur \(Y\) est gaussien de loi \(\mathcal{N}(0, I_n)\). Donc \(W = QY\) est gaussien, centré, de covariance \(QI_nQ^{T} = I_n\). Les \(W_i\) sont donc indépendantes de loi \(\mathcal{N}(0,1)\). Ensuite, \(W_1 = \frac{1}{\sqrt{n}}\sum Y_i = \sqrt{n}\,\overline{Y}\) et \(\|W\|^2 = \|Y\|^2\), car \(Q\) est orthogonale. Par conséquent,
\[\sum_{i=1}^{n}(Y_i – \overline{Y})^2 = \|Y\|^2 – n\overline{Y}^2 = \|W\|^2 – W_1^2 = \sum_{i=2}^{n}W_i^2.\]
Enfin, \(X_i – \overline{X} = \sigma(Y_i – \overline{Y})\). Donc \(\frac{(n-1)S^2}{\sigma^2} = \sum_{i=2}^{n}W_i^2\). - D’après l’exemple du cours, \(W_i^2\) a pour densité \(\frac{1}{\sqrt{2\pi y}}e^{-y/2}\) sur \(]0, +\infty[\). Or la densité de \(\Gamma(1/2, 1/2)\) vaut \(\frac{(1/2)^{1/2}}{\Gamma(1/2)}y^{-1/2}e^{-y/2}\). Comme \(\Gamma(1/2) = \sqrt{\pi}\), c’est la même fonction. Donc \(W_i^2\) suit \(\Gamma(1/2, 1/2)\), de fonction caractéristique \((1 – 2it)^{-1/2}\). Les \(W_i^2\) sont indépendantes. Donc la fonction caractéristique de leur somme vaut \((1 – 2it)^{-(n-1)/2}\). Par injectivité, \(\frac{(n-1)S^2}{\sigma^2}\) suit la loi \(\Gamma\big(\frac{n-1}{2}, \frac{1}{2}\big)\), c’est-à-dire la loi du khi-deux à \(n-1\) degrés de liberté.
Point de méthode : une rotation bien choisie transforme un vecteur gaussien standard en un autre vecteur gaussien standard ; c’est l’outil clé de la statistique gaussienne.
Revenir aux énoncés des exercices
Pour aller plus loin en L3
- Le cours : variables aléatoires et espérance, cours de maths en L3
- Les énoncés : exercices de maths en L3 sur variables aléatoires et espérance
- À maîtriser avant : Intégrale de Lebesgue et théorèmes de convergence, Mesure produit, Fubini et changement de variables
- Chapitre précédent : Espaces de Hilbert et analyse de Fourier
- Chapitre suivant : Convergences, grands nombres et central limite
- Tester vos connaissances : QCM de maths en L3 par chapitre
- Le sommaire : tous les chapitres de maths de L3 et la licence de maths de L1 à L3